

NamiGPTとは
NamiGPTは、中国語の初心者を対象とした大規模言語モデルの基礎チュートリアルです。PyTorchを使ってGPT-2をゼロから実装し、既存のTransformerモジュールは使用しません。また、OpenAI公式の事前学習済み重みを読み込み、推論とテキスト生成を行えます。
このプロジェクトは学習効率を第一の目標とせず、理解を重視しています。コアモデルはgpt2/model.pyにあり、コードは200行未満です。チュートリアルでは「猫吃鱼(猫が魚を食べる)」という3語の例を手がかりに、トークン化、ベクトル、アテンション行列、最終的な生成処理を段階的に分解して説明します。
NamiGPTという名前は、KarpathyのnanoGPTに敬意を表したものです。中国語の完全な初心者向けに、最小限の例を通してGPT-2の各ステップを説明することに重点を置いています。
学べること
- Tokenizerがテキストをtoken IDに変換する方法。
- Embeddingと位置エンコーディングによるモデル入力の構成方法。
- Self-AttentionとMulti-Head Attentionの計算方法。
- 残差接続、LayerNorm、FFN、活性化関数がそれぞれ担う役割。
- 複数のTransformer Blockを積み重ねてGPT-2を構成する方法。
- OpenAI公式の重みを手書きモデルに読み込む方法。
- 貪欲法、温度、top-k戦略を使ってテキストを生成する方法。
- テストを通じて、手書き実装とHuggingFace実装の一致を検証する方法。
プロジェクトの主な特徴
コアコンポーネントをゼロから実装
NamiGPTは既存のTransformerモジュールを直接呼び出していません。モデル本体にはLayerNorm、Attention、FFN、Block、GPTなどのコンポーネントが含まれており、データとテンソルがどのように流れるかを1行ずつ読み進めるのに適しています。
章ごとのスクリプトを独立して実行可能
推論編は、トークナイザー、Embedding、位置エンコーディング、自己注意、多頭注意、残差接続、レイヤー正規化、フィードフォワードネットワーク、活性化関数、Transformer Block、積層、重みの読み込み、テキスト生成、解釈可能性という15の段階的なテーマで構成されています。各テーマには実行可能な対応スクリプトが用意されています。
インタラクティブな可視化を提供
Transformerアーキテクチャの動的可視化と、推論行列全体の可視化を提供しています。コードや数式が理解しにくいときは、「猫吃鱼」の例で行列の各要素がマスごとに計算される様子を確認できます。
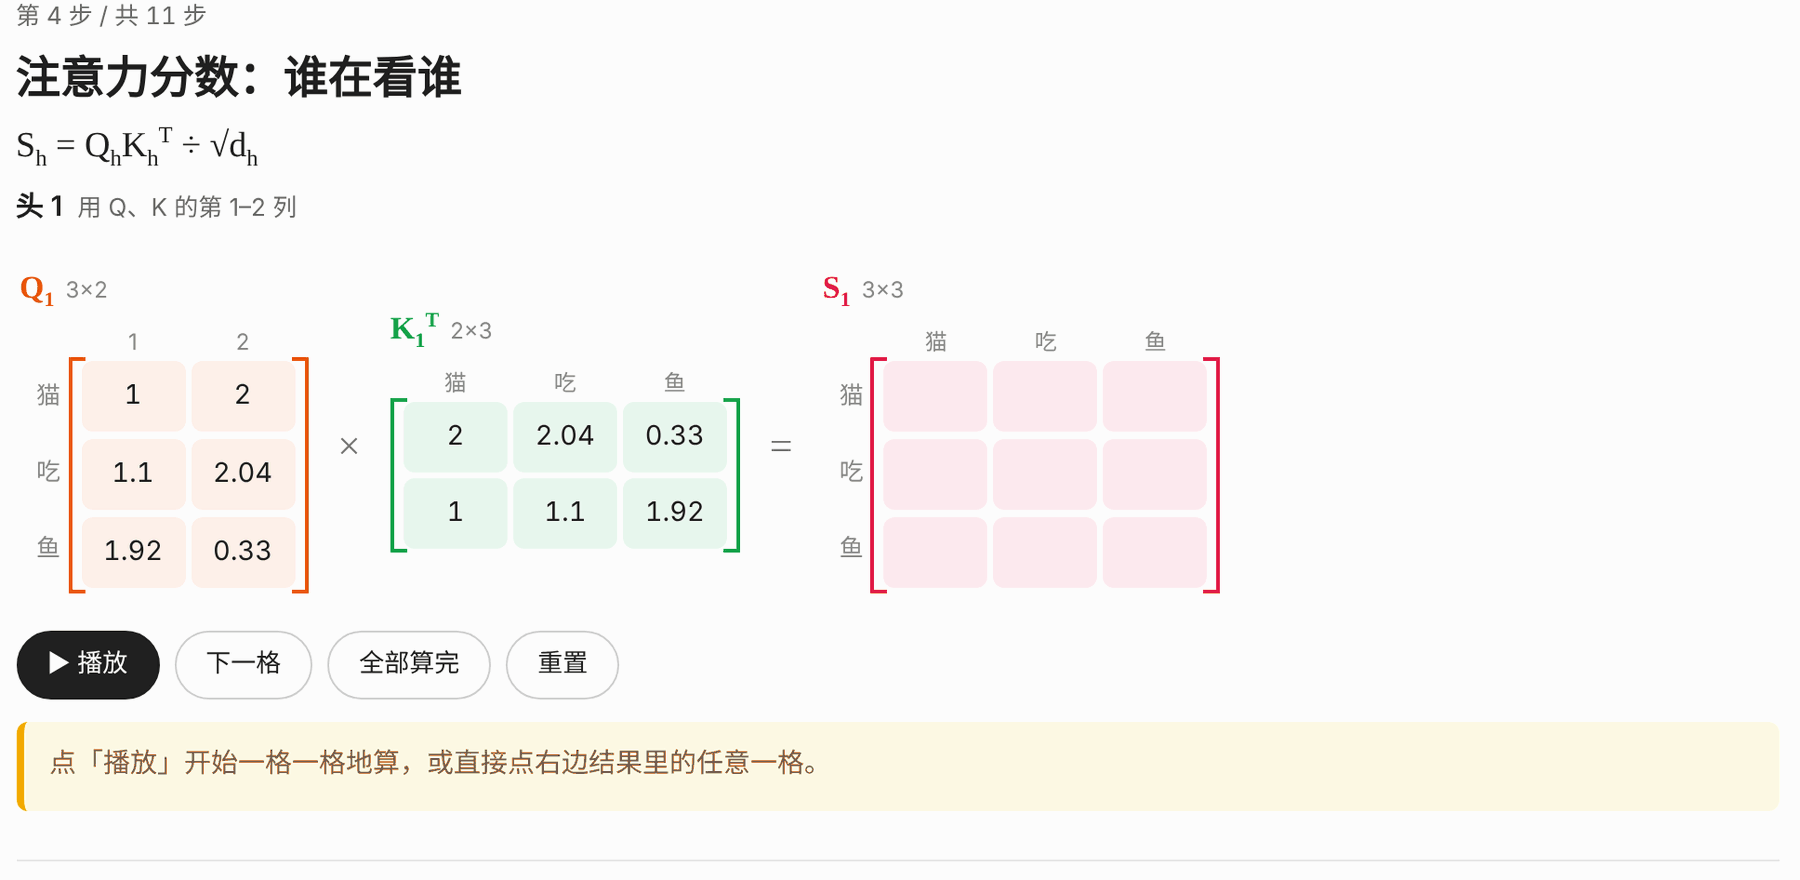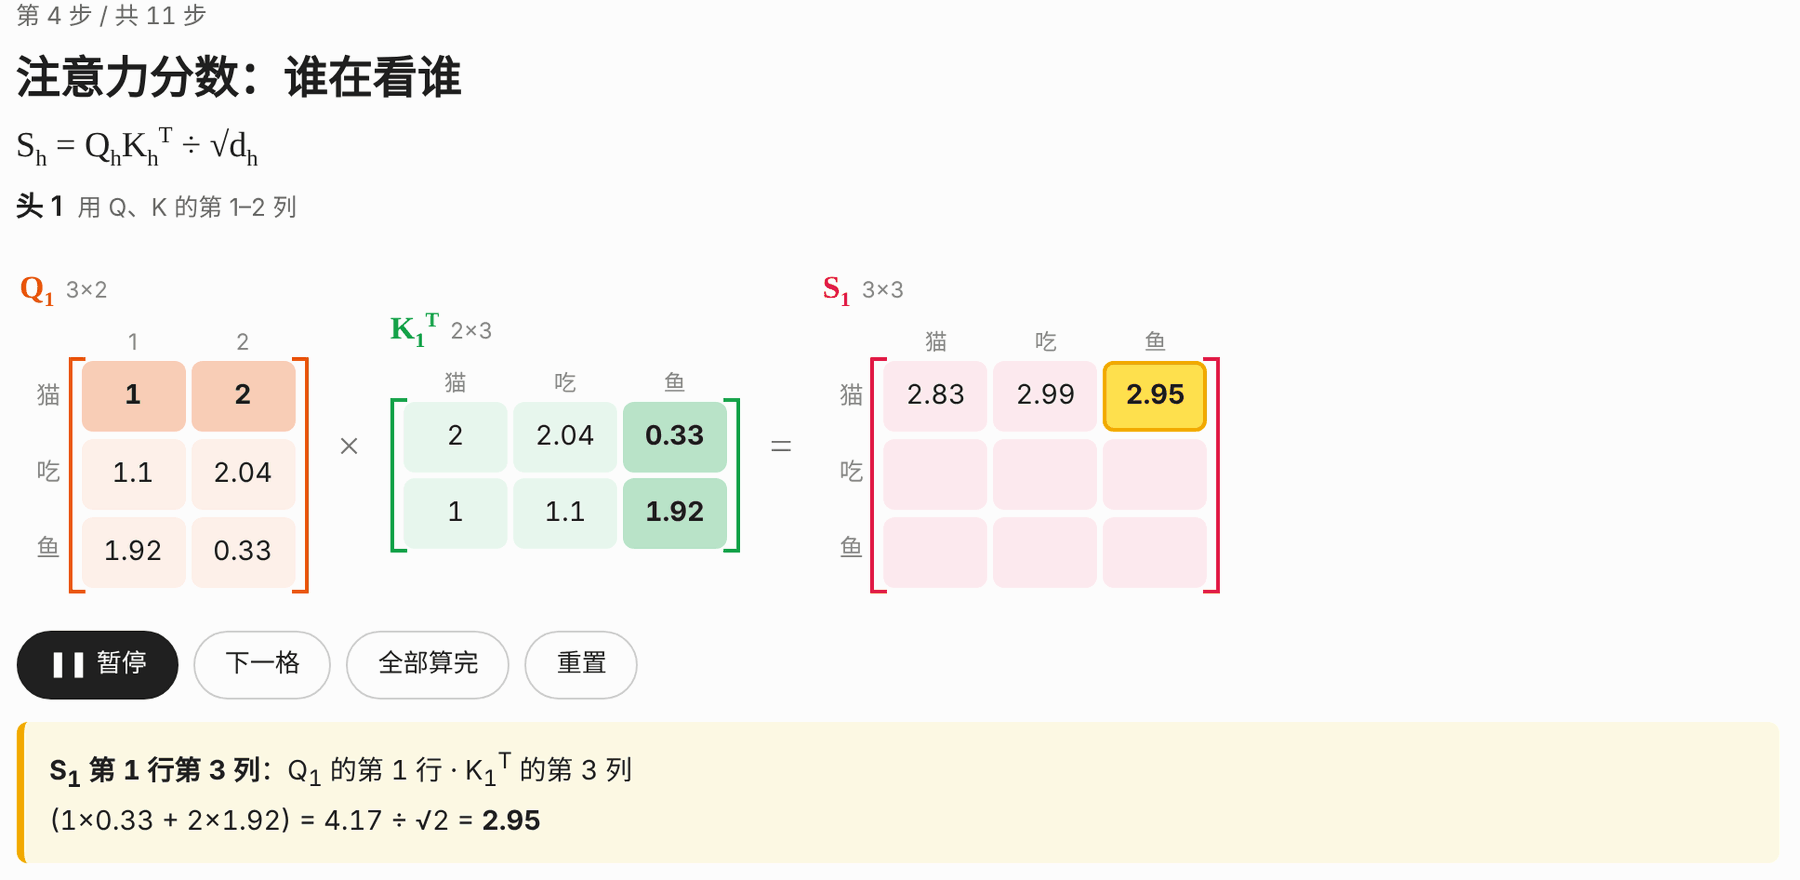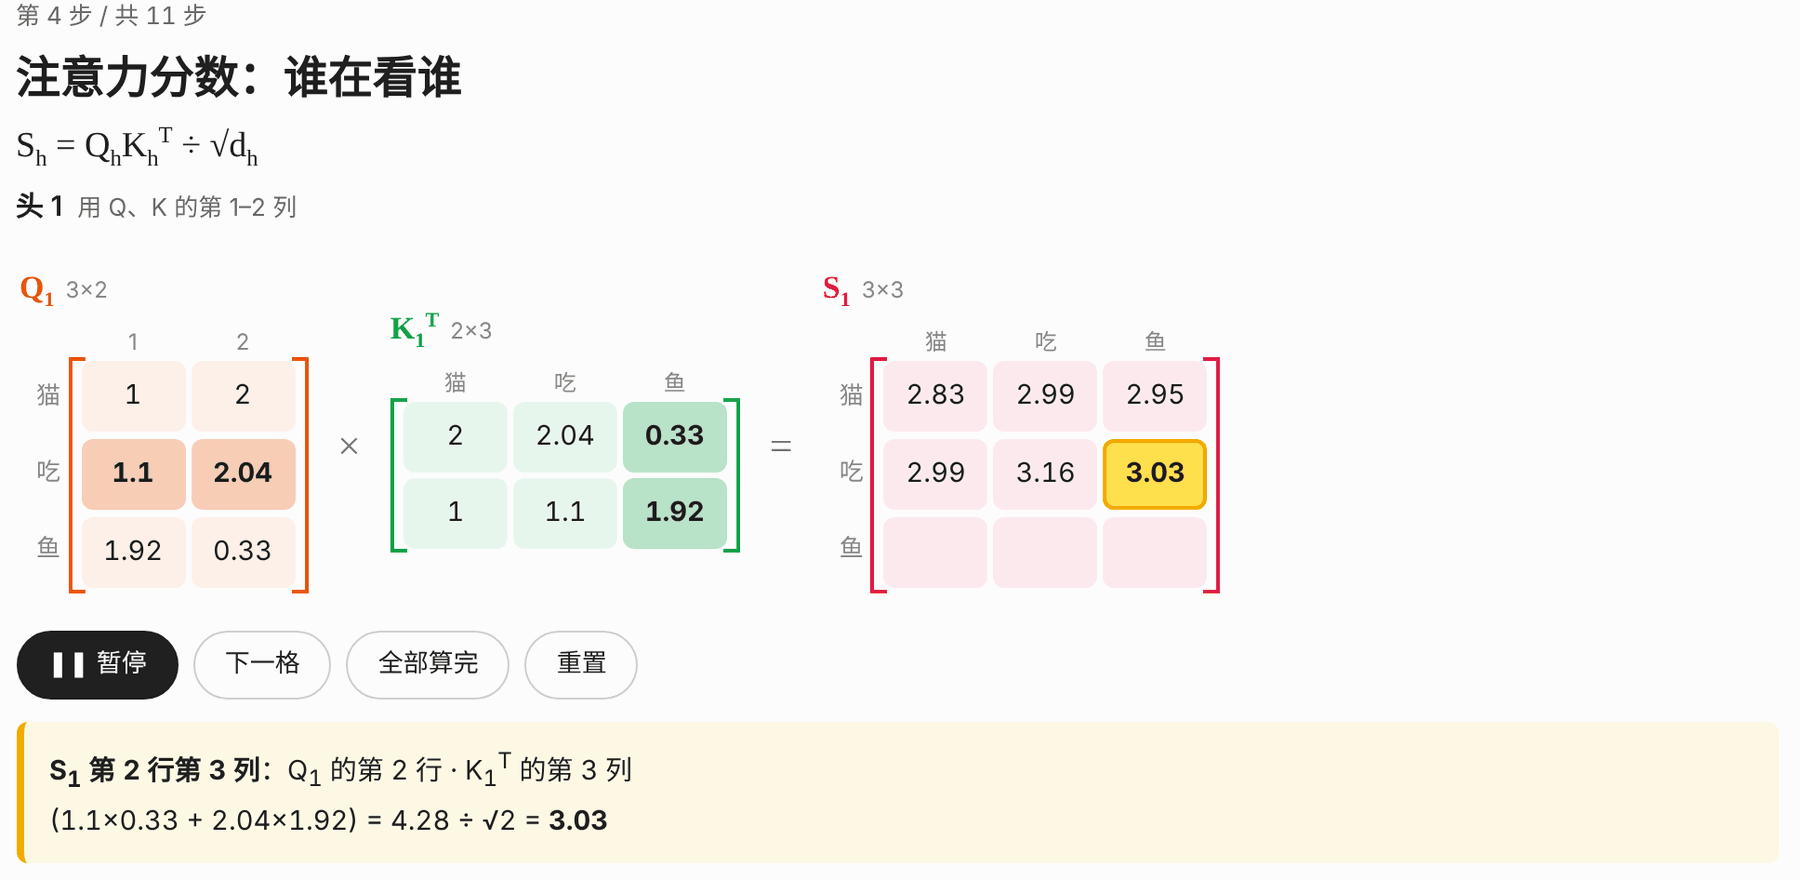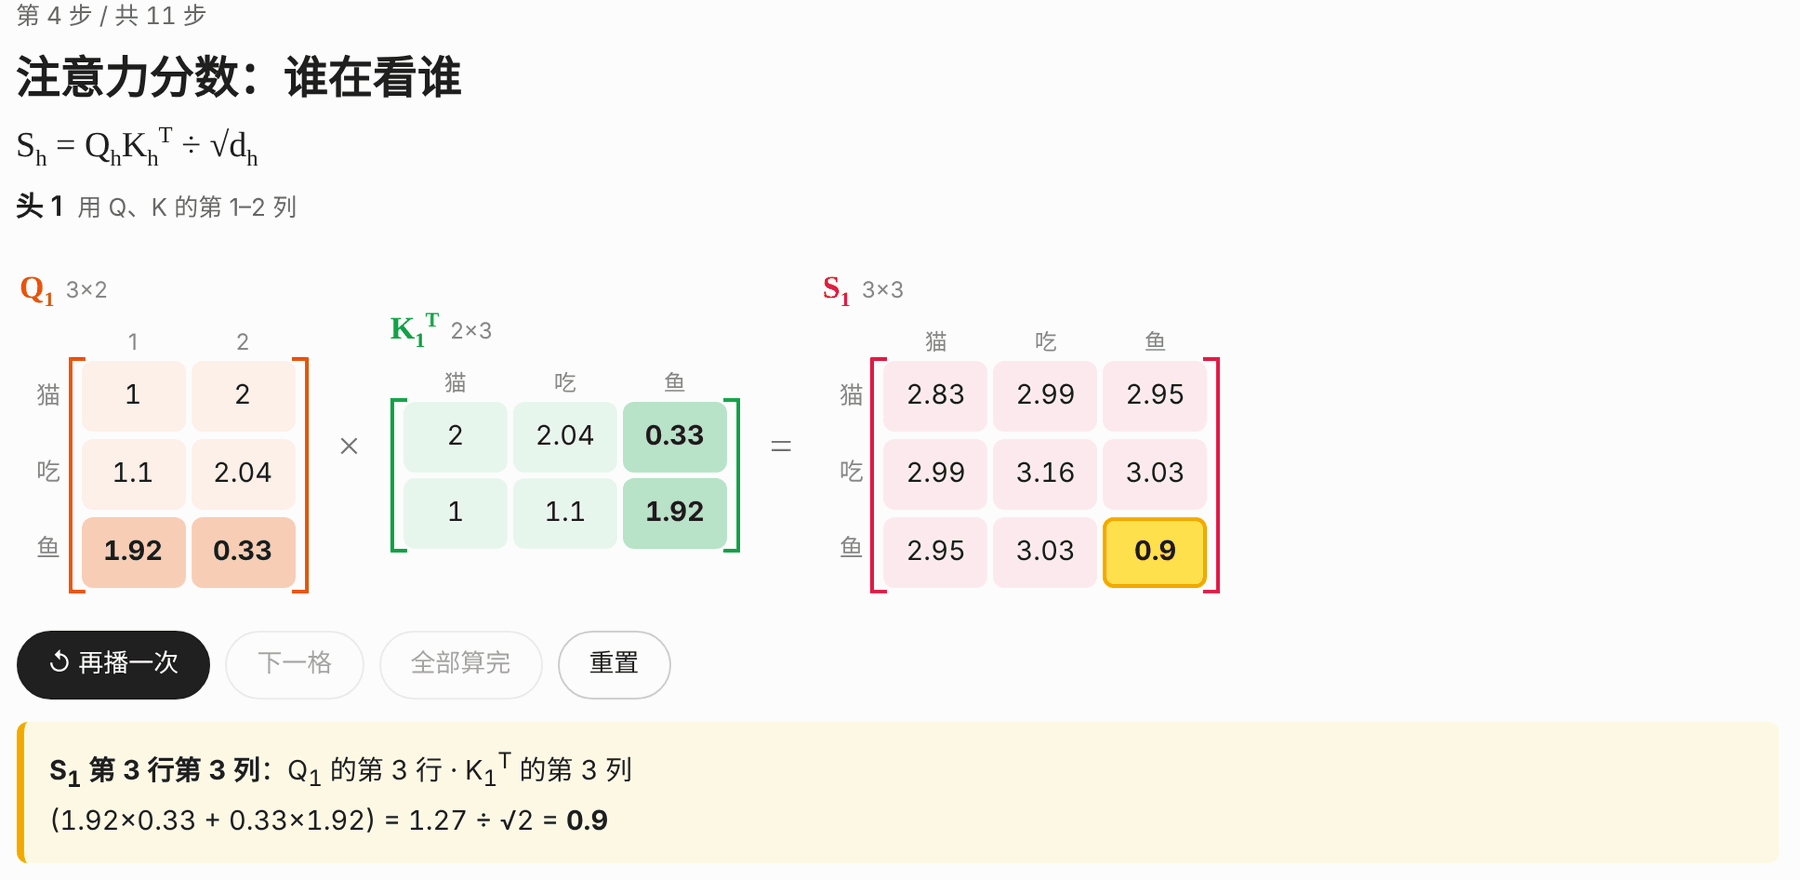
まず1枚の図で理解するTransformerを確認し、その後大規模モデル推論の可視化を使って章のコードと照らし合わせることをおすすめします。
HuggingFaceの結果と一致
リポジトリには、形状チェックとHuggingFace公式実装との一致テストが含まれています。ランダムな重みを使った高速比較に加え、実際のGPT-2重みをダウンロードして追加検証することもできます。
インストール前の準備
始める前に、基本的なPythonコードを読めることと、行列乗算などの基本的な線形代数の概念を理解していることが望まれます。想定実行環境はPython 3.9以上およびPyTorch 2.xです。
まずリポジトリをクローンし、プロジェクトディレクトリに移動して依存関係をインストールします。
git clone https://github.com/aa1143/NamiGPT.git
cd NamiGPT
pip install -r requirements.txt
HuggingFaceから公式重みをダウンロードする際にネットワークの制限がある場合は、現在のターミナルでミラーアドレスを設定できます。
export HF_ENDPOINT=https://hf-mirror.comこのミラーは公式重みのダウンロードにのみ使用します。その後from_pretrainedを呼び出す場合も、モデル構造はNamiGPTの手書き実装から提供されます。
ステップ1:章ごとにGPT-2を理解する
初心者に最も適した方法は、いきなり完全なモデルを読むことではなく、推論データの流れに沿って章ごとに学ぶことです。
- 入力段階:まずTokenizer、Embedding、位置エンコーディングを理解します。
- アテンション段階:Self-Attentionを理解し、次にMulti-Head Attentionへ進みます。
- モジュール段階:残差接続、LayerNorm、FFN、活性化関数を学びます。
- モデル段階:各コンポーネントをTransformer Blockにまとめ、積み重ねて完全なGPT-2を構成します。
- 応用段階:公式重みを読み込み、テキストを生成し、解釈可能性の結果を確認します。
各スクリプトは単独で実行できます。たとえば、多頭注意の章を実行するには次のコマンドを使います。
python chapters/01-inference/ep06_multi_head_attention.py図と文章による完全な内容はNamiGPT図解チュートリアルで確認できます。リポジトリ内の原稿はdocs/01-inference/にあります。
ステップ2:GPT-2を読み込み、テキストを生成する
インストールが完了したら、NamiGPTが提供するモデル読み込み・生成インターフェースを直接インポートできます。次の例ではGPT-2 tokenizerを使って英語のプロンプトをtoken IDに変換し、手書きモデルと公式の124M重みを読み込みます。
import tiktoken, torch
from gpt2 import from_pretrained, generate

enc = tiktoken.get_encoding("gpt2")
model = from_pretrained("gpt2")

ids = torch.tensor([enc.encode("The cat sat on the")])
out = generate(
    model,
    ids,
    max_new_tokens=30,
    temperature=0.8,
    top_k=50,
)
print(enc.decode(out[0].tolist()))
コードの実行フロー
tiktoken.get_encoding("gpt2")でGPT-2が使用するエンコーダーを取得します。enc.encode(...)でプロンプトテキストをtoken IDに変換します。torch.tensorでIDをモデルが必要とするバッチテンソルにまとめます。from_pretrained("gpt2")で手書きのGPT-2を作成し、公式の124M重みを読み込みます。generateでプロンプトの後に最大30個の新しいtokenを生成します。enc.decodeで出力token IDをテキストに戻します。
注意:GPT-2は対話用に微調整されていません。得意なのは既存の内容に続けて文章を書くことであり、チャットモデルのように質問へ回答することではありません。学習コーパスは主に英語で構成されているため、まずは英語のプロンプトを使うことをおすすめします。
ステップ3:生成パラメータを理解する
この例では、2つの重要なサンプリングパラメータを使用しています。
temperature=0.8:候補tokenの確率分布を調整します。プロジェクトの生成モジュールは温度戦略に対応しています。top_k=50:確率が高い上位50個の候補tokenからのみ選択します。プロジェクトは貪欲生成とtop-k生成の両方に対応しています。
学習時はプロンプトを変えず、温度またはtop-kだけを調整して、続きの生成結果を比較できます。これにより、生成戦略が出力に与える影響を直感的に確認できます。ただし、具体的なパラメータは実験の目的に応じて選択してください。
ステップ4:GradioのWebデモを起動する
ブラウザでプロンプトを入力し、続きの生成結果と各ステップの候補語の確率を確認したい場合は、Gradioをインストールしてリポジトリ内のデモプログラムを起動できます。
pip install gradio
python demo/app.py
Webデモはモデルが各ステップで行う予測の観察に適しており、章ごとのスクリプトは個々のコンポーネントの計算過程を調べるのに適しています。両者を組み合わせることで、最終的なテキストと内部の確率変化を対応づけて確認できます。
ステップ5:テストを実行する
アテンション、重みの読み込み、生成ロジックを変更した後は、テストを実行することをおすすめします。デフォルトのテストではランダムな重みを使って比較するため、事前学習済みモデルをダウンロードする必要がなく、通常は短時間で完了します。
pytest tests/ -v実際のGPT-2重みを使って追加の一致検証を行う場合は、次を実行します。
TEST_PRETRAINED=1 pytest tests/ -v2つ目のコマンドでは実際の重みも追加でダウンロードするため、初回の実行時はダウンロードの完了まで待つ必要があります。
リポジトリ構成の概要
gpt2/config.py:124M、355M、774M、1.5Bの構成を含むモデル設定。gpt2/model.py:LayerNorm、Attention、FFN、Block、GPTモデル本体。gpt2/load_weights.py:公式重みを手書きモデルに読み込む処理。gpt2/generate.py:貪欲法、温度、top-kによる生成ロジック。chapters/01-inference/:各チュートリアルに対応するデモスクリプト。docs/01-inference/:チュートリアル記事の原稿。demo/app.py:GradioのWebデモ。tests/:形状チェックとHuggingFaceとの一致テスト。
高度なテクニック:HuggingFaceとの一致に関する3つの重要ポイント
1. 因果マスクを正しく適用する
GPT-2は自己回帰型の言語モデルです。系列内の各単語は自分自身と前にある単語だけを参照でき、後続のtokenを先に見ることはできません。因果マスクを適用し忘れると、公式重みの読み込みに成功してもモデルの出力は誤ったものになります。
2. 重みを移す際に転置を処理する
GPT-2の元の実装ではConv1Dを使用し、重みの形状は[in, out]です。一方、PyTorchのnn.Linearは[out, in]を使用します。そのため、公式パラメータを手書きの線形層に読み込む際は転置が必要です。
また、c_attnはQuery、Key、Valueのパラメータをまとめて連結しています。手書き実装と一致させるには、まずそれらを対応する3つの部分に分割し、正しい位置に配置する必要があります。
3. tanh近似版のGELUを使用する
GPT-2はGELUのtanh近似版を使用しますが、PyTorchのnn.GELU()はデフォルトで正確なバージョンを使用します。要素単位で一致させるには、次のように設定します。
nn.GELU(approximate="tanh")これら3つの点は一見小さな違いに見えますが、手書きモデルが公式実装の結果を再現できるかどうかに直接影響します。誤差の原因を特定するときは、マスク、パラメータ形状、活性化関数のバージョンを順番に確認してください。
おすすめの学習・デバッグ方法
- まずアーキテクチャの動的可視化を通して、GPT-2がTransformerのデコーダー部分だけを使用するという全体像を理解します。
- 現在の章のスクリプトを実行し、入力、出力、中間テンソルの形状を記録します。
- アテンション行列が理解しにくいときは、オンラインの行列可視化と照らし合わせてマスごとに確認します。
- 1つのコンポーネントを理解したら、
gpt2/model.py内の対応する実装を読みます。 - 実装を変更した後は、まずランダム重みのテストを実行し、必要に応じて実際の重みを使ったテストを実行します。
- 最後にテキスト生成の例とGradioページを使って、完全なモデルの動作を確認します。
この順序で進めると、アーキテクチャ図、行列計算、章ごとのコード、完全なモデル、最終出力をつなげて理解できます。最初からGPT-2全体の多層構造に圧倒されることもありません。
まとめ
NamiGPT は、基本的な行列計算から完全な GPT-2 推論までを学べる学習パスを提供します。まずは各コンポーネントを理解するために独立した章のスクリプトを実行し、次に OpenAI 公式の重みを読み込んで英語テキストの続きを生成します。最後に、可視化と HuggingFace との整合性テストを通じて、自分の理解や変更内容を検証できます。
プロジェクトのコードは MIT ライセンスを採用しています。docs/ ディレクトリ内の記事は CC BY-NC 4.0 ライセンスで提供されており、転載時には出典を明記し、商用利用は禁止されています。