
LLaMA Factory(現在は LlamaFactory に改名)は、大規模言語モデル向けの統合ファインチューニングフレームワークです。本プロジェクトは北京航空航天大学の鄭耀威博士チームによって開始され、ACL 2024 論文による学術的裏付けもあります。「ゼロコード CLI + Web UI」設計を採用し、ファインチューニングの手順を簡素化することを目指しています。LlamaFactory は GitHub で累計 72 000 個を超える Stars を獲得しており、大規模モデルのファインチューニング分野におけるリファレンス実装となっています。
>
一、プロジェクト概要
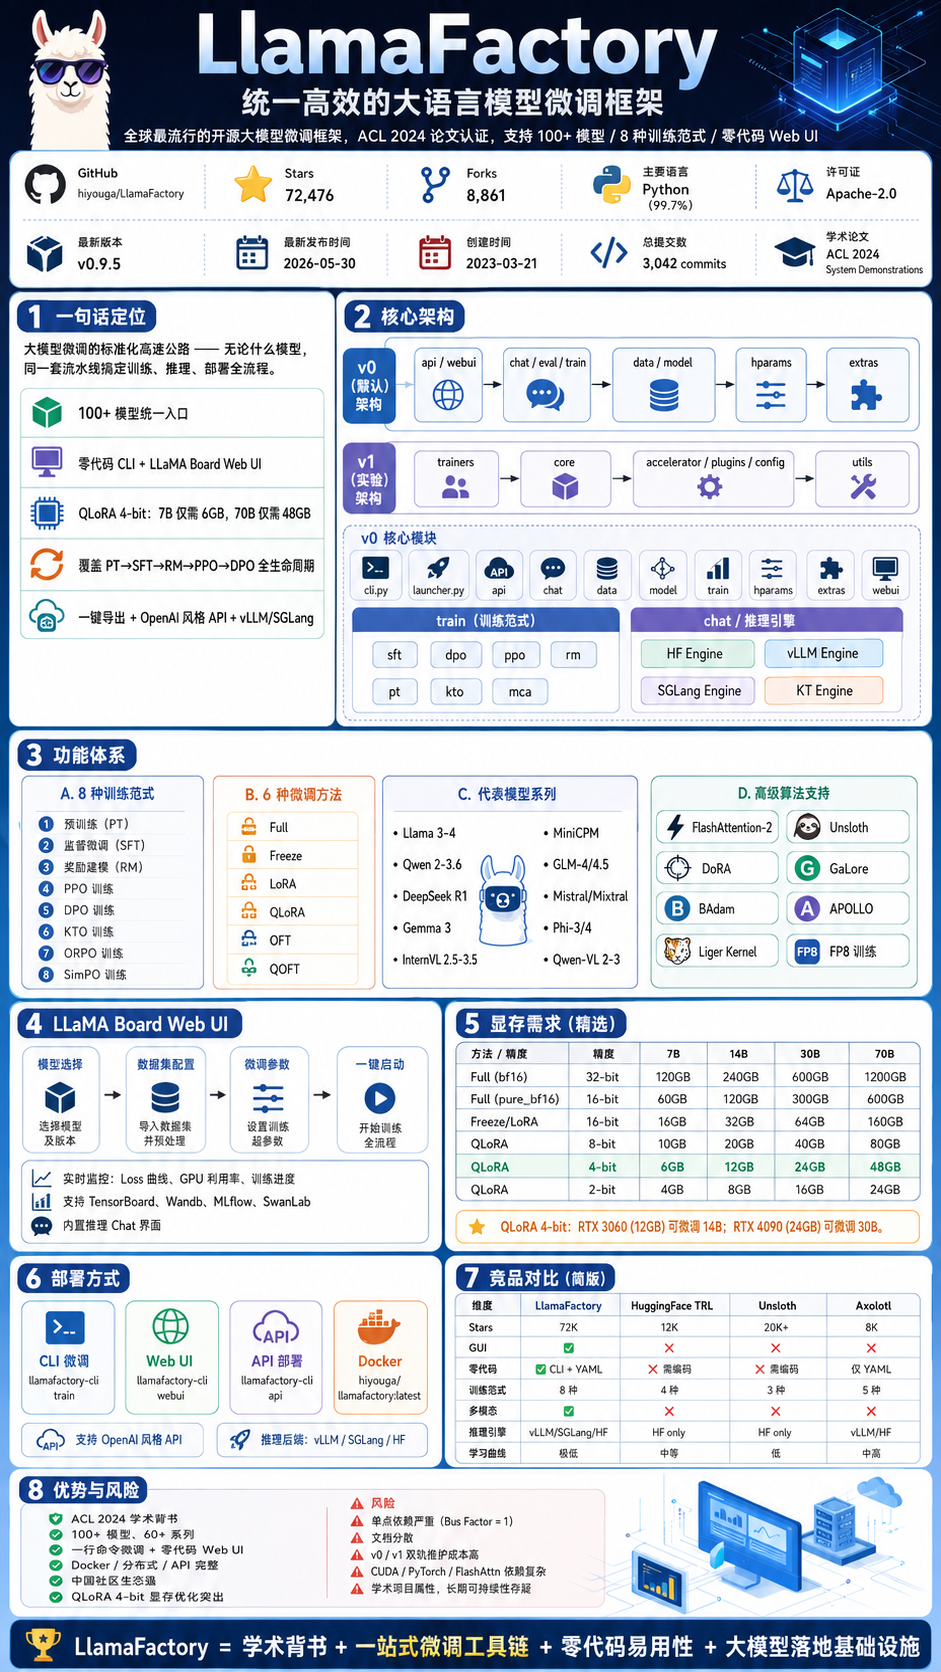
項目|詳細
プロジェクト正式名称|LlamaFactory(旧称 LLaMA-Factory)
GitHub アドレス|github.com/hiyouga/LlamaFactory
Stars|72,476 ⭐
Forks|8,861
主要言語|Python(99.7%)
ライセンス|Apache-2.0
作成日|2023-03-21
最新バージョン|v0.9.5(2026-05-30)
総コミット数|3,042 commits
主要コントリビューター|hiyouga(鄭耀威、総コミット数の 72% にあたる 2,188 commits)
学術論文|ACL 2024 System Demonstrations
リポジトリサイズ|~412.9 MB
Open Issues|57
創設者の鄭耀威(hiyouga)は北京航空航天大学の博士課程学生で、これまでに第一著者として ACL、CVPR、WWW などの国際トップ会議で複数の論文を発表し、AAAI、EMNLP などの会議で査読者も務めています。受賞歴には Huawei Cup、Lanqiao Cup 全国 1 等賞、北航大学生年間人物賞、昇騰エコシステム オープンソース卓越貢献賞などがあります。共同チームのメンバーには、北航の教授である張日崇、張俊豪、葉彦涵、羅哲炎、馮章馳、馬永強などがいます。
二、プロジェクトの位置づけと中核的価値
2.1 一言で表す位置づけ
標準化された大規模モデルのファインチューニングパイプライン:あらゆるモデルに適用できる統一プロセスで、データ準備、モデル学習、推論検証、デプロイまでの全工程をカバーします。
2.2 解決する主要な課題
課題|LLaMA Factory の解決策
モデルごとにファインチューニングの手順が異なり、切り替えコストが高い|アルゴリズム・モデル・データを「分離」する設計により、100 以上のモデルを統一的な入口で利用
ファインチューニングのコードは敷居が高く、深層学習の専門知識が必要|ゼロコード CLI + LLaMA Board Web UI(Gradio)
GPU メモリが不足し、コンシューマー向け GPU では大規模モデルを学習できない|QLoRA 4-bit:7B では 6GB、70B では 48GB のみ必要
オープンソースコミュニティにワンストップのツールチェーンが不足|PT→SFT→RM→PPO→DPO のライフサイクル全体をカバー
推論デプロイが複雑|ワンクリックエクスポート + OpenAI 形式 API + vLLM/SGLang
2.3 設計思想:アルゴリズム・モデル・データの「分離」
あるインタビューで、鄭耀威はモデルの推論プロセスを標準化された高速道路を走る車にたとえました。モデル自体はさまざまな種類の車に相当し、データは車に積載された貨物に相当します。モデルがこの高速道路上で正常に動作できれば、ファインチューニングはパラメーターを調整するだけで完了できます。
三、技術アーキテクチャの詳細分析
3.1 二重アーキテクチャの並行設計
LLaMA Factory は v0(安定版)と v1(実験版)の 2 つのアーキテクチャを同時に提供し、環境変数 USE_V1 を設定することで切り替えられます。
v0(デフォルト): api/webui → chat/eval/train → data/model → hparams → extras
v1(実験版): trainers → core → accelerator/plugins/config → utils
v0 アーキテクチャは現在の主要実装で、完全な機能と充実したドキュメントを提供します。v1 アーキテクチャはまだ実験段階で、よりモジュール化された階層設計を採用しています。
3.2 v0 コアモジュールの詳細
src/llamafactory/
├── cli.py              # CLI エントリーポイント、llamafactory-cli コマンドの振り分け
├── launcher.py          # USE_V1 に応じたランチャーの振り分け
├── api/                 # OpenAI 形式 REST API
│   ├── app.py           # FastAPI アプリケーション
│   ├── chat.py          # 対話エンドポイント
│   └── protocol.py      # プロトコル定義
├── chat/                # 推論エンジン層
│   ├── base_engine.py   # 抽象基底クラス
│   ├── hf_engine.py     # HuggingFace ネイティブ推論
│   ├── vllm_engine.py   # vLLM 高性能推論
│   └── sglang_engine.py # SGLang 推論
├── data/                # データ処理層
│   ├── template.py      # 100 以上のモデル用 Prompt テンプレート登録
│   ├── mm_plugin.py     # マルチモーダル(画像・動画・音声)処理
│   ├── loader.py        # データセットローダー
│   ├── processor/       # 学習段階別プロセッサー
│   └── converter.py     # 形式変換(Alpaca/ShareGPT)
├── model/               # モデル層
│   ├── loader.py        # モデル・トークナイザーの読み込み、量子化、LoRA
│   └── patcher.py       # モデル互換パッチ
├── train/               # 学習層
│   ├── sft/             # 教師ありファインチューニング
│   ├── dpo/             # DPO 選好最適化
│   ├── ppo/             # PPO 強化学習
│   ├── rm/              # 報酬モデリング
│   ├── pt/              # 事前学習
│   ├── kto/             # KTO 学習
│   └── mca/             # Megatron-Core 対応
├── hparams/              # パラメーター設定層
│   ├── model_args.py    # モデルパラメーター
│   ├── data_args.py     # データパラメーター
│   ├── finetuning_args.py # ファインチューニングパラメーター
│   └── training_args.py # 学習パラメーター(HF TrainingArguments を継承)
├── extras/               # ユーティリティ
│   ├── constants.py     # グローバル定数・列挙型
│   └── packages.py      # 依存関係チェック
└── webui/                # LLaMA Board Web インターフェース
    ├── interface.py     # Gradio インターフェース構築
    ├── runner.py        # 学習タスクの起動
    └── components/      # UI コンポーネント
3.3 学習フロー(v0 Training Flow)
llamafactory-cli train xxx.yaml
  → run_exp() [tuner.py]
    → read_args() → YAML/JSON 設定を解析
    → get_train_args() → 4 つの型付き dataclass を生成:
        ModelArguments + DataArguments + FinetuningArguments + TrainingArguments
    → 具体的な学習関数へルーティング:
        run_sft / run_dpo / run_ppo / run_rm / run_pt / run_kto
    → (任意) export_model() → LoRA 重みを統合してエクスポート
3.4 推論エンジンマトリックス
エンジン|特徴|適用シーン
HF Engine|ネイティブ HuggingFace、互換性が最も高い|開発・デバッグ、小規模推論
vLLM Engine|270% の推論高速化、PagedAttention|高性能オンライン推論
SGLang Engine|RadixAttention、構造化生成|バッチ推論、複雑な生成
KT Engine|知識転移専用|モデル蒸留
四、機能体系
4.1 対応する学習パラダイム(8 種類 × 6 種類のファインチューニング手法 = 48 種類の組み合わせ)
学習パラダイム|Full|Freeze|LoRA|QLoRA|OFT|QOFT
事前学習 (PT)|✅|✅|✅|✅|✅|✅
教師ありファインチューニング (SFT)|✅|✅|✅|✅|✅|✅
報酬モデリング (RM)|✅|✅|✅|✅|✅|✅
PPO 学習|✅|✅|✅|✅|✅|✅
DPO 学習|✅|✅|✅|✅|✅|✅
KTO 学習|✅|✅|✅|✅|✅|✅
ORPO 学習|✅|✅|✅|✅|✅|✅
SimPO 学習|✅|✅|✅|✅|✅|✅
4.2 対応するモデルシリーズ(60 以上のシリーズ、100 以上のバリエーション)
代表的なモデル:
モデルシリーズ|パラメータ規模|特徴
Llama 3-4|1B–402B|Metaのフラッグシップオープンソースモデル
Qwen 2-3.6|0.5B–397B|Alibaba通義千問の全シリーズ
DeepSeek R1|1.5B–671B|推論モデルの蒸留版
Gemma 3|270M–27B|Googleの軽量モデル
InternVL 2.5-3.5|1B–241B|マルチモーダル視覚言語モデル
MiniCPM|0.5B–9B|エッジデバイス向けに最適化
GLM-4/4.5|9B–355B|智譜のChatGLMシリーズ
Mistral/Mixtral|7B–8x22B|MoE専門家混合
Phi-3/4|3.8B–14B|Microsoftの小型・高性能モデル
Qwen-VL 2-3|2B–235B|視覚言語モデル
4.3 高度なアルゴリズムのサポート
アルゴリズム|機能|導入バージョン
FlashAttention-2|Attention計算の高速化|2023-09
Unsloth|トレーニングを170%高速化 + VRAMを50%節約|2023-12
DoRA|重み分解LoRA|2024-02
GaLore|勾配低ランク最適化|2024-03
BAdam|ブロック座標降下最適化|2024-04
APOLLO|高次最適化器|2025-Q1
Liger Kernel|Tritonカーネルによる高速化|2025
FP8トレーニング|Transformer Engineをサポート|2025
4.4 LLaMA Board Web UI
Gradioで構築されたノーコードのビジュアルインターフェース
モデル選択 → データセット設定 → 微調整パラメータ → ワンクリックでトレーニング開始
リアルタイム監視:Loss曲線、GPU使用率、トレーニング進捗
TensorBoard、Wandb、MLflow、SwanLabなど複数バックエンドのログに対応
推論用Chatインターフェースを内蔵し、トレーニング後すぐにテスト可能
4.5 デプロイ方法
# CLIによる微調整(1行コマンド)
llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml

# Web UI
llamafactory-cli webui

# OpenAI形式APIによるデプロイ
API_PORT=8000 llamafactory-cli api examples/inference/qwen3.yaml

# Docker
docker run -it --rm --gpus=all hiyouga/llamafactory:latest
五、ハードウェア要件(VRAM見積もり)
方式|精度|7B|14B|30B|70B
Full (bf16)|32-bit|120GB|240GB|600GB|1200GB
Full (pure_bf16)|16-bit|60GB|120GB|300GB|600GB
Freeze/LoRA|16-bit|16GB|32GB|64GB|160GB
QLoRA|8-bit|10GB|20GB|40GB|80GB
QLoRA|4-bit|6GB|12GB|24GB|48GB
QLoRA|2-bit|4GB|8GB|16GB|24GB
QLoRA 4‑bit量子化により、単体のRTX 3060(12 GB VRAM)で14 Bパラメータモデルを、単体のRTX 4090(24 GB VRAM)で30 Bパラメータモデルを微調整できます。
六、バージョンの変遷
バージョン|日付|主な変更
v0.1.0|2023-03|初回リリース、LLaMAの微調整をサポート
初期の反復|2023|SFT + LoRA/QLoRA、DPO、Web UI、FlashAttention-2、Unsloth
初期の反復|2024 Q1-Q3|DoRA、GaLore、BAdam、FSDP+QLoRA、vLLM、マルチモーダルLLaVA、論文発表
v0.9.1|2025 Q1|Llama 3.2 Vision、LLaVA-NeXT、Pixtral、Video-LLaVA
v0.9.2|2025 Q1|MiniCPM-o、SwanLab、APOLLOオプティマイザ
v0.9.3|2025 Q2|Llama 4、Gemma 3、Qwen3、InternVL3、Qwen2.5-Omni
v0.9.4|2025-12|🔄 リポジトリ名をLlamaFactoryに変更、Python 3.9-3.10を廃止
v0.9.5|2026-05-30|Qwen3.5/3.6、Gemma 4、Transformers v5に対応
v1.x(実験的)|2026|新アーキテクチャ trainers → core → accelerator、モジュール化された再設計
主なマイルストーンの解説
ACL 2024論文発表 —— 学術的評価によりStarsが1万から3万以上へ急増
2024年下半期 —— マルチモーダル対応(LLaVA/Video/音声)により新市場を開拓
2025年 —— 月次リリースのペースを維持し、Qwen3/DeepSeek/Llama4に対応。中国のオープンソースコミュニティで第一選択肢に
リポジトリ名の変更 —— LLaMA-Factory → LlamaFactory、Metaブランドへの依存を解消
v1実験アーキテクチャ —— 大規模な再構築が迫っていることを示唆
七、コミュニティエコシステム
7.1 プロジェクトエコシステム・マトリクス
プロジェクト|説明|Stars
LlamaFactory|中核微調整フレームワーク|72K+
EasyR1|VLM強化学習(GRPO/DAPO/Reinforce++)|新興
FastEdit|効率的なモデルの事実編集|アーカイブ済み
llamafactory-community|コミュニティ交流センター|-
Easy Dataset|合成データ生成ツール|サードパーティ
DataFlow|データ処理パイプライン|サードパーティ
7.2 コミュニティの盛り上がり
中国AIコミュニティ:CSDN、知乎、博客园に数百本のチュートリアル・実践記事
企業での採用:Alibaba Cloud、Huawei Ascend、Amazon AWS、NVIDIAが公式に推奨
教育分野:復旦大学をはじめ複数の大学で大規模モデル講座の教育ツールとして採用
中国語対応:ModelScope(魔搭コミュニティ)をネイティブサポート、OpenMind Hubミラーからダウンロード可能
LLaMA Factory Online:オンラインプラットフォームサービスを提供していたが、2026-06-20に終了
7.3 競合比較
フレームワーク|Stars|主な特徴|モデル対応|使いやすさ
LlamaFactory|72K|一体型GUI/CLI、ACL論文による裏付け|100+|⭐⭐⭐⭐⭐
HuggingFace TRL|12K|HF公式ツールチェーン、エコシステムとの深い統合|すべてのHFモデル|⭐⭐⭐
Axolotl|8K|YAML駆動、高度なユーザー向けカスタマイズ|主要モデル|⭐⭐⭐
Unsloth|20K+|極限の性能最適化(2-5x高速化)|LLaMA/Mistralなど|⭐⭐⭐⭐
Firefly|5K|中国語大規模モデルの最適化|主に中国語モデル|⭐⭐⭐
LLaMA-Adapter|6K|学術研究志向|LLaMAシリーズ|⭐⭐
LlamaFactoryの主な強み:
同時に ACL論文 + 7万Stars + 商用導入事例 + ノーコードGUI を持つ唯一のフレームワーク
モデルのカバー範囲が最も広い(GPT-2からLlama 4、テキストのみからマルチモーダルまで)
中国コミュニティのエコシステムが最も強い(HuggingFaceミラー + ModelScope統合)
八、SWOT分析
8.1 強み (Strengths)
強み|詳細
🔬 学術的権威性|ACL 2024論文、学術引用数500+件
🎯 極めて低い導入障壁|1行コマンドによる微調整、Web UIでノーコード操作
🌐 最も広いモデル対応|100+モデル、60+シリーズ、テキスト/視覚/動画/音声
🇨🇳 中国コミュニティエコシステム|ModelScope/OpenMindミラー、豊富な中国語チュートリアル
🔧 産業グレードのツールチェーン|Docker/分散/APIデプロイを網羅
💾 極限のVRAM最適化|QLoRA 4-bitでコンシューマー向けGPU上の70Bモデルを実行
8.2 弱み (Weaknesses)
弱み|詳細
👤 単一人物への依存が深刻|hiyougaがコミットの72%(2,188/3,042)を占め、Bus Factor = 1
📚 ドキュメントが分散|READMEが長大(68KB)で、Wiki/ReadTheDocs/コミュニティ記事の情報が断片化
🐛 Issueの滞留|Open Issuesは57件のみだが、Issueセクションでの議論量は膨大
🏗️ v0/v1の二重路線による分裂|二重アーキテクチャの保守コストが高く、v1の安定化が長期化
📦 パッケージ依存が複雑|CUDA/PyTorch/FlashAttnのバージョンマトリクスでエラーが起きやすい
🔒 学術プロジェクトとしての性質|専任運営チームがなく、長期的な持続可能性に懸念
8.3 機会 (Opportunities)
機会|詳細
🚀 Agent微調整の分野|Function Calling / Tool Useの微調整需要が急増
🎥 マルチモーダル拡張|Video/Audio/3Dモデル微調整のブルーオーシャン市場
☁️ クラウドネイティブSaaS|LLaMA Factory Onlineは終了したが、企業向けマネージドサービスの需要は残る
🏢 企業研修市場|大規模モデル微調整の研修コース、認定制度
🔗 MCP統合|AI Agentインフラの微調整バックエンドとして
8.4 脅威 (Threats)
脅威|詳細
🏢 大手企業の自社開発フレームワーク|Alibaba PAI、Huawei ModelArtsが統合ソリューションを提供
🔄 HF公式との競争|HuggingFace TRL/peftエコシステムが成熟化
📉 微調整需要の縮小|Prompt Engineering + RAGが微調整の一部の用途を代替
👨🎓 創設者の卒業|鄭耀威博士の卒業後、プロジェクトの保守に割ける力が低下する可能性
九、リスク評価
リスクカテゴリ|リスクレベル|説明
Bus Factor|🔴 高リスク|単一のコア開発者がコミットの 72% を占めており、離脱した場合にプロジェクトが停滞するリスクが極めて高い
技術的負債|🟡 中リスク|v0/v1 の二重アーキテクチャ、68KB の README、ドキュメントの断片化
依存関係|🟡 中リスク|CUDA/PyTorch/FlashAttn のバージョンマトリクスの維持コストが高い
商用化|🟢 低リスク|Apache-2.0 ライセンスで、商用上の制限なし
コミュニティの健全性|🟢 健全|7.2 万 Stars、活発なグローバルコミュニティ、企業での幅広い採用
十、技術的な見どころと革新性
10.1 「標準化された高速道路」アーキテクチャ
従来のファインチューニングでは、モデルごとに個別の適応が必要です。LLaMA Factory はテンプレート登録メカニズムと monkey‑patch 技術を組み合わせ、適応コストを大幅に削減しています。
# 新しいモデルの追加に必要なのは 3 ステップだけ:
# 1. template.py の TEMPLATES 辞書に Prompt テンプレートを登録
# 2. patcher.py にモデル互換パッチを追加(必要な場合)
# 3. mm_plugin.py にマルチモーダル対応を追加(必要な場合)
10.2 4 層パラメータ設定システム
YAML/JSON 設定ファイル
  → parser.py で解析
    → ModelArguments(モデル選択、量子化)
    → DataArguments(データセット、テンプレート、前処理)
    → FinetuningArguments(LoRA rank/target、学習手法)
    → TrainingArguments(HF を継承、分散処理/ログ/checkpoint)
10.3 データパイプラインの標準化
本ツールは Alpaca と ShareGPT の 2 種類の主要データ形式に対応し、50 を超えるプリセットデータセットを自動変換できます。また、JSON、JSONL、CSV、Parquet、Arrow などのファイル形式にも対応しています。
10.4 段階的な量子化サポート
16 ビットのフル精度から 2 ビット QLoRA まで、6 種類の精度レベルに対応しており、A100 サーバークラスターから一般的なノートパソコンまで、さまざまなハードウェア環境で利用できます。
十一、競合製品比較マトリクス
項目|LlamaFactory|HuggingFace TRL|Unsloth|Axolotl
Stars|72K|12K|20K+|8K
モデル対応|100+ シリーズ|すべての HF|LLaMA/Qwen/Mistral|主要シリーズ
GUI|✅ LLaMA Board|❌|❌|❌
ノーコード|✅ CLI + YAML|❌ コーディングが必要|❌ コーディングが必要|YAML のみ
学習パラダイム|8 種|4 種 (SFT/DPO/PPO/GRPO)|3 種|5 種
量子化の対応範囲|2-16bit|4-16bit|4-16bit|4-16bit
マルチモーダル|✅ 画像/動画/音声|❌|❌|❌
中国語エコシステム|✅ ModelScope + 魔搭|⚠️ VPN が必要|⚠️ VPN が必要|❌
学術論文|ACL 2024|-|-|-
推論エンジン|vLLM/SGLang/HF|HF のみ|HF のみ|vLLM/HF
学習曲線|非常に低い|中程度|低い|中〜高
十二、デプロイ実践のポイント
12.1 クイックスタート(3 ステップ)
# Step 1: インストール
git clone --depth 1 github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e ".[torch,metrics]"

# Step 2: Web UI を起動
llamafactory-cli webui

# Step 3: ブラウザで localhost:7860 を開き、モデル → データセット → 学習を選択!
12.2 本番環境での推奨事項
# Docker デプロイ(推奨)
docker run -it --rm --gpus=all \
    -v ./hf_cache:/root/.cache/huggingface \
    -v ./data:/app/shared_data \
    -v ./output:/app/output \
    -p 7860:7860 -p 8000:8000 \
    hiyouga/llamafactory:latest

# API デプロイ(OpenAI 互換)
API_PORT=8000 llamafactory-cli api \
    examples/inference/qwen3.yaml \
    infer_backend=vllm
12.3 Windows ユーザーへの注意事項
PyTorch の GPU 版を手動でインストールする必要があります:
pip install torch torchvision torchaudio --index-url download.pytorch.org/whl/cu126QLoRA には Windows 専用の bitsandbytes コンパイル済みバージョンのインストールが必要です
Windows 上で FlashAttention-2 を使用するには手動コンパイルが必要です
シリアライズエラーを避けるため、
dataloader_num_workers: 0を設定してください
十三、今後の展望
v1 アーキテクチャの安定化:実験ブランチは 2026-2027 年にメインアーキテクチャとなる見込みで、モジュール化の度合いがさらに高まります
Agent ファインチューニングの深化:Tool Use / Function Calling のファインチューニングが標準機能になります
推論モデル (Reasoning) のファインチューニング:DeepSeek-R1 蒸留 + GRPO ファインチューニング(EasyR1 プロジェクト)
クラウドネイティブなホスティング:LLaMA Factory Online の終了後、サードパーティのホスティングサービスが登場する可能性があります
マルチモーダル学習の統合:テキスト/画像/動画/音声を同一フレームワーク内でファインチューニング
十四、評価とまとめ
項目|評価|講評
技術アーキテクチャ|9.5/10|モジュール設計、二重アーキテクチャの進化、豊富なエンジンマトリクス
機能の完全性|10/10|8 種の学習パラダイム × 6 種のファインチューニング手法 × 100+ モデル
使いやすさ|10/10|1 行のコマンドによるファインチューニング + ノーコード Web UI、業界最高水準
ドキュメント品質|7.5/10|README は詳細だが長すぎ、断片化が深刻
コミュニティの活発さ|9.5/10|72K Stars、中国コミュニティで圧倒的な人気
本番運用への適合度|9.0/10|Docker/API/分散処理が充実し、企業での検証も十分
持続可能性|6.5/10|Bus Factor=1、学術プロジェクトとしての性質があり、長期的には不透明
革新性|8.5/10|ACL 論文、テンプレート登録メカニズム、4 層パラメータシステム
総合評価:9.
一言でまとめると
LLaMA Factory は、ACL 2024 論文に基づいて実装されたオープンソースの大規模モデルファインチューニングフレームワークであり、GitHub で約 72 000 個のスターを獲得してコミュニティから支持されています。フレームワークは「アルゴリズム・モデル・データの分離」という設計理念に従い、ノーコードのコマンドラインインターフェース(CLI)と Web UI を提供します。100 種類を超えるモデルのファインチューニングに対応し、大規模モデルのファインチューニングに必要な技術的ハードルを大幅に下げています。大規模モデルアプリケーションを実用化するための基盤として利用できます。