

まず利用範囲を確認する
ARTEX は、個人の学習、コード研究、ローカルの隔離環境における技術検証のみに使用してください。プロジェクトの声明に基づき、所有または許可を得ている対象であっても、オンラインシステム、Webサイト、ネットワーク接続されたシステム、本番環境に対するスキャン、探索、悪用、攻撃に使用することはできません。開始前に、プロジェクトの AGPL-3.0 ライセンス、所在地のサイバーセキュリティ関連法規、リポジトリに記載された利用制限および免責事項を理解し、遵守することを確認してください。
この記事では、ローカル環境へのデプロイと安全な隔離環境を前提に、ARTEX のインストール、PostgreSQL と LLM の設定、インターフェースからのタスク確認、アセット同期や脆弱性の再テストなどの機能について説明します。
ARTEX は、Go バックエンドと Next.js フロントエンドで構成された AI マルチエージェントシステムです。プロジェクトには、操作感を確認できるオンライン Demoが用意されています。本番実行時には、Go の go:embed を使ってフロントエンドを単一バイナリに組み込めます。
ARTEX でできること
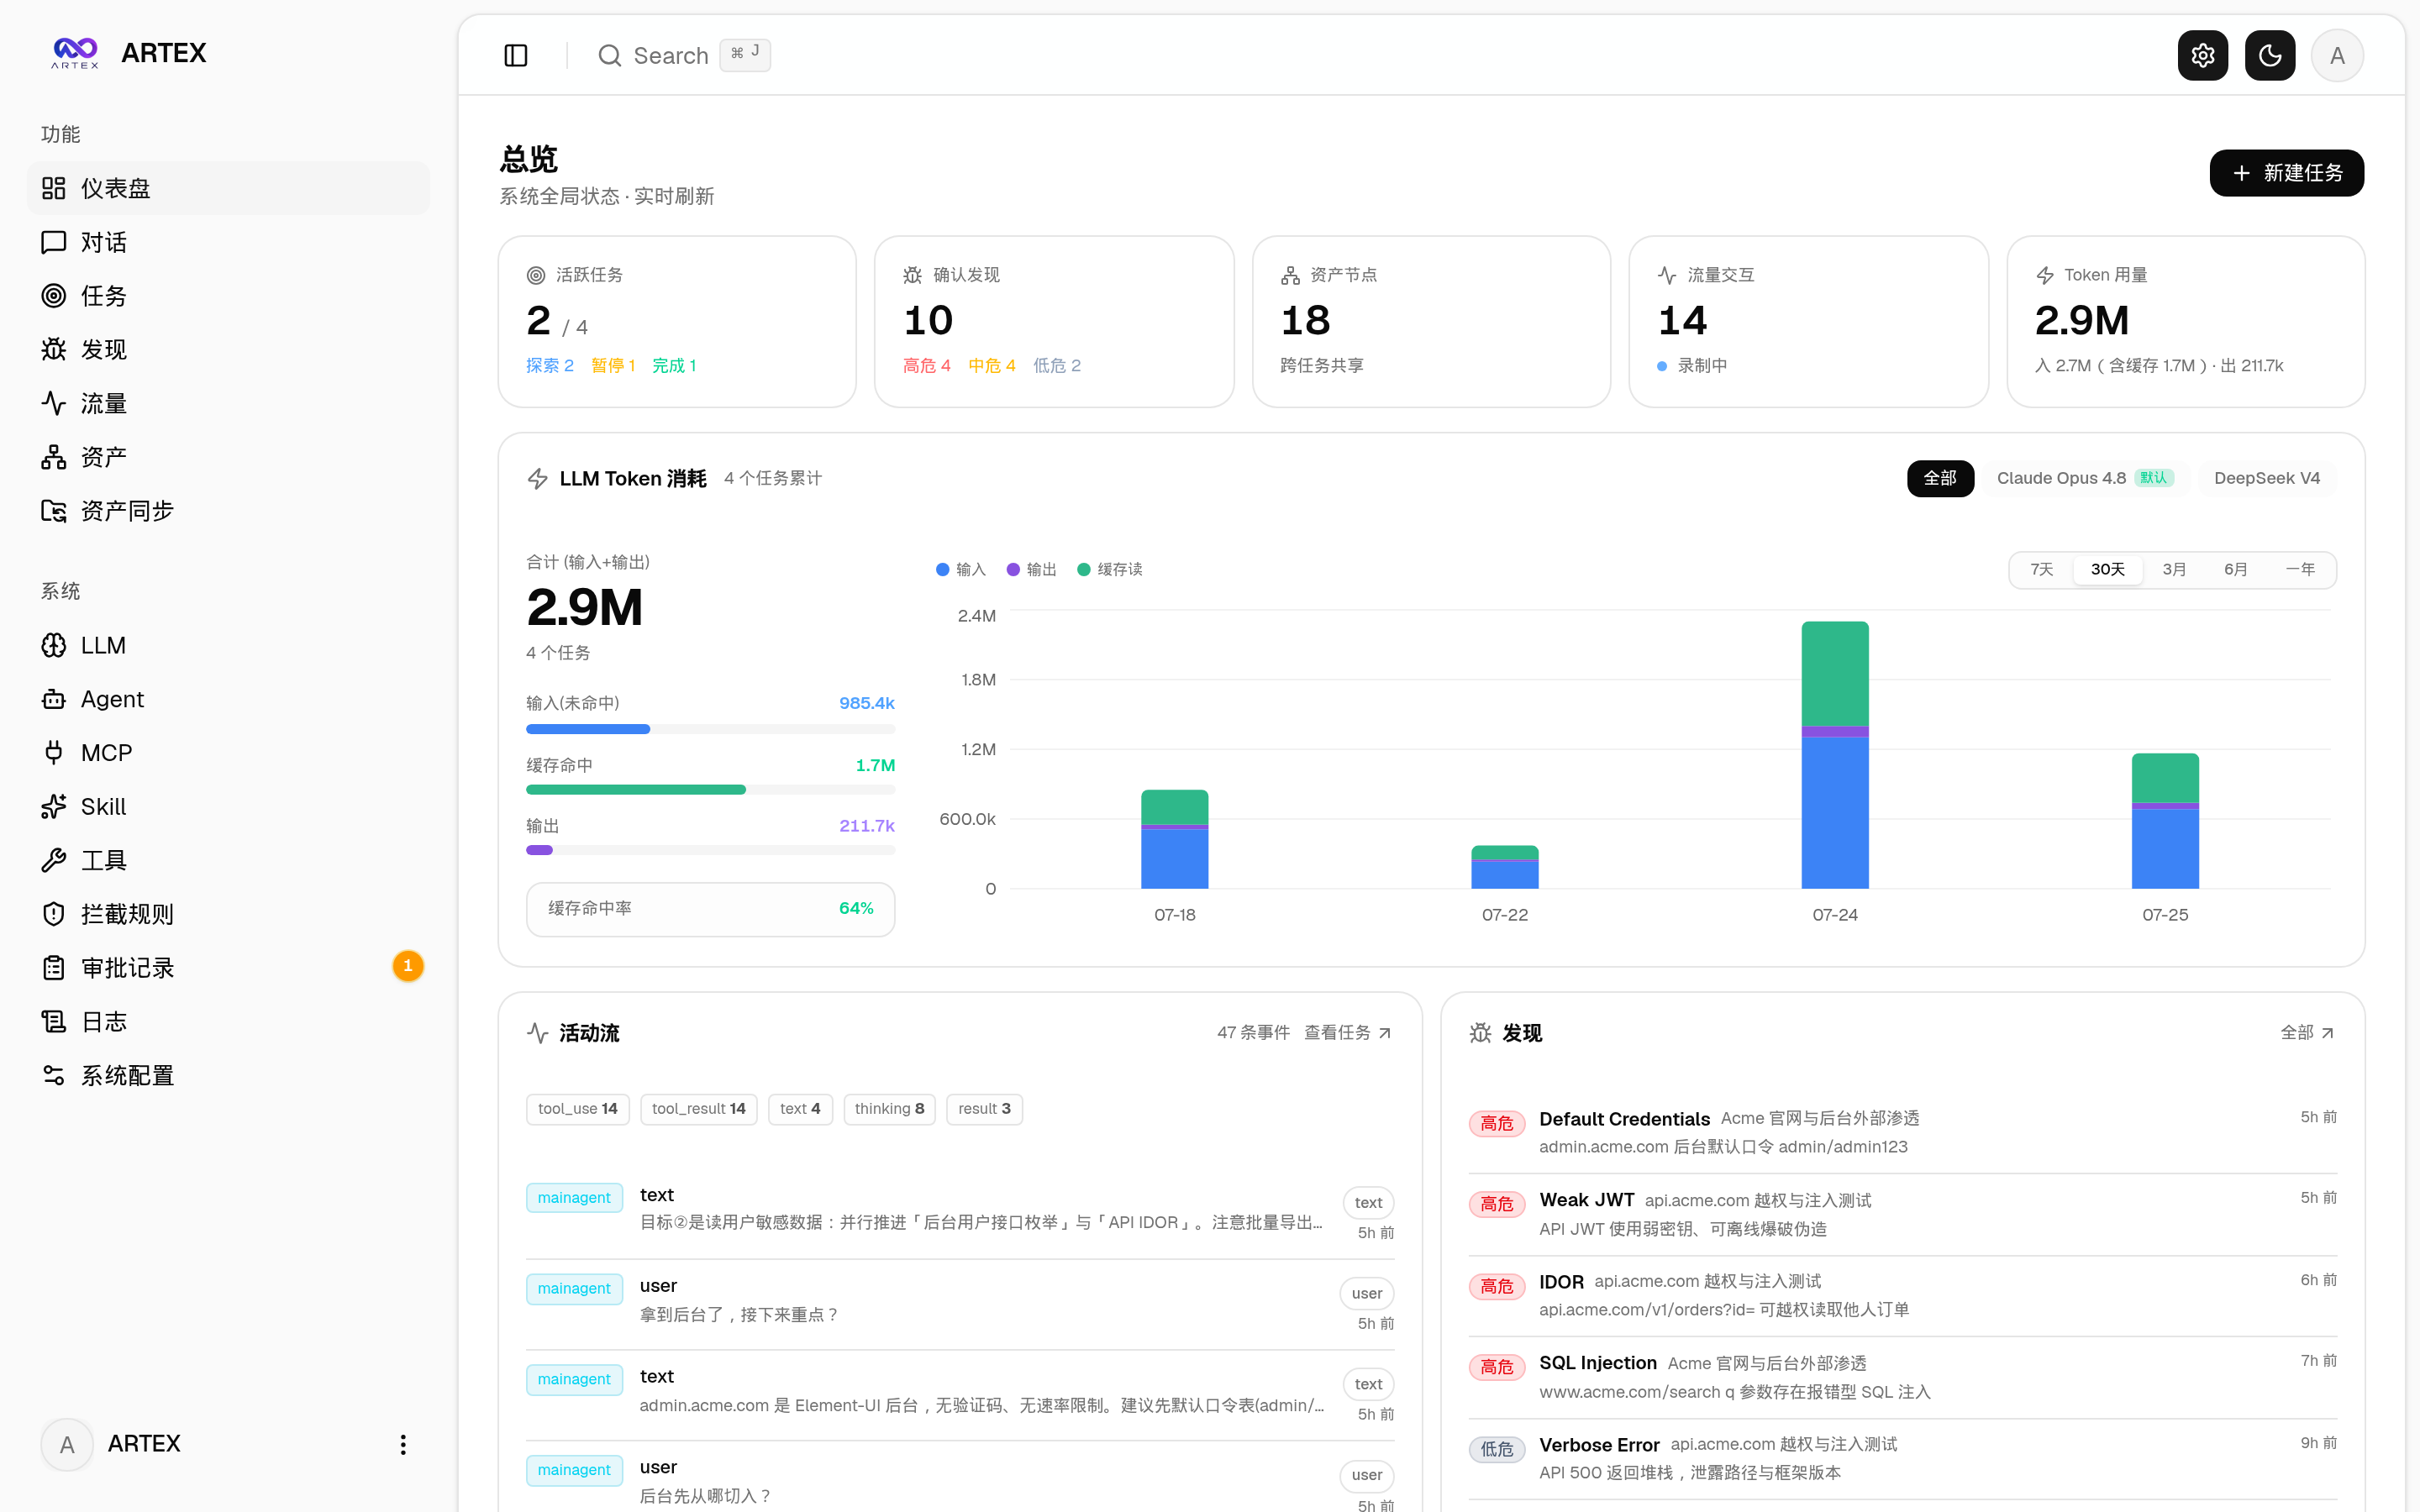
ARTEX は、自律的な探索、タスクのオーケストレーション、プロセスの記録を中心に構築されています。システムには、ダッシュボード、タスク一覧、セッション実行プロセス、探索チェーン、検出結果、アセット、アセットカバレッジマップ、トラフィック記録、ヒューマン・イン・ザ・ループ対話、Agent 管理、LLM 設定などの画面があります。
- マルチエージェント探索:goals、planner、worker、mainagent などの役割が連携してタスクを進めます。
- 2種類のグラフモデル:アセットグラフはタスクをまたいで共有されるアセットの事実を保存し、探索グラフは個別タスクの目標、意図、事実、プロンプト、検出結果を記録します。
- プロセスレベルの情報交換:worker は他の worker の実行プロセスを検索し、そこから得られた観察結果を再利用できます。
- ヒューマン・イン・ザ・ループ:対話とインターセプト承認を通じて、ツール呼び出しや重要な操作の判断に参加できます。
- リアルタイムアクティビティストリーム:バックエンドは SSE でアクティビティ情報を配信し、タスクの実行状況を画面上で継続的に確認できます。
- トラフィック記録:記録型 MITM プロキシが、ツール実行時のトラフィックと証拠を保存します。
- アセット同期:ScopeSentry から、ドメイン、サブドメイン、IP、ポート、サイト、エンドポイントなどのアセットを同期できます。
- 脆弱性の再テスト:既存の脆弱性に対して個別に再テスト Agent セッションを作成し、結論、証拠、セッションリンクを保存できます。
ARTEX をインストールする
方法1:ワンステップインストールスクリプトを使用する
プロジェクトが推奨するインストール方法です。スクリプトは Docker の有無を確認して必要に応じてインストールし、Docker のみで実行する方法と、ローカルでコンパイルして実行する方法を選択できます。
git clone https://github.com/Autumn-27/ARTEX.git
cd ARTEX
./install.sh
すべてを Docker で実行する場合は、PostgreSQL のパスワードを入力します。Enter キーを押して、スクリプトにランダムなパスワードを生成させることもできます。その後、スクリプトが .env を書き込み、docker compose up -d を実行します。
ローカル実行を選択した場合は、既存のデータベースに接続することも、Docker でデータベースを起動することもできます。スクリプトは config.json を生成し、フロントエンドを含む単一バイナリをコンパイルしてサービスを起動します。
インストール完了後、http://localhost:8787 にアクセスします。初回アクセス時に /setup を開き、管理者パスワードを設定してください。
方法2:Docker Compose を手動で使用する
git clone https://github.com/Autumn-27/ARTEX.git
cd ARTEX
cp .env.example .env
docker compose up -d
.env を編集し、少なくとも POSTGRES_PASSWORD を設定してください。環境変数で Anthropic を設定する場合は、ANTHROPIC_API_KEY も設定できます。コンテナイメージには一般的なツールが含まれており、./skills と ./data はバインドマウントによって保持されます。
起動後、http://localhost:8787 にアクセスします。リモート MCP が必要な場合は、システム設定で http または sse を選択できます。旧版 SSE では通常、/sse でイベントストリームを確立し、返された /message?sessionId=... で JSON-RPC リクエストを受信します。認証リクエストヘッダーは Authorization=Bearer <token> として設定します。
方法3:ビルド済みバイナリを使用する
Releases から対応するプラットフォームの圧縮パッケージをダウンロードして解凍します。通常、artex、start.sh または Windows 用の start.bat、skills/、config.example.json が含まれています。
cp config.example.json config.json
./start.sh
起動には start.sh または start.bat を使用し、./artex を直接実行しないでください。起動スクリプトはプロセスを監視し、ページからワンクリックで更新した後の再起動にも対応します。バックグラウンドで実行する場合は、次のコマンドを使用できます。
nohup ./start.sh >artex.log 2>&1 &方法4:ソースコードからビルドする
フロントエンドを組み込んだ単一バイナリをソースコードから構築する場合は、まず Next.js の静的ファイルを生成し、バックエンドの組み込み用ディレクトリにコピーします。
cd web && npm ci && npm run build:static && cd ..
cp -r web/out server/webui/dist
CGO_ENABLED=0 go build -tags embedui -o artex ./cmd/artex
./start.sh
基本設定を完了する
PostgreSQL を設定する
ARTEX は PostgreSQL に依存します。ローカル実行方式を使用する場合は、config.json にデータベース接続情報を記入するか、ARTEX_PG_DSN で設定を上書きできます。
{
  "database": {
    "host": "127.0.0.1",
    "port": 5432,
    "user": "artex",
    "password": "yourpass",
    "dbname": "artex",
    "sslmode": "disable"
  }
}
サービスは起動するたびに、必要なフィールドやインデックスの変更を含むデータベース構造の初期化とマイグレーションを冪等的に実行します。アップグレード前には、データベースと ./data ディレクトリをバックアップすることを推奨します。
LLM を設定する
探索機能には LLM が必要です。Anthropic または OpenAI の API Key を使用するか、画面の「LLM 設定」ページで入力できます。
export ANTHROPIC_API_KEY=sk-...OPENAI_API_KEY も設定できます。また、ARTEX_LLM_PROVIDER、ARTEX_LLM_MODEL、ARTEX_LLM_BASE_URL、ARTEX_LLM_PROXY によって、プロバイダー、モデル、アドレス、プロキシを調整できます。
同時実行数とポートを調整する
各タスクの work agent 数は「システム設定」で調整できます。デフォルト値は 3 です。起動パラメーターでは、Web/API アドレスとトラフィック記録プロキシのポートを設定できます。
./start.sh -addr :8787 -proxy :8788起動スクリプトは、パラメーターをそのまま artex に渡します。
Web インターフェースを使い始める
1. ログインしてダッシュボードを確認する
初回アクセス時に管理者パスワードを設定し、ダッシュボードで概要、Token 消費量、アクティビティストリームを確認します。ダッシュボードは、システムが正常に動作しているか、タスクで新しいアクティビティが発生しているかをすばやく判断するのに適しています。
2. タスクと実行プロセスを確認する
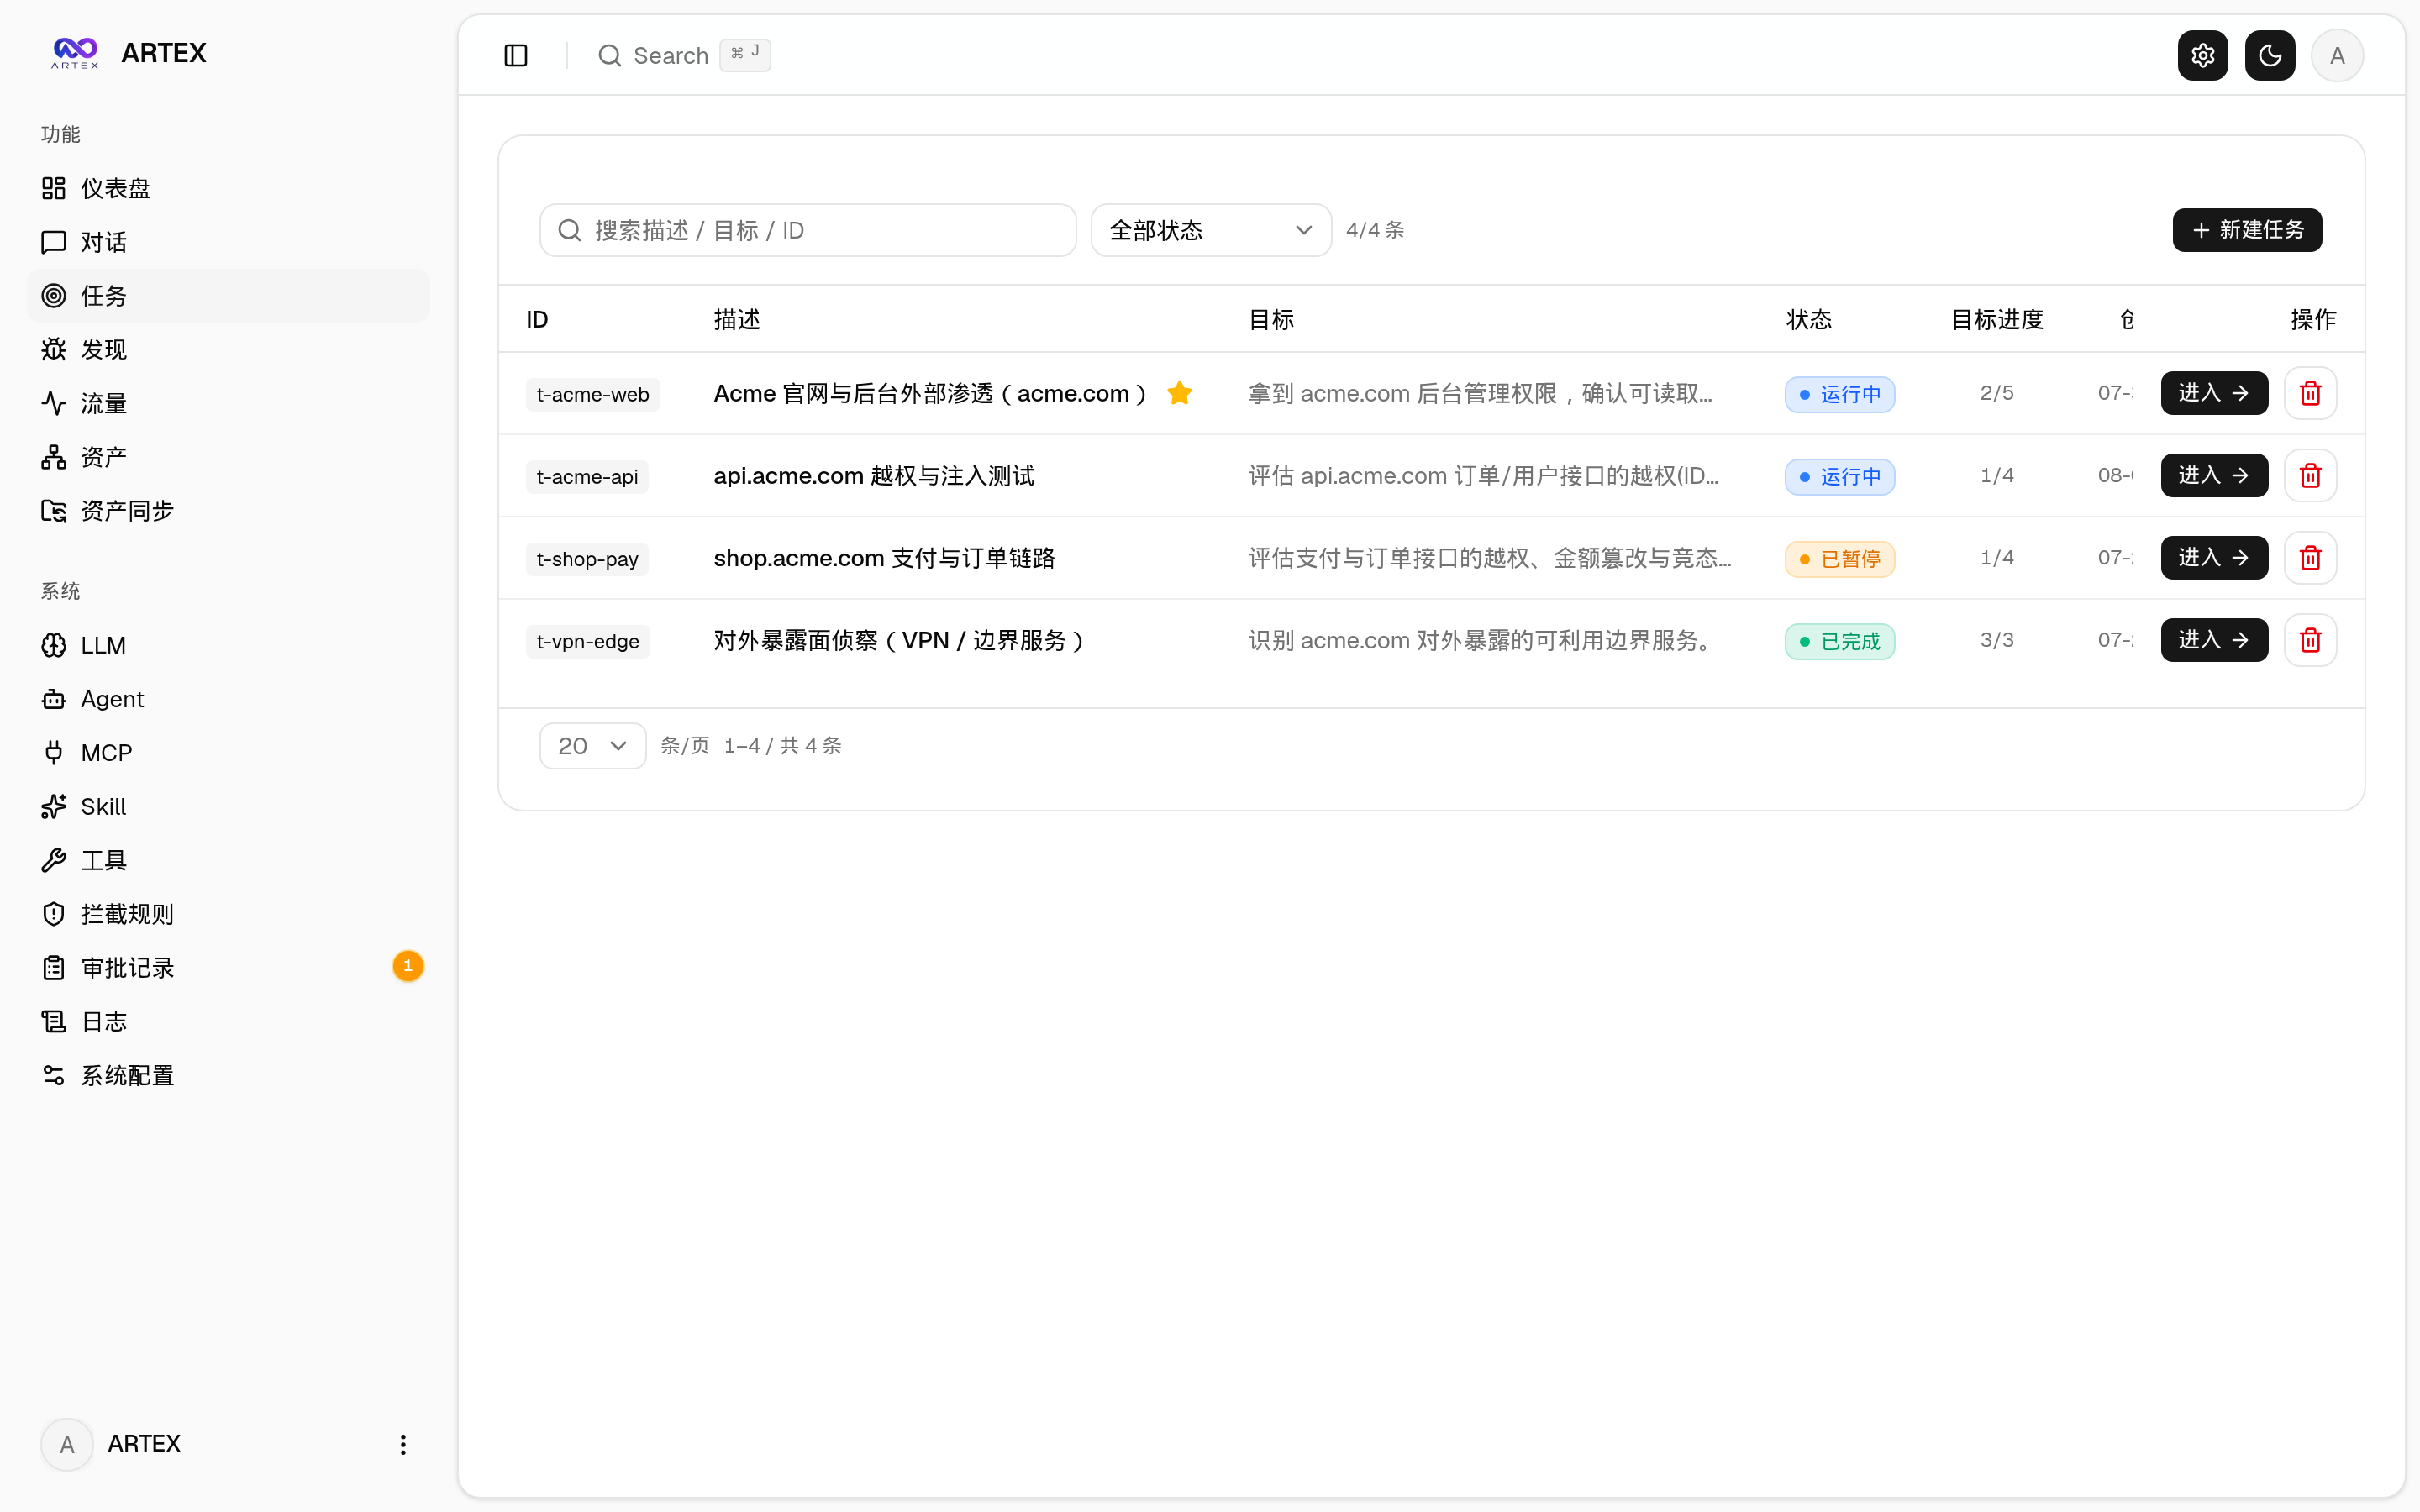
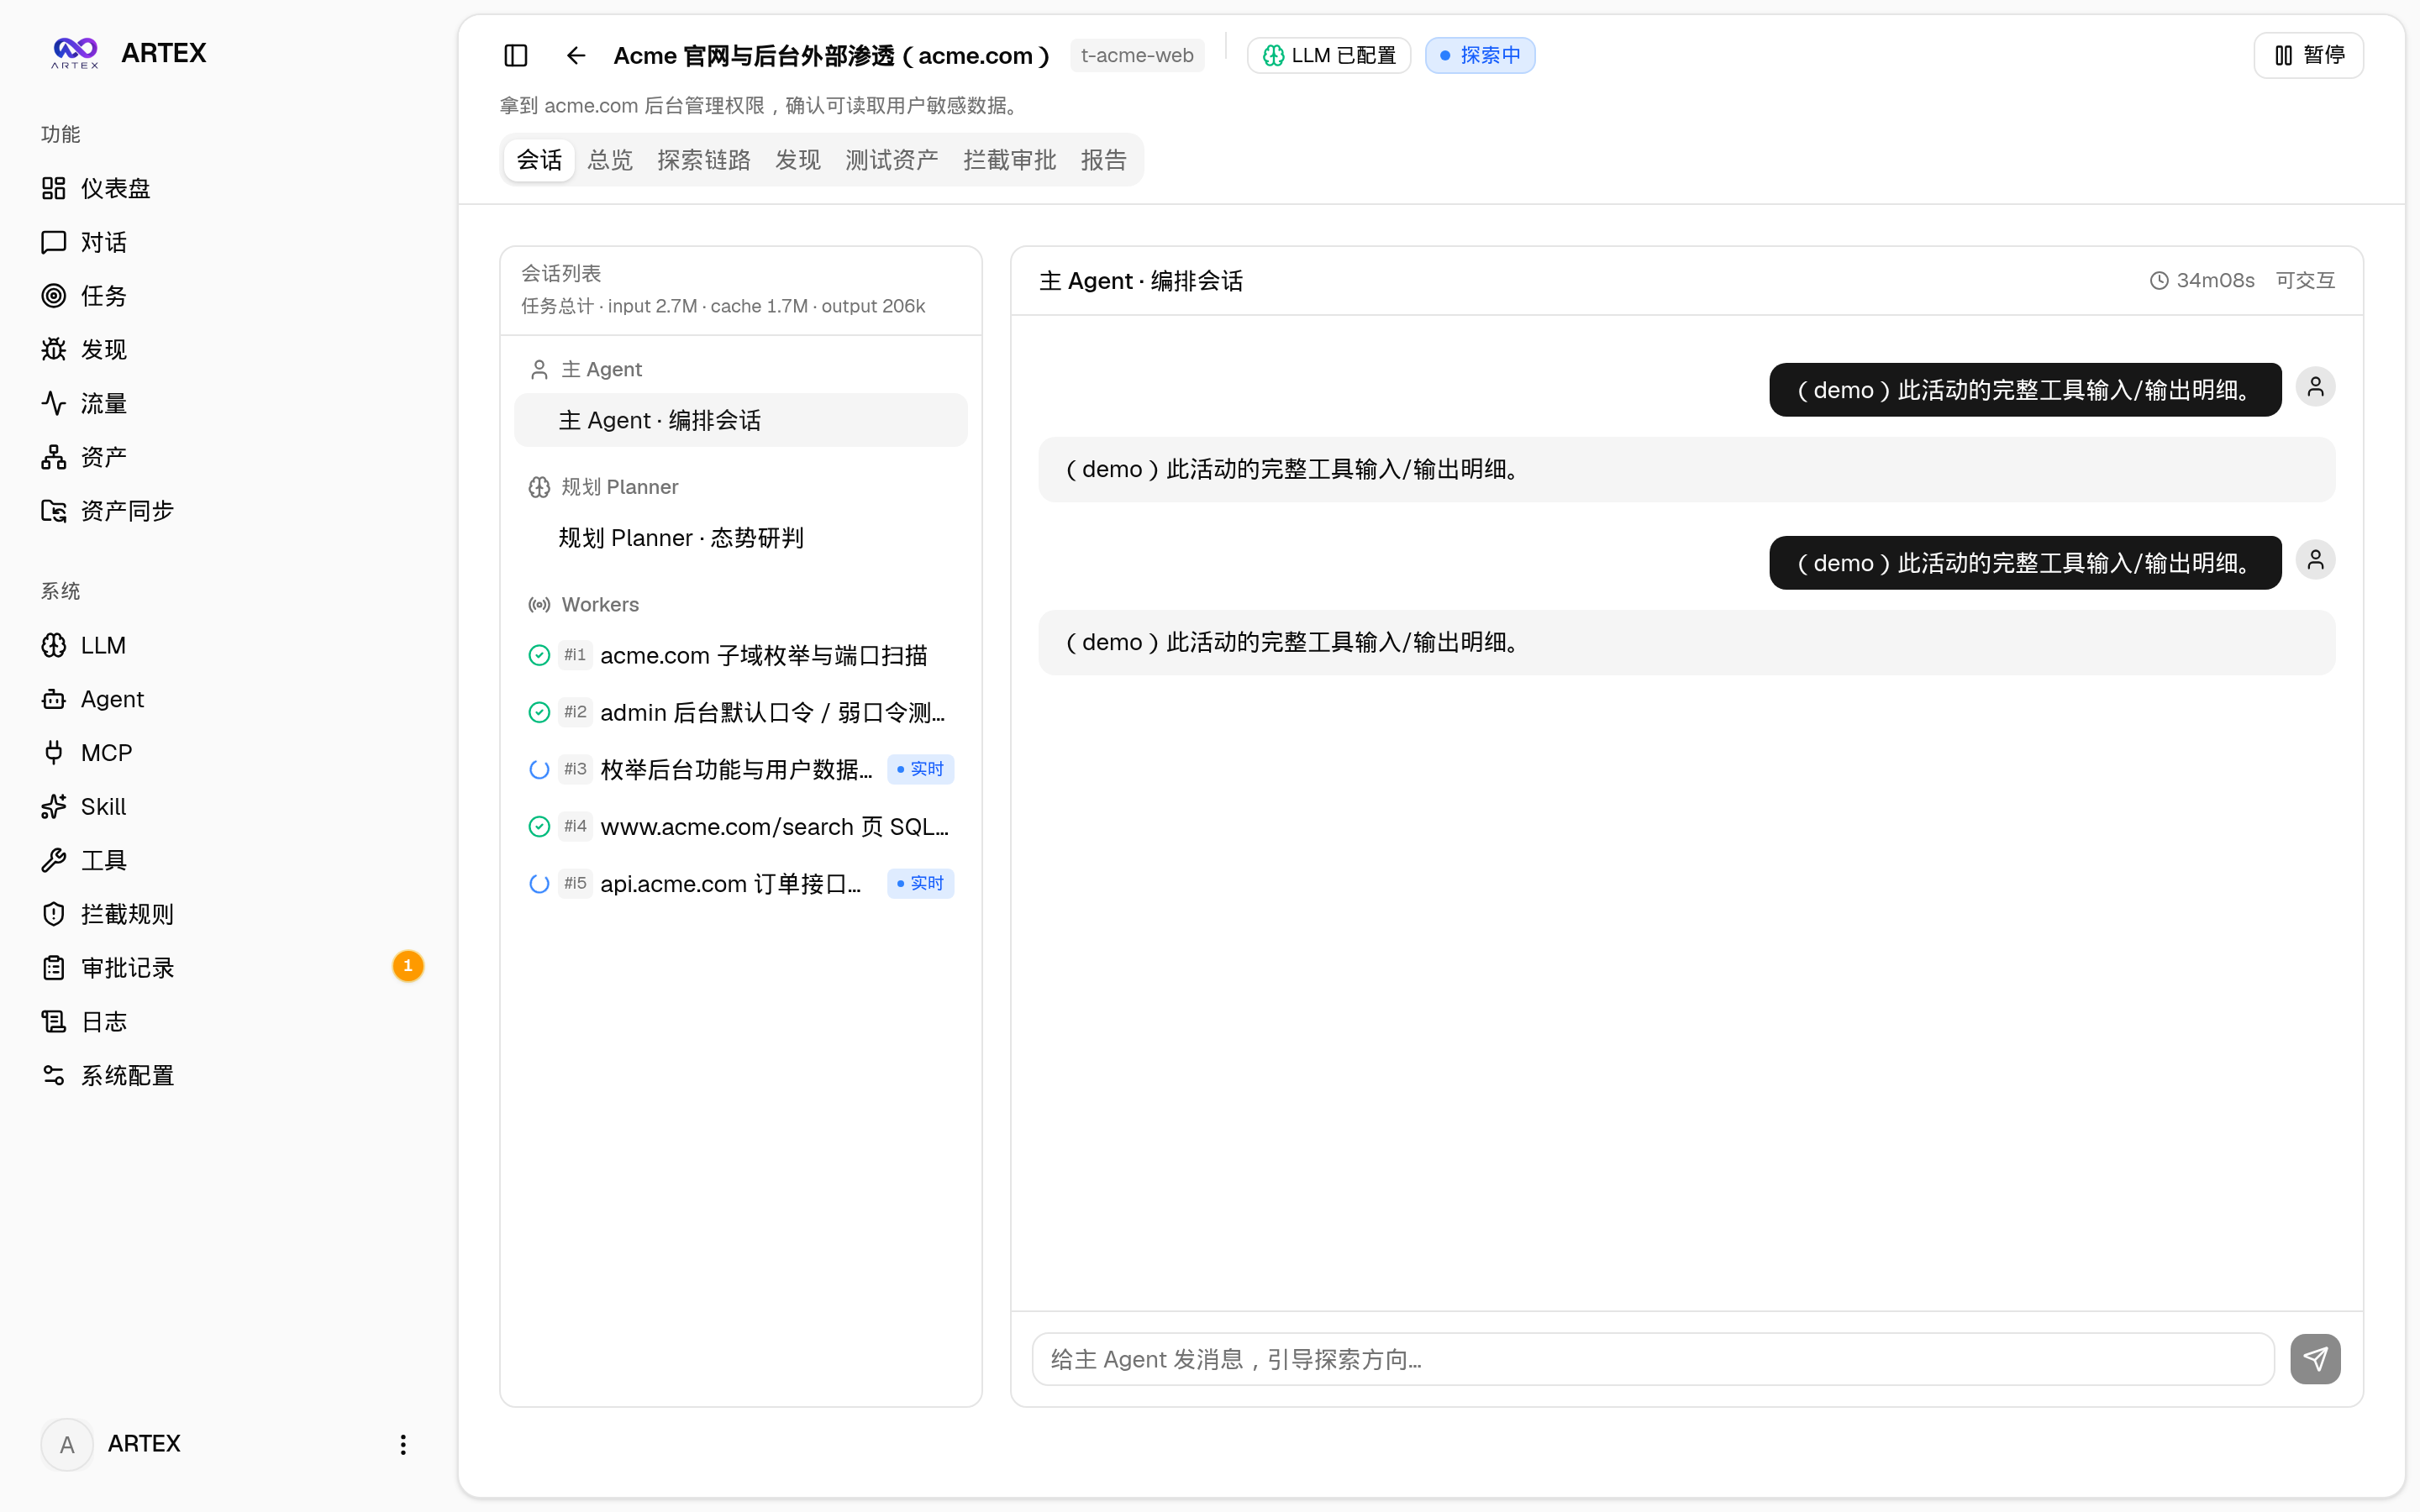
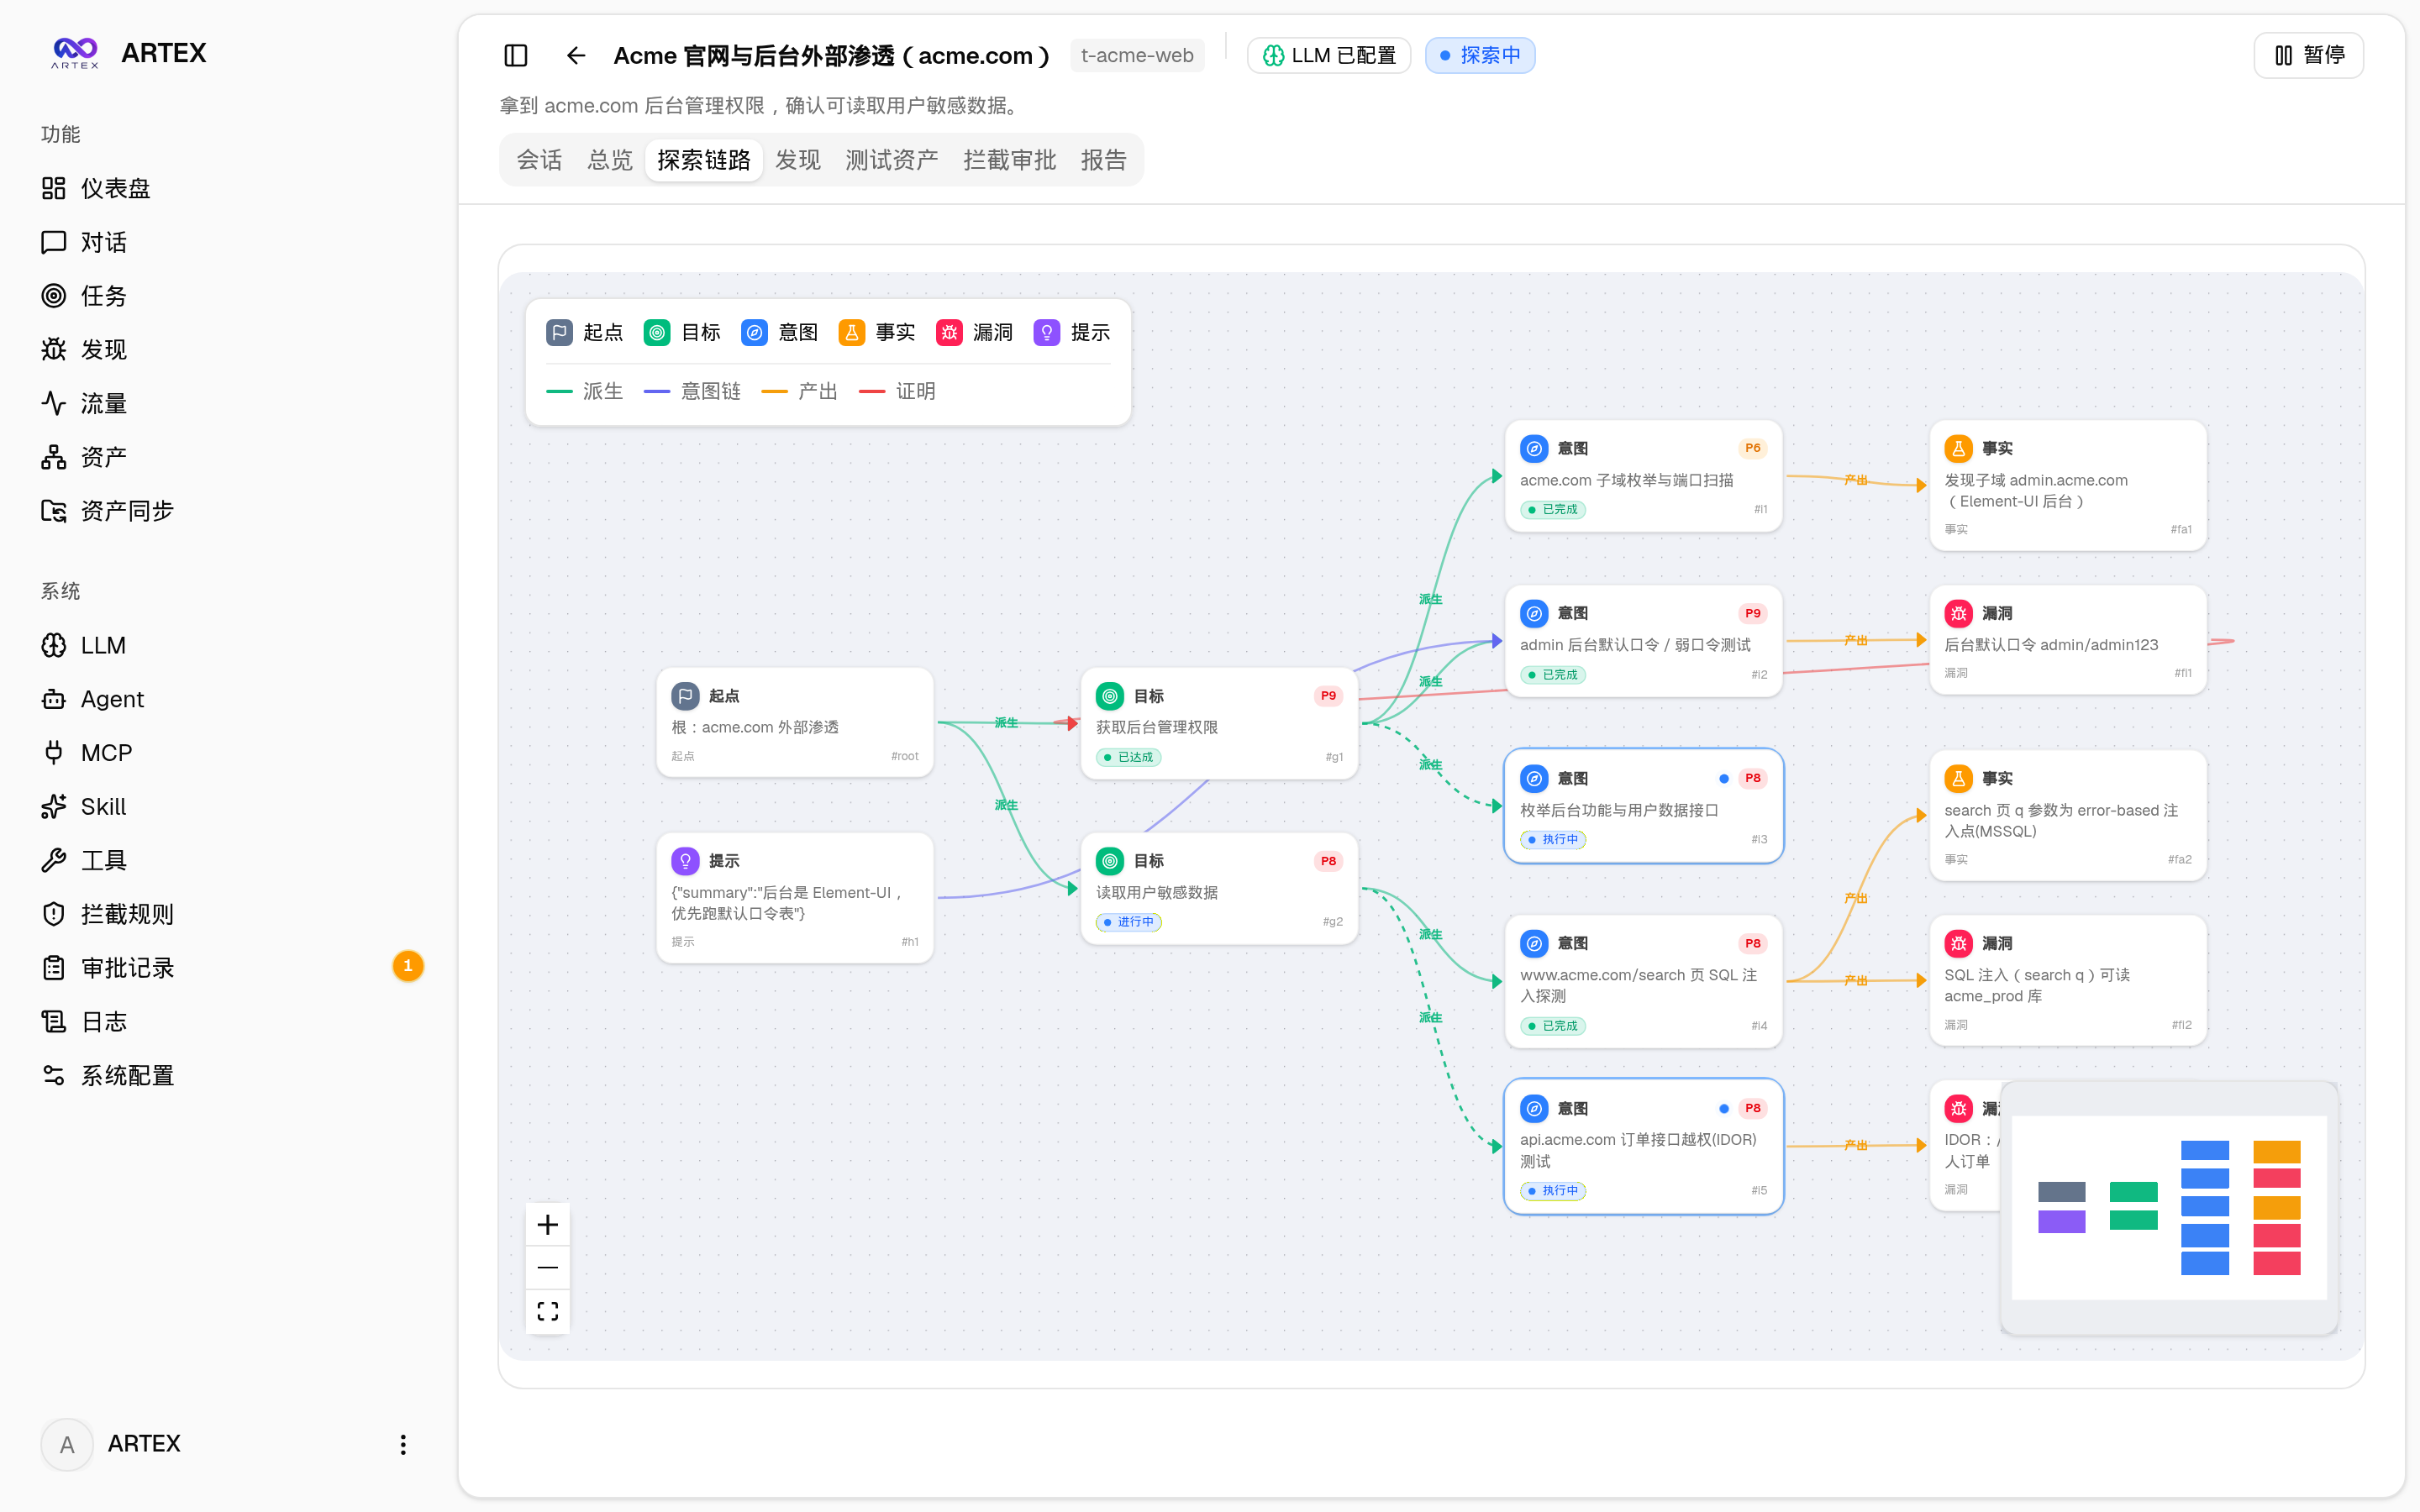
タスク一覧から対象タスクを選択すると、そのセッション、ツール呼び出し、アクティビティ記録、探索チェーンを確認できます。実行プロセス画面には agent の作業手順が表示され、探索チェーンでは目標、意図、事実、検出結果の関係を理解できます。
これらの画面を使用する際は、まずローカルの隔離環境で手順を検証し、アクティビティ記録とトラフィック記録を通じて、agent が実際に実行した手順を確認してください。
3. 検出結果とアセットを確認する
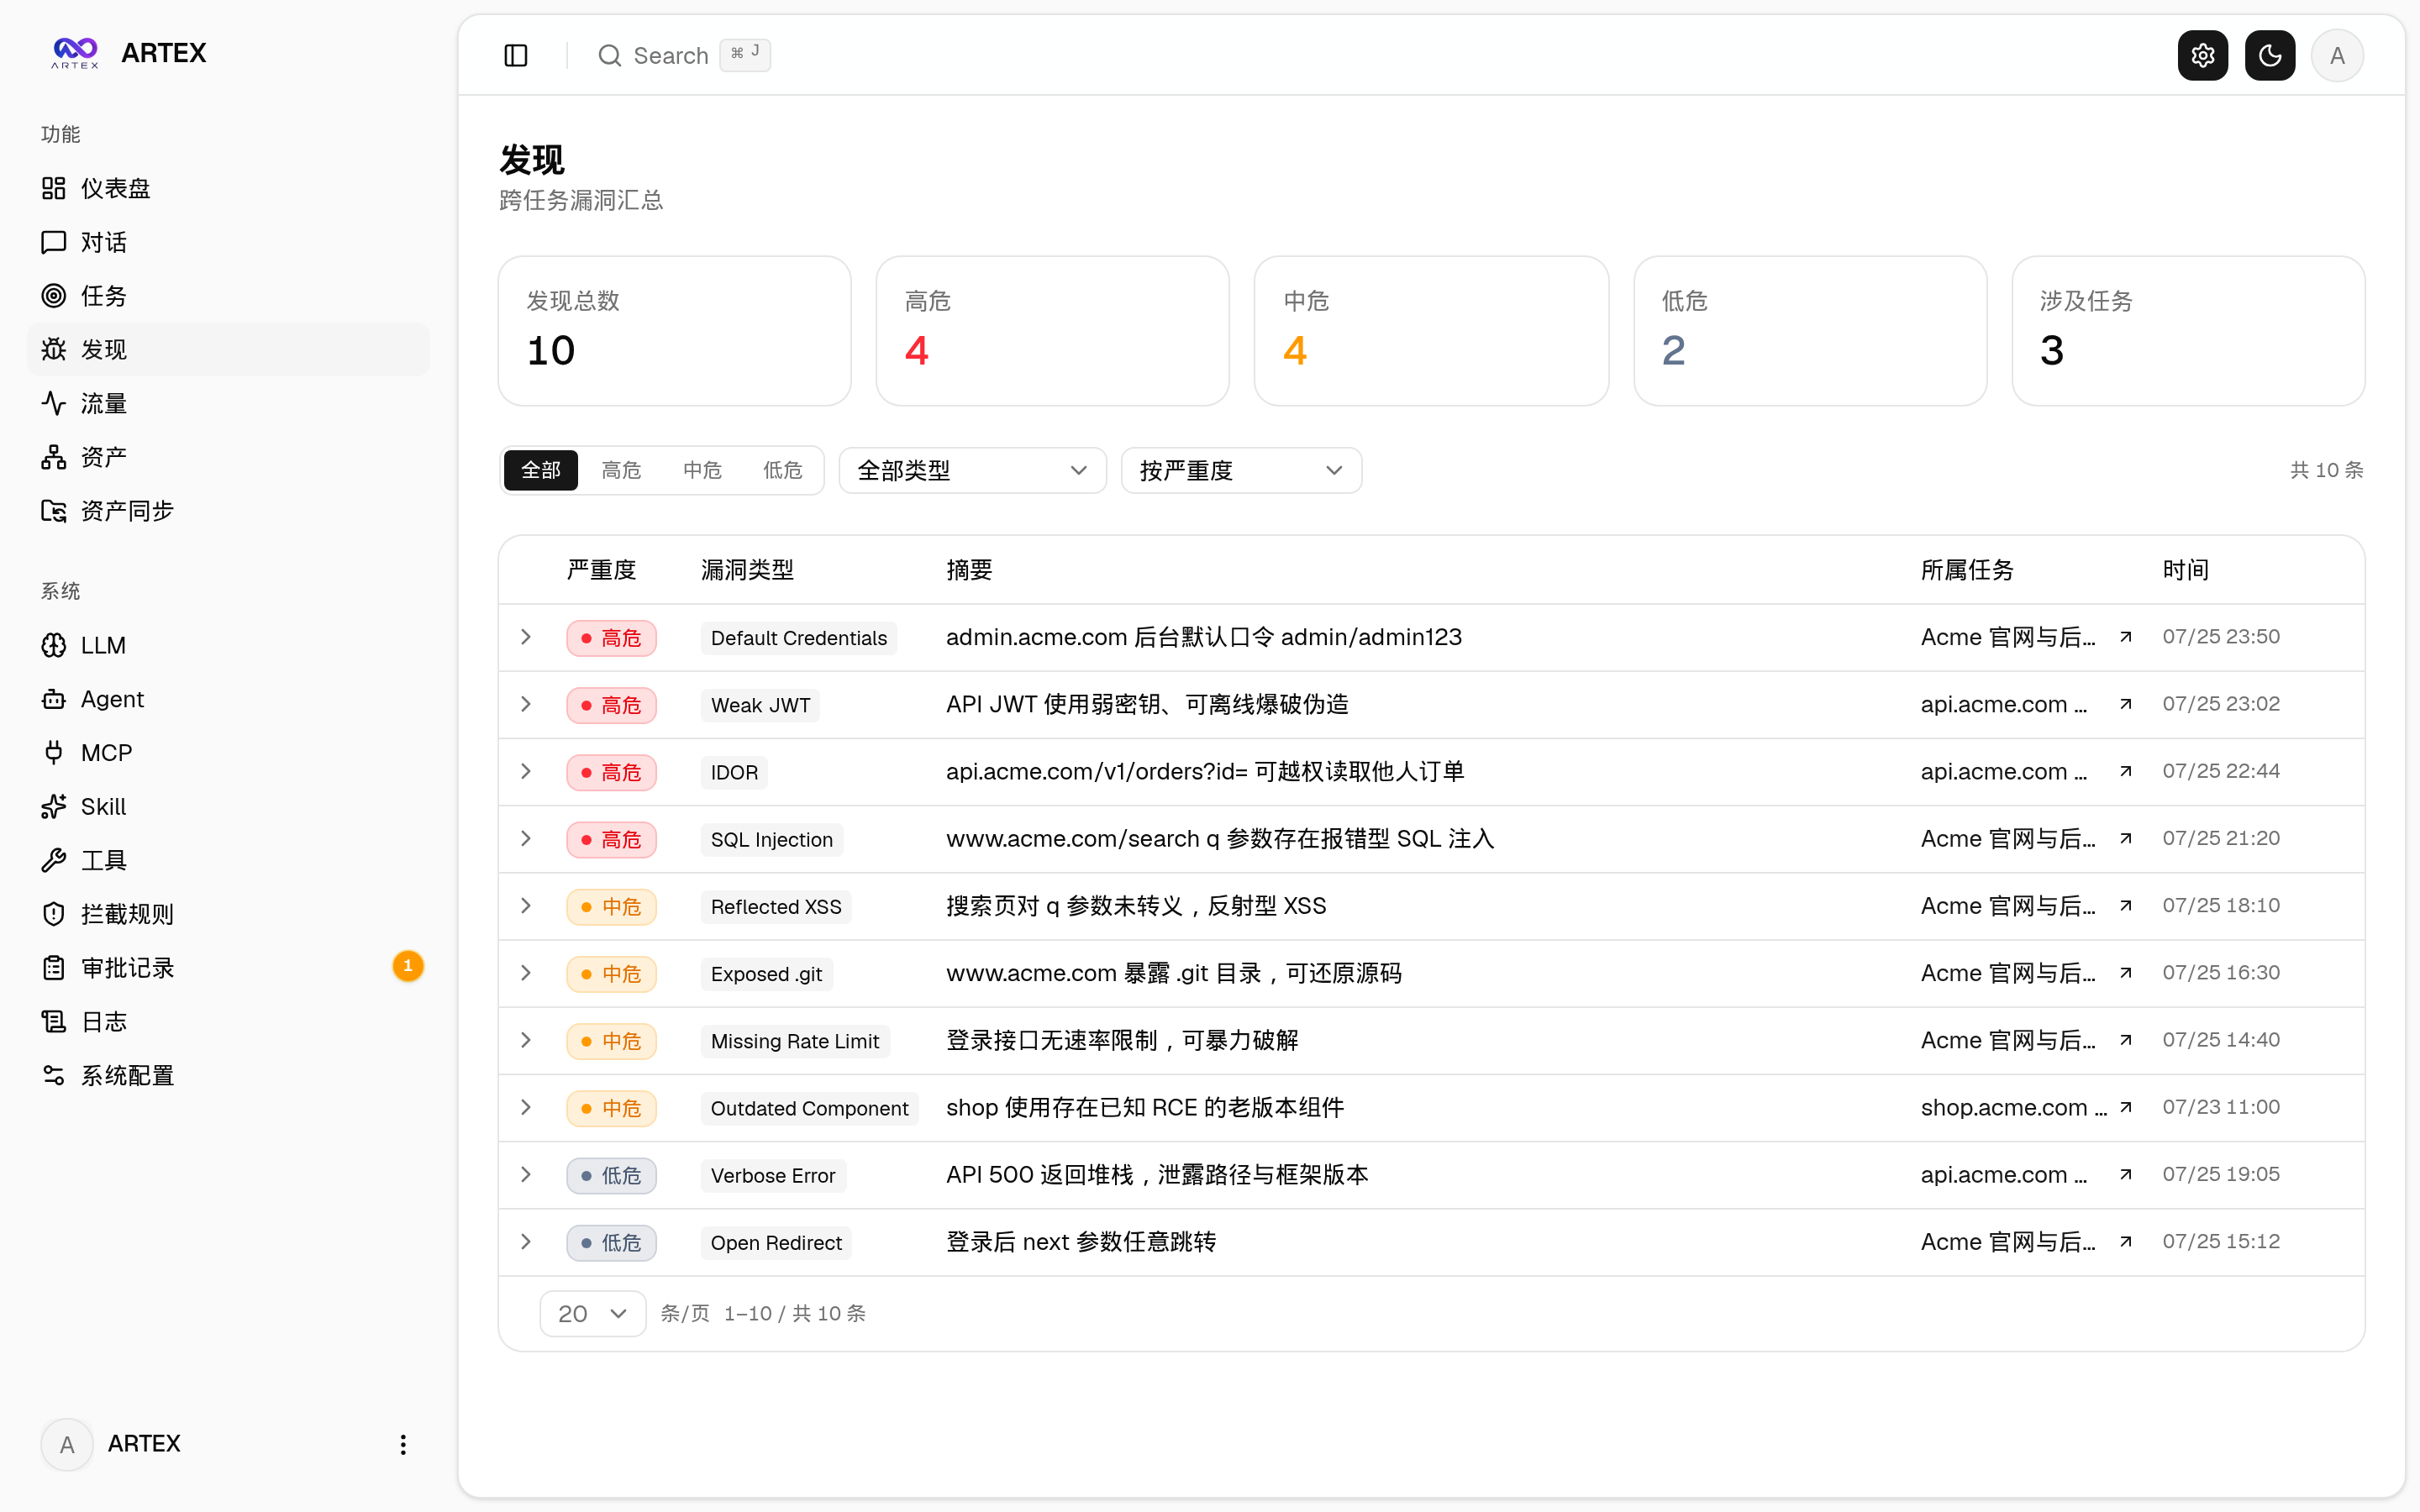
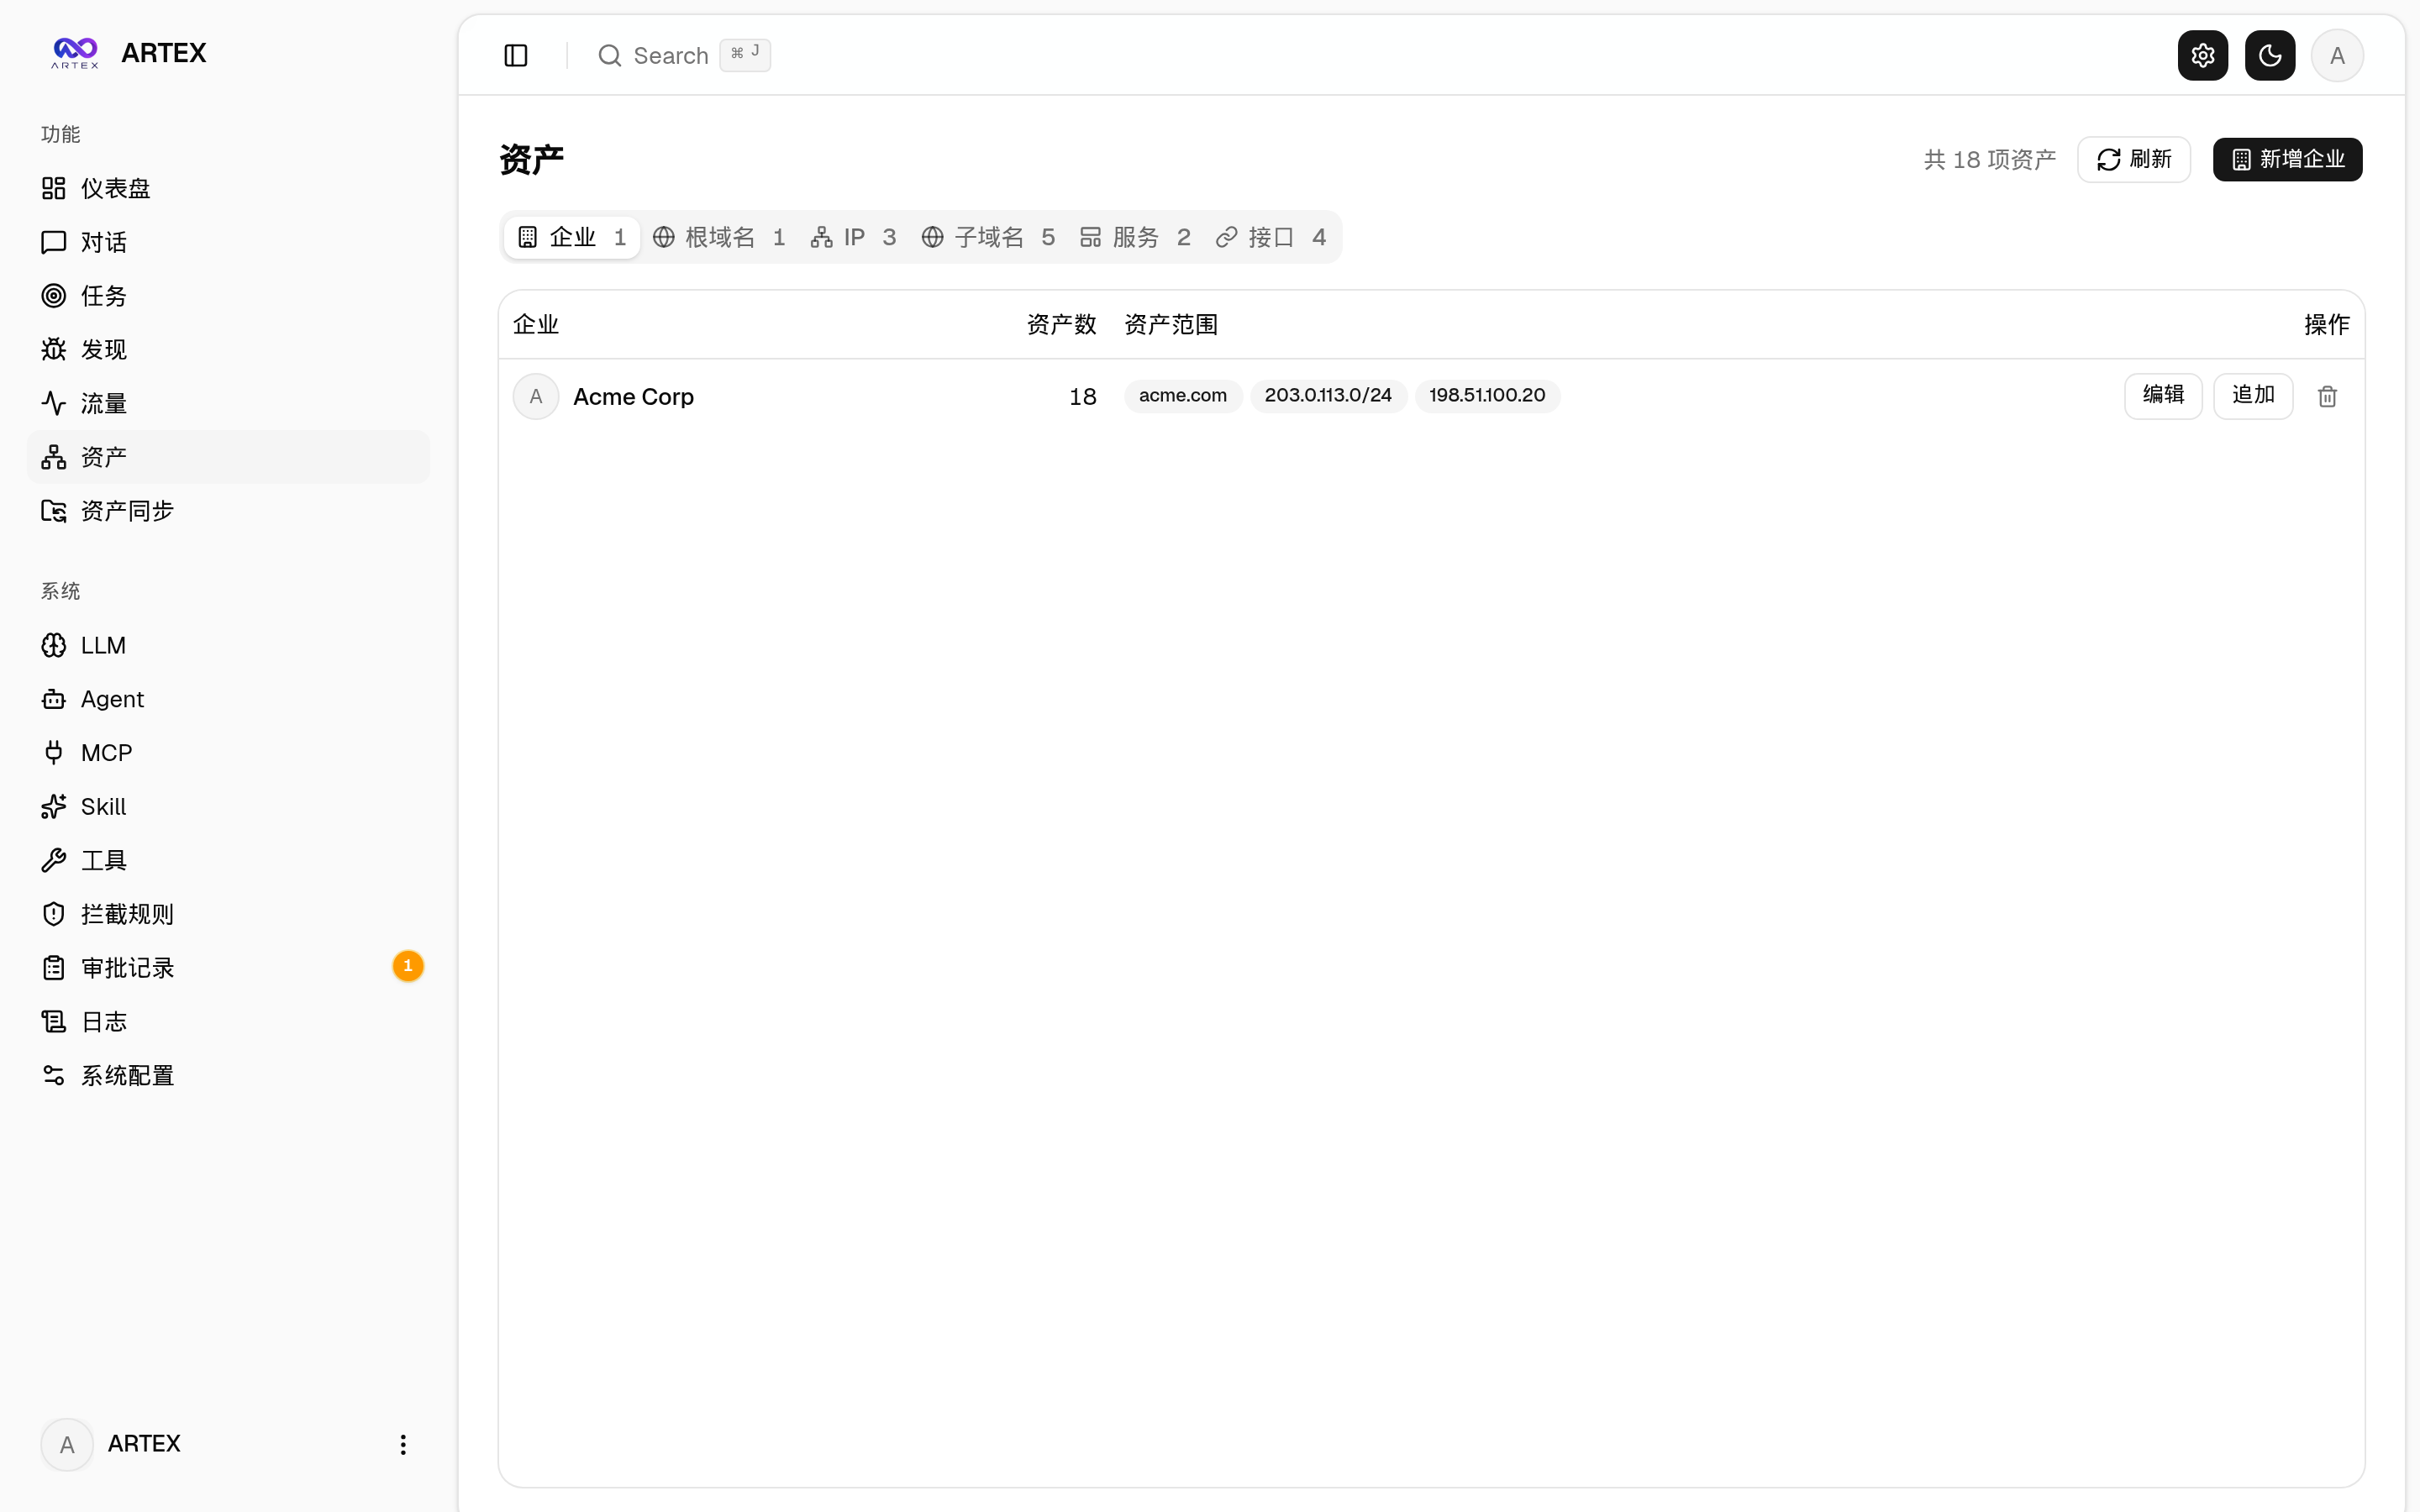
検出結果ページには、タスクで発生した脆弱性やその他の検出結果がまとめて表示されます。アセットページには、システムが収集・統合したアセット情報が表示されます。
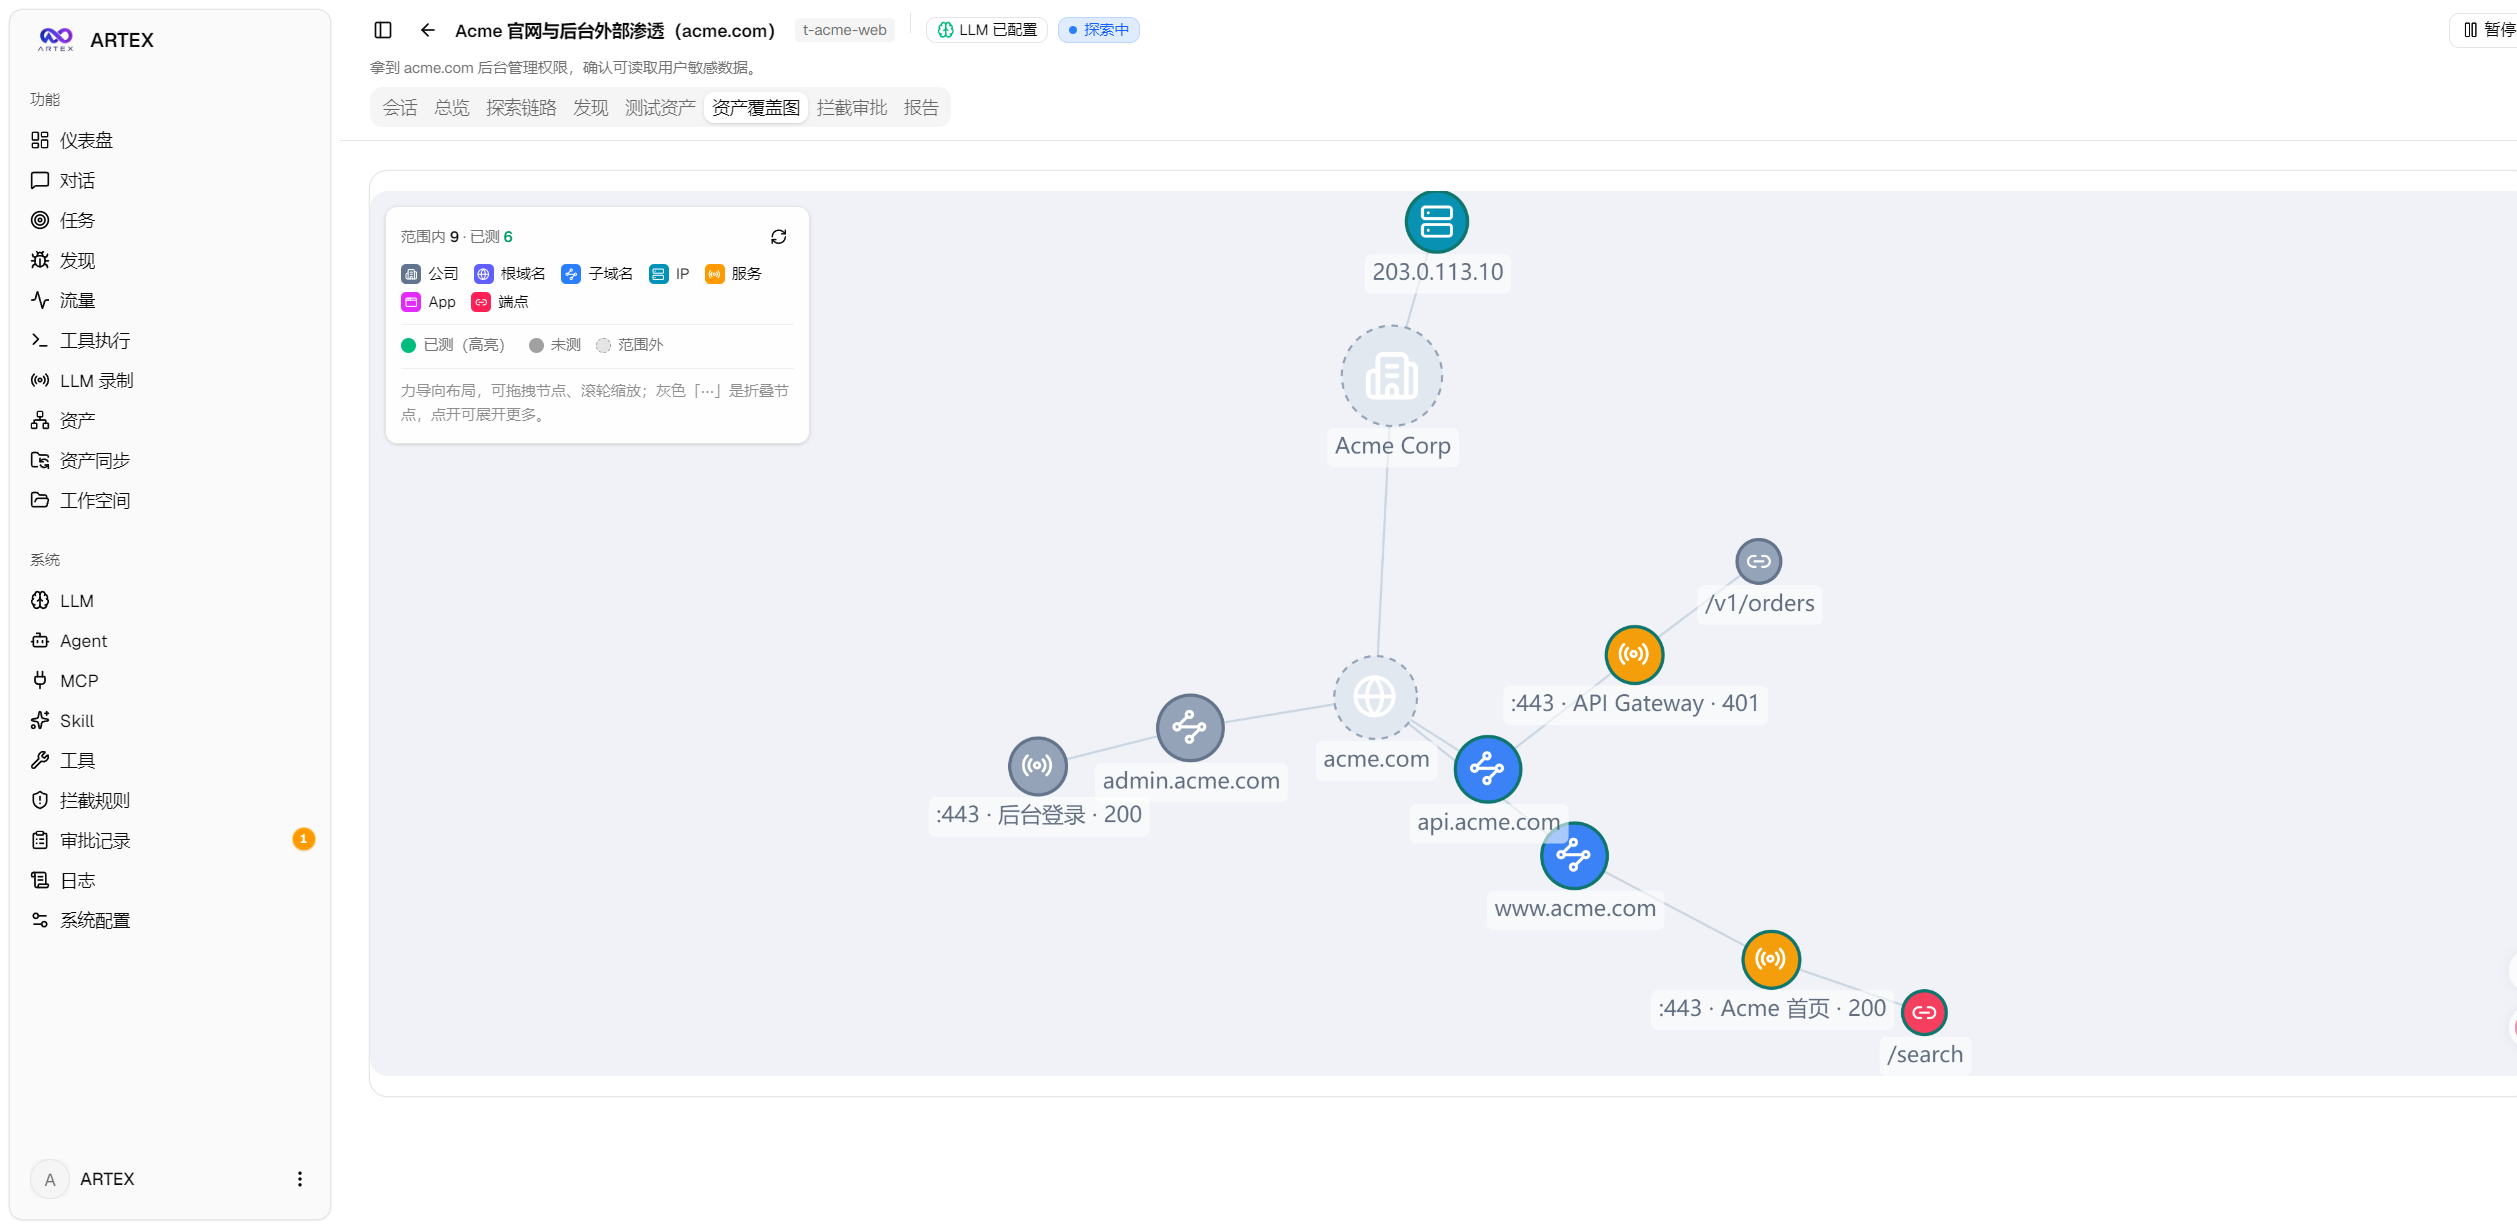
アセットカバレッジマップでは、力指向レイアウトで対象範囲のアセットを表示し、テスト済みのノードを強調表示できます。ノードの折りたたみと展開にも対応しています。全体を見渡しながら、探索済みのアセットと未カバーのアセットを確認するのに適しています。
ScopeSentry のアセットを同期する
ScopeSentry ですでにアセットを収集している場合は、ARTEX の「アセット同期」ページでデータソースに接続し、重複した収集を避けることができます。
- ScopeSentry のアドレスと API Key を入力し、データソースを接続します。
- プロジェクトまたはタスク単位で、同期する対象を選択します。
- ドメイン、サブドメイン、IP、ポート、サイト、エンドポイントなど、アセットの種類を選択します。
- インポートを実行し、ARTEX に組織のアセット範囲に従ってデータを統合させます。
- アセットグラフでインポート結果を確認し、その後の探索に利用できるよう agent に提供します。
アセットグラフは、タスクをまたいで共有されるグローバルなアセットの真実データベースです。プログラムが親子関係と重複排除キーを計算し、agent はアセットの元データを提出します。
ARTEXの二重グラフアーキテクチャを理解する
アセットグラフ:どのようなアセットがあるかを記述
アセットグラフのノードには、root_domain、subdomain、ip、service、app、endpoint などがあります。ドメイン、サブドメイン、サービス、エンドポイントは親子関係で整理され、対応する企業に所属します。
探索グラフ:タスクをどのように進めるかを記述
探索グラフはタスクごとに独立して保存され、goal、intent、fact、finding、hint などのノードで構成されます。システムは spawns、derived_from、yields、proves などの関係によって、進行の連鎖を記録します。
2つのグラフはアンカーを通じて関連付けられます。意図、事実、脆弱性は具体的なアセットにアンカーできるため、探索の方向から関連するアセットを確認したり、特定のアセットから、そのアセットが現在のタスクでどの方向からテストされたかを逆引きしたりできます。
planner と worker の連携
エンジンはイベント駆動のループを採用しています。グラフに変更があると planner が起動し、現在の状況を読み取って意図を割り当てます。worker は1つの意図を取得し、ツールを使って実行したうえで、新しいアセット、事実、発見をデータベースに書き戻します。この書き戻し操作によって、再び planner が起動します。
planner は、未対応の新しい方向が見つかった場合にのみ意図を割り当てます。worker は取得した意図を完了すると停止し、複数の worker が際限なく重複実行することを防ぎます。
複数のステップがあり、前後関係に依存する探索チェーンでは、planner がタスクごとに保持される共有 todolist を管理します。前のステップが完了し、対応する事実が存在する場合にのみ、次のステップが割り当てられます。この仕組みにより、チェーン全体が一度に並列展開されるのを防ぎます。
他の worker の実行プロセスを検索する
後続の worker は search_all_worker_traces(q) を使って、このタスク内にある他の work の実行過程をキーワードで検索できます。また、list_worker_traces で実行済みの work を確認し、get_worker_trace(intent_id, step_ids=[...]) で指定したステップの完全な内容を取得できます。システムは現在の worker 自身の意図を自動的に除外します。
このようなプロセスレベルの情報交換により、agent はまだ fact として正式に書き込まれていない観察結果を再利用できます。同時に、各 worker が自分に割り当てられた意図だけを実行するという境界も維持されます。
トラフィック記録と承認
ARTEX は、トラフィック記録プロキシとツール承認ゲートを提供します。トラフィックページではツール実行によって生成された記録を確認でき、インターセプト承認ページでは人による確認が必要な操作を処理できます。
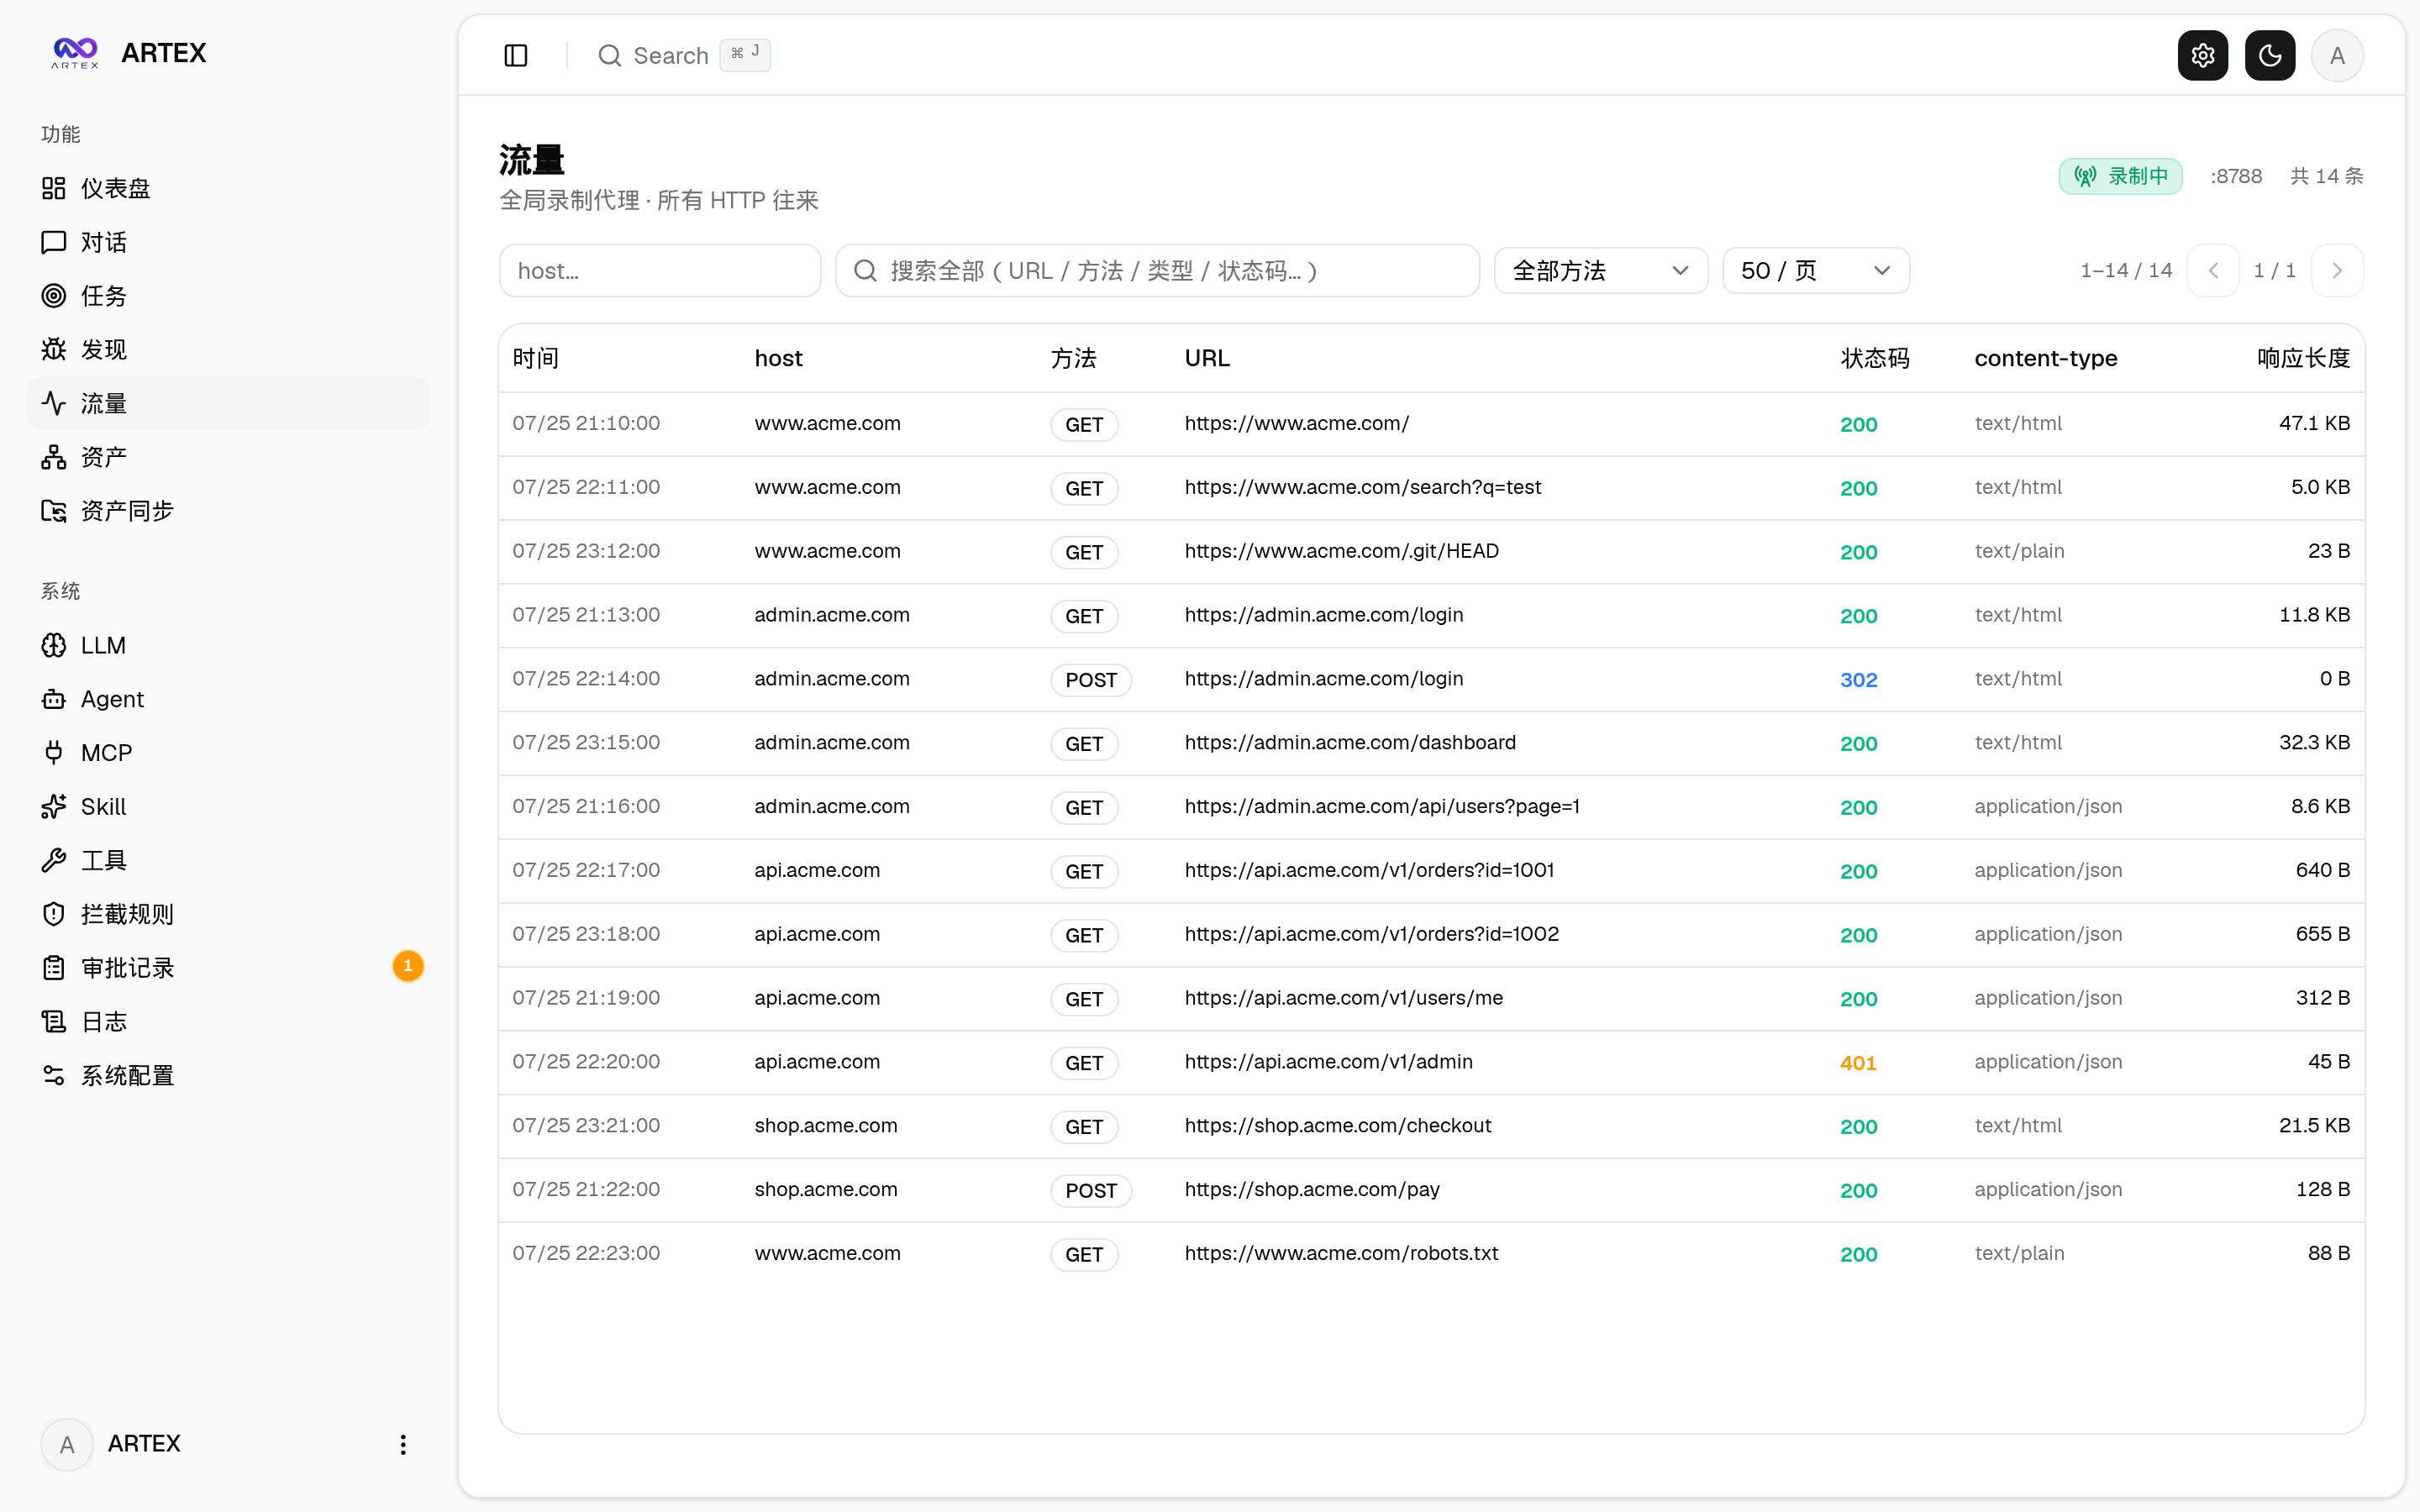
セキュリティ検証時は、タスクセッション、ツール呼び出し、アクティビティストリーム、トラフィック記録を同時に確認し、システムの動作が想定どおりであることを確認することを推奨します。Human-in-the-loop の対話を使って、コンテキストを補足したり承認に参加したりすることもできます。
脆弱性の再テストを実行する
タスク詳細の「再テスト」タブでは、このタスクの脆弱性をページ単位で選択し、過去の結論と証拠を確認したうえで、個別に再テストを開始できます。脆弱性一覧、脆弱性詳細、タスクグループビュー、アセットビューには、いずれも再テストの入口があります。
- 脆弱性一覧または脆弱性詳細で「再テスト」をクリックします。
- 必要に応じて、修正版、テスト条件、制限事項を入力します。
- 独立した再テスト Agent セッションを開始します。
- セッションで再テストの過程を確認し、終了後に結論と証拠を確認します。
再テストの結論には「再現可能」「修正済み」「確認不能」があります。再テストが正常に完了し、結論が「修正済み」の場合、システムは脆弱性の対応ステータスを自動的に更新します。実行中、失敗、停止、その他の結論では、元のステータスは自動的に変更されません。元の証拠とレポートは保持されます。
システムには、編集可能な「脆弱性再テスト」retester Agent があらかじめ用意されています。Agent 管理でプロンプト、LLM、実行予算、ツールを設定できます。専用 LLM が紐付けられていない場合は、グローバルで有効な設定が使用されます。同じ脆弱性を再テスト中の場合は既存のセッションが再利用され、停止、失敗、サービス再起動後には再度開始できます。
なお、プロジェクトの説明によると、再テスト履歴は現時点で脆弱性レポートのエクスポートやタスクアーカイブパッケージには含まれず、トラフィックパッケージにも自動的には関連付けられません。デモモードでは明確にシミュレーションと表示された記録のみが生成され、実際のターゲットにはリクエストを送信しません。
リバースプロキシのデプロイに関する要点
フロントエンド、API、SSE はデフォルトで同じバックエンドポートから提供されるため、通常は HTTPS ポートだけを外部公開し、ARTEX の 8787 は内部ネットワークに残します。リアルタイムアクティビティストリームは同一オリジンのアドレスを使用するため、通常は NEXT_PUBLIC_SSE_BASE の設定は不要です。
Nginx などのリバースプロキシでは、SSE のバッファリングを無効にし、長めの読み取りタイムアウトを設定する必要があります。設定しない場合、ブラウザは接続に成功してもアクティビティイベントを継続的に受信できないことがあります。
location / {
    proxy_pass http://127.0.0.1:8787;
    proxy_set_header Host $host;
    proxy_set_header X-Forwarded-Proto $scheme;
    proxy_buffering off;
    proxy_cache off;
    proxy_read_timeout 3600s;
    proxy_http_version 1.1;
    proxy_set_header Connection "";
}
SSE で異なるオリジン、たとえば独立したサブドメインを使用する必要がある場合にのみ、ビルド段階で NEXT_PUBLIC_SSE_BASE を設定します。この変数は next build の時点で静的パッケージに固定されるため、コンテナの実行時に設定しても反映されません。
アップグレードとロールバック
ARTEX のアップグレードではプログラムが置き換えられますが、PostgreSQL のデータボリューム、./data、./skills は保持されます。システム設定ページの「バージョンと更新」カードからワンクリック更新を実行することを推奨します。更新処理では、現在のプラットフォーム向けリリースパッケージをダウンロードし、SHA256SUMS を検証し、新しいバイナリのスモークテストを実行した後、起動スクリプトによって置き換えを完了します。
検証またはスモークテストに失敗した場合、ステージングされたプログラムは破棄されます。新しいバージョンの起動に3回連続で失敗すると、自動的にロールバックされます。以前のバージョンは artex.old として保持されます。ただし、データベース構造はプログラムのロールバックに伴って戻らないため、アップグレード前にデータベースと ./data をバックアップする必要があります。
更新によってサービスが再起動され、実行中のタスクが中断されるため、アイドル時に実行してください。Docker デプロイでは、ページの更新はプログラムだけを置き換え、イメージ内のツールチェーンは置き換えない点にも注意が必要です。イメージをアップグレードするには、次を実行します。
docker compose pull artex
docker compose up -d artex
リポジトリにある更新スクリプトを使用することもできます。
cd ARTEX
./update.sh
ローカル開発とテスト
開発環境では、dev.sh を使ってバックエンド、トラフィックプロキシ、Next.js 開発サーバーを同時に起動できます。
./dev.shデフォルトのバックエンドポートは 8787、トラフィックプロキシのポートは 8788、フロントエンド開発サーバーのポートは 5173 です。個別に実行することもできます。
go run ./cmd/artex
cd web && npm run dev
go test ./...
バックエンドを起動せず、フロントエンドだけをプレビューする場合は、次を使用できます。
cd web && NEXT_PUBLIC_MOCK=1 npm run devまとめ
ARTEX は、Go モノリスバックエンド、Next.js インターフェース、PostgreSQL、LLM agent、トラフィック記録、承認メカニズム、アセット管理を1つのシステムに統合しています。導入時は、まず Docker またはインストールスクリプトでデプロイし、PostgreSQL と LLM を設定します。その後、タスク、セッション、探索チェーン、アセットカバレッジグラフ、トラフィック記録を順に確認しながら、システムの動作を理解していくことができます。
アセットグラフと探索グラフの役割分担を理解することが、ARTEX を把握する鍵です。アセットグラフは「どのようなアセットがあるか」に答え、探索グラフは「タスクをどのように進めるか」に答えます。テストを行う際は、必ずローカルの隔離環境とプロジェクトで許可された学習用途に厳密に限定し、プロジェクトの声明、オープンソースライセンス、適用される法律を遵守してください。