01 まず結論RVCオープンソースプロジェクトを使い、数時間かけて専用のロリ声モデルをトレーニングしました。効果は有料で購入した商用ボイスチェンジャーよりはるかに優れています。声は自然で感情があり、私がどんな口調で話しても、その口調のまま出力されます。02 RVCの基本的な仕組み一言で言えば、**自分の声を、好きな声色に変える**ことです。RVCが変えるのは「声色」であり、「感情」ではありません。楽しそうに話せば楽しそうに返し、落ち着いて話せば落ち着いて返します。だから、良いモデルは機械的ではなく、自然で感情豊かに聞こえるはずです。トレーニングの公式:**欲しい声の音声 + RVCトレーニング = あなた専用のモデル**03 ステップ1:素材を探す素材の品質がモデルの効果を左右します。
ロリ声の素材を探す
条件:声色が統一され、感情が豊かで、バックグラウンドノイズがなく、10-20分
注意:全編が単調なささやき声の素材は使わないでください。そうしないと、モデルも「感情がない」状態になります
04 ステップ2:素材を処理するAudacity(無料)を使って操作します:
音声をインポート
**モノラル**に変換
サンプリングレートが**44100 Hz**であることを確認
**WAV形式**で書き出す
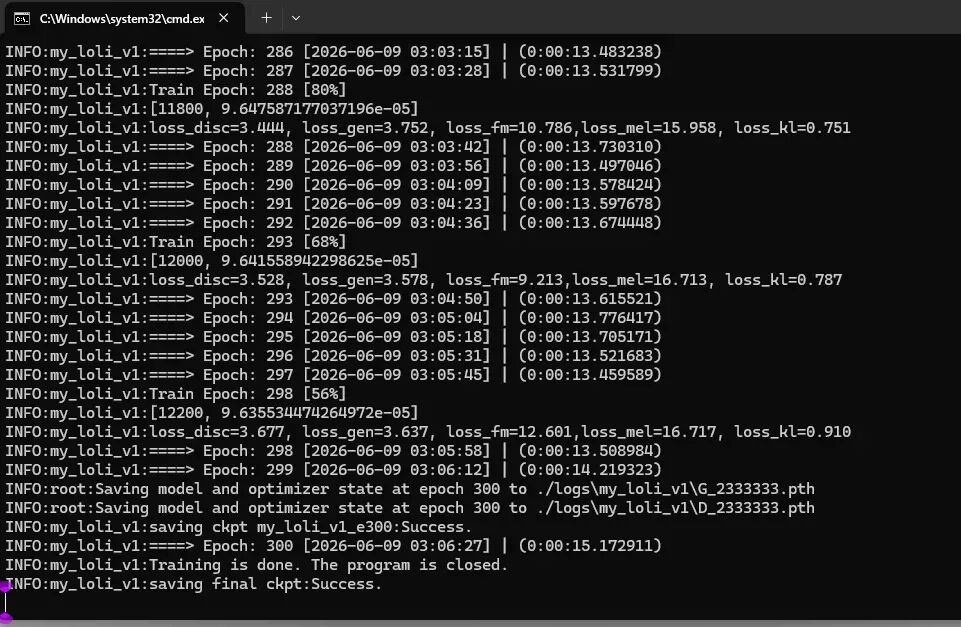
バックグラウンドノイズや残響がある場合は、RVCに搭載されている「伴奏・ボーカル分離」機能を使い、`VR-DeEchoNormal`を選んで除去します。05 ステップ3:モデルをトレーニングするRVC WebUIを開き(`go-web.bat`をダブルクリック)→「トレーニング」タブに移動します| 主要パラメータ | 推奨値 ||---------|--------|| 実験名 | 英語、例:`my_loli_v1` || バージョン | `v2` || ピッチ抽出アルゴリズム | `rmvpe` || 総トレーニング回数 | `200-300` || batch_size | `8` |設定後、**`一括トレーニング`**をクリックし、1-2時間待てば完了します。50回ごとにモデルが自動保存されます。06 ステップ4:効果を試聴する「モデル推論」タブに移動します:
声色リストを更新し、自分のモデルを選択
自分の録音をアップロード
ピッチ変更:男性声から女性声は`+12`、女性声から女性声は`0`を入力
`rmvpe`にチェックを入れる
「変換」をクリック
満足できなければ、別のトレーニング回数のモデルを試すか、「無声音子音の保護」パラメータを調整してください。07 ステップ5:配信で声を変える`go-realtime-gui.bat`をダブルクリックします:
自分の`.pth`モデルを読み込む(`.index`は空欄のまま、検索比率は`0`にする)
入力デバイスにマイク、出力に仮想オーディオケーブルを選択
ピッチ変更に`+12`(男性から女性)を入力し、`rmvpe`にチェックを入れる
「音声変換を開始」をクリック
その後、OBSでマイクを仮想オーディオケーブルに設定すれば完了です。08 よくある問題
声が硬く、感情がない? → 素材の問題です。感情豊かな素材に変えて、もう一度トレーニングしてください
なぜ自分でトレーニングしたもののほうが、有料で購入したものより良いの? → 商用ソフトはエコシステムに囲い込まれており、決められたモデルを購入するしかありません。RVCならすべて自分でコントロールできます
どんなスペックが必要? → 4GB以上のVRAMを搭載したNVIDIA製GPU、16GBのメモリ
09 最後に「硬いモデルにお金を払う」ことから「高品質なモデルを自分でトレーニングする」ことまで、実はこの1本のガイドがあれば十分です。今あなたが手に入れるのは単なるモデルではなく、**あらゆる声を生み出す力**です。