

Rizzo Flowとは?
Rizzo Flowは、構造化されていないテキストやJSONの状態を、確率付きの型付き判断に変換するオープンソースのローカルファーストシステムです。言語モデルに文章やJSONをトークンごとに生成させる代わりに、フォワードパス後に、制約された回答文字の集合に対するモデルの確率を読み取ります。
この設計により、次のような判断に対応できます。
trueの確率を伴う真偽値の回答。- 名前付き選択肢からの選択。各選択肢に確率を付与。
- 順序付けられた評価基準レベルによるスコア。
- 代表的な基準値に基づく数値推定。
Rizzo Flowはllama.cppを通じて、お使いのハードウェア上で実行できます。Apple Metal、NVIDIA CUDA、Vulkan、AMD ROCm、Intel SYCL、またはCPU実行を利用できます。また、Jev互換のHTTPインターフェースも提供しており、互換アプリケーションからホスト型サービスの代わりにローカルURLを指定できます。
Rizzo Flowは独立したプロジェクトです。Jevの背後にあるインターフェースパターンを再現していますが、Jevの独自アーキテクチャや学習を再現するものではありません。自身の代表的なデータでキャリブレーションしない限り、その確率は未校正です。
ゼロトークン判断の仕組み
各リクエストでは、Rizzo Flowがプロンプトの先頭に状態を配置し、一度だけ処理します。その後、質問は共有された状態キャッシュから分岐します。可能な各回答は大文字の文字に対応付けられ、システムは許可された文字のロジットだけを読み取ります。
- 状態をテキストに変換し、モデルのKVキャッシュに事前入力します。
- 各質問を、制約付きの多肢選択問題として表現します。
- 同じ状態を共有する質問をマイクロバッチで評価します。
- 許可された回答のロジットをsoftmaxで確率に変換します。
- Pythonコードが、スキーマ検証済みの真偽値、選択肢、スコア、または数値データを返します。
デコードループ、サンプリングされたテキスト、出力の解析、JSONの修復は行いません。ただし、生成トークンがゼロでも計算がゼロになるわけではありません。状態と質問プロンプトには、依然としてモデル推論が必要です。
主な機能
- 完全ローカル動作:モデル推論はお使いのマシン上で実行されます。
- 型付き結果:アプリケーションは生成された文章ではなく、構造化された値を受け取ります。
- 確率分布:選択肢とスコアの結果では、最尤の回答だけでなく確率も確認できます。
- 4つのネイティブプリミティブ:真偽値、選択肢、スコア、数値。
- 任意の棄権:ネイティブAPIは、根拠不足、不確実性、または範囲外の数値結果を報告できます。
- 共有状態のバッチ処理:1つのリクエスト内の複数の質問で、状態のKVキャッシュを再利用します。
- Jev互換エンドポイント:既存のクライアントは
/v1/systemoneと/v1/modelsを利用できます。 - 長いコンテキストに対応するモデル:Spark-X2.5は最大1,048,576トークンのネイティブコンテキストをサポートしますが、Rizzo Flowの質問あたりのデフォルトは8,192トークンです。
- ローカルツール:サーバーには、プレイグラウンド、インタラクティブなOpenAPIドキュメント、Snakeのデモが含まれています。
前提条件
Rizzo Flowをインストールする前に、次のものがあることを確認してください。
- Python 3.11以降。
- Git。
- 依存関係と環境の管理に使うuv。
- 選択したモデルとランタイムに十分なディスク容量。
デフォルトのSpark-X2.5-4B Q8_0モデルのダウンロード容量は約4.4 GBです。ランタイムのダウンロード容量はプラットフォームによって異なり、Macでは約11 MB、CUDAパッケージでは約570 MBです。
サーバーのインストールと起動
リポジトリをクローンし、固定された依存関係を同期し、デフォルトのランタイムとモデルをダウンロードして、サービスを起動します。
git clone https://github.com/Rizzo-AI-Academy/rizzo-flow
cd rizzo-flow
uv sync --locked
uv run rizzo download
uv run rizzo serve
ダウンロードコマンドは、現在のマシン向けの公式ビルド済みllama.cppパッケージを選択し、SHA-256チェックサムを検証して、Spark-X2.5-4B Q8_0をダウンロードします。中断されたダウンロードは停止した地点から再開できます。
プロジェクトのドキュメントによると、モデルの読み込みには約10秒かかります。サービスの準備ができたら、次を開いてください。
- ビジュアルプレイグラウンド:
http://127.0.0.1:8017/playground - インタラクティブなOpenAPIドキュメント:
http://127.0.0.1:8017/docs - Snakeのデモ:
http://127.0.0.1:8017/snake
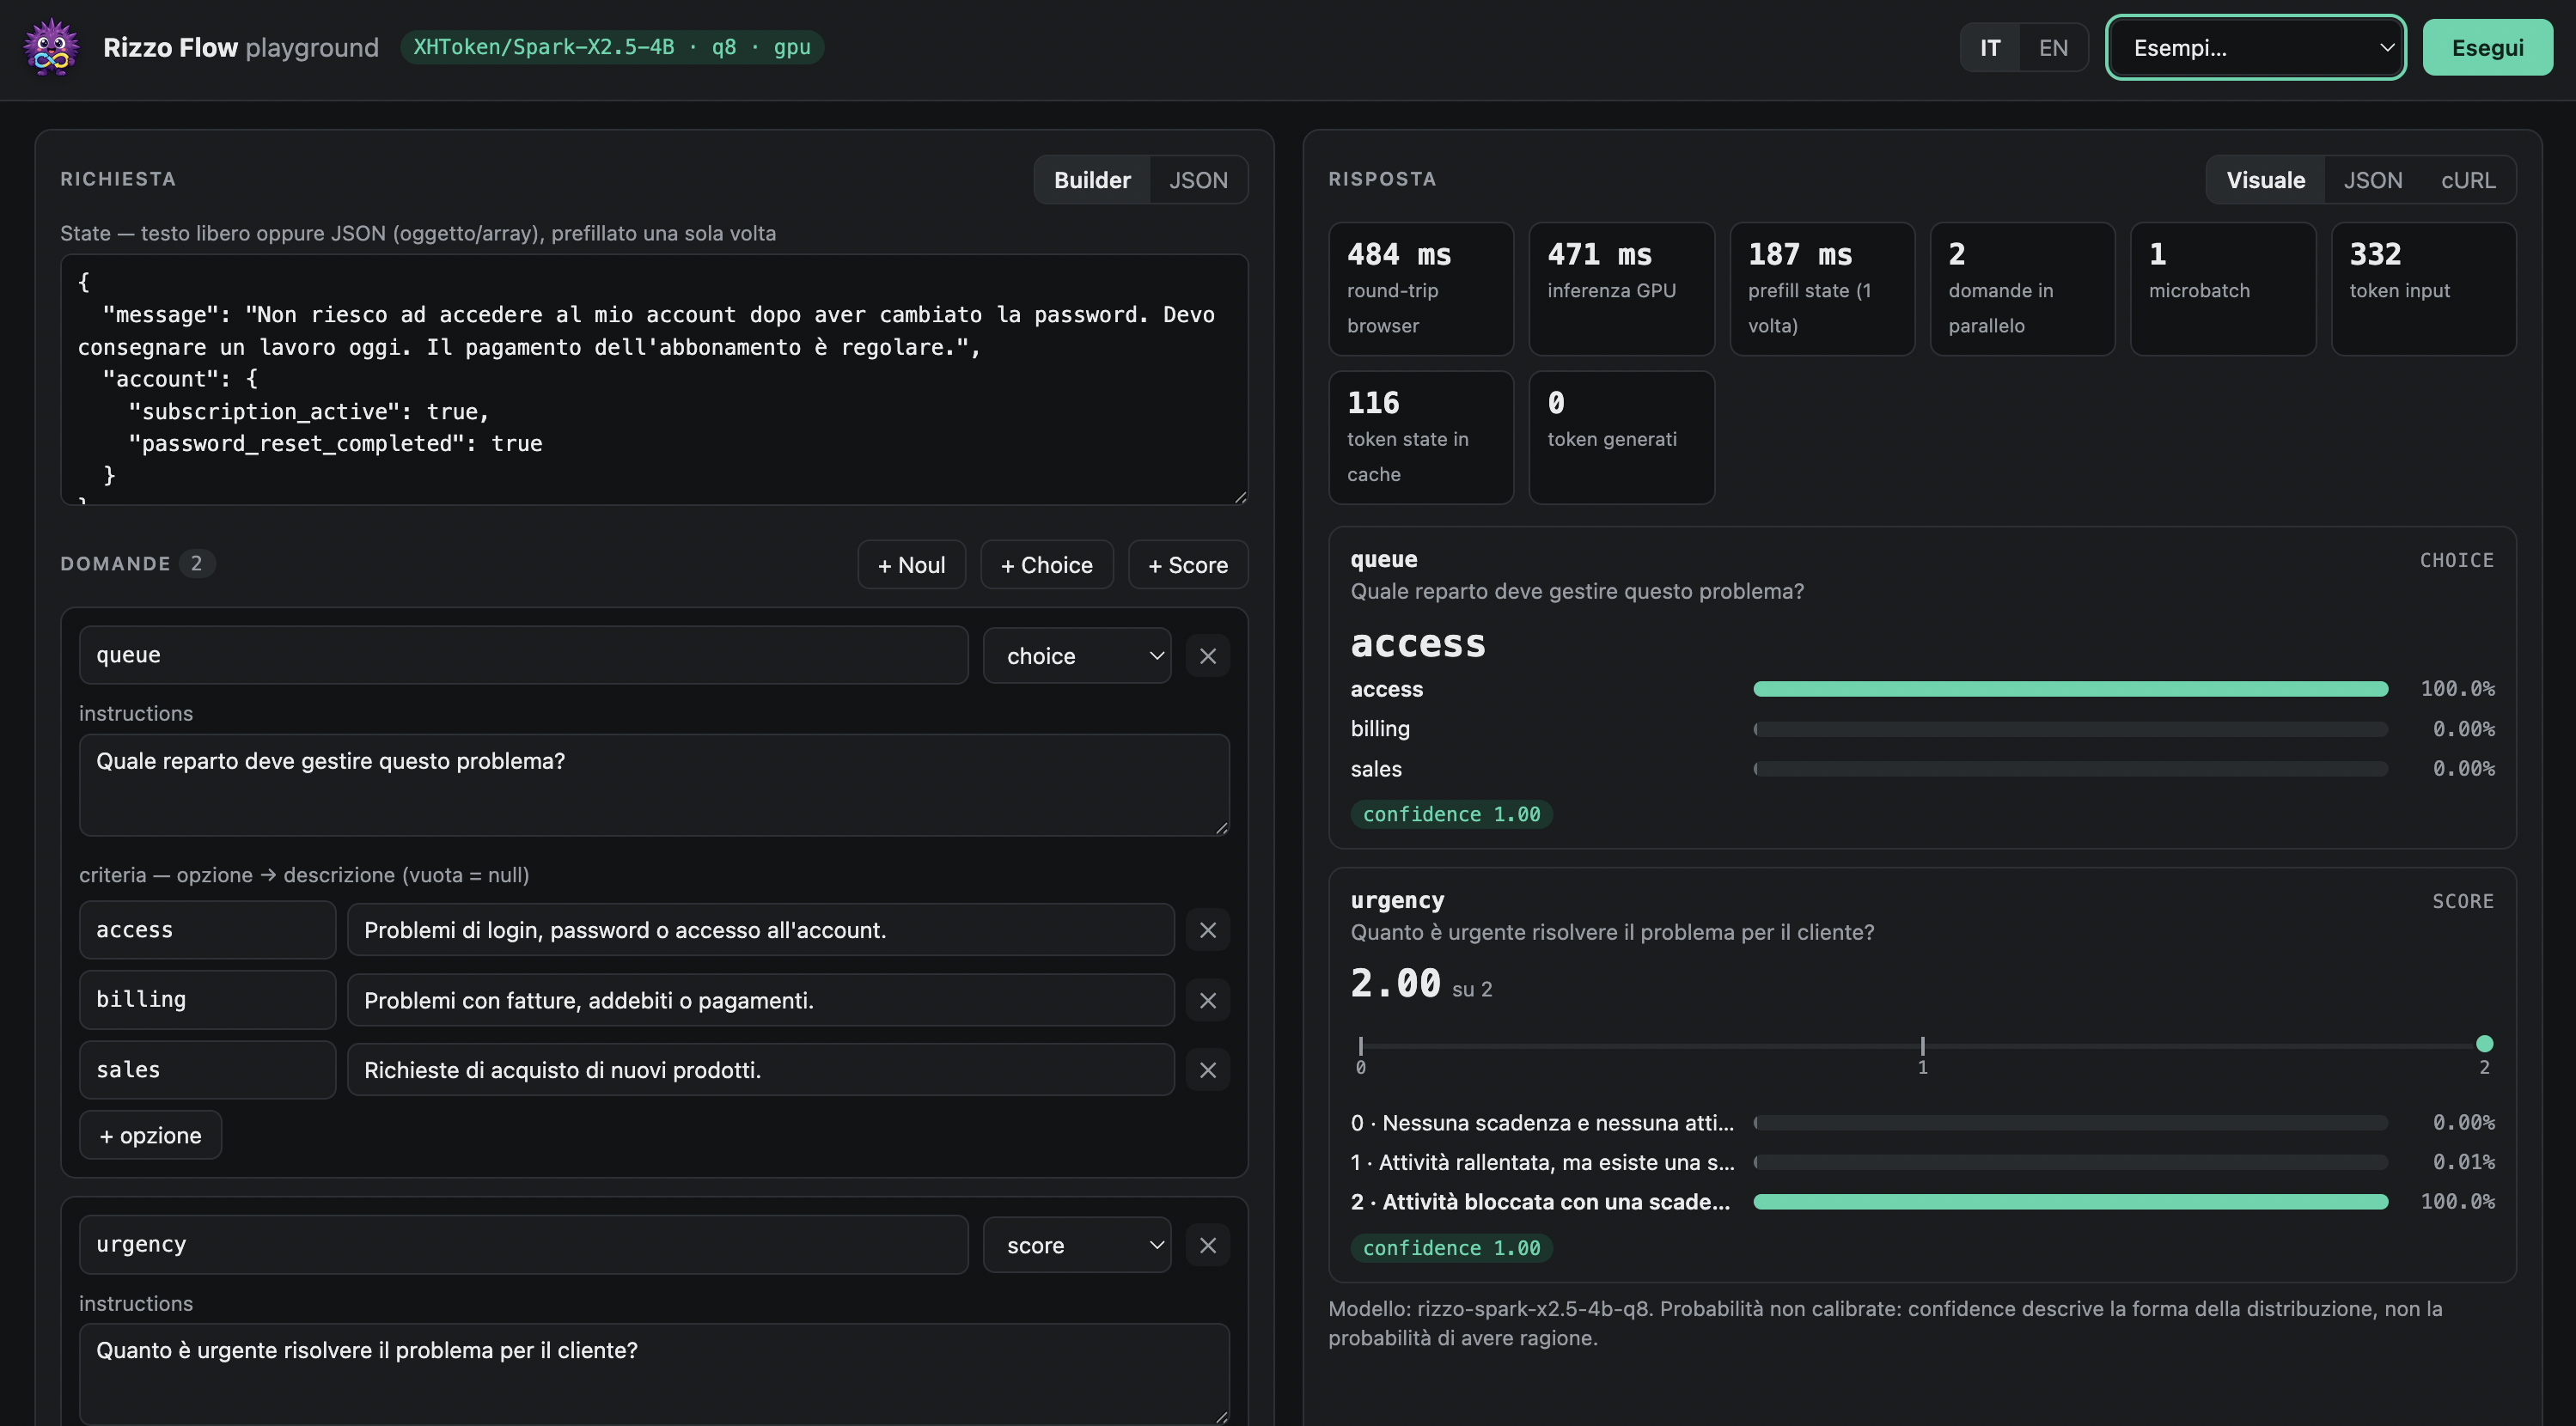
プレイグラウンドには、すぐに使えるサンプル、質問ビルダー、両API用の生JSONエディター、確率バー、処理時間の詳細、同等のcURLコマンドが含まれています。外部への通信は行わず、英語とイタリア語を切り替えられます。
小さいモデルを使う
最初のダウンロードを短時間で済ませるには、1.7Bモデルをインストールします。
uv run rizzo download --size 1.7b
uv run rizzo serve --size 1.7b
1.7B Q8_0ファイルは約1.8 GBで、実行速度はおよそ2倍ですが、READMEでは精度が大幅に低いと警告されています。また、棄権を有効にすると「証拠不十分」の選択肢を選びやすいため、自分のワークロードで慎重にテストしてください。
最初の判定を行う
最も簡単なAPIテストでは、Jev互換のPOST /v1/systemoneエンドポイントを使用します。次のリクエストは、サポートメッセージが緊急性を伝えているかどうかを尋ねます。
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "Help! My payouts have been failing for 3 days.",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this convey urgency?"
      }
    }
}'noulの結果は「はい」である確率で、0から1までの数値として表されます。リクエストでrizzo-latestや便利なエイリアスを使用した場合でも、レスポンスには実際のローカルモデル識別子が示されます。
1回のリクエストで複数の質問を行う
Rizzo Flowは、同じstateに対して複数の質問を評価できるよう設計されています。1回のリクエストにまとめることで、質問間でstateのKVキャッシュを共有できます。
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "Help! My payouts have been failing for 3 days.",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this convey urgency?"
      },
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments, invoicing, refunds",
          "technical": "Bugs and outages",
          "sales": null
        }
      },
      "frustration": {
        "type": "score",
        "instructions": "How frustrated is the customer?",
        "criteria": ["Calm", "Frustrated", "Very angry"]
      }
    }
}'レスポンスには、noulの「はい」の確率、すべての選択肢の確率、凡例付きの確率加重スコアが含まれます。usage.output_tokensの値は常に0です。
ネイティブの判定APIを使用する
ネイティブのPOST /v1/decisionsエンドポイントでは、数値質問や棄権を含むRizzo Flowの完全な機能セットを利用できます。質問タイプは次の4つです。
boolean: 型付きの値とtrueである確率を返します。choice: 選択されたオプションと、すべてのオプションの分布を返します。score: 順序付けられたレベル全体について、確率加重スコアと正規化スコアを返します。numeric: 推定値、中央値、ばらつき、範囲未満または範囲超過の確率を返します。
アンカーから数値を推定する
数値質問では、増加する代表アンカーを定義します。次の例では、モデルに報告された充填率を読み取らせます。
curl http://127.0.0.1:8017/v1/decisions \
  -H 'Content-Type: application/json' \
  -d '{
    "state": {"measurement": 75, "unit": "percent"},
    "questions": {
      "fill": {
        "type": "numeric",
        "instructions": "Read the reported fill percentage.",
        "unit": "percent",
        "anchors": [
          {"value": 0, "description": "Empty"},
          {"value": 50, "description": "Half full"},
          {"value": 75, "description": "Three quarters full"},
          {"value": 100, "description": "Completely full"}
        ]
      }
    }
  }'
アンカーは統計的な区間ではなく、代表値です。報告される平均値は最小アンカーと最大アンカーの間にとどまり、分位点はこれらのアンカー上にある離散確率分布を表します。
棄権を理解する
ネイティブの質問では、デフォルトで棄権が許可されています。Rizzo Flowは内部的に「証拠不十分」の選択肢を追加し、数値質問には範囲未満と範囲超過の可能性も含めます。選択されたオプションとポリシーによっては、主値がnullになり、ステータスにinsufficient_evidence、out_of_range、またはuncertainが示される場合があります。
Jev互換形式では棄権を使用しません。yes/noの結果は、正確に2つの選択肢を対象として計算されます。小型の1.7BモデルをネイティブAPI経由で使用する場合は、プロジェクトの推奨に従いallow_abstainをfalseに設定し、データへの影響を検証することを検討してください。
サーバーなしで判定を実行する
スクリプト、テスト、または単発の評価では、リクエストファイルをCLIに直接渡します。
uv run rizzo decide examples/ticket.json仮想環境を有効にして、uv runのプレフィックスを省略することもできます。
source .venv/bin/activate
rizzo decide examples/ticket.json
PowerShellでは、次のコマンドで有効にします。
.venv\Scripts\activateモデル、量子化、デバイスを選択する
デフォルト設定ではSpark-X2.5-4B Q8_0を使用します。その他にドキュメント化されている量子化方式はQ4_K_MとBF16です。
- 4B Q8_0: 約4.4 GB。デフォルト設定です。
- 4B Q4_K_M: 約2.6 GB。
- 4B BF16: 約8.2 GB。
- 1.7B Q8_0: 約1.8 GB。
- 1.7B Q4_K_M: 約1.1 GB。
- 1.7B BF16: 約3.4 GB。
サーバーを起動する前に、ランタイムから認識できるデバイスを確認します。
uv run rizzo devicesその後、デバイスファミリーを明示的に選択できます。
uv run rizzo serve --device cuda
uv run rizzo serve --device vulkan
uv run rizzo serve --device metal
uv run rizzo serve --device cpu
指定したデバイスファミリーはヒントではなく要件として扱われるため、Rizzo Flowは明示的に指定されたGPUファミリーをCPUへ黙ってフォールバックしません。追加のランタイムパッケージは個別にダウンロードできます。
uv run rizzo download --only runtime --runtime rocm
uv run rizzo download --only runtime --runtime sycl
uv run rizzo download --only runtime --runtime cpu
高度な設定と実用的なヒント
関連する質問をまとめる
同じ状態に関する質問は、1つのリクエストにまとめてください。これはRizzo Flowの設計の中心です。状態は一度だけ事前入力され、質問のサフィックスはマイクロバッチで評価されます。質問のデフォルトのマイクロバッチサイズは4で、--batch-sizeで変更できます。
uv run rizzo serve --batch-size 8バッチを大きくすれば、必ず性能が向上するわけではありません。対象マシンでレイテンシとメモリ消費量を比較してください。
コンテキストは慎重に増やす
Spark-X2.5はネイティブで100万トークンのコンテキストに対応していますが、サーバーの質問あたりのデフォルトは8,192トークンです。--ctxで上限を引き上げられます。
uv run rizzo serve --ctx 32768KVキャッシュは起動時に確保されます。4Bモデルの場合、READMEでは1トークンあたり約144 KiB、デフォルト上限では約1.4 GiB、32,000トークンでは4.8 GiBと見積もられています。設定した上限を超える入力は切り捨てられず、拒否されます。およそ60,000トークンを超える場合は、schema.pyにあるリポジトリの256 KB状態上限も引き上げる必要があります。
互換エンドポイントを保護する
サーバーの起動前にRIZZO_API_KEYを設定すると、Jev互換エンドポイントでBearer認証が必須になります。
export RIZZO_API_KEY="replace-with-a-secret"
uv run rizzo serve
Windows PowerShellでは次のようにします。
$env:RIZZO_API_KEY = "replace-with-a-secret"
uv run rizzo serve
認証に失敗するとHTTP 401が返されます。不正なリクエストデータにはHTTP 422が返される場合があります。
互換クライアントを接続先変更する
ホスト型TypeSafe API向けに設計されたクライアントは、ベースURLを変更することでローカルサービスを利用できます。
export TYPESAFE_BASE_URL=http://127.0.0.1:8017プロジェクトによると、この環境変数の設定は公式SDK向けに設計されていますが、SDKでの動作確認はまだ行われていません。インターフェースには互換性がありますが、基盤となるローカルモデルはJevではありません。
信頼度と確率を正しく扱う
互換APIの信頼度は、選択肢の分布の形状を表します。回答が正しいことを検証済みの確率ではありません。同様に、モデルの生の確率は過信的になったり、適切にキャリブレーションされていなかったりする場合があります。
代表性のあるラベル付きデータセットで判断を検証し、必要に応じて実際のデプロイ環境向けにキャリブレーションしてください。サーバーでは--calibrationを使ってキャリブレーションファイルを指定できます。
uv run rizzo serve --calibration fit.jsonキャリブレーションは、適合に使用したモデルファイル、ランタイム、量子化、ハードウェアバックエンドに依存します。CUDA、Vulkan、Metalでは丸め方が異なる場合があり、量子化によって返される確率が変わることもあります。
回答スロットの上限を守る
各候補は1つの大文字に対応するため、1つの質問で使用できる回答スロットは最大26個です。内部の棄権 विकल्पや範囲選択肢もスロットを消費します。そのため、棄権なしの選択式質問では通常の選択肢を最大26個、棄権ありでは25個まで使用できます。数値質問では、範囲外(下限未満、上限超過)や任意の証拠不足の選択肢もスロットを占有するため、利用できる基準点は少なくなります。
カスタムモデルファイルまたはllama.cppビルドを使用する
--modelを使うと、特定のGGUFファイルでサーバーを起動できます。
uv run rizzo serve --model /path/to/model.ggufカスタムのllama.cppインストールを使用するには、RIZZO_LLAMA_DIRをlibllamaを含むディレクトリに設定します。READMEでは、バインディングがそのバージョンのヘッダーに結び付いているため、llama.cppのコミット161755fが必要とされています。
Snakeデモを試す
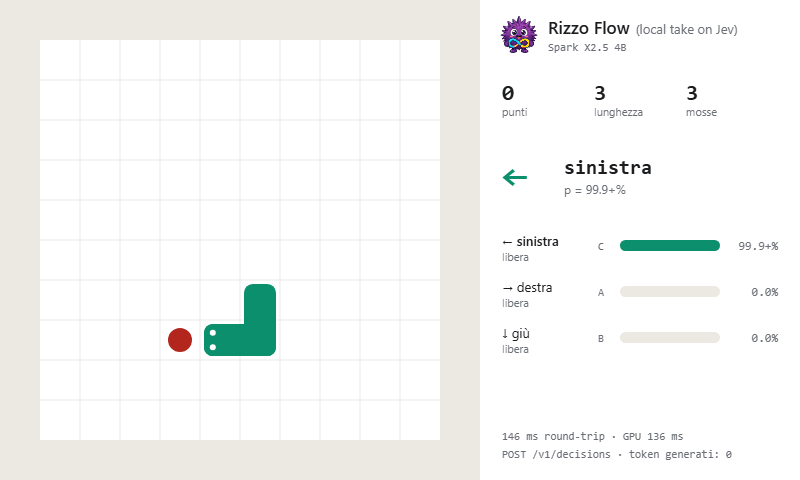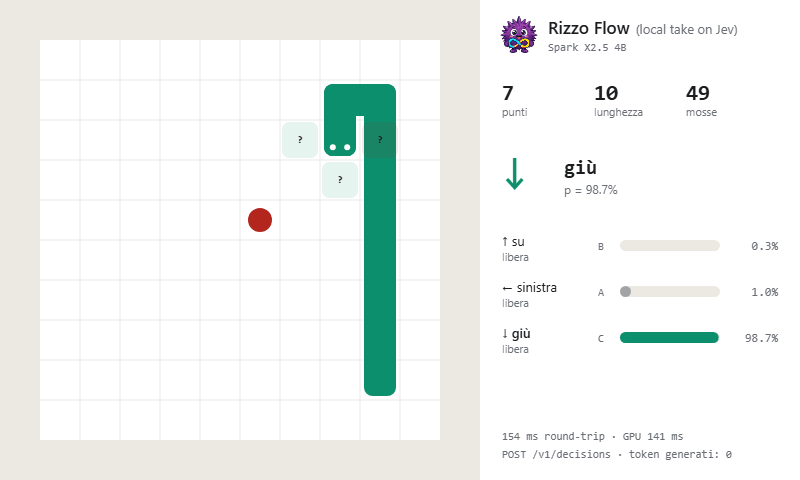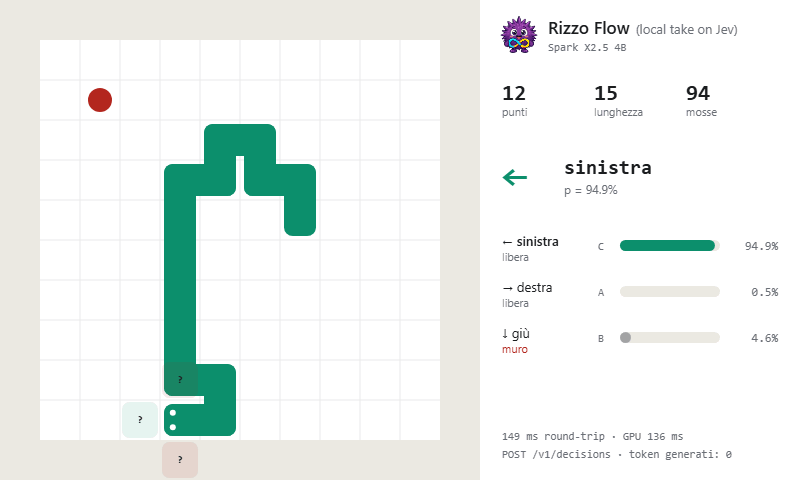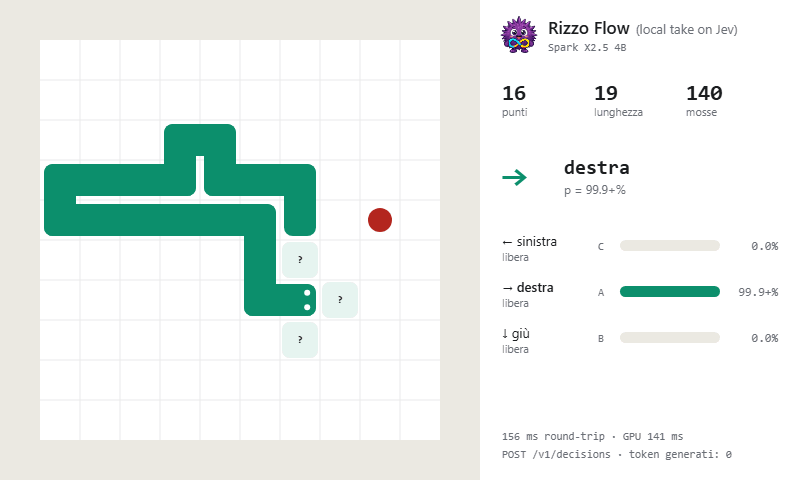
ローカルのSnakeページは、型付きの判断でインタラクティブなアプリケーションを制御する方法を示します。1回の移動ごとに、盤面の説明と合法手を列挙した選択式質問を含むPOST /v1/decisionsリクエストが1件送信されます。ページには、テキストを生成せずに回答確率、ロジット、処理時間、判断ログが表示されます。
このデモは、重要なモデリング上の教訓も示しています。入力表現が重要です。READMEによると、4BモデルはASCIIグリッドだけを使う場合より、手ごとの計算済みセンサーを使う場合の方がはるかに優れた性能を発揮します。これらの観察結果は少数の非公式なゲームから得られたものであり、ベンチマークとして扱うべきではありません。
運用時の確認
GET /healthを使うと、モデルの来歴とファイルハッシュを確認できます。リクエストとレスポンスのスキーマは、request.schema.jsonとresponse.schema.jsonでも確認できます。再現性のあるデプロイでは、モデル、量子化、ランタイム、バックエンド、コンテキスト設定、キャリブレーションを固定してください。
READMEでは、RTX 5060 Ti上でSpark-X2.5-4B Q8_0を使った短い判断に、およそ50ミリ秒かかると報告されていますが、これはハードウェアとワークロードに依存します。同じドキュメントでは、Apple Silicon、AMD、Intel、Linux NVIDIA、CPU構成のすべてが同等にテストされたわけではないと説明されているため、レイテンシの期待値を設定する前に自分のマシンでベンチマークしてください。
結論
Rizzo Flowは、テキストを生成せずに、構造化されていない状態を型付きの確率的な意思決定へ変換するための実用的なローカルインターフェースを提供します。まずプレイグラウンドを使い、関連する質問を1つのリクエストにまとめ、数値推定や棄権が必要な場合はネイティブAPIを利用してください。本番環境で使用する前に、実際のアプリケーションを反映したデータで、精度、レイテンシ、キャリブレーション、量子化、バックエンドの動作をテストしてください。