

DeepSelectとは?
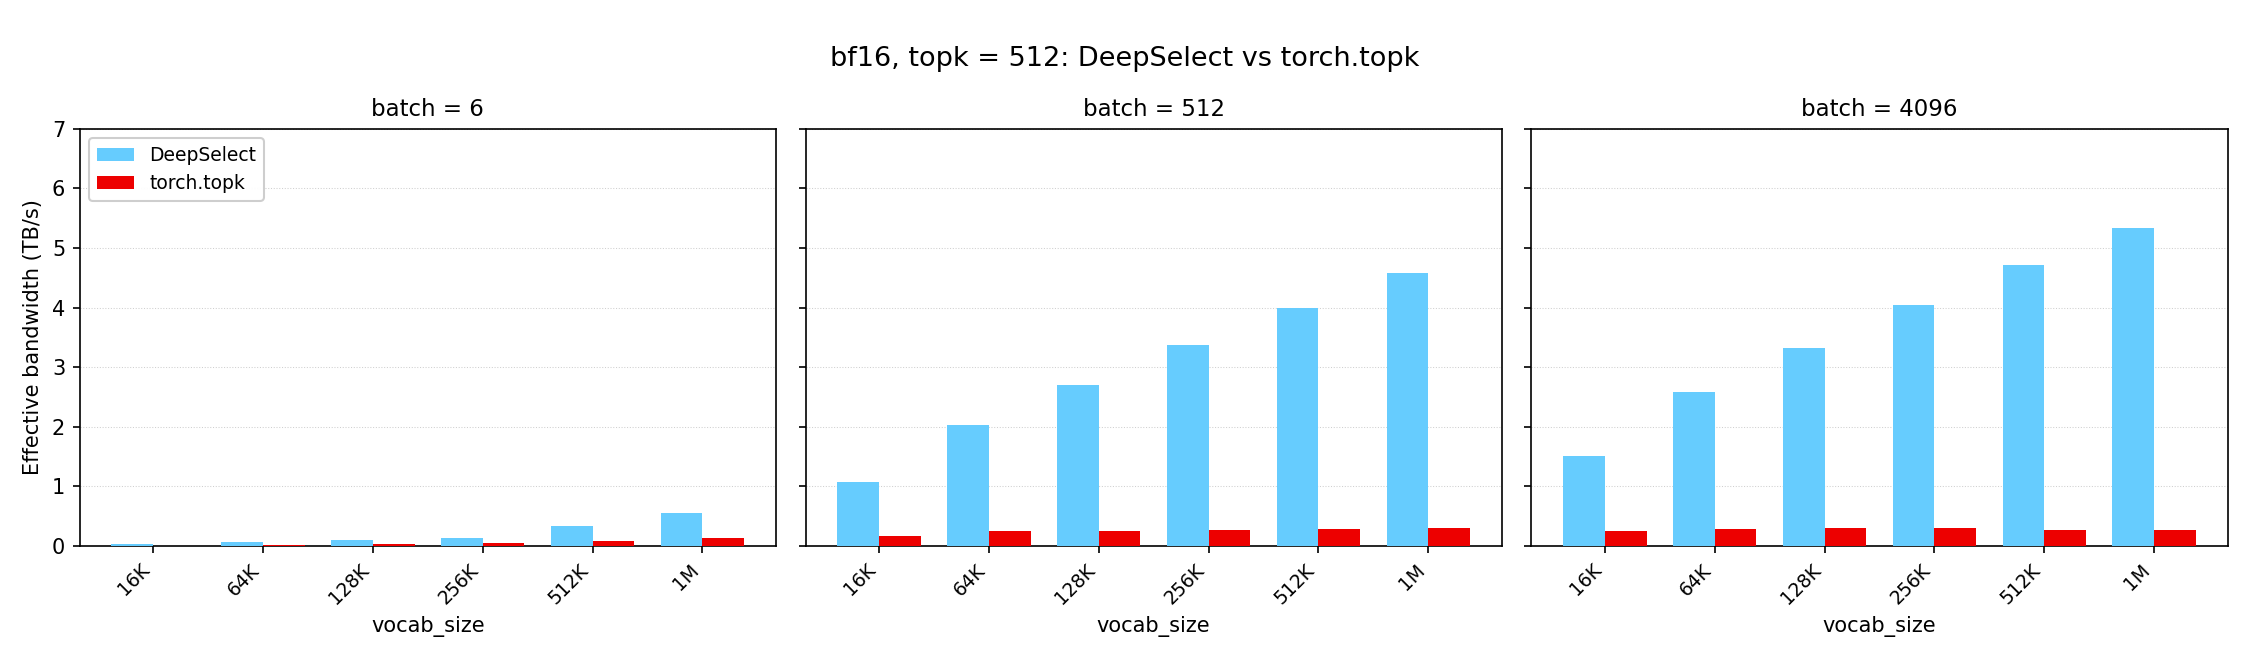
DeepSelectは、DeepSeek Sparse Attentionおよびサンプリングで使用されるTopKカーネルの高性能実装です。プロジェクトのREADMEによると、ライブラリがサポートするワークロードでは、標準のtorch.topkと比較して2~20倍の高速化を実現できます。
DeepSelectは、あらゆるTopK構成の最適化を試みるのではなく、2つのシナリオに集中しています。1つはtorch.bfloat16入力を使用するLightning Indexerワークロード、もう1つはtorch.float32入力を使用するサンプリングワークロードです。
サポートされるワークロード
Lightning Indexerシナリオ
- 入力型:
torch.bfloat16 - バッチサイズ:1以上。小規模および大規模バッチの両方に最適化
- 語彙サイズ:1以上。小規模および大規模語彙の両方に最適化
- TopKサイズ:小さく、
4096以下
パフォーマンスを向上させるには、結果を並べ替える必要がない限り、sorted_indexを無効にしてください。値が不要な場合は、return_value=Falseを設定して値の出力を省略します。
サンプリングシナリオ
- 入力型:
torch.float32 - バッチサイズ:1以上
- 語彙サイズ:約128K
- TopKサイズ:小さく、
4096以下
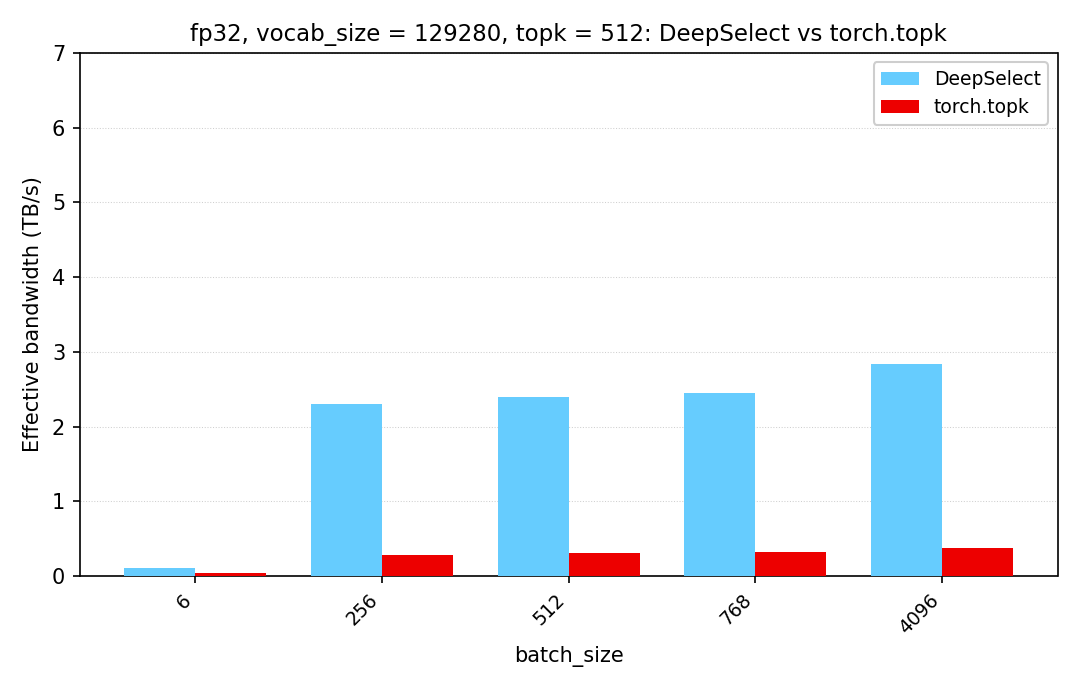
TopKは浮動小数点演算を実行しないため、リポジトリでは浮動小数点スループットではなく実効メモリ帯域幅を使用してパフォーマンスを測定します。ベンチマークでは、同じ入力に対するtorch.topkとの相対的なパフォーマンスを報告します。
主な機能
- DeepSeek Sparse Attentionおよびサンプリングワークロード向けに特化したTopKカーネル
- 対象シナリオにおける
torch.bfloat16およびtorch.float32入力のサポート torch.int32またはtorch.int64のインデックス出力を設定可能- インデックスのみが必要な場合にオーバーヘッドを削減できる、値出力のオプション
- 行ごとの排他的上限による可変長行
- インデックス用の呼び出し側管理出力バッファ
- 組み込みのNaNチェック
インストール
リポジトリをクローンし、サブモジュールを初期化して、プロジェクトディレクトリからパッケージをインストールします。
git clone https://github.com/deepseek-ai/DeepSelect.git
cd DeepSelect
git submodule update --init --recursive
pip install -v .例ではCUDAテンソルを使用するため、入力をdevice="cuda"上に作成してください。
基本的なTopKの使用方法
PyTorchとDeepSelectをインポートし、2次元の入力テンソルを作成して、deep_select.topkを呼び出します。
import torch
import deep_select

batch_size = 4
vocab_size = 204800
topk = 1024

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.bfloat16,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=True,
    indices_type=torch.int32,
    return_value=True,
)

print(values.shape)   # (4, 1024)
print(indices.shape) # (4, 1024)入力の形状は(batch_size, vocab_size)でなければなりません。最終次元は連続している必要があり、行ストライドはdeep_select.get_stride_requirement()[0]バイトの倍数でなければなりません。
返される値のデータ型はxと同じです。インデックスにはindices_typeで選択した型が使用され、torch.int32またはtorch.int64を指定できます。sorted_index=Trueの場合、各行で返されるインデックスは昇順に並べられます。
インデックスのみを返す
後続のコードで選択された値が不要な場合は、値の出力を無効にします。
values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=False,
    indices_type=torch.int32,
    return_value=False,
)
READMEによると、値の出力を省略すると約10%高速になります。並べ替えにはオーバーヘッドが発生するため、順序が必要な場合を除き、ソート出力の要求は避けてください。
ストライドのアライメント処理
DeepSelectでは、入力行と出力行にアライメント要件があります。実行時に確認できます。
input_alignment, output_alignment = deep_select.get_stride_requirement()

print("Input row-stride alignment:", input_alignment, "bytes")
print("Output row-stride alignment:", output_alignment, "bytes")
入力の行ストライドが必要な入力アライメントの倍数でない場合は、DeepSelectに渡す前にテンソルをパディングしてください。最終次元は連続した状態を維持する必要があります。
DeepSelectはデフォルトで両方の出力を確保します。出力のストライドはdeep_select.get_stride_requirement()[1]バイトにアライメントされるため、返されるテンソルは非連続になる場合があります。出力を使用するコードでは、標準的な連続ストライドを前提にしないでください。
既存のインデックスバッファを使用する
呼び出し側が管理するバッファにインデックスを書き込む場合、APIではoutput_idx=を受け付けます。このバッファは、同じ出力ストライド要件を満たす必要があります。カスタムバッファを設定する前に、完全な関数シグネチャについてdeep_select/interface.pyを確認してください。
可変長行の操作
endを使用すると、各行に排他的上限を割り当てられます。これは、同じバッチ内の行に異なる有効長が含まれる場合に便利です。
import torch
import deep_select

batch_size = 2
vocab_size = 129280

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.float32,
    device="cuda",
)

end = torch.tensor(
    [129280, 100000],
    dtype=torch.int32,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    1000,
    end=end,
    sorted=True,
    indices_type=torch.int64,
)ここでは、1行目はすべての129280要素を使用できますが、2行目は先頭の100000要素に制限されます。行の長さが要求されたTopKサイズより短い場合、DeepSelectは出力をvalue_oob_fill_valueおよびidx_oob_fill_valueでパディングします。
NaNの処理
NaNチェックは常に有効です。デフォルトではabort_when_nan_found=Trueのため、カーネルはNaNを検出するとtrap()を呼び出して中断します。有効長が要求されたTopKサイズ以下の行は、NaNチェックの対象になりません。
NaNが含まれる可能性がある場合、特にデフォルトの中断動作を維持する場合は、カーネルを起動する前に入力データを検証またはサニタイズしてください。
パフォーマンスと高度なヒント
- サポートされているTopKの範囲内に収める。 DeepSelectがサポートする小さなTopK値は
4096以下です。これを超える値はサポートされません。 - 想定するワークロードに合わせる。 プロジェクトで説明されているLightning Indexerのシナリオでは
torch.bfloat16を、サンプリングのシナリオではtorch.float32を使用してください。 - 可能な場合はソートを省略する。 インデックスまたは値による順序付けには性能コストがかかるため、後続処理で必要な場合にのみ要求してください。
- 可能な場合は値を省略する。 インデックスのみを使用する場合は、
return_value=Falseを設定してください。 - 早い段階でアラインメントを確認する。 性能が重要なループ内で互換性のないテンソルを修正するのではなく、
get_stride_requirement()を基準にテンソル形状とパディングを計画してください。 - 出力が連続していると仮定しない。 DeepSelectは出力行のストライドをアラインメントするため、生成されるテンソルは非連続になる場合があります。
- 実際の形状でベンチマークする。 TopKの性能は、入力型、バッチサイズ、語彙サイズ、TopKサイズに左右されます。アプリケーションで使用する正確な構成をテストしてください。
付属ベンチマークの実行
リポジトリのテストスクリプトには、パフォーマンスモードが含まれています。
python3 tests/test.py --perf-onlyこのベンチマークは、同じ入力に対してDeepSelectとtorch.topkを比較し、実効メモリ帯域幅を使用して比率を報告します。
まとめ
DeepSelectは、互換性のあるDeepSeek Sparse Attentionおよびサンプリングのワークロード向けに、専用のTopKカーネルを提供します。アラインメントされた2次元CUDAテンソルから始め、topkを4096以下に保ち、不要な場合はソートまたは値の出力を無効にしてください。本番環境に統合する際は、ストライド要件を確認し、出力が非連続になる可能性を考慮したうえで、アプリケーションで使用する正確なテンソル形状をベンチマークしてください。