

このプロジェクトの概要
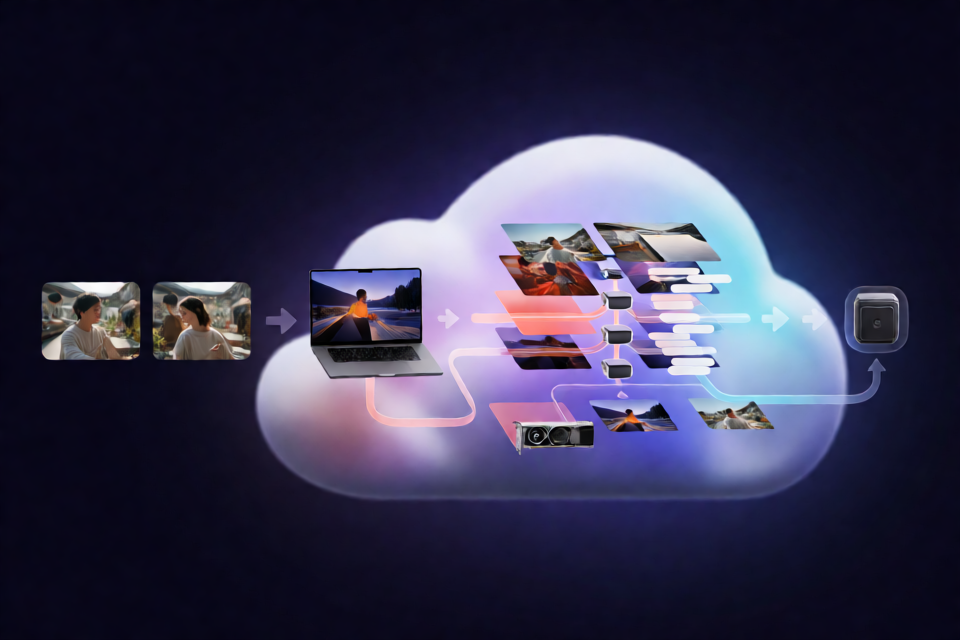
MiniMax H3 Ref2VA LoRA Colab Skillは、ペア画像データセットを準備し、Google ColabでMiniMax H3 Ref2VA LoRAをトレーニングするための、インストール可能なCodexスキルです。ランナーはローカル画像を整理し、データセットをパッケージ化し、付属のColabノートブックを起動します。チェックポイントと実行アーティファクトはGoogle Driveに保存され、最終的な.safetensorsアダプターがコンピューターにダウンロードされます。
このワークフローはMiniMax H3トランスフォーマー専用です。H3は画像理解パイプライン内でQwen3-VLを使用しますが、Qwen Imageは別のモデルです。Qwen Image LoRAはH3アダプターと互換性がありません。
主な機能
- ターゲット画像と参照・制御画像のペアデータセットを作成します。
- 利用可能な場合は、同じベース名のキャプションファイルを使用します。
- 再現性のあるキャプションと参照画像の選択に対応するJSONデータセットプランを使用できます。
- Google Colab上のOstris AI Toolkitを通じてMiniMax H3 Ref2VA LoRAのトレーニングを実行します。
- トレーニングステップ数、LoRAランク、アルファ、学習率、GPUタイプ、高メモリ要求を設定できます。
- チェックポイント、サンプル、設定、実行概要をGoogle Driveに同期します。
- 最終的な
.safetensorsアダプターをローカルの出力ディレクトリにダウンロードします。 - Colabの計算リソース残量を確認し、リモートランタイム接続をテストするコマンドを提供します。
前提条件
スキルをインストールする前に、ローカルシステムに以下があることを確認してください。
- Python 3.10以降。
- リモートコマンドを実行する前にインストールし、認証済みのGoogle Colab CLI。
- GPUハードウェアにアクセスできるColabアカウント。
- 適用されるライセンスへの同意を含む、必要なH3モデルおよびトレーニングアダプターのアセットへのアクセス。
- 予定しているトレーニング実行に十分なColab計算リソース。
付属のノートブックは、少なくとも60 GiBの空きディスク容量を確認し、GPU VRAMが48 GiB未満の場合に警告します。プロジェクトでは高メモリのA100を推奨していますが、公式な最小VRAM保証はありません。
Codexスキルをインストールする
リポジトリをクローンし、インストーラーを実行します。
git clone https://github.com/killkli/minimax-h3-lora-colab-skill.git
cd minimax-h3-lora-colab-skill
./install.shCODEX_HOMEが設定されている場合、インストーラーはスキルを$CODEX_HOME/skillsの下に配置します。それ以外の場合は~/.codex/skillsを使用します。
別のスキルディレクトリにインストールするには、--destを指定します。
./install.sh --dest /path/to/skills既存のインストールはデフォルトで保持されます。意図的に置き換える場合は--forceを使用してください。インストーラーは以前のコピーを黙って削除せず、タイムスタンプ付きのバックアップに移動します。
インストールを確認する
Colabジョブを起動せずにランナーのヘルプを表示します。
python3 ~/.codex/skills/minimax-h3-lora-colab/scripts/runner.py --helpCODEX_HOMEを設定している場合は、~/.codex/skillsを$CODEX_HOME/skillsに置き換えてください。ローカルでのインストール確認とヘルプ確認では、トレーニングは開始されず、ColabのGPU時間も消費されません。
トレーニング画像を準備する
ターゲット写真を1つのディレクトリに配置します。写真には同じ人物または対象を写してください。必要に応じて、ベース名が一致するテキストファイルとしてキャプションを追加できます。たとえば、photo01.jpgのキャプションをphoto01.txtに記述できます。
クローンしたリポジトリから、次のコマンドでデータセットを準備します。
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
準備されたディレクトリには、次の内容が含まれます。
prepared_dataset/
├── targets/
├── references/
└── dataset_manifest.jsontargets/には、ターゲット画像と、同じベース名のキャプションファイルが含まれます。references/には、ターゲットとベース名が一致する参照画像または制御画像が含まれます。dataset_manifest.jsonには、各サンプルのソース、ターゲット、参照画像、キャプションが記録されます。
データセットの準備はローカルで行われます。元の写真は準備済みデータセットにコピーされますが、Colabにはアップロードされません。
参照画像を自動的に選択する
別の参照フォルダーを指定しない場合、ランナーには少なくとも2枚のターゲット写真が必要です。ランナーはそれらの写真を順番に使用して参照ペアを作成します。
可能であれば、同じ対象について、用途の異なる有用な構図を使用してください。ターゲット自身を参照画像にしないでください。
別の参照フォルダーを使用する
別のディレクトリから参照画像を選択するには、--reference-dirを追加します。
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
選択するすべての参照画像には、ターゲットセットと同じ対象を写してください。大規模なコレクションの一部だけを選別する場合は、選択したターゲットと参照画像をステージング用フォルダーに配置し、元の画像コレクションには手を加えないでください。
再現可能なデータセットプランを作成する
データセットプランには、画像ごとのキャプションと、任意のターゲットと参照画像の対応が記録されます。これにより、手動またはエージェントによる選別を再現できます。
{
  "captions": {
    "photo01.jpg": "studio_subject person, waist-up portrait in a blue jacket, outdoors in soft daylight",
    "photo02.jpg": "studio_subject person, side profile wearing a white shirt, indoors by a window"
  },
  "references": {
    "photo01.jpg": "front_reference.png",
    "photo02.jpg": "side_reference.png"
  }
}
captions オブジェクトには、対象画像ごとのベース名をすべて含める必要があります。任意の references オブジェクトを指定する場合は、対象画像の各ベース名を、候補参照ディレクトリ内の画像ベース名にも対応付ける必要があります。
キャプションには、目に見える詳細のみを記述してください。関係のない人物や対象は別のデータセットに分け、対象画像をそれ自体に対応付けないでください。
次のプランを使用してデータセットを準備します。
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --dataset-plan /path/to/dataset-plan.json \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
--dataset-plan を省略すると、runner は既存のサイドカーキャプションを使用し、キャプションがない場合は簡単なデフォルト値を設定します。
アップロード前の確認
トレーニング前に dataset_manifest.json を開き、各ソース、対象、参照、キャプションを確認してください。誤った対応付け、説明の欠落、別の対象に属する画像を見つけるには、この段階が最適です。トレーニングでは、準備済みの画像が Colab ランタイムにアップロードされます。
Google Colab で LoRA をトレーニングする
準備済みのデータセットを確認したら、トレーニングを開始します。
python3 scripts/runner.py train \
  --dataset-dir ./prepared_dataset \
  --name studio_subject \
  --trigger "studio_subject person" \
  --steps 1000 \
  --rank 16 \
  --alpha 16 \
  --gpu A100 \
  --output-dir ./outputs
デフォルトのトレーニング設定は次のとおりです。
- トレーニングステップ数 1,000。
- LoRA ランク 16。
- Alpha 16。
- 学習率
1e-4。 - 大容量メモリの A100 Colab セッション。
ノートブックは H3 モデルと、必要なトレーニングアダプター用アセットをダウンロードします。最終アダプターは ./outputs/ に .safetensors ファイルとして配置されます。
実行時の成果物は次の場所にも同期されます。
MyDrive/MiniMax_H3_LoRAs/<name>/<run-id>/Drive ディレクトリには、チェックポイント、生成サンプル、設定データ、実行概要が含まれます。
トレーニングパラメーターの変更は慎重に行う
ステップ数、ランク、アルファ、GPU、出力ディレクトリには、例の値とは異なる値を指定できます。サポートされているすべてのトレーニングオプションを確認するには、次を実行します。
python3 scripts/runner.py train --helpデフォルトでは大容量メモリモードが要求されます。選択した Colab GPU 割り当てでその要求を省略する場合にのみ、--no-high-mem を追加してください。
Colab の使用状況と接続を確認する
現在の Colab 計算残高を JSON 形式で読み取るには、次を使用します。
python3 scripts/runner.py usage --jsonリモート GPU ランタイムを用意し、プローブ、ファイル転送、Google Drive パスを確認するには、次を実行します。
python3 scripts/runner.py test
testコマンドはトレーニングの検証ではありません。MiniMax H3 のトレーニングが利用可能な VRAM に収まることや、正常に完了することを保証するものではありません。
高度なヒントと運用ガイダンス
対象セットを絞り込む
1 つのデータセットには、1 人の人物または 1 つの対象の画像だけを使用してください。関係のない対象を分けると、キャプションと参照の対応付けが明確になり、runner が想定するワークフローにも沿うことができます。
画像ごとのキャプションを使用する
一般的なキャプションだけに頼らず、ポーズ、服装、構図、環境、照明など、目に見える属性を記述してください。選択したトリガーは一貫して含めますが、画像から確認できない詳細は追加しないでください。
有用な参照の多様性を優先する
同じ対象を描写しながら、さまざまな視点を提供する参照画像を選んでください。たとえば、適切な場合は正面向きと横顔の画像を組み合わせます。対象をそれ自体と組み合わせないでください。
確認可能な記録を保持する
データセットプランと生成されたマニフェストをプロジェクトとともに保管してください。これらを合わせることで、実行に使用したキャプションと対応付けが記録され、準備プロセスの監査や再実行が容易になります。
ローカルとクラウドの出力を監視する
ローカルの出力ディレクトリにはダウンロードされた最終アダプターが含まれ、Google Drive にはより広範な実行成果物が保持されます。トレーニングが予期せず停止した場合は、Drive のコピーでチェックポイント、サンプル、設定、実行概要を確認してください。
ハードウェアへの適合はランタイムに依存すると考える
推奨される大容量メモリの A100 でも、成功が保証されるわけではありません。実際に必要なメモリ量は、Colab ランタイムとトレーニング設定によって異なります。ノートブックは VRAM が 48 GiB 未満の場合に警告し、空きディスク容量が 60 GiB あるか確認しますが、これらの確認は公式のハードウェア保証ではありません。
検証状況を理解する
上流の AI Toolkit Ref2VA のサンプル設定には、未検証のマークが付いています。そのため、このリポジトリはすべてのクラウドトレーニング実行が成功するとは主張していません。ノートブックは再現性のため、確認済みの AI Toolkit ソースコミットを固定していますが、インストールの成功やリモートプローブの成功を、エンドツーエンドのトレーニング完了の証拠と解釈しないでください。
参考資料
結論
MiniMax H3 Ref2VA LoRA Colab Skillは、ローカルでの画像キュレーションからダウンロード可能なH3アダプターの作成まで、再現可能な手順を提供します。ターゲット画像と参照画像のペアをローカルで準備・確認し、再現性のあるキャプションとマッピングが必要な場合はデータセット計画を使用します。Colabのリソースとライセンスを確認してから、トレーニングを開始してください。上流の設定は未検証のままであり、Qwen Image LoRAはMiniMax H3アダプターと互換性がない点に注意してください。