

Tiny Classifiersの概要
tiny-classifiersは、小規模でタスク特化型のテキスト分類器をトレーニングするための実用的なレシピです。1,700万パラメータのEttin-17Mエンコーダーを使用し、すべての重みをファインチューニングして、標準的なHugging Faceモデルとして保存します。
このプロジェクトは、銀行メッセージの振り分け、ニュースの分類、ユーザー意図の認識、感情分析、法務文書の定義済みカテゴリへの割り当てなどの分類タスク向けに設計されています。ラベル付きサンプルが十分にない場合は、より大規模な言語モデルを教師として使い、トレーニングセットにラベルを付けることができます。
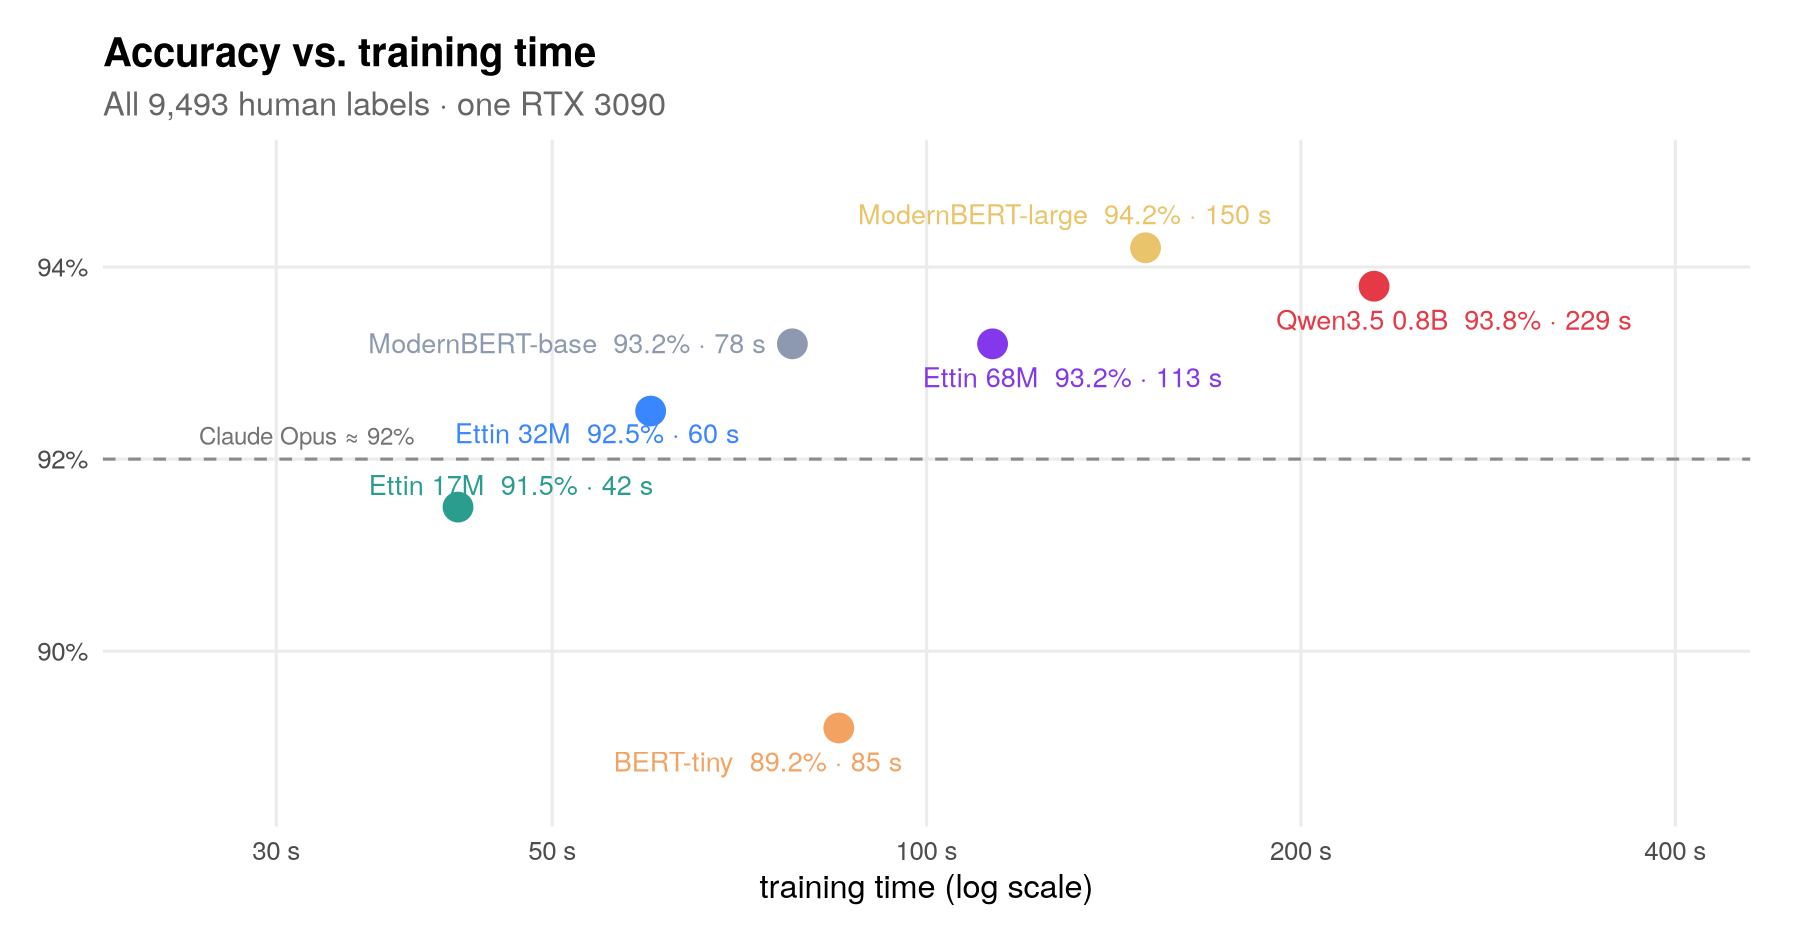
リポジトリのBanking77実験では、Ettin-17Mの精度は91.5%に達し、Claude Opusの92%に迫りました。トレーニングはゲーミングGPU 1台で42秒、推論はメッセージ1件あたり約5ミリ秒でした。トレーニングはノートPCのCPUでも約11分、スマートフォンのGPUでも約21分で実行できました。
Banking77の精度とトレーニング時間の比較。
主な機能
- 小規模なローカルモデル:Ettin-17Mは1,700万パラメータを持ち、カテゴリごとに1つのスコアを出力します。
- 人手または教師によるラベル:検証済みのラベルでトレーニングするか、Kimi K3に未ラベルのメッセージのラベル付けを依頼できます。
- GPUおよびCPUトレーニング:トレーニングスクリプトは両方の環境に対応しています。
- 標準モデル出力:トレーニング済みの分類器は、Hugging Faceの
transformersパイプラインから読み込めます。 - 再開可能なラベル付け:ラベル付けスクリプトは、再試行、適応型同時実行数、遅いリクエストへのヘッジ、プロバイダーごとの予算に対応しています。
- 組み込み評価:トレーニングではテスト精度をレポートし、教師によるラベル付けではラベル付きテストセットに対する教師の精度を測定できます。
- コスト分析:損益分岐点スクリプトにより、API経由で分類料金を支払うよりもラベル付けとトレーニングが安くなる時点を推定できます。
- 再利用可能なデータ準備:10種類の公開分類データセットを、統一された構造で準備できます。
トレーニングレシピの仕組み
Ettin-17Mは、Johns Hopkinsが公開したオープンなエンコーダーで、BERT系モデルに関連しています。トークンごとにテキストを生成する生成モデルとは異なり、入力全体を読み取り、利用可能な各カテゴリにスコアを割り当てます。
このリポジトリはカテゴリごとに1つの出力を追加し、モデルのすべての重みをファインチューニングします。デフォルトのレシピでは、バッチサイズ32、学習率1e-4のAdamW、重み減衰0.01、5%のウォームアップ後にコサイン減衰、勾配クリッピング1.0、クロスエントロピー損失を使用します。
約9,500件のメッセージでは、トレーニングを6パス実行します。サンプルが2,000件 בלבדの場合も同じ最適化ステップ数を使うため、約28パスに相当します。READMEでは、これらの設定はタスクごとに個別チューニングされていないことを強調しています。
インストールとセットアップ
1. uvをインストールする
スクリプトはuvを使って必要な環境を作成し、初回実行時に依存関係を自動インストールします。お使いのOS向けの手順に従ってuvをインストールし、リポジトリのルートディレクトリでターミナルを開いてください。
2. 公開データセットを準備する
準備スクリプトを実行します。
uv run recipe/prepare.pyこのスクリプトは、Hugging Face HubからBanking77、CLINC150、英語およびフランス語のMASSIVE、TREC、AG News、SST-5、Financial PhraseBank、LEDGAR、ツイートのヘイトスピーチデータセットをダウンロードします。
各タスクについて、data/tasks/の下にディレクトリを作成します。タスク定義、2,000件のトレーニングメッセージ、カテゴリごとに最大150例を含むより大きなトレーニング分割、テストセットを構築します。
3. ラベル付けプロバイダーを設定する
教師モデルでラベルを生成する場合は、対応するプロバイダーのAPIキーを1つ以上設定します。
export OPENROUTER_API_KEY=...このレシピは、Fireworks、Together、DeepInfra、Parasailに関連付けられたプロバイダーキーにも対応しています。データを送信したり、生成された回答をトレーニングに使用したりする前に、各プロバイダーの最新の料金、利用ポリシー、モデル規約を確認してください。
基本チュートリアル:AG News分類器をトレーニングする
ステップ1:Kimi K3でラベルを生成する
データセットを準備したら、AG Newsのトレーニングメッセージ2,000件にラベルを付けます。
uv run recipe/label.py data/tasks/agnews報告された実行例では、Kimi K3は約20秒、約1ドルで2,000例にラベルを付けました。実際の時間と費用はプロバイダーによって異なる場合があります。スクリプトは再開可能なため、中断されたラベル付け作業を最初からやり直す必要はありません。
ステップ2:教師ラベルでEttin-17Mをファインチューニングする
生成したラベルファイルをトレーニングスクリプトに渡し、出力ディレクトリを指定します。
uv run recipe/train.py data/tasks/agnews --labels labels/agnews-train.jsonl --save models/agnewsスクリプトは分類器をファインチューニングし、テストセットで評価してテスト精度を表示し、Hugging Face互換モデルをmodels/agnewsに保存します。
ステップ3:人手ラベルのベースラインをトレーニングする
教師ラベル引数を付けずに同じトレーニングスクリプトを実行し、データセット本来の人手ラベルでトレーニングします。
uv run recipe/train.py data/tasks/agnewsこの比較により、知識蒸留の過程でどの程度性能が失われたかを把握できます。リポジトリのチュートリアル実行では、人手ラベルで89.2%、Kimi K3のラベルで85.1%、Qwen3.8-27Bのラベルで81.8%の精度になりました。
ステップ4:新しいテキストを分類する
Hugging Faceのパイプラインで保存したモデルを読み込みます。
from transformers import pipeline

classify = pipeline(
    "text-classification",
    model="models/agnews",
    device="cpu"
)

result = classify(
    "NASA's new telescope finds water vapour on a distant planet"
)
print(result)結果は、予測されたラベルとそのスコアを含むリストです。この例で期待されるカテゴリはSci/Techです。報告されたAG Newsモデルは、CPU上でメッセージ1件を約6ミリ秒で処理しました。
独自データで小型分類器を使う
1. タスクディレクトリを作成する
data/tasks/agnews/と同じ構成に従ってフォルダーを作成します。各カスタムタスクには、task.json、train.jsonl、test.jsonlの各ファイルが必要です。
2. カテゴリを定義する
task.jsonファイルには、名前、1文の指示、ラベルの完全な一覧を含める必要があります。
{"name":"support-routing","instruction":"Assign each support message to the correct team.","labels":["billing","technical","account"]}区別しやすく、意味の明確なラベル名を使用します。指示では、モデルまたは教師が行う分類判断を明確に説明してください。
3. 学習用およびテスト用レコードを追加する
1行につき1つのJSONオブジェクトを保存します。ラベル付きレコードの構造は次のとおりです。
{"id":"msg-001","text":"I was charged twice for my subscription.","label":"billing"}教師モデルで学習データにラベルを付ける場合、train.jsonl内のレコードではlabelフィールドを省略できます。
{"id":"msg-002","text":"The application closes whenever I upload a file."}テストレコードには確認済みのラベルを付け、教師と学生の両方の精度を測定できるようにします。本番環境でモデルを信頼して使う前に、数百件のテストメッセージを手作業で確認することをプロジェクトは推奨しています。
4. ラベル付け、学習、評価を行う
標準コマンドで自分のディレクトリに置き換えます。
uv run recipe/label.py data/tasks/support-routing
uv run recipe/train.py data/tasks/support-routing \
  --labels labels/support-routing-train.jsonl \
--save models/support-routing--labelsを省略すれば、人間が付けたラベルを直接使って学習することもできます。Ettin-17M以外のエンコーダーを使うには、学習スクリプトの--modelオプションでモデルを指定します。
ファインチューニングの採算性を測定する
タスクの準備後に損益分岐点分析を実行します。
uv run recipe/breakeven.pyこのスクリプトは、費用と時間の両方を考慮し、ラベル付けと学習にかかる初期費用を回収するまでに分類しなければならないメッセージ数を推定します。Jevのゼロショット分類APIと比較すると、リポジトリで確認された損益分岐点はタスクによっておよそ5万〜50万メッセージでした。
処理量が少ない、または不確実な場合は、APIの方がシンプルな選択肢になる可能性があります。タスクが安定していて評価データがあり、分類量が多い場合は、ファインチューニングの魅力が高まります。
高度なヒント
ラベルの品質を優先する
実験では、モデルのサイズよりもラベルの方が重要であることが分かりました。ラベル付きの例を増やすほど、学習曲線は向上し続けました。教師が学習した学生モデルは、一般に教師モデルを精度数ポイント下回りましたが、人間によるラベル付けではその上限を超えられる可能性がありました。
アーキテクチャを変更したり、多数のハイパーパラメータを調整したりする前に、曖昧なカテゴリを見直し、体系的なラベル付けミスを修正し、代表的な例を追加してください。
教師を個別に評価する
タスクの性能が低い教師を、学生が確実に補うことはできません。10タスクの結果では、教師自体が弱いタスクで、教師ラベル付きモデルの性能が低下しました。人間が確認したテストセットを保持し、はるかに大規模なデータセットのラベル付けに費用をかける前に、教師の精度を測定してください。
実験結果の変動を考慮する
READMEでは、乱数シードによる約±0.5ポイント、テストセットのサイズによる±1.5〜2ポイントの変動が報告されています。公開されている表では、3回の実行結果の平均を使用しています。小さな精度差がデプロイの判断に影響する場合は、複数回の実行と十分な大きさのテストセットを使用してください。
ライセンスとプロバイダーの規約を守る
教師モデルのライセンスとプロバイダーの規約が許可している場合に限り、生成された回答で学習してください。リポジトリではKimi K3を使用していますが、一部のモデルやAPIでは、その出力を別のモデルの学習に使うことを禁止しています。公開データセットにもそれぞれのライセンスがあり、リポジトリは再配布せずにダウンロードします。
別のハードウェアを試す
メインの学習スクリプトはCPUとGPUでの実行をサポートしています。リポジトリには、WebGPUとjax-jsを使ってChrome上で学習する、スマートフォン向けの別実装も含まれています。スマートフォンのワークフローは専用の実装として扱い、プロジェクトのphone/ディレクトリにある指示に従ってください。
文書化されたNixOSの問題を回避する
NixOSでの学習が/sbin/ldconfigが見つからないために失敗する場合は、学習を実行する前にCUDAライブラリパスを設定します。
export TRITON_LIBCUDA_PATH=/run/opengl-driver/libまとめ
tiny-classifiersは、ラベル付きテキストを高速なローカル分類器に変換するための簡潔なワークフローを提供します。タスクを準備し、人間または教師によるラベルを取得し、Ettin-17Mをファインチューニングし、確認済みの例で評価し、ローカル推論が経済面でAPIを上回るかを見積もります。
最も重要な教訓は、信頼できるラベルと評価データに投資することです。それらがあれば、1,700万パラメータのエンコーダーでも、高い分類精度、ミリ秒単位の推論、予測可能なローカル運用コストを実現でき、すべてのメッセージで大規模モデルを呼び出す必要がなくなります。