

Recurrent Looped Transformerとは?
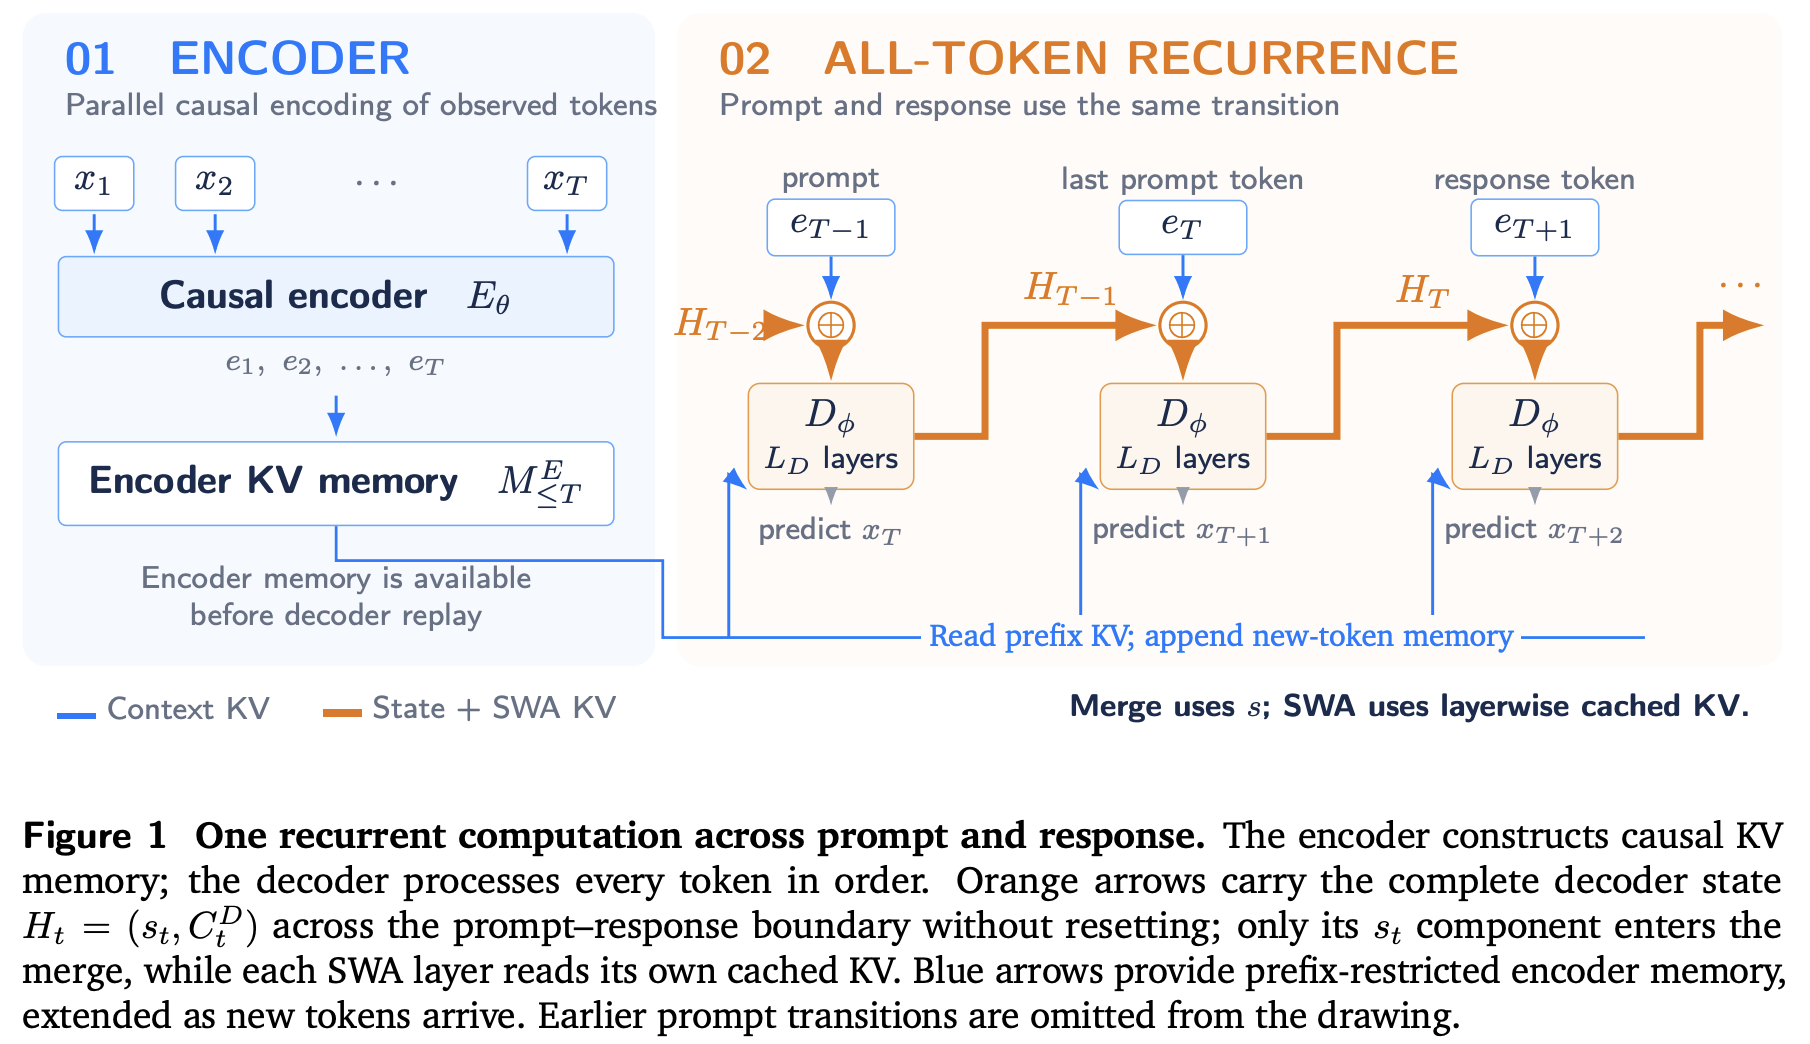
Recurrent Looped Transformer(RLT)は、系列内のすべてのトークンにわたって潜在計算を引き継ぐよう設計された研究用アーキテクチャです。因果エンコーダーがグローバルなキー・バリューメモリを構築し、リカレントデコーダーがそのメモリをスライディングウィンドウアテンションおよび直前の最終隠れ状態からのフィードバックと組み合わせます。
これにより、拡張可能な時間的計算経路が生まれます。デコーダーの層数がL_Dである場合、t個のトークンを処理すると、各トークンでは固定数のブロックしか実行しないにもかかわらず、tL_D個のデコーダーブロックを通るリカレント経路が形成されます。
このプロジェクトにおける「無限の時間的深さ」とは、計算経路が系列長に応じて拡大できることを意味します。1つのトークン内でモデルが無限の計算を行うという意味ではありません。
主な設計原則
1. 時間方向の潜在推論
あるトークンに対するデコーダーの最終出力は、次のトークンへの入力になります。その結果、モデルはプロンプトと生成応答の境界をリセット地点として扱うのではなく、プロンプト全体と生成された応答を通じて潜在状態を伝播できます。
2. モデルとハードウェアの協調設計
提案された設計には、次のような最適化の可能性があります。
- 既知のトークンに対する因果エンコーダー計算の並列化
- 独立した系列間でのバッチ処理
- エンコーダー由来メモリの再利用
- リカレントデコーダー実行周辺でのアクティベーションチェックポイント
これらは設計上の可能性および研究目標です。このレポートは、大規模ハードウェアで測定された高速化を主張するものではありません。
3. 学習と強化学習における共有セマンティクス
事前学習、教師ありファインチューニング、サンプリング、現行ポリシーによる強化学習のリプレイは、すべて同じ完全な状態遷移を使用します。この状態には、プロンプトのリカレンスとデコーダーのスライディングウィンドウ・キー・バリューキャッシュの両方が含まれます。
アーキテクチャの仕組み
トークンx_tに対して、因果エンコーダーは表現e_tと、エンコーダー由来のグローバルメモリM_≤tを生成します。デコーダー状態は、リカレント出力と層ごとのスライディングウィンドウ・アテンションキャッシュの両方を保持します。
H_t = (s_t, C_t^D)
H_0 = (s_*, empty)
状態遷移は次のとおりです。
(s_t, C_t^D) = D_phi(
  Merge(e_t, s_(t-1)),
  M_≤t,
  C_(t-1)^D,
  t
)
次のトークンの分布は、最終リカレント出力から計算されます。
p(x_(t+1) | x_(1:t)) = softmax(W_o RMSNorm_o(s_t))3種類のコンテキスト
- グローバルエンコーダーコンテキスト:デコーダーのクロスアテンションは現在位置を介してのみエンコーダーメモリを読み取り、因果的な動作を維持します。
- ローカルデコーダーメモリ:スライディングウィンドウアテンションは、直近のデコーダーのキー・バリューエントリと現在のトークンのエントリを読み取ります。サイズ
Wのウィンドウには現在のトークンが含まれるため、次の更新で保持できる過去のエントリは最大W - 1個です。 - 時間的フィードバック:直前のデコーダー最終出力が現在のエンコーダー表現とマージされます。
系列がプロンプトから応答へ移行しても、リカレント出力もデコーダーキャッシュもリセットされません。
具体的なモデル構成
このレポートでは、エンコーダー層48層、デコーダー層48層の構成について説明しています。互換性のあるアテンション重みとフィードフォワード重みはステージ間で共有されます。デコーダーブロックはさらにエンコーダーメモリに対するクロスアテンションを実行するため、層数が同じでも浮動小数点演算数が同じであるとは限りません。
インストールとリポジトリのセットアップ
READMEは、文書化されたソフトウェアパッケージではなく、アーキテクチャに関するレポートを提示しています。依存関係の要件、インストールコマンド、公開トレーニングスクリプト、実行可能なAPIは提供されていません。それでも、論文と関連資料を読むためにリポジトリをクローンできます。
git clone https://github.com/yifanzhang-pro/recurrent-looped-tranformer.git
cd recurrent-looped-tranformerまず、同梱されているRecurrent_Looped_Transformer.pdfを確認してください。また、プロジェクトウェブサイトにアクセスし、プレフィルとデコードのカーネル不一致に関する資料も確認できます。
READMEには実行可能な実装が記載されていないため、パッケージのインストール手順やすぐに実行できるモデルコードをリポジトリの説明から推測すべきではありません。
基本的な使用方法:RLTの実行モデルに従う
このレポートを適用する最も有用な方法は、実装の設計図として利用することです。次の概念的な擬似コードは、1回の状態遷移を要約したものであり、リポジトリが提供するAPIではありません。
state = (initial_recurrent_state, empty_decoder_cache)

for each token x_t:
    e_t = causal_encoder_representation(x_t)
    memory = encoder_memory_through_position(t)

    merged = Merge(e_t, state.recurrent_output)
    state = recurrent_decoder(
        merged,
        memory,
        state.decoder_cache,
        position=t
    )

    next_token_distribution = output_head(state.recurrent_output)
プロンプトのプレフィル
- 既知のプロンプトトークンに対して、因果エンコーダーをバッチ処理で実行します。
- すべてのプロンプトトークンをデコーダーに通し、各トークンでリカレント処理を行います。
- このリカレンス中に、デコーダーのスライディングウィンドウ・キー・バリューキャッシュを構築します。
- 生成に使用するため、最終リカレント出力とキャッシュを保持します。
プロンプトのプレフィル中にエンコーダーだけを実行しても、レポートで説明されているRLTの完全な状態は再現できません。
自己回帰生成
- 直前の状態を使用して、次のトークンの分布を計算します。
- その分布からトークンをサンプリングします。
- サンプリングしたトークンを逐次的にエンコードします。
- そのトークンをリカレントデコーダーで正確に1回だけ処理します。
- リカレント出力とスライディングウィンドウキャッシュの両方を更新します。
この順序により、生成されたトークンを二重に処理することを避け、学習時と同じ状態遷移の意味論を維持できます。
事前学習と教師ありファインチューニング
事前学習では、エンコーダーは因果的に動作し、リカレントデコーダーは時間方向の完全な逆伝播を使用します。すべての有効な次トークンのターゲットに対して教師信号が与えられます。
教師ありファインチューニングでは、すべてのコンテキストトークンで状態を更新しますが、損失を適用するのはアシスタントのターゲットだけです。プロンプトのトークンに教師信号が与えられない場合でも、プロンプトはリカレント状態の構築に参加します。
現行ポリシーによる強化学習リプレイ
現行ポリシーのリプレイでは、現在のモデル重みの下で完全な系列履歴を再構築する必要があります。これには、リカレント出力、エンコーダーメモリ、すべてのデコーダーのスライディングウィンドウキャッシュが含まれます。
- 現在のパラメータを使用してエンコーダー表現とメモリを再構築します。
- 過去のすべてのトークンをリプレイし、リカレント状態とデコーダーキャッシュを再構築します。
- アクショントークンを処理する前に、そのアクションの確率を評価します。
- アクションを1回処理して、次の状態へ進みます。
パラメータに依存するキャッシュは重みの更新後に古くなるため、正確なリプレイには再構築が必要です。完全な勾配は、リカレント出力、デコーダーのキー・バリューエントリ、エンコーダーメモリを通過します。これらのコンポーネントのいずれかを切り離すことは、勾配の近似にあたります。
行動の対数確率は、サンプリングに実際に使用した分布に対応していなければなりません。厳密な重要度サンプリングには、さらにサポートのカバレッジが必要です。実行意味論を共有することで、構造的なプロンプト境界の不一致は減りますが、カーネル間の数値的な一致や、偏りのないオフポリシー目的関数が保証されるわけではありません。
初期の合成結果
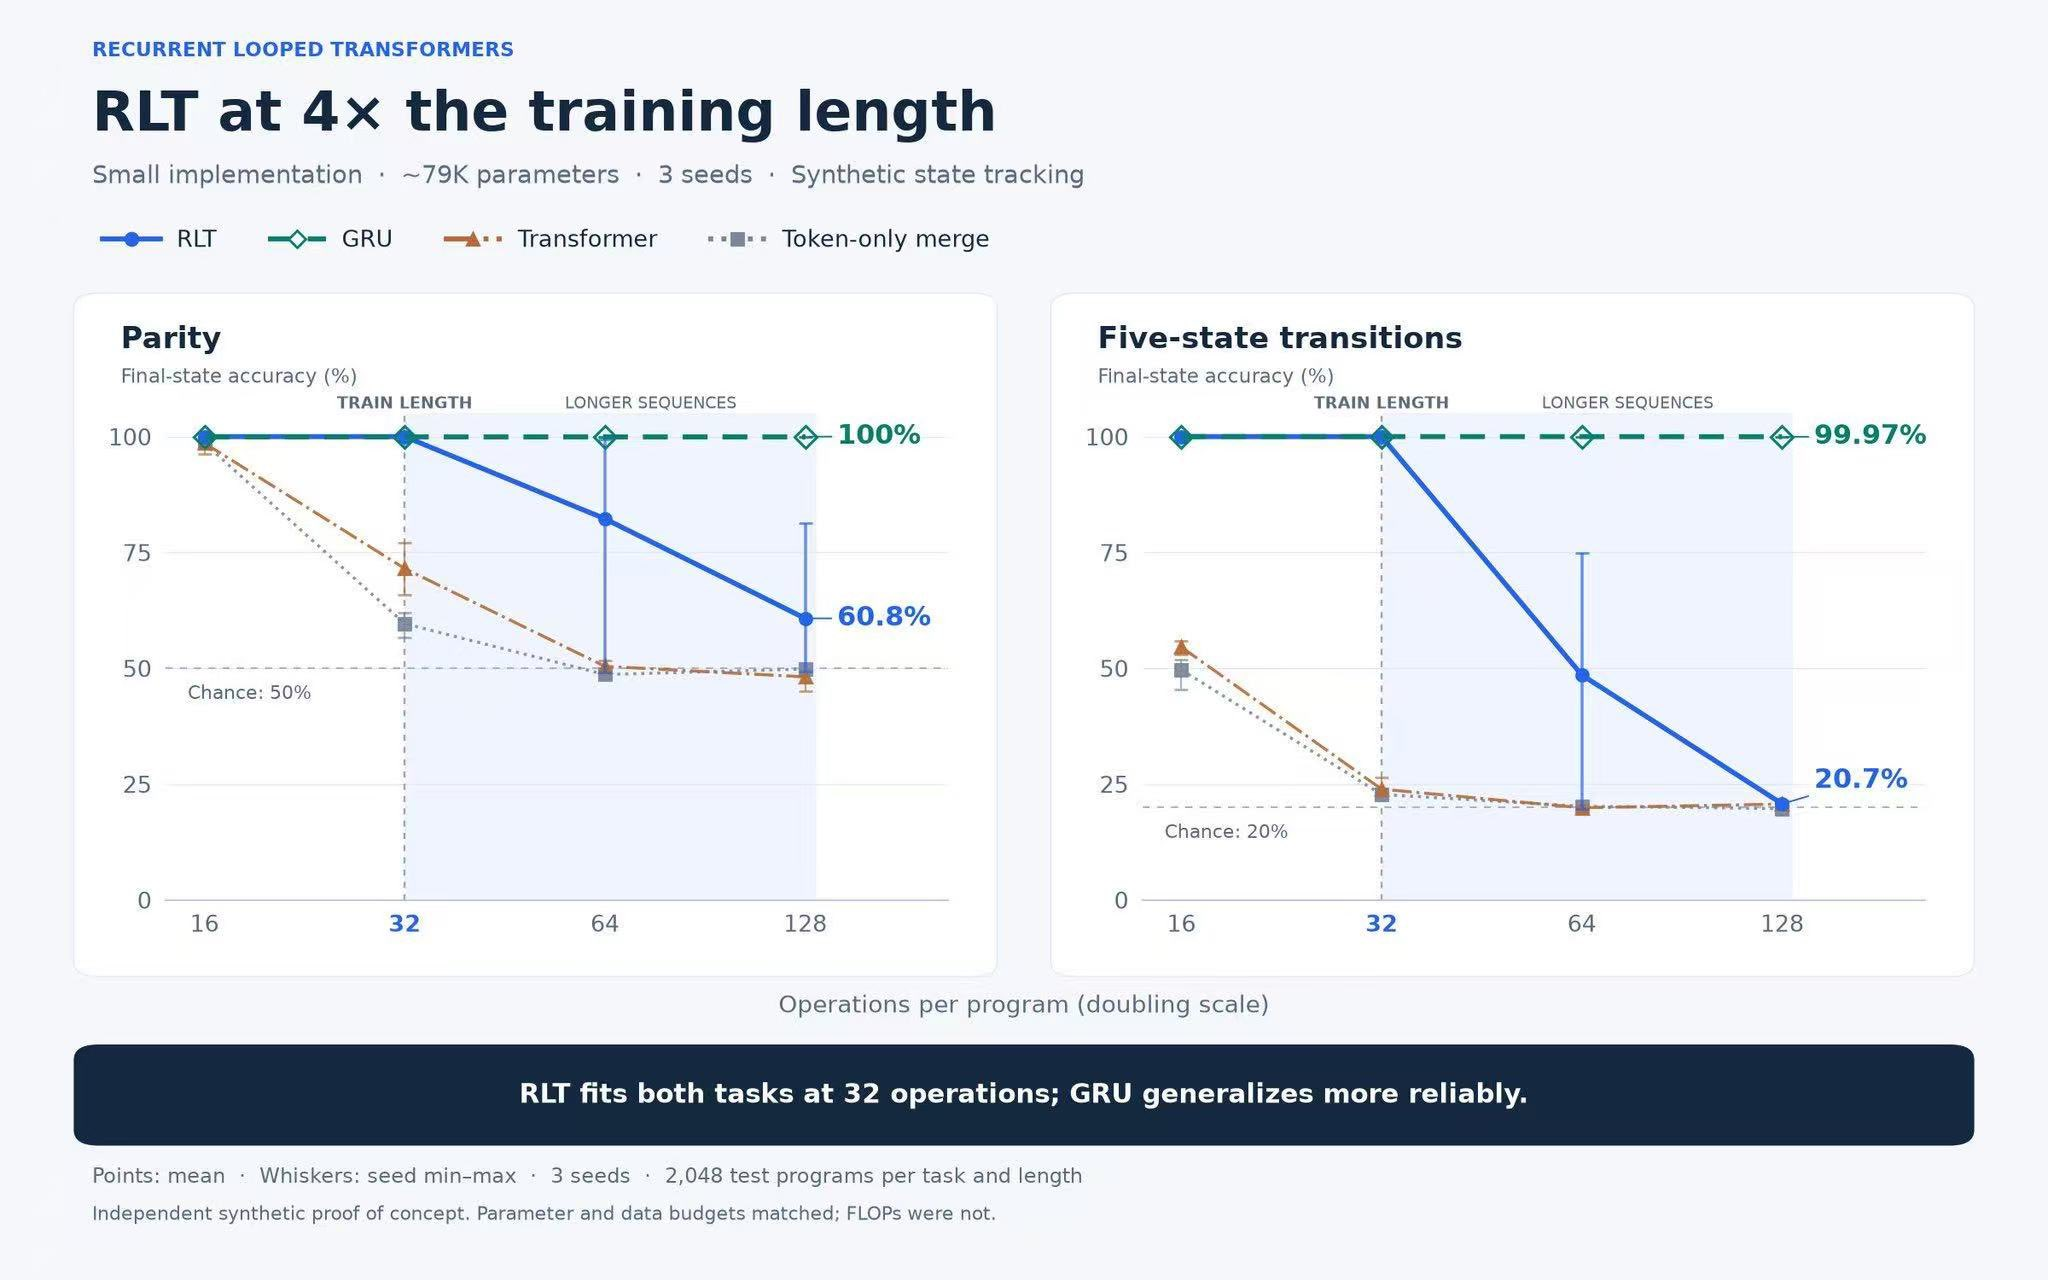
READMEでは、約79,000個のパラメータと3つの乱数シードを使用した小規模な実装による、独立した概念実証の状態追跡実験が報告されています。モデルは32操作の系列で学習され、最大128操作の系列で評価されました。各タスクおよび各系列長について、2,048個のテストプログラムが使用されています。
パリティタスク
- 32操作では、RLTは最終状態の正解率として約100%に到達しました。
- 64操作では、約82%に到達しました。
- 128操作では、60.8%でした。
- パリティの偶然による正解率は50%です。
5状態遷移タスク
- 32操作では、RLTは最終状態の正解率として約100%に到達しました。
- 64操作では、約49%に到達しました。
- 128操作では、20.7%でした。
- このタスクの偶然による正解率は20%です。
結果から、RLTは学習時の系列長では両方のタスクに適合しましたが、より長い系列では正解率が低下したことが分かります。近似値と記された値は元の図から読み取ったものであり、128操作時のRLTの値は数値としてラベル表示されていました。
パラメータ予算とデータ予算は一致させられていますが、浮動小数点演算の予算は一致していません。これらの実験は合成データによるデモンストレーションであり、大規模な推論性能の向上、ハードウェアアクセラレーション、強化学習のスケーリングを示す証拠ではありません。
高度な実装のヒント
- 完全な状態を分割できないものとして扱う:
s_tとC_t^Dの両方を保持します。リカレントベクトルだけを復元しても、記載された遷移は再現できません。 - 応答の境界でリセットしない: プロンプトの再帰とそのデコーダーキャッシュは、応答生成へ直接引き継がれなければなりません。
- ウィンドウを正確に定義する: サイズ
Wのスライディングウィンドウには現在のトークンが含まれるため、次の更新で利用できる過去のエントリはW - 1個だけです。 - 更新後にキャッシュを再構築する: 現行ポリシーのリプレイでは、以前のポリシーからキャッシュした値ではなく、現在の重みで生成したキャッシュが必要です。
- サンプリングとリプレイの順序を揃える: 生成されたアクションを直前の状態から評価し、その後で1回だけ処理します。
- 厳密な勾配と近似を区別する: リカレント状態、デコーダーキャッシュ、またはエンコーダーメモリを切り離すと、勾配経路が変わります。
- 計算量を個別に測定する: パラメータ予算やデータ予算が同じでも、FLOPsが同じとは限りません。特にデコーダー層ではエンコーダーメモリへのクロスアテンションが追加されるためです。
- 数値的な挙動を検証する: 高レベルの実行意味論を共有していても、プレフィル用カーネルとデコード用カーネルの違いが自動的に解消されるわけではありません。
結論
Recurrent Looped Transformerは、グローバルな因果的エンコーダーメモリ、ローカルなデコーダーのスライディングウィンドウアテンション、トークン間のリカレントフィードバックを組み合わせます。その中心的な実装原則は一貫性です。すべてのプロンプトと応答のトークンは、事前学習、ファインチューニング、生成、現行ポリシーのリプレイを通じて、同じ完全な状態遷移に参加しなければなりません。
初期実験は、小規模な状態追跡タスクにおいて有用な系列長の一般化を示唆していますが、学習時の系列長を超えると性能は依然として低下します。したがって、このアーキテクチャは、検証済みの大規模推論システムではなく、研究提案および概念実証として捉えるべきです。