

大学院入試エージェントベンチマークの概要
大学院入試エージェントベンチマークは、大学院入試のアドバイスに用いるエージェント構成を評価します。エージェント構成は、実行システムと言語モデルを組み合わせたもので、出願先の推薦、計画策定、意思決定、新しい学生情報が得られた際のアドバイス更新についてテストされます。
現在、このベンチマークには中国語のタスク70件、ケース23件、回答ステージ83件が含まれています。各タスクには評価基準と参照プログラムがあります。公開データセットはアクセス承認なしで利用できますが、結果の汚染を防ぐため、採点資料は評価対象のエージェントから利用できない状態にしておく必要があります。
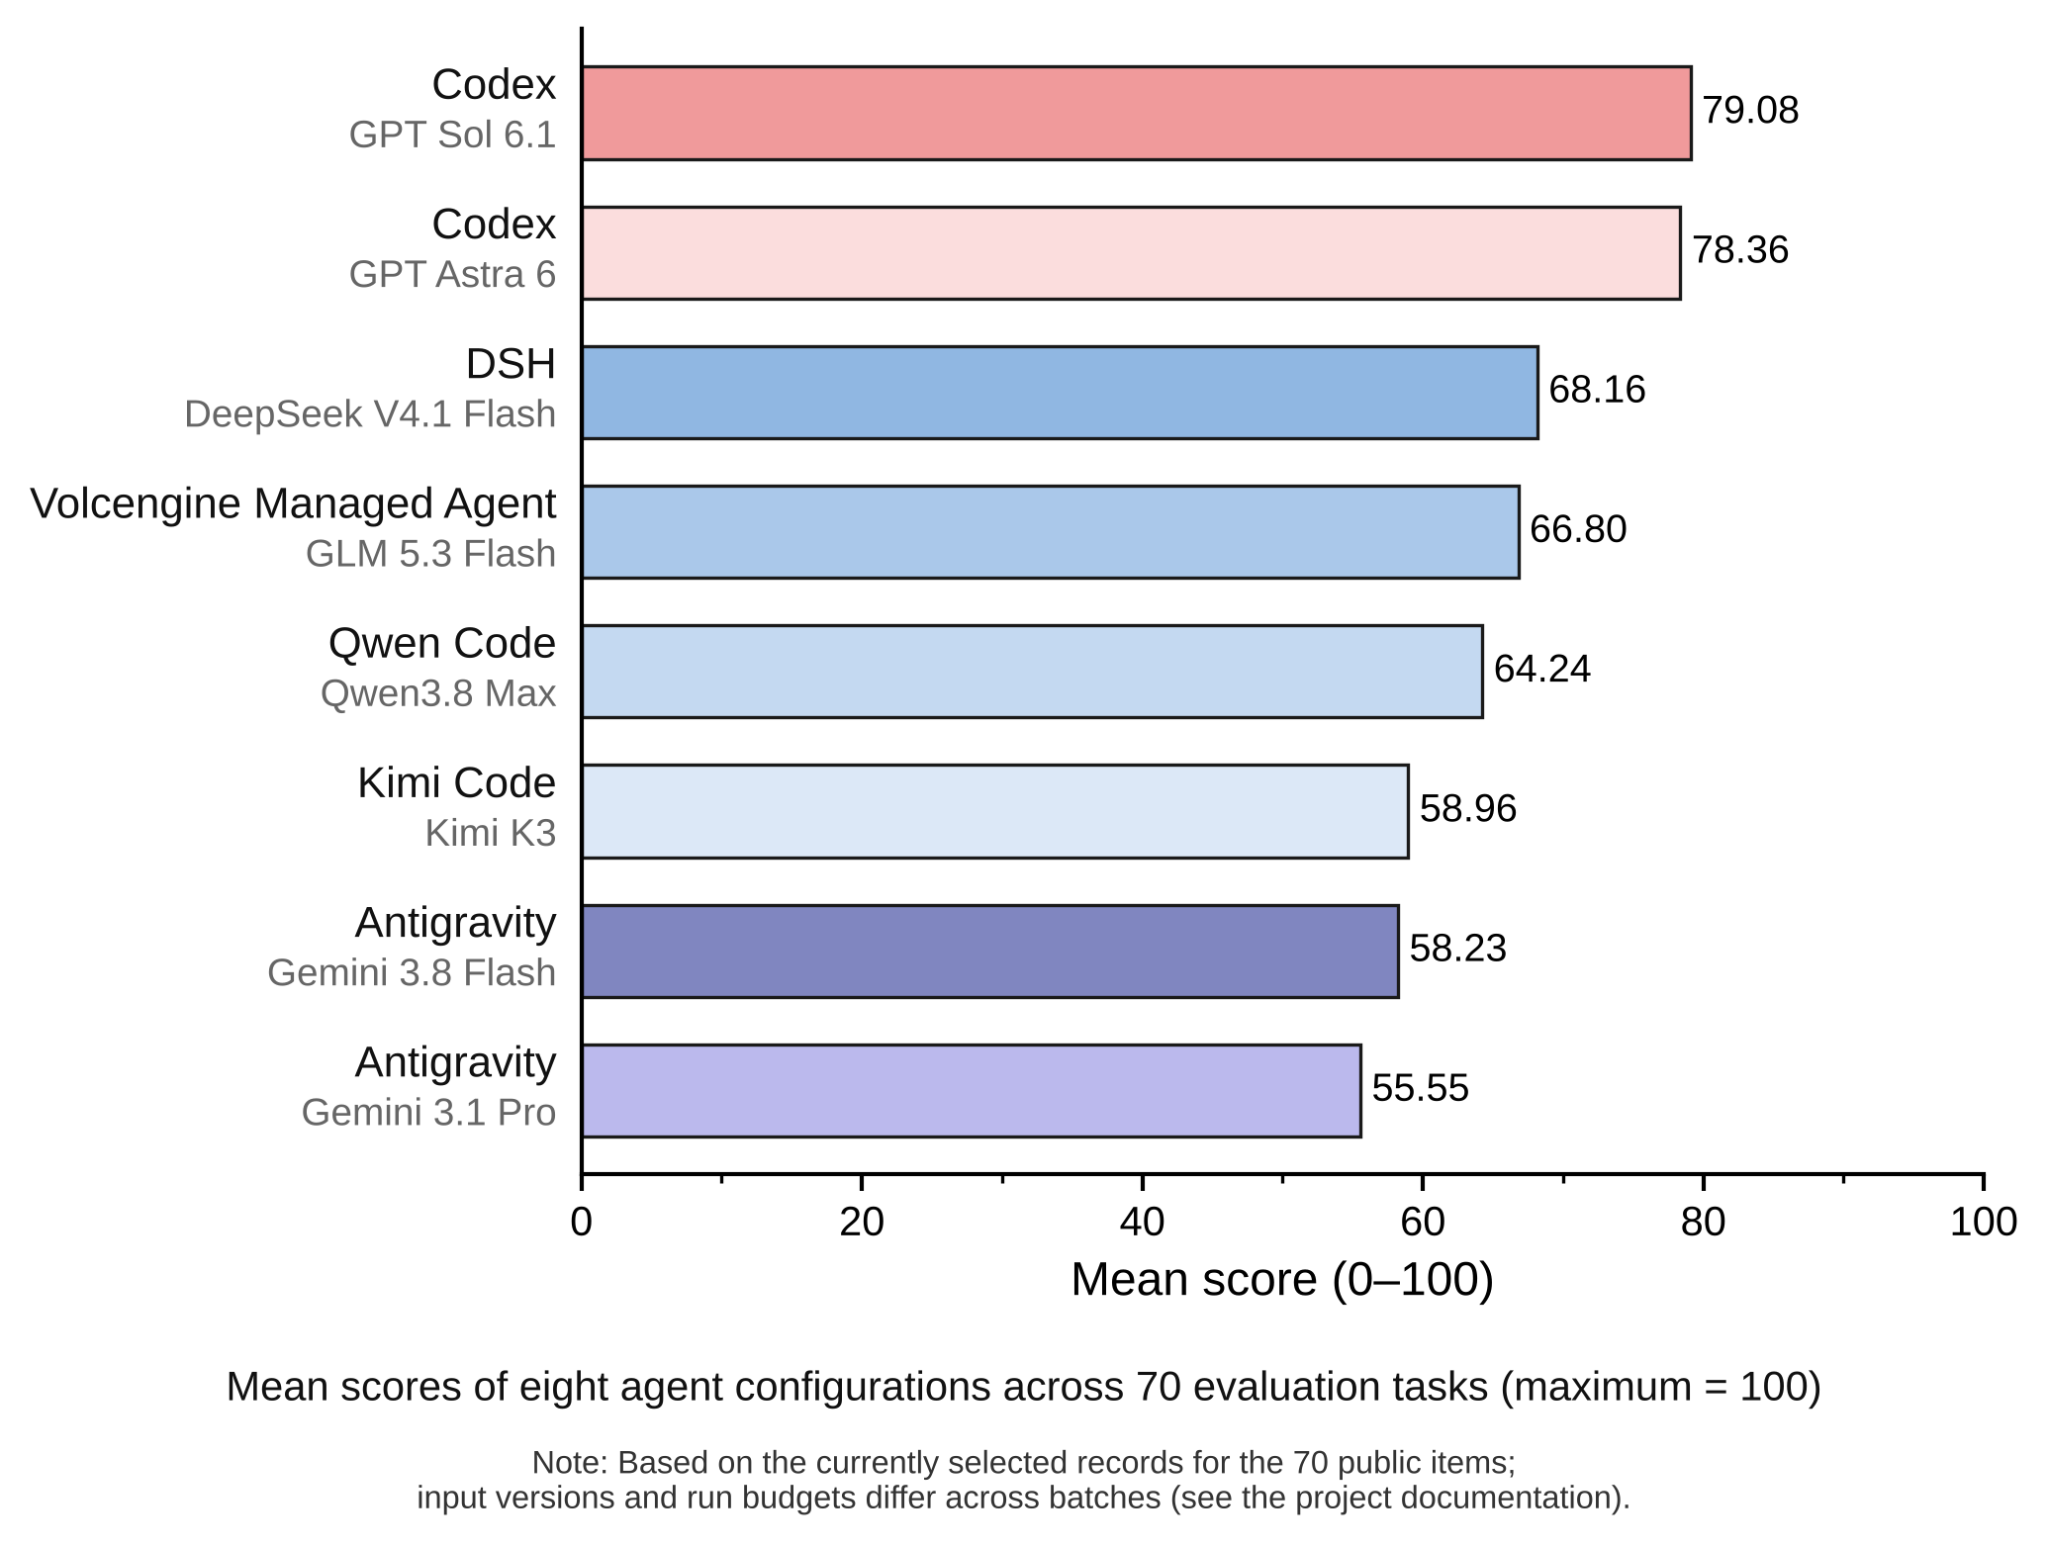
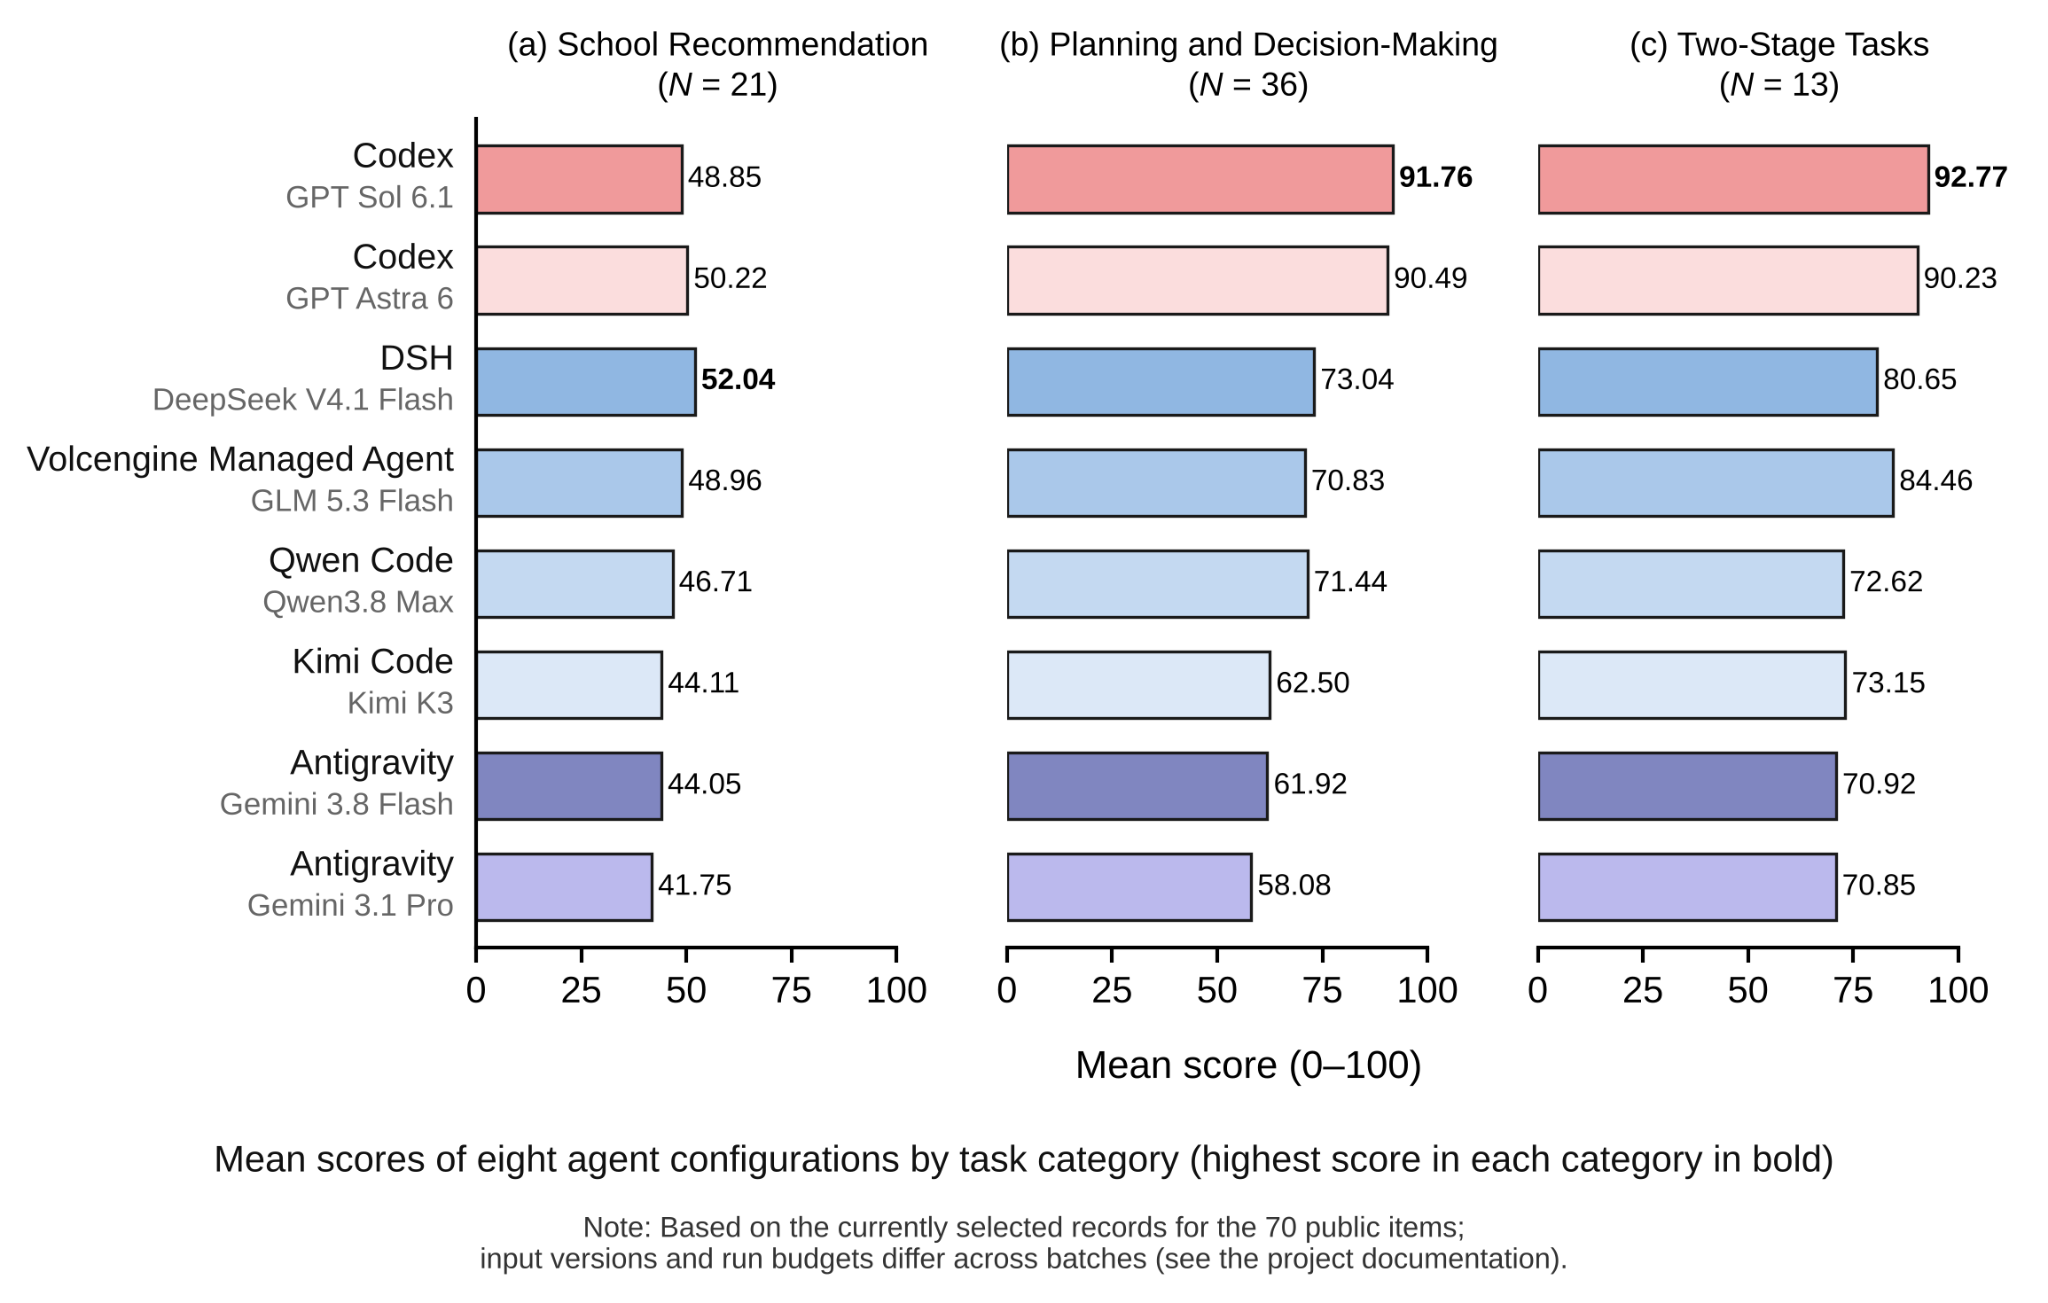
リポジトリでは、8つの構成について評価記録も公開しています。すべての構成が現在の70タスクを完了していますが、プロジェクトの注記によると、実行には異なる入力バージョンと予算が使用されているため、リーダーボードの結果を完全に均一な実験結果として扱うべきではありません。
評価構成を理解する
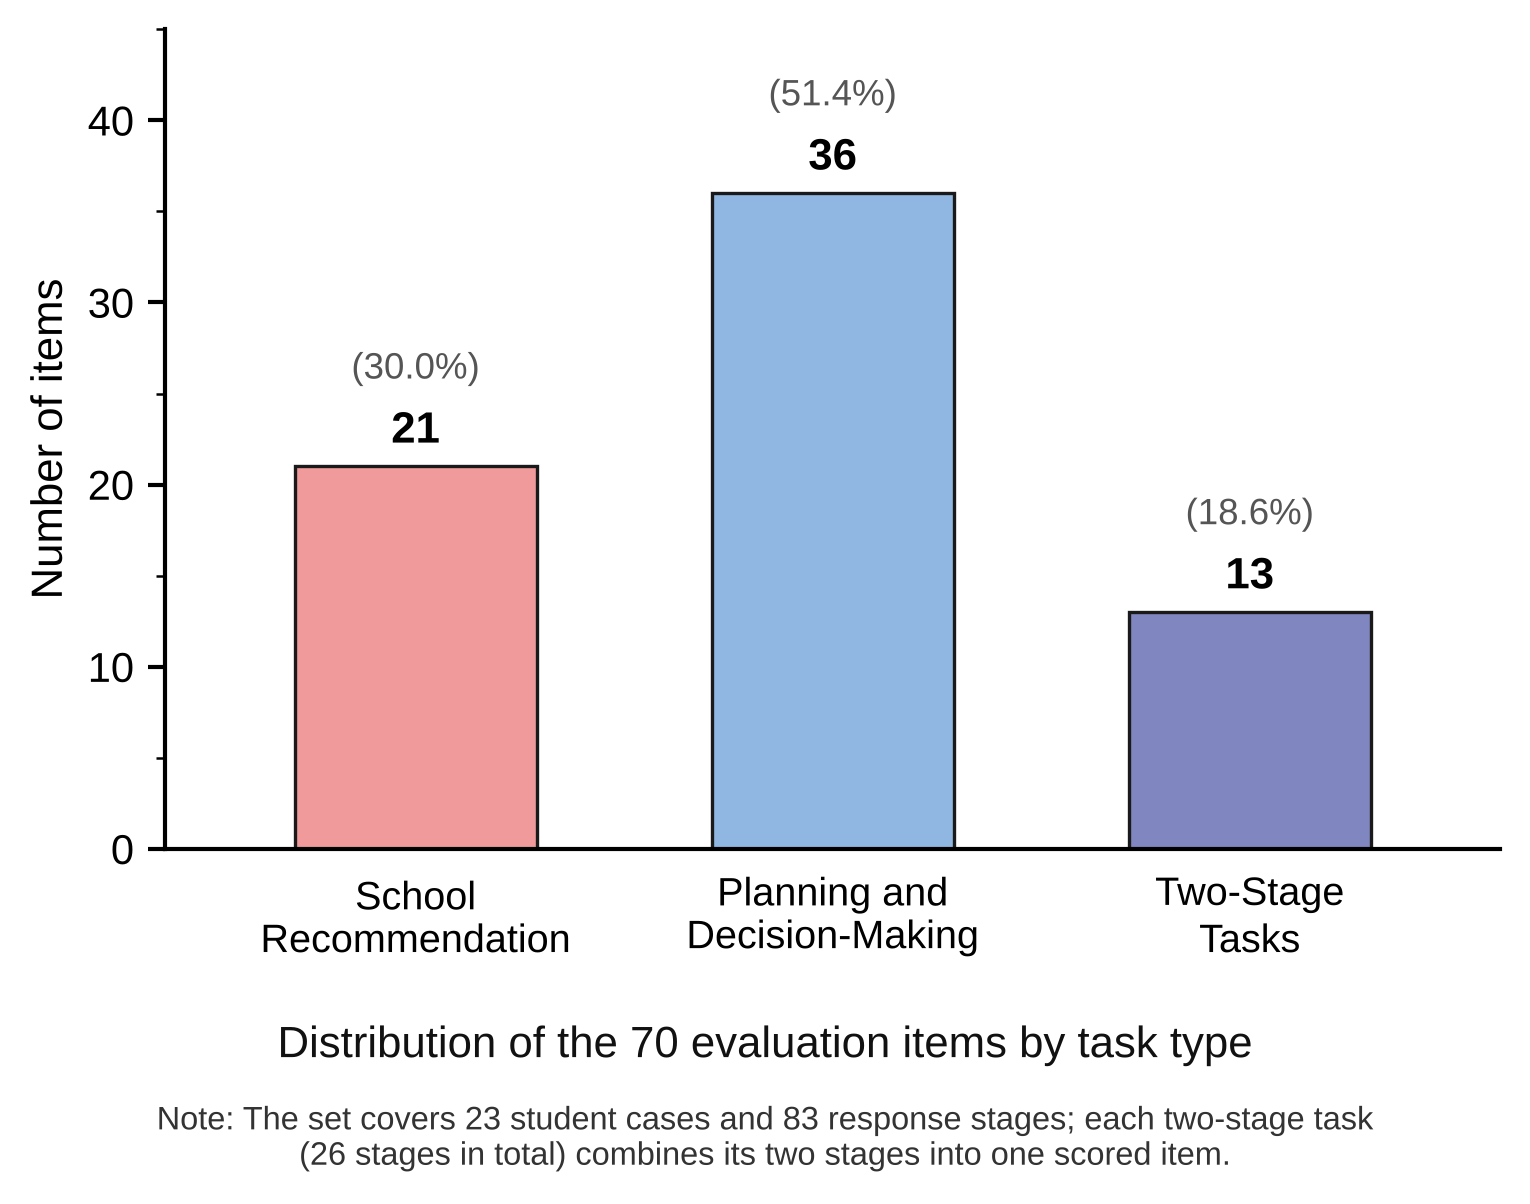
タスクコレクションは、次の3カテゴリに分かれています。
- 推薦タスク21件: 推薦されたプログラムが学生の経歴や制約にどの程度適合しているかを評価します。
- 計画・意思決定タスク36件: 準備計画、リスク評価、実行可能なアドバイスを評価します。
- 2段階タスク13件: 同じセッション内で新しい情報を提示し、エージェントが以前のアドバイスを見直すかどうかをテストします。
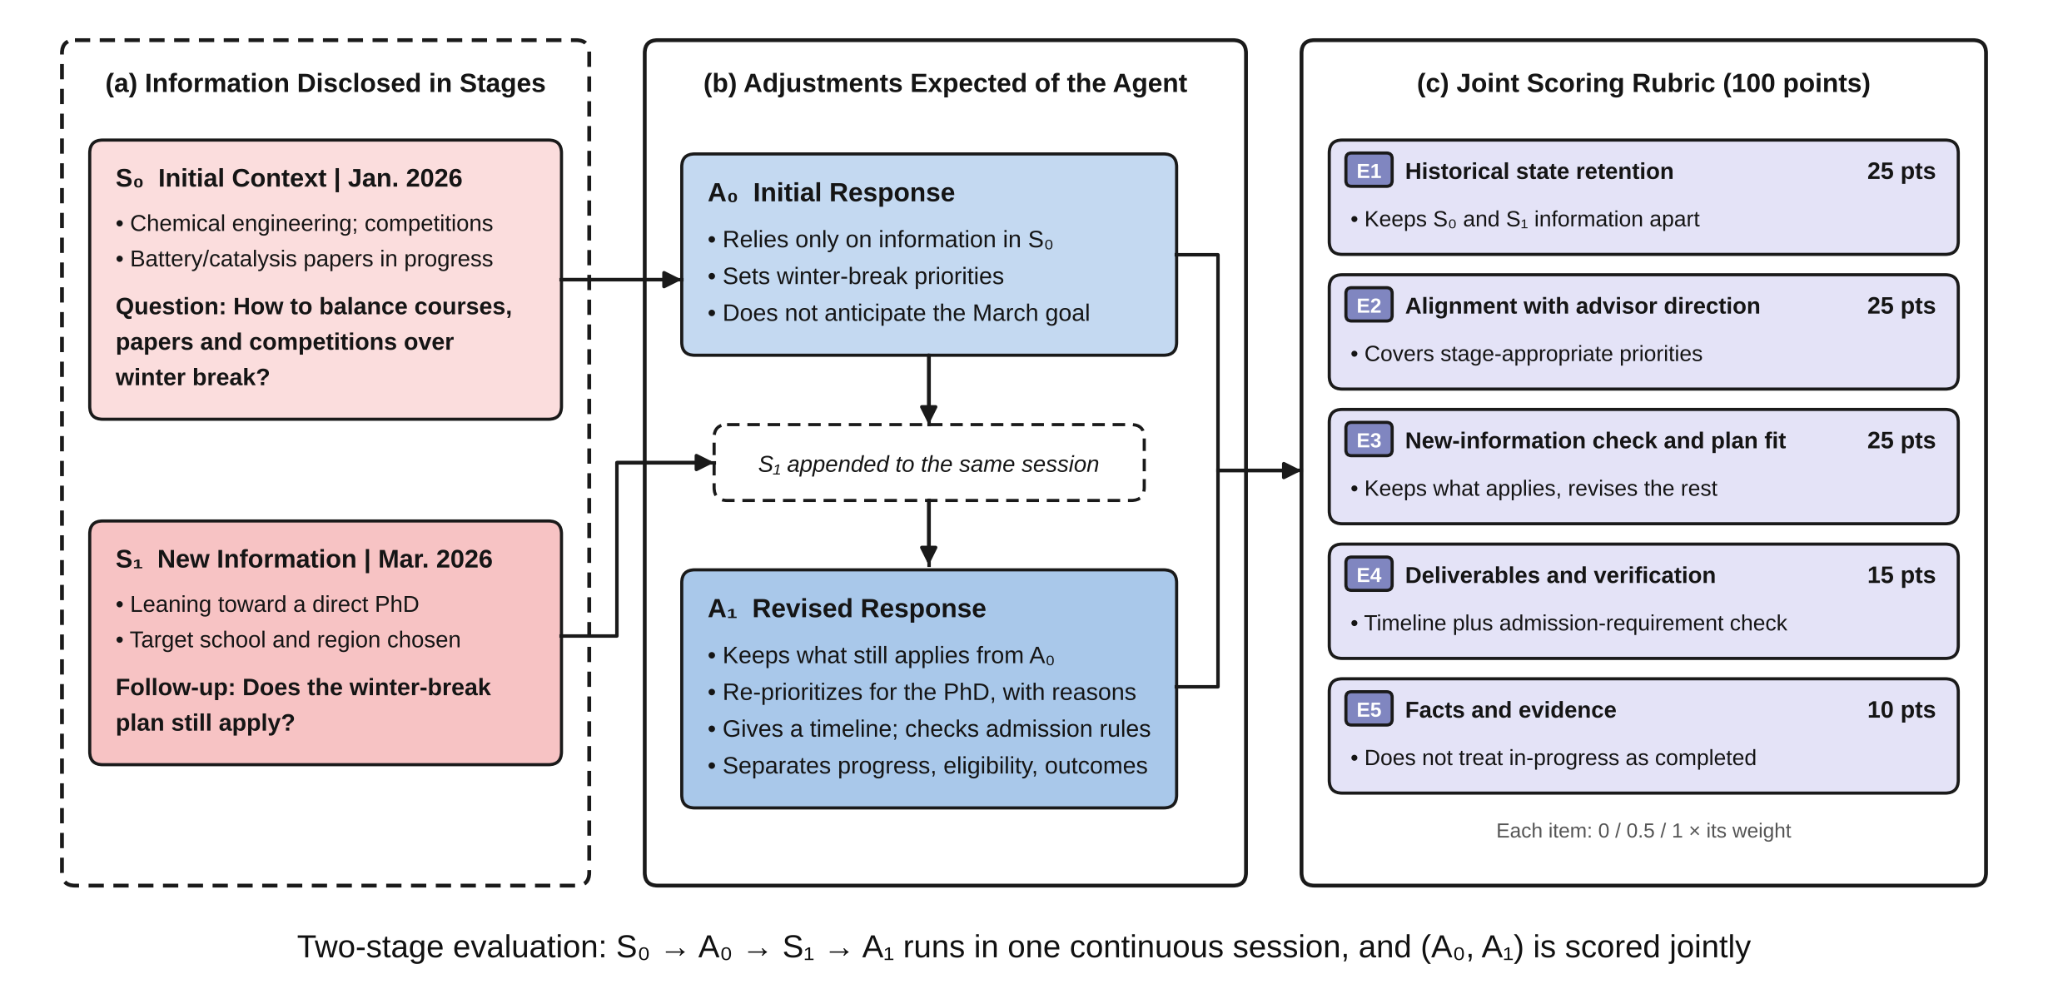
各タスクの配点は100点です。推薦タスクでは、70点を参照プログラムとの適合性、30点を推薦の質に配分します。回答全体は別のレビュアーが採点し、評価基準は回答プロセスの外部に置かれます。
2段階タスクは初期コンテキストS₀から始まり、その後、更新情報S₁が提示されます。エージェントは1つのセッション内で初回回答A₀と改訂回答A₁を生成します。両方の回答を合わせて採点します。公開されているO03-04の例では、学生が方針を変更し、直接博士課程への出願を目指す1月から3月までのシナリオが示されています。
環境を準備する
コマンドはリポジトリのルートから実行します。自動ネイティブ実行にはmacOS SeatbeltとPython 3.10以降が必要です。Kimiのサブスクリプション構成にはPython 3.11以降が必要です。
このフレームワークはPythonの標準ライブラリのみを使用するため、リポジトリでpip installを実行する必要はありません。ただし、実行する構成に対応する公式クライアントをインストールし、サブスクリプションへのログインまたはAPIキーを準備する必要があります。
利用可能なクライアントには、Codex、Claude Code、Antigravity、DeepSeek Harness、Qwen Code、Kimi Codeがあります。認証方法はクライアントによって異なります。サブスクリプションまたはOAuthを使用する構成がある一方、DeepSeekとQwenはプロジェクトのドキュメントに記載されたAPIベースの認証を使用します。
エージェント構成を選択する
エージェントIDは、リポジトリの現在のレジストリconfig/agents-cli.example.jsonに記載されています。これらのIDはベンチマーク構成の識別子であり、モデルに直接渡す引数ではありません。
gpt-6-astraはGPT Astra 6を使用するCodex向けgpt-6-1-solはGPT Sol 6.1を使用するCodex向けclaude-opus-5-5はClaude Opusを使用するClaude Code向けclaude-sonnet-5-5はClaude Sonnetを使用するClaude Code向けantigravity-gemini-3-8-flash-highはGemini Flashを使用するAntigravity向けdeepseek-v4-1-flashはDeepSeek Flashを使用するDeepSeek Harness向けqwen3-8-max-0902はQwen Maxを使用するQwen Code向けkimi-k3はKimi K3を使用するKimi Code向け
クイックスタートのワークフローを実行する
ベンチマークでは、すべての構成で同じワークフローを使用します。まず、エージェントIDをAGENTシェル変数に割り当てます。
AGENT=gpt-6-1-sol次に、ローカル構成を保存します。
python3 -m benchmark setup --agent "$AGENT"
選択したクライアントと認証の準備ができているか確認します。
python3 -m benchmark cli-check --agent "$AGENT"チェック結果がready_for_trialになったら、現在のタスク選択を使ってバッチを実行します。
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
--agent "$AGENT" --out "./runs/current-$AGENT"デフォルトでは、バッチ実行はモデル呼び出しを行わず、70タスクと83ステージをプレビューします。アカウントの利用枠を使用する準備ができたら、--executeを追加します。
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT" \
--executecli-checkが成功したら、まず1つの試行タスクから始めます。これにより、完全なバッチを開始する前に、クライアント、認証方式、サンドボックス、出力先が正しく機能することを確認できます。
複数の構成を実行する
各クライアントを個別に設定して確認してから、バッチコマンドに複数の --agent オプションを渡します。異なる設定の結果が互いに上書きされないよう、新しい出力ディレクトリを使用してください。
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent gpt-6-1-sol \
  --agent claude-opus-5-5 \
  --out "./runs/comparison" \
  --execute
各設定の認証方式は、レジストリに記載されたクライアントと一致させてください。サブスクリプションベースの設定では、対応するサブスクリプションログインを使用し、API設定では必要なAPI認証情報を使用します。
タスクと結果を確認する
タスクインデックスは config/selections/current.json で確認できます。質問、評価基準、採点定義については、質問と採点、データ形式ガイド、採点ルールを参照してください。
公開された結果は、複数の形式で利用できます。
- 集計結果についてはスコア概要。
- タスクレベルの詳細な記録についてはタスク別結果。
- 公開された回答文と評価情報については設定別の回答とスコア。
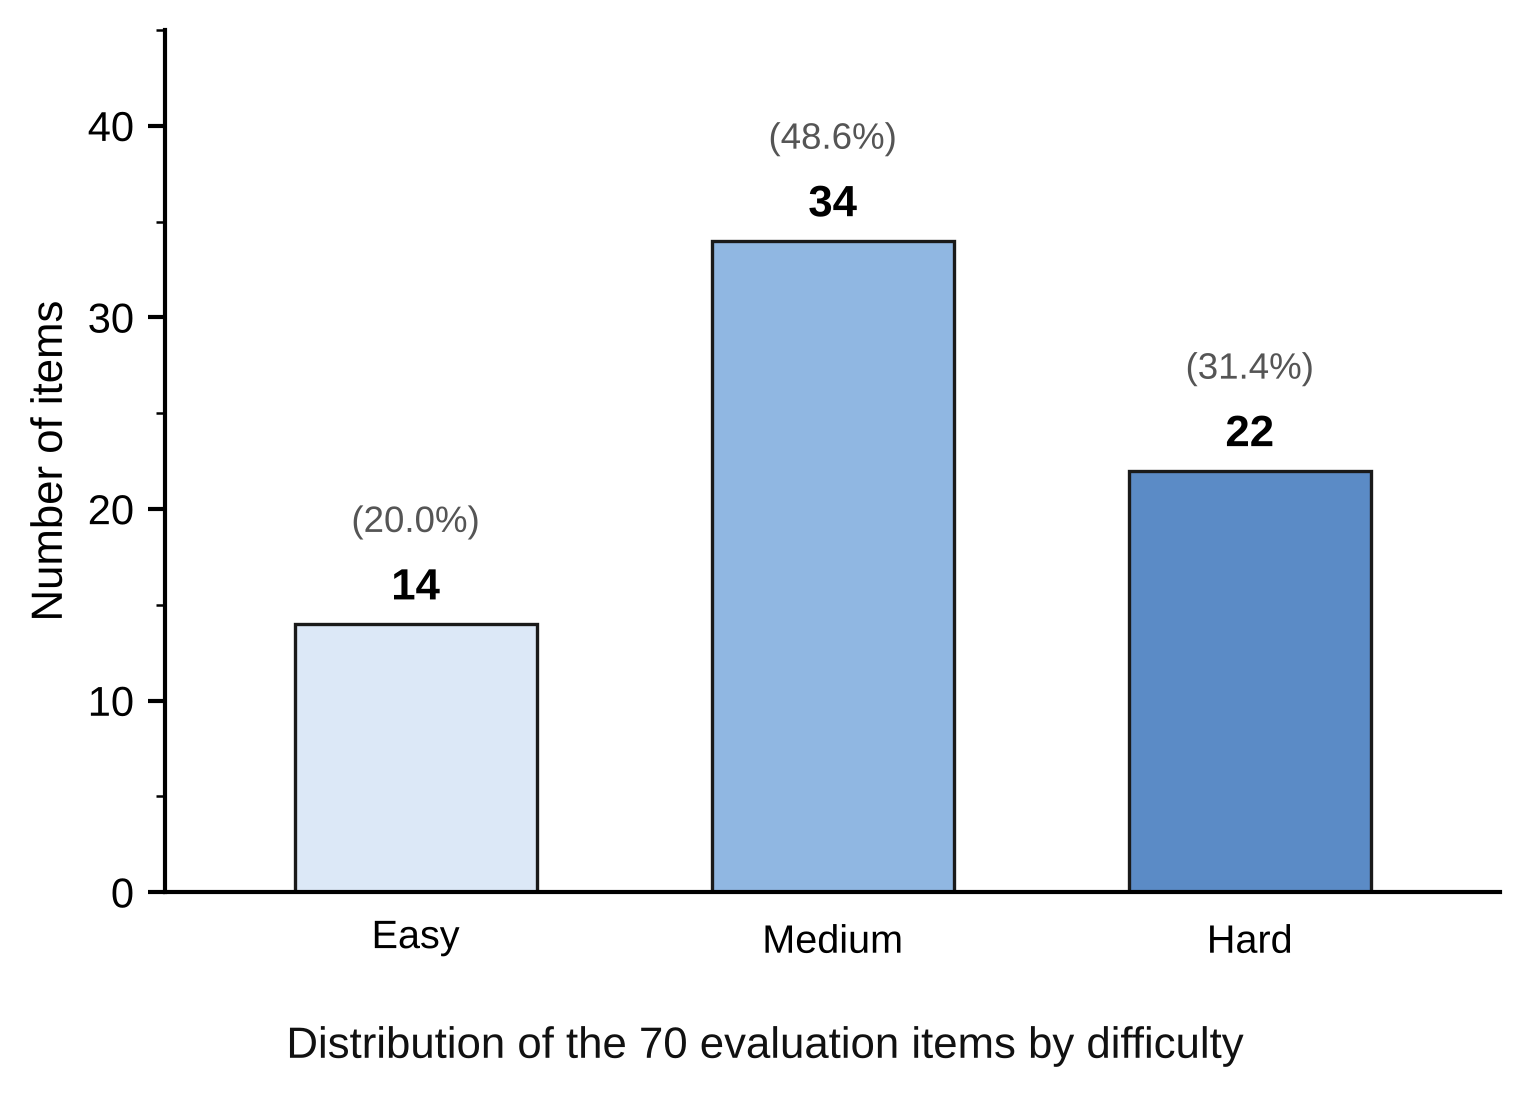
公開リーダーボードでは、評価対象となった8つの設定について、平均スコアと完了率を報告しています。また、リポジトリには現在のタスクの難易度ラベルとして、易しいもの14件、中程度のもの34件、難しいもの22件が記録されています。これらのラベルは教師によるキャリブレーションを通じて所有者が確認したものであり、独立した二重レビューの結果として提示されているものではありません。
採点とレビューのヒント
採点では、エクスポートした資料を確認するために、別のCodexサブスクリプションセッションを使用する場合があります。APIによる任意の判定には、追加設定が必要です。評価対象のエージェントに評価基準や参照プログラムを公開すると比較が無効になる可能性があるため、回答プロセスと採点用資料は分離してください。
自身の実行結果を比較する際は、エージェントID、クライアントバージョン、入力バージョン、実行予算、出力ディレクトリ、関連するコンテンツハッシュを記録してください。プロジェクトでは、公開リーダーボードの実行結果がすべて同一の実行条件を共有しているわけではないと警告しています。そのため、方法論と実行記録も併せて結果を比較してください。
再現可能な実験を行うには、固定された入力、提出物、スコア検証を扱う再現ガイドに従ってください。方法論ドキュメントでは評価設定と制限事項を説明し、ネイティブCLIガイドではインストール、認証、複数ステージについて詳しく説明しています。
結論
Graduate Admissions Agent Benchmarkは、入試エージェントが正確な推薦、有用な計画案内、そして学生の状況が変化した際の適切な更新を提供できるかを検証するための体系的な方法を提供します。対応クライアントを設定し、レジストリからエージェントIDを選択し、cli-checkで検証してから、バッチをプレビューし、試行または完全な評価を実行してください。公開されているタスク定義、結果、方法論ドキュメントを使用して、スコアを適切に解釈し、比較を再現してください。