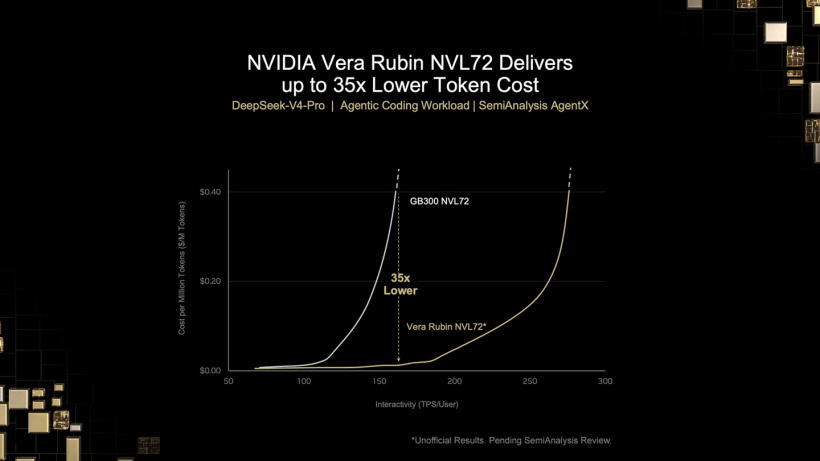
엔비디아는 어제 SemiAnalysis AgentX 워크로드와 DeepSeek-v4-PRO 1.6T 모델을 사용해 평가 테스트를 진행했으며, Vera Rubin의 메가와트당 처리량이 Blackwell의 30배에 달하는 것으로 나타났다.
메가와트당 처리량(Tokens per Megawatt, 약칭 tokens / MW)은 AI 데이터센터가 정해진 전력 한도에서 얼마나 많은 AI 토큰을 생성할 수 있는지를 측정하는 핵심 전력 효율 지표다.
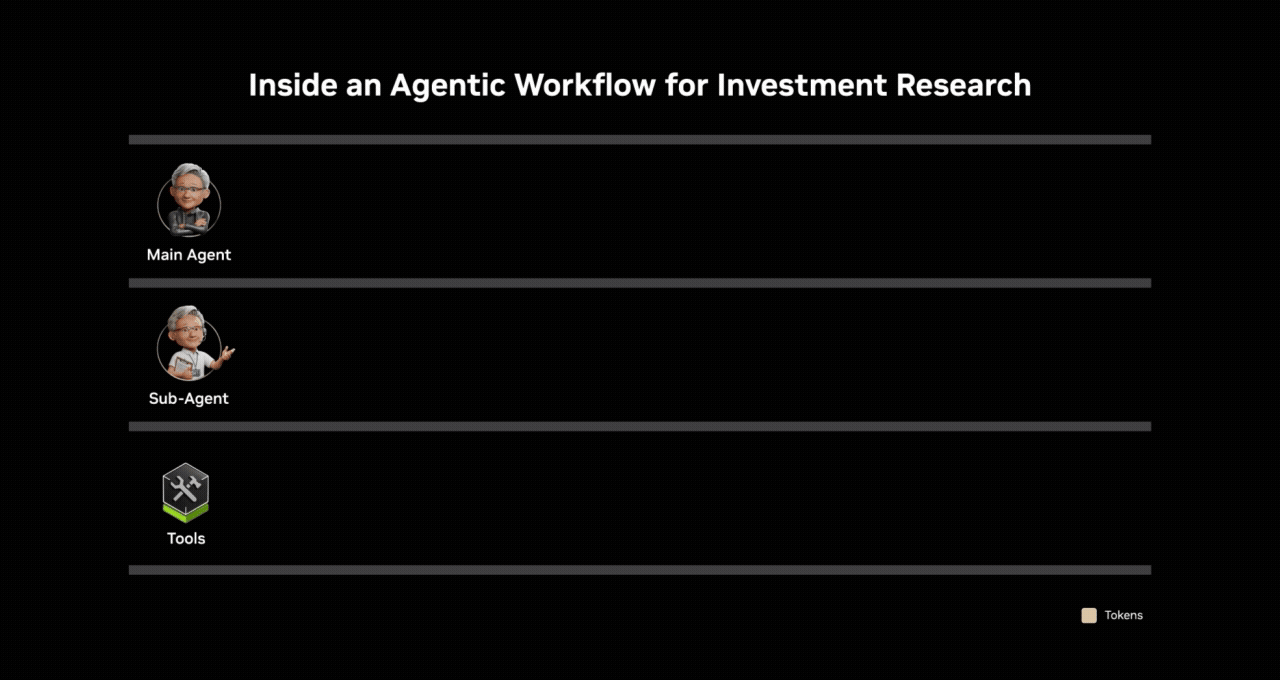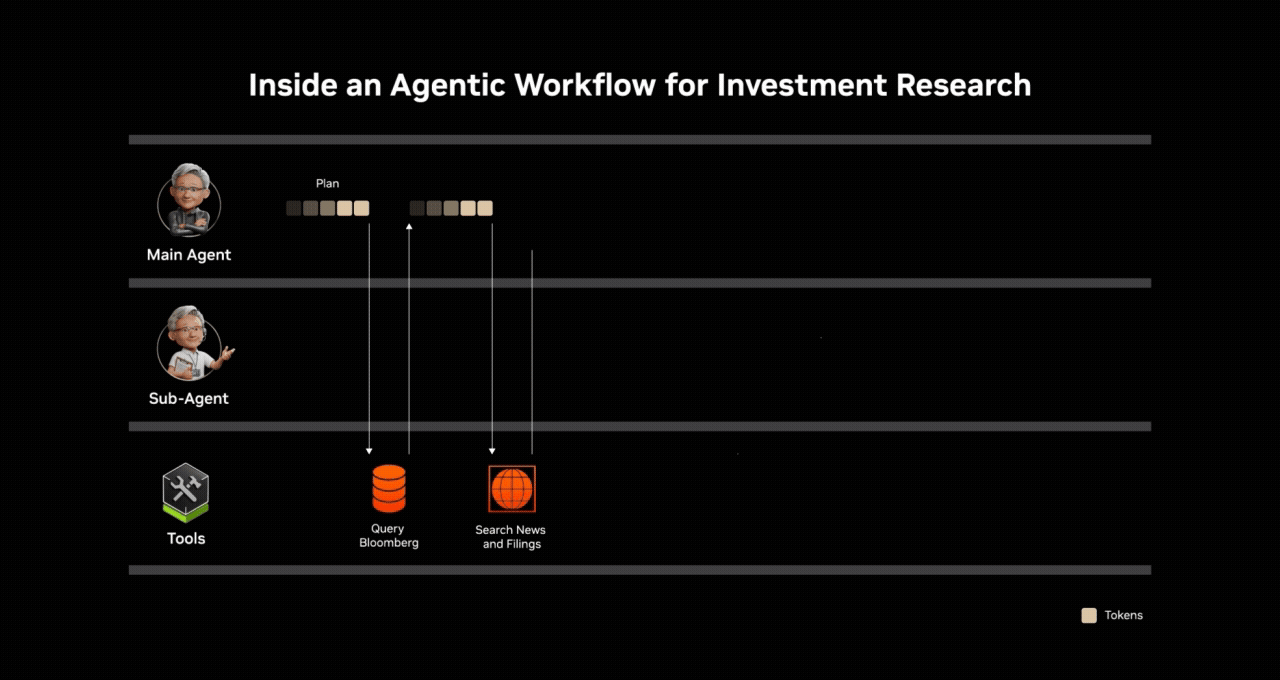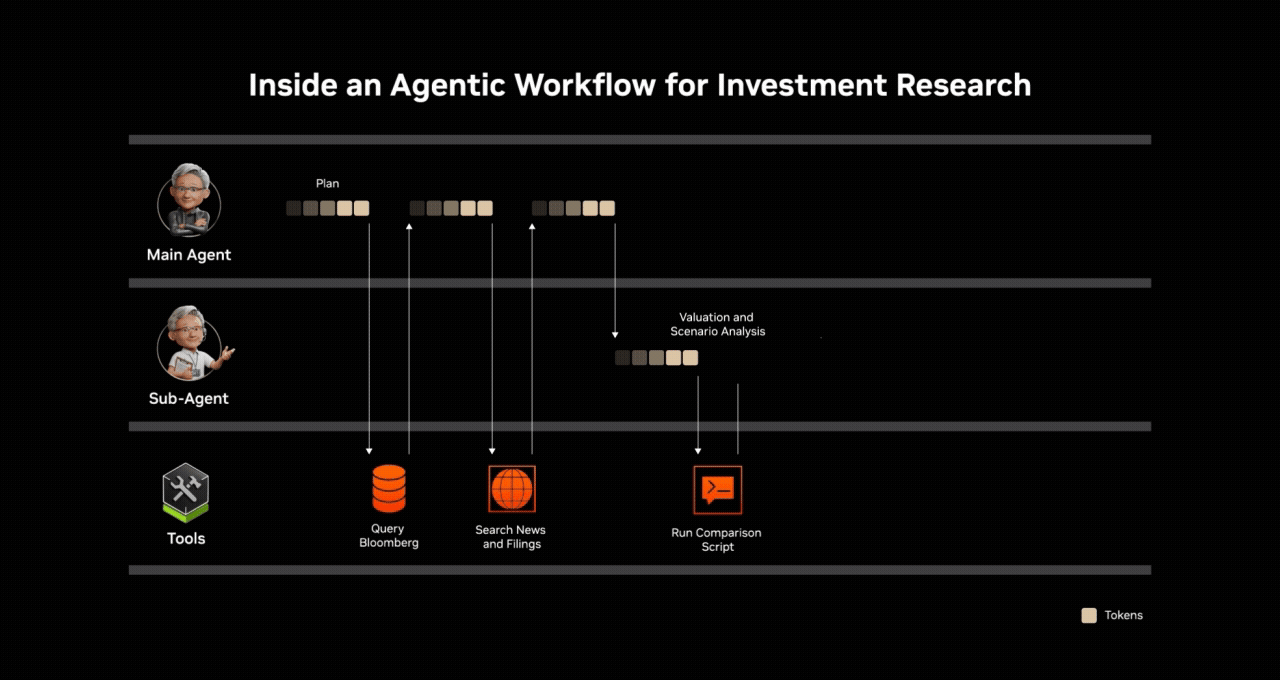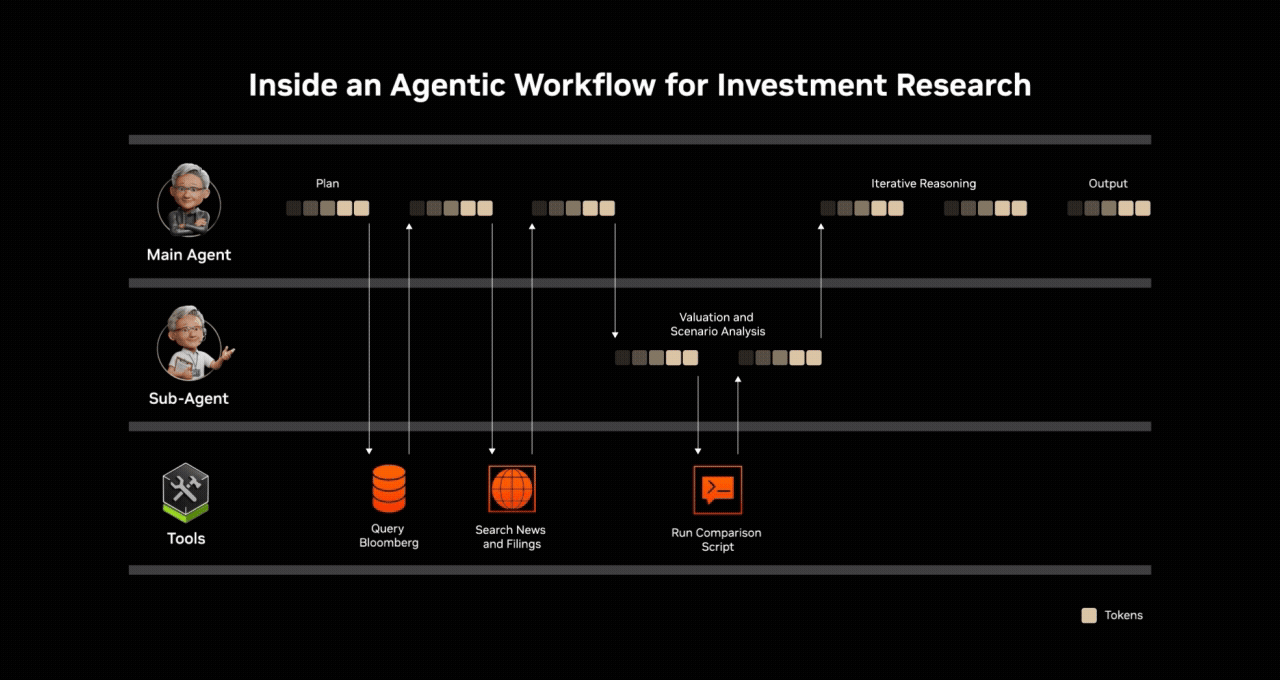
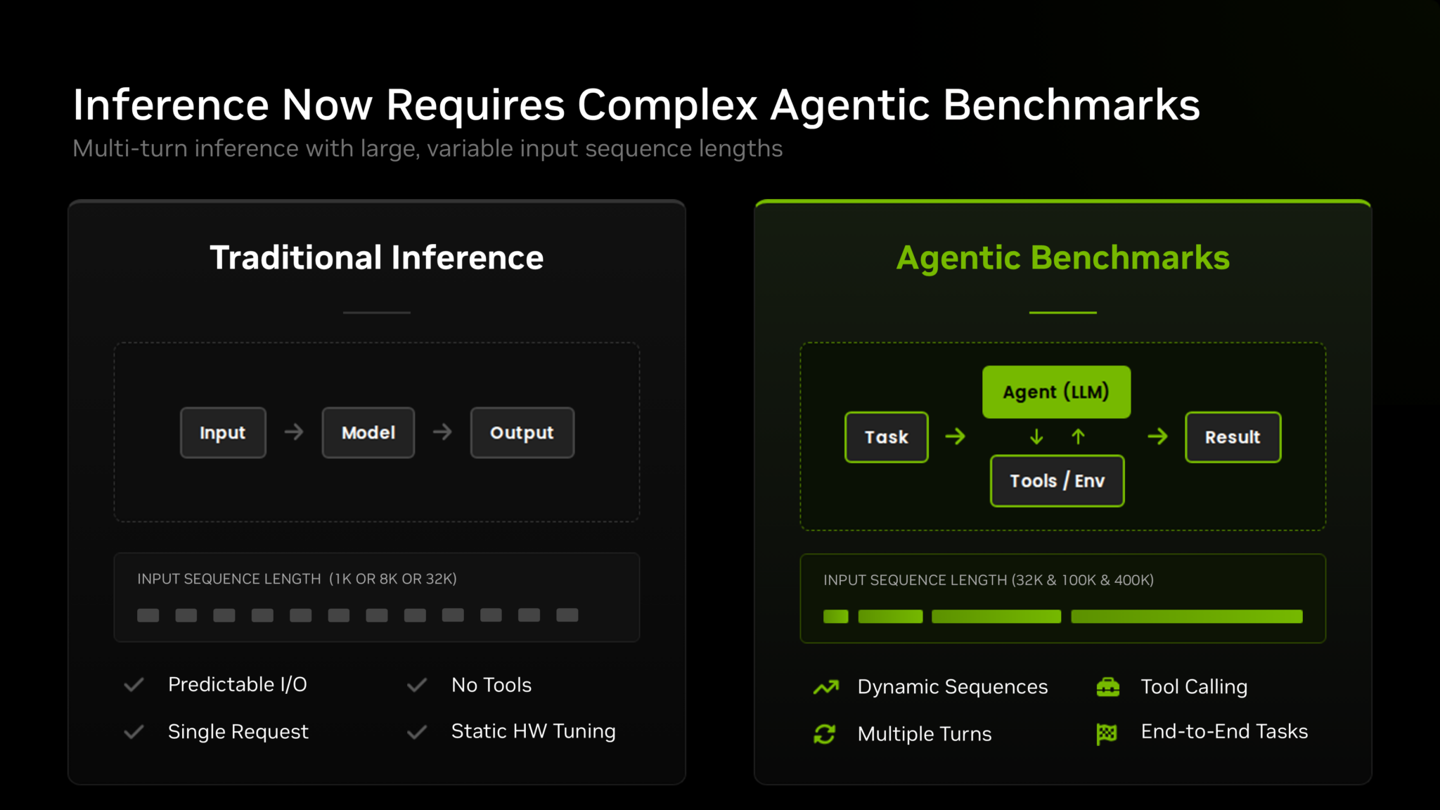
IT之家가 블로그 게시물을 인용해 소개한 내용에 따르면, SemiAnalysis AgentX는 4개 지표를 통해 에이전트 프로그래밍 추론 워크로드를 중점적으로 평가했다.
엔드투엔드 정규화 상호작용성은 요청 제출부터 최종 토큰 도착까지의 전체 시간을 기준으로 계산하며, 첫 번째 토큰 대기 시간을 포함한 사용자가 체감하는 출력 효율을 반영한다.
표준 상호작용성은 첫 번째 토큰부터 마지막 토큰까지의 생성 단계만 집계한다.
엔드투엔드 지연 시간은 단일 요청의 제출부터 최종 출력 토큰 도착까지 걸린 총 시간을 집계한다.
첫 번째 토큰 지연 시간(TTFT)은 요청 제출부터 첫 번째 출력 토큰 도착까지의 시간을 집계한다.
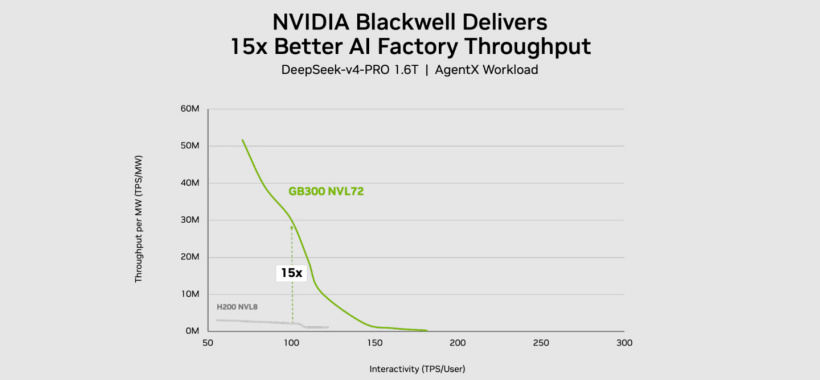
DeepSeek-v4-PRO 1.6T 워크로드에서 GB300 NVL72를 사용하는 Grace Blackwell 서버의 메가와트당 처리량은 H200 NVL8 Hopper 솔루션의 15배에 달했다.
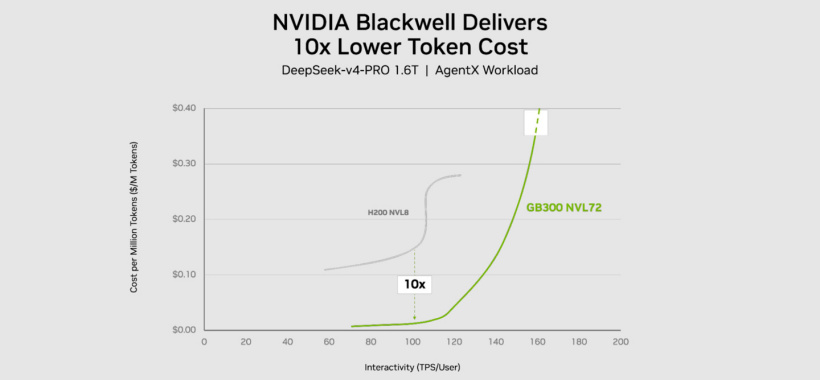
Blackwell의 토큰 100만 개당 비용은 이전 세대의 약 10분의 1이다. 운영자는 동일한 전력과 인프라 예산으로 더 많은 에이전트를 지원하거나, 더 낮은 운영 비용으로 동일한 에이전트 용량을 유지할 수 있다.
Vera Rubin은 이러한 우위를 한층 더 높인다. DeepSeek V4 Pro 모델에서 Vera Rubin NVL72의 메가와트당 처리량은 GB300 NVL72의 약 30배다.
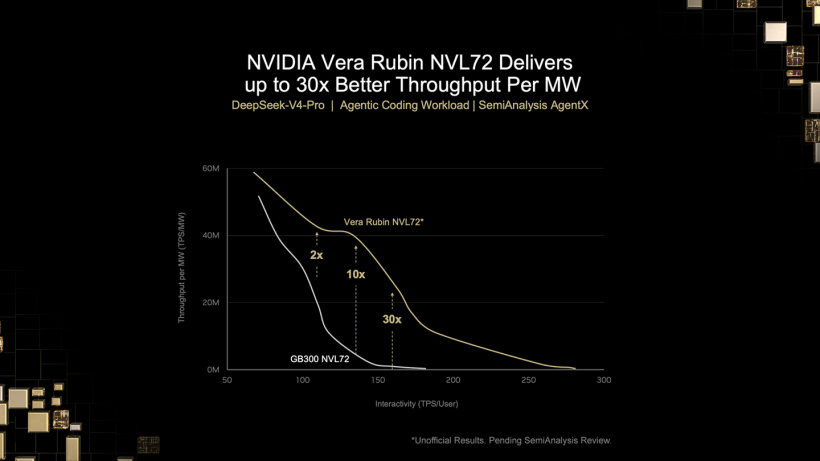
Vera Rubin NVL72의 토큰 100만 개당 비용은 GB300 NVL72의 35분의 1이다. 이를 통해 에이전트를 지속적이고 대규모로 실행하며 고객의 다양한 워크로드 요구를 충족할 수 있다.