

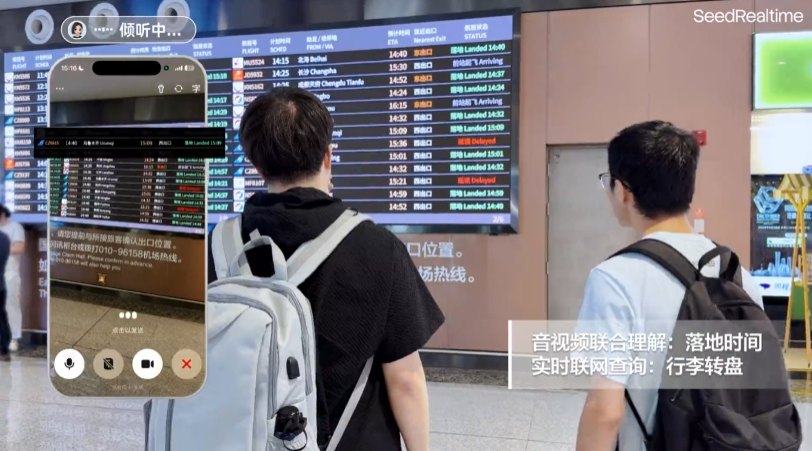
바이트댄스는 오늘 네이티브 음성·영상 전이중 대규모 모델 SeedRealtime을 출시하고, 전 모달리티 자연어 상호작용을 향한 행보를 시작한다고 발표했습니다.
SeedRealtime은 통합 아키텍처로 오디오, 비디오, 텍스트를 네이티브 융합하고, 연속적인 멀티모달 정보 흐름에서 실시간으로 상호작용해 ‘보면서 듣고 말하는’ 새로운 경험을 제공합니다. 다음 세 가지 핵심 기술 혁신을 구현했습니다.
음성·영상 공동 이해: 소리, 화면, 시간 정보를 네이티브 방식으로 심층 융합합니다. 모델은 장면 정보를 활용해 동음이의어의 모호성을 해소할 수 있으며, 시각 정보 속 시간적 지시도 정확하게 이해해 보고 듣고 말하는 내용을 하나로 통합합니다.
능동적인 상호작용 능력: 지속적인 환경 인식과 능동적인 표현 능력을 갖췄습니다. 화면 상태의 변화, 예를 들어 주요 대상의 등장을 감지하면 능동적으로 알리고, 도구를 호출해 표현에 활용할 수도 있어 상호작용을 수동적인 응답에서 능동적인 협업으로 발전시킵니다.
자연스러운 상호작용 리듬: 사용자의 대화 상태와 소통 리듬을 실시간으로 파악해 적절한 순간에 자연스럽게 말을 이어가고, 멈추고, 응답할 수 있습니다. 또한 강력한 간섭 저항 능력을 갖춰 주변 사람의 잡담과 배경 소음을 구분하고, 간섭으로 잘못 활성화되지 않아 원활하고 일관된 소통을 유지합니다.
엔드투엔드 인체 평가 결과, 캐스케이드 모델과 비교해 SeedRealtime의 음성·영상 대화 리듬 관련 문제가 절반으로 줄었습니다. 모델이 말할 타이밍을 더욱 자연스럽게 판단하면서 ‘말이 끝나기 전에 말을 끊는 현상, 말이 끝났는데도 응답이 늦어지는 현상, 배경 소음이나 잡담에 잘못 활성화되는 현상’ 등 대화가 끊기는 문제가 크게 감소했습니다. 또한 한 번의 대화를 완전하고 원활하게 이어갈 수 있는 확률도 뚜렷하게 향상되었습니다.
현재 SeedRealtime은 더우바오 앱에 전면上线되어 업계 최초로 음성·영상 전이중 기술의 대규모 상용화를 실현했습니다. 더우바오 앱을 최신 버전으로 업데이트한 뒤 대화창에서 ‘전화하기’를 선택하고 영상 통화 화면으로 들어가体验할 수 있습니다.
프로젝트 홈페이지:
https://seed.bytedance.com/seedrealtime