

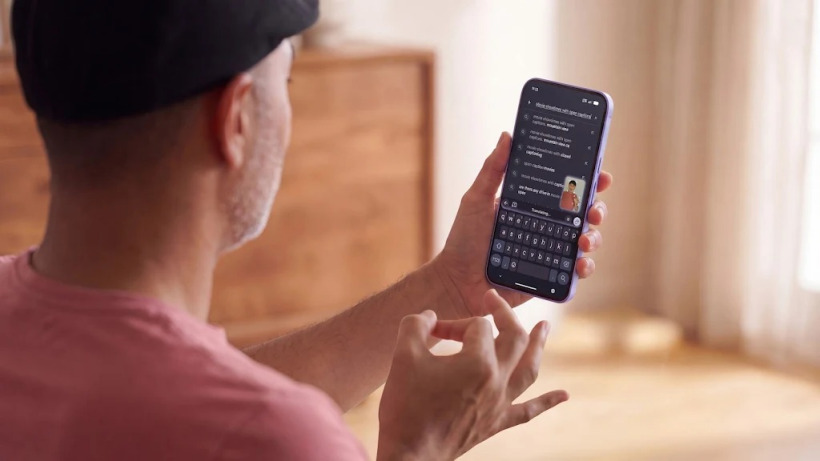
Google 산하 인공지능 연구소는 현지 시간 12일 대규모 다국어 수어-텍스트(SL2T) 번역 모델을 출시한다고 발표했다.
이 모델 덕분에 수어 인공지능이 최초로 소비자 제품에 도입됐다. Google Pixel 11 시리즈 스마트폰의 Gboard와 Live Transcribe 애플리케이션은 수어-텍스트 입력 기능을 지원한다(초기에는 미국 수어만 지원하며, 이후 더 많은 수어와 기기로 확대될 예정이다).
전 세계 약 7,000만 명의 청각장애인이 200여 종의 수어를 사용한다. 새로운 기능을 통해 이들은 음성 입력과 유사한 유연한 ‘타이핑 대체’ 경험을 누릴 수 있다. 테스트 결과, 미국 수어를 사용하는 것이 영어로 타이핑하는 것보다 빠르고 자연스러우며 만족도도 높은 것으로 나타났다.
DeepMind는 수어가 고유한 문법과 어휘를 갖춘 독립적인 자연어라고 설명했다. 따라서 수어 번역에는 수어를 순서대로 문자로 바꾸는 방식이 아니라 진정한 기계 번역이 필요하다. SL2T 작업을 수행하려면 모델이 수어 사용자의 신체 여러 부위가 동시에 움직이는 동작을 ‘이해’할 수 있어야 하며, 이를 위해서는 강력한 컴퓨터 비전 처리 능력이 필요하다.
Google DeepMind의 SL2T 모델은 50종이 넘는 수어의 10만 시간 분량 데이터를 사용해 학습됐다. 이 모델은 수어를 일련의 자세 특징점 위치 정보로 변환해 사용자의 개인정보를 보호하며, 원본 영상 스트림을 서버로 전송할 필요가 없다. 또한 기존에 널리 사용되던 ‘중간 주석’을 버리고 공간 정보를 직접 해석한다.