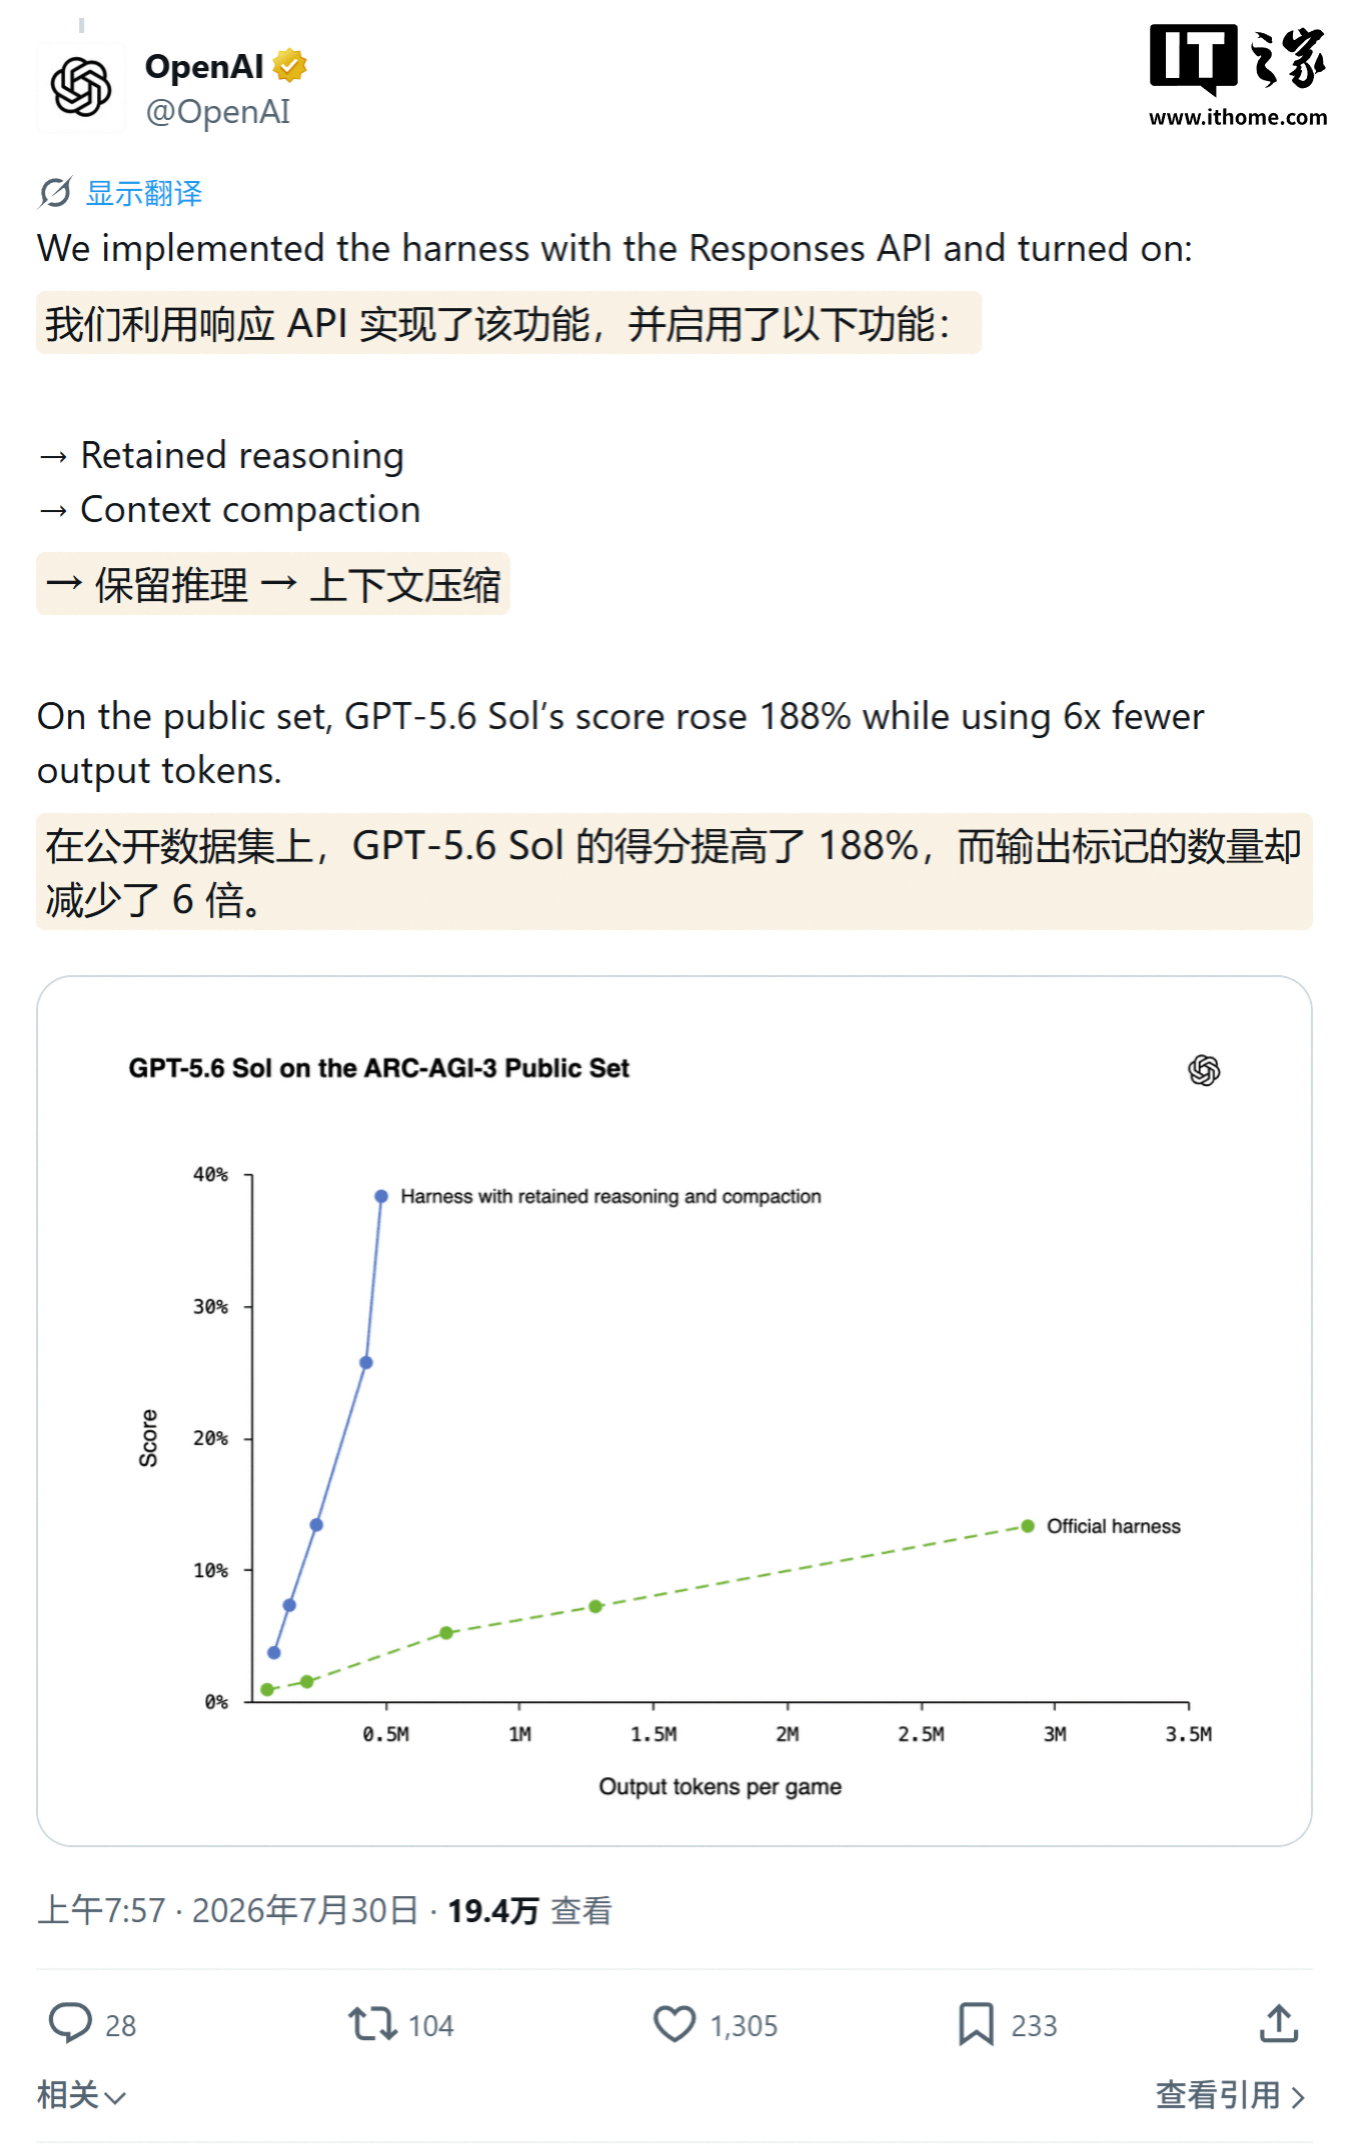
OpenAI는 오늘(7월 31일) 발표를 통해 프레임워크를 개선해 GPT-5.6 Sol 모델의 ARC-AGI-3 점수를 188% 높였다고 밝혔다.
참고: ARC-AGI-3는 ARC Prize 팀이 선보인 새로운 상호작용형 추론 벤치마크 테스트로, 현재 전 세계적으로 AI 일반지능(AGI)을 평가하는 가장 엄격하고 수준 높은 상호작용형 추론 평가 기준으로 인정받고 있다.
이 벤치마크는 전통적인 AI의 정적인 ‘문제 풀이’ 및 지식 질의응답 테스트 방식을 완전히 탈피해, AI를 전혀 낯선 ‘게임 환경’에 직접 투입하고 인간처럼 실시간으로 탐색·학습·적응할 수 있는지를 평가한다.
최적화 전 GPT-5.6 Sol의 ARC-AGI-3 벤치마크 테스트 점수는 7.8%였으며, GPT-5.5 모델의 점수는 0.4%에 불과했다.
OpenAI는 검토 과정에서 GPT-5.6 시리즈 모델의 공식 프레임워크에 GPT-5.6 Sol의 성능에 영향을 미치는 두 가지 메커니즘이 있음을 발견했다.
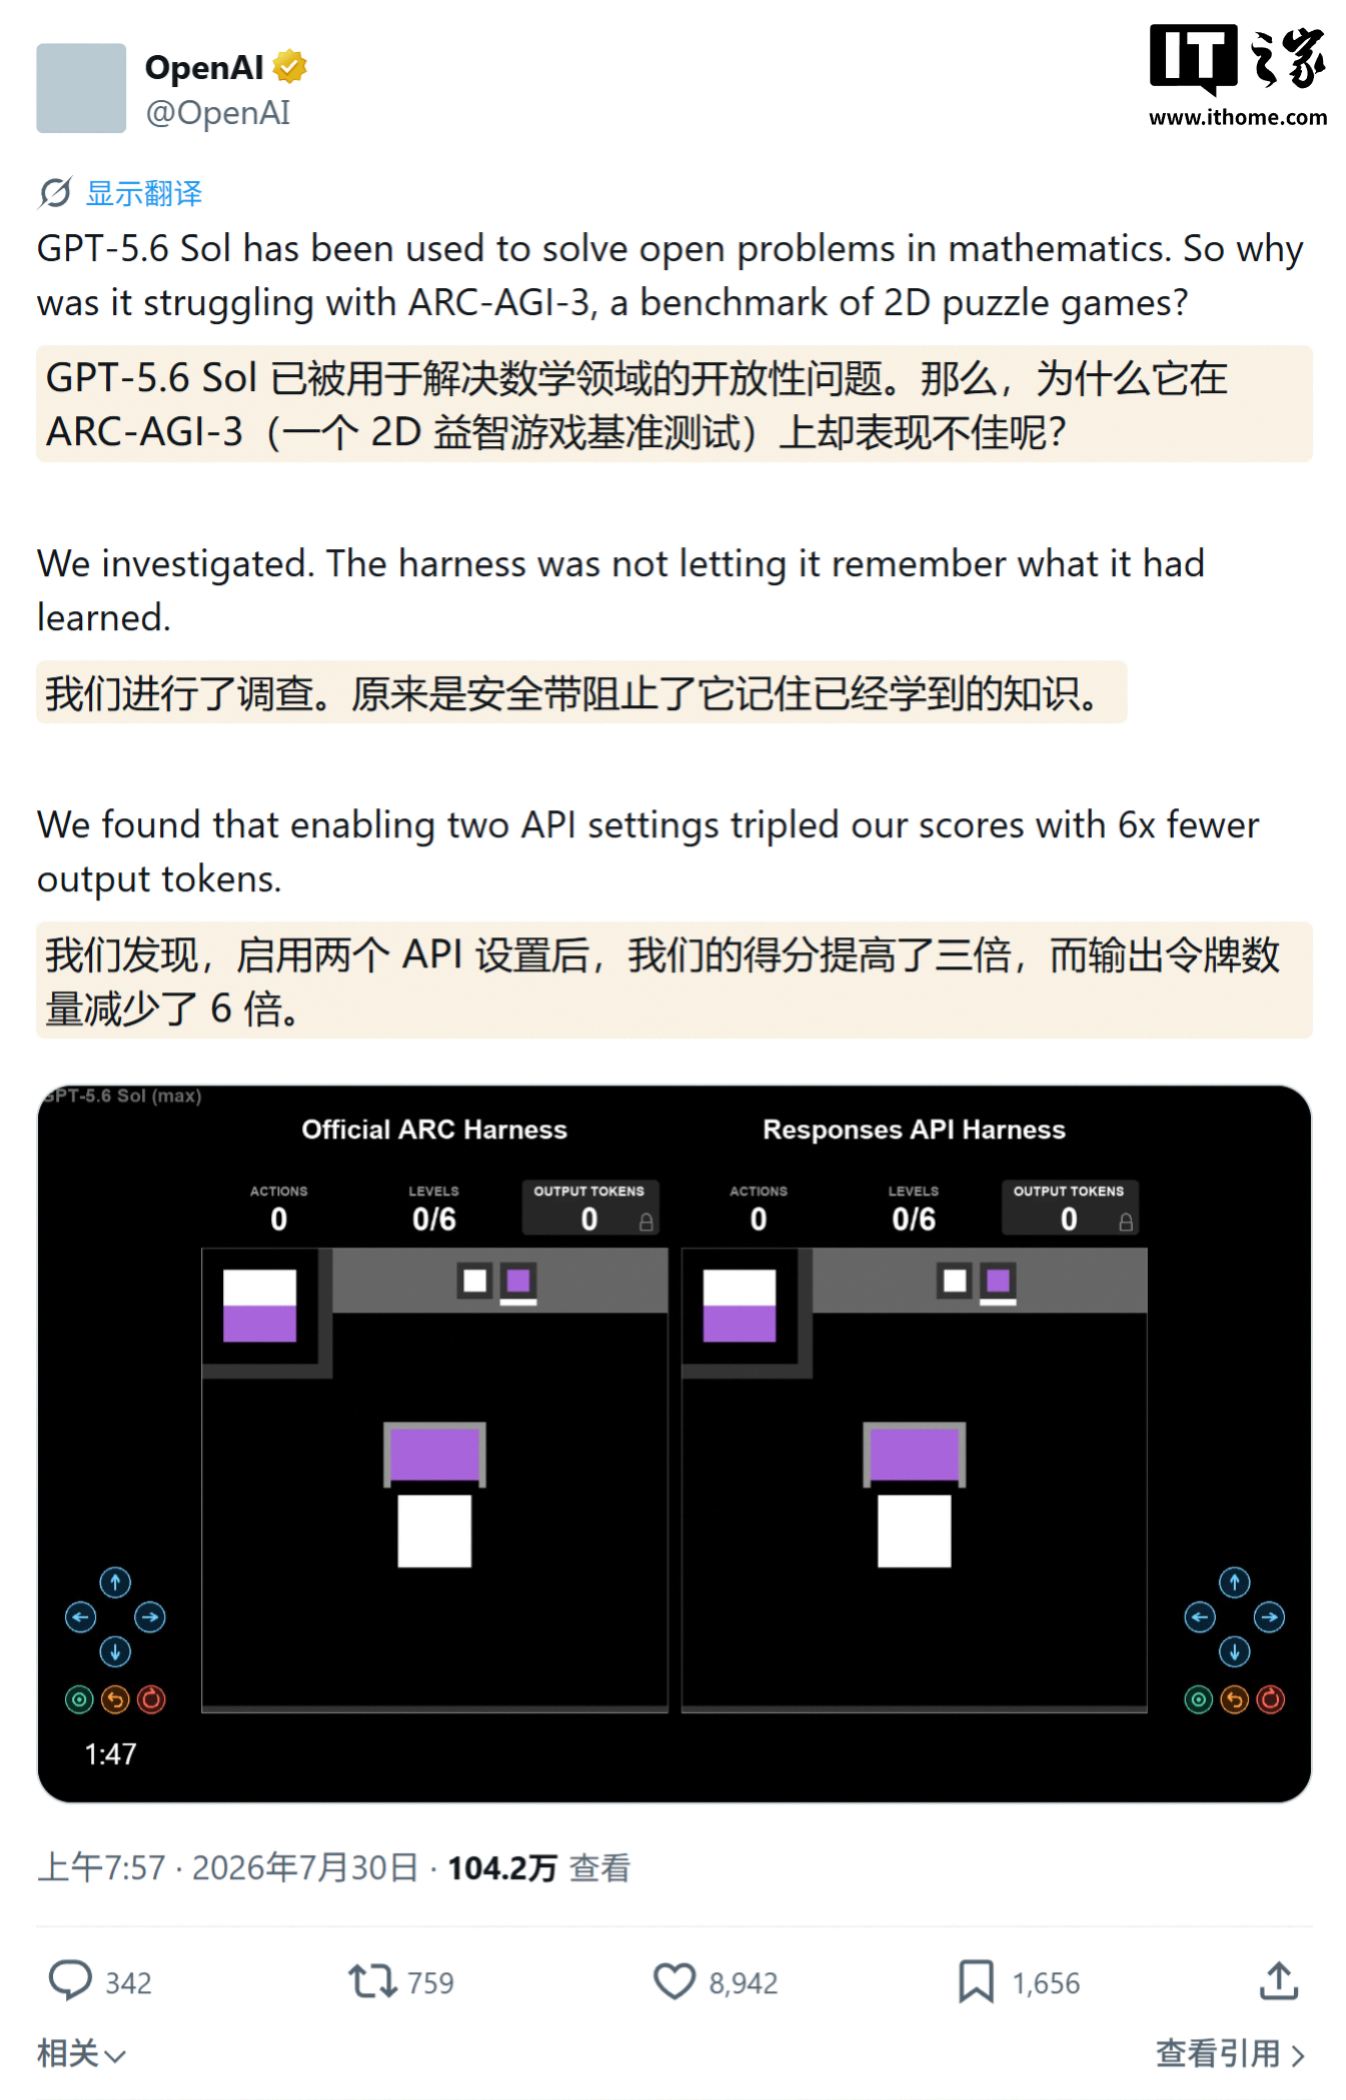
첫째, 게임에서 매번 행동을 취한 후 비공개 추론이 폐기된다. 이는 GPT-5.6 Sol이 행동을 한 번 실행할 때마다 게임을 다시 이해해야 한다는 의미다. 모델은 과거 행동 기록과 간단한 메모는 볼 수 있지만, 해당 행동을 이끌어낸 계획과 통찰, 사고 과정은 볼 수 없다.
둘째, 공식 프레임워크는 롤링 절단 방식의 컨텍스트 창을 사용한다. 기록이 길어질수록 이전 행동이 컨텍스트에서 사라진다. 즉 GPT-5.6 Sol은 과거의 사고를 보존하지 못할 뿐 아니라 과거 행동에 대한 기억도 잃게 된다.
OpenAI는 이러한 문제를 해결하기 위해 추론 보존(inference preservation)과 컨텍스트 압축(context compression)이라는 두 가지 방안을 제시했다.
추론 보존과 관련해 OpenAI는 Responses API를 사용해 ARC-AGI-3 테스트 프레임워크를 다시 구현했다. GPT-5.6에서는 이전 response ID만 전달하면 도구 호출과 여러 차례의 상호작용에서 추론이 자동으로 보존된다.
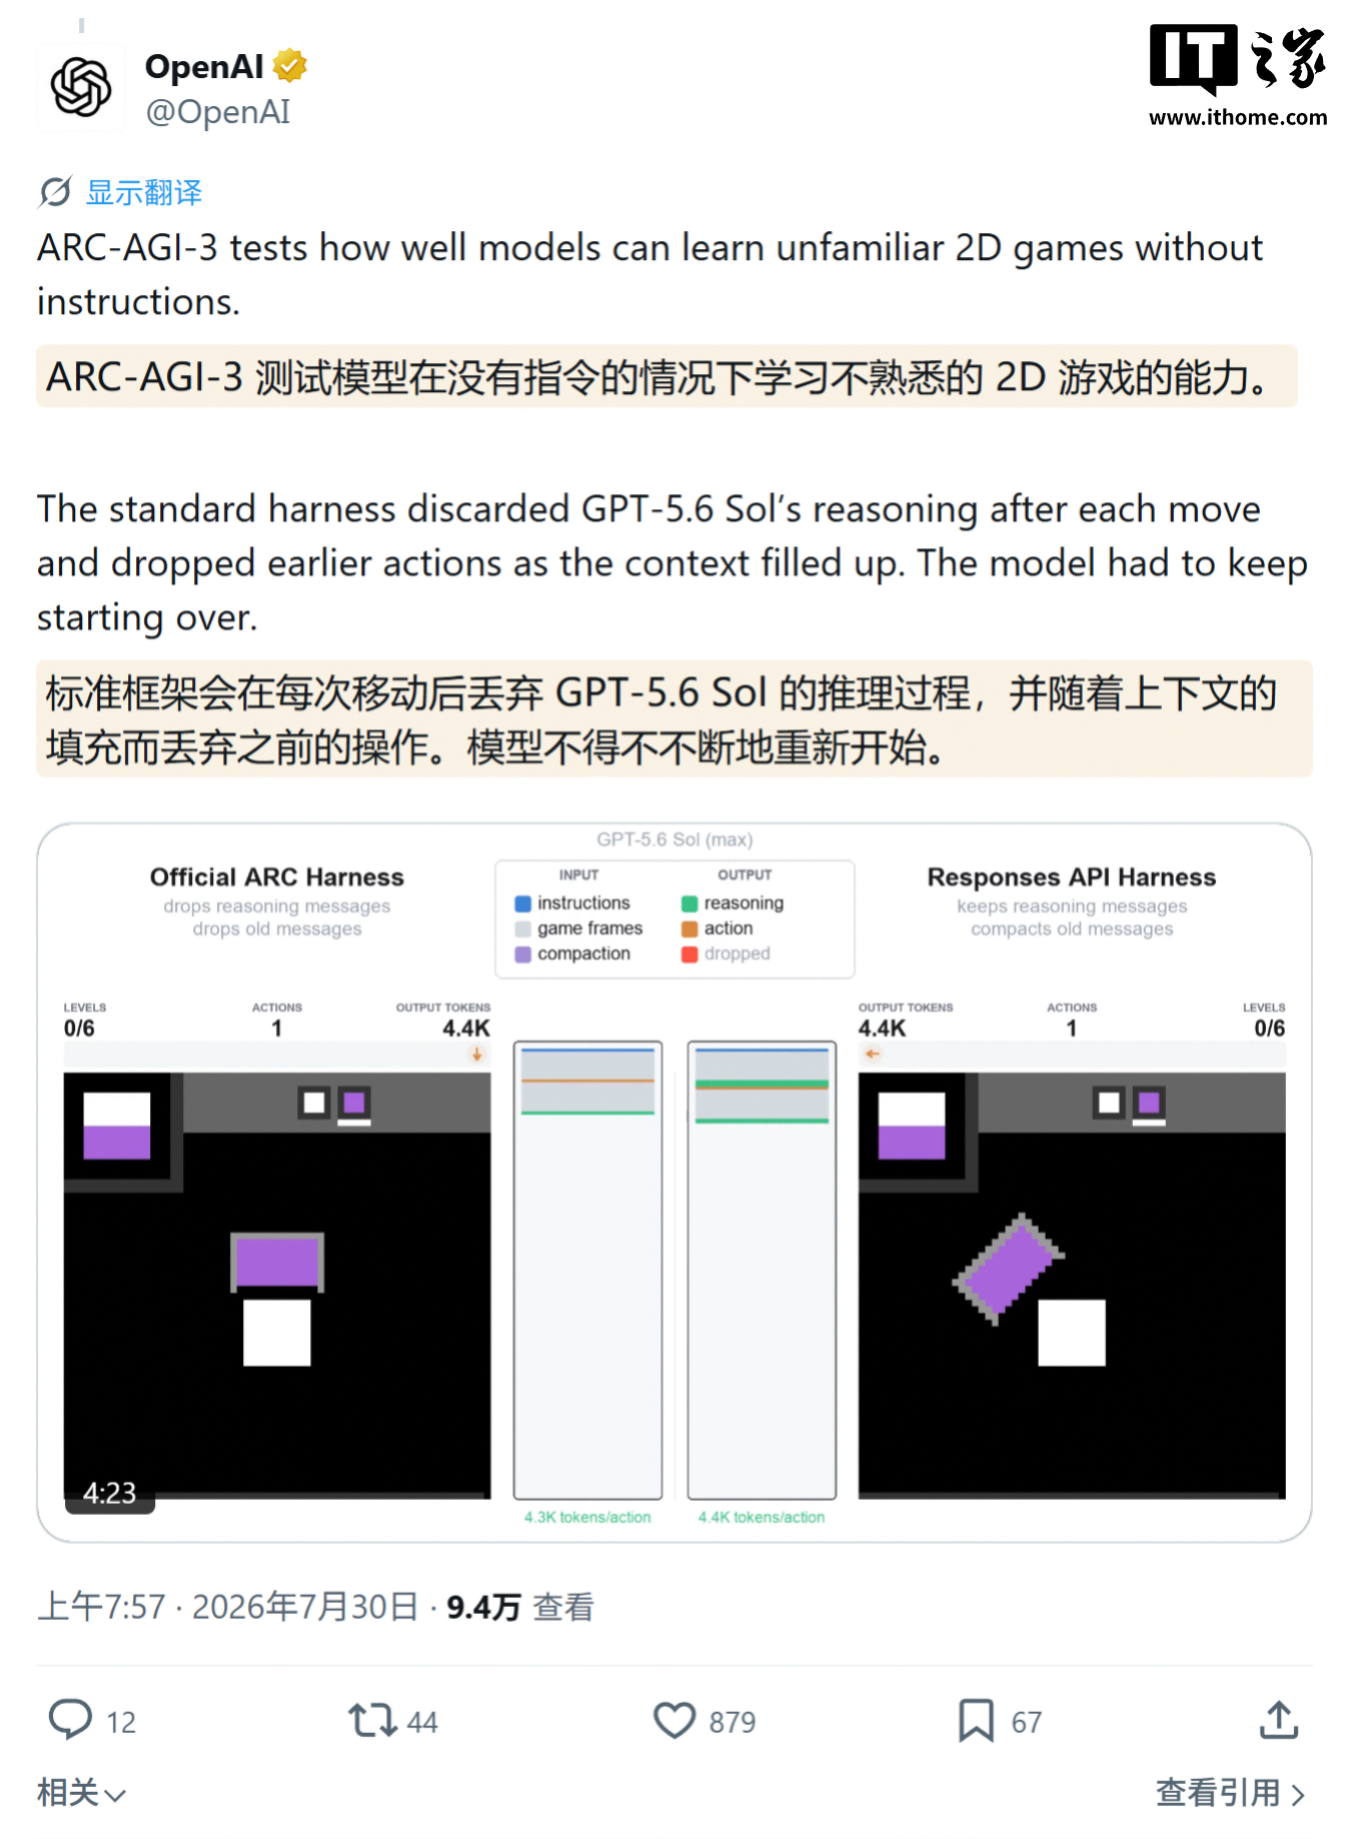
OpenAI는 추론 보존을 활성화하면 GPT-5.6이 매 라운드마다 게임을 다시 설명할 필요가 없어져, 각 행동 전에 사고하는 데 걸리는 시간이 줄어든다고 밝혔다. 또한 모델이 과거의 생각을 보존하게 되면서 시간이 지날수록 더 잘 학습하고 더욱 일관된 전략을 사용하게 된다.
컨텍스트 압축과 관련해 공식 ARC-AGI-3 프레임워크는 대화 컨텍스트가 175000자를 초과하면 가장 오래된 메시지를 삭제한다. OpenAI에 따르면 롤링 절단에는 두 가지 단점이 있다. 모델이 초기 관찰과 행동을 잃게 되며, 작업 시간 대부분 동안 더 가득 찬 컨텍스트 창으로 실행돼 성능이 소폭 저하될 수 있다는 점이다.
컨텍스트 압축을 활성화하면 GPT-5.6 Sol은 장시간 작업에서 각 게임에 대해 학습한 정보를 더 잘 보존하고, 더 적은 출력 토큰으로 더 높은 점수를 얻을 수 있다.
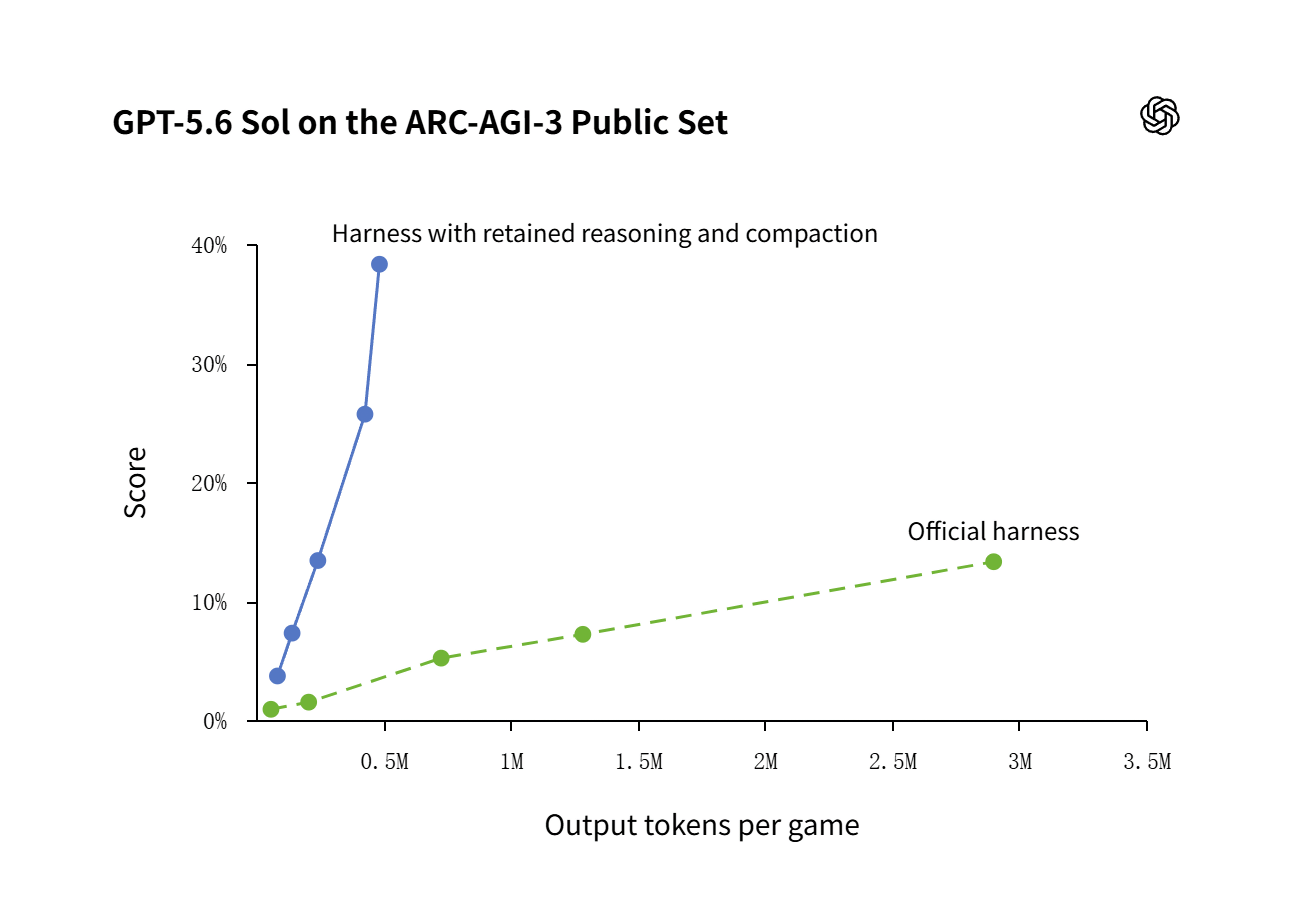
공식 harness를 사용했을 때 GPT-5.6 Sol의 ARC-AGI-3 점수는 13.3%였다. 추론 보존(inference preservation)과 컨텍스트 압축(context compression)을 활성화하자 GPT-5.6 Sol은 토큰 출력량을 6분의 1로 줄이는 동시에 38.3%의 점수를 기록했으며, 성적은 188.42% 향상됐다.
harness(흔히 ‘고삐 공학’이라고 부름)는 대규모 모델 외부에 배치되어 실행 환경, 도구 통합, 규칙 제약 및 피드백 메커니즘을 제공하는 전체 시스템 아키텍처를 뜻한다.
강력한 AI 모델을 힘이 넘치지만 통제하기 어려운 야생마에 비유한다면, harness는 말의 고삐와 안장, 기수가 정한 이동 경로에 해당한다. 모델 자체의 아키텍처를 바꾸지는 않지만, 모델을 안전하고 안정적으로 통제해 복잡한 작업을 실제로 수행할 수 있을지를 결정한다.