

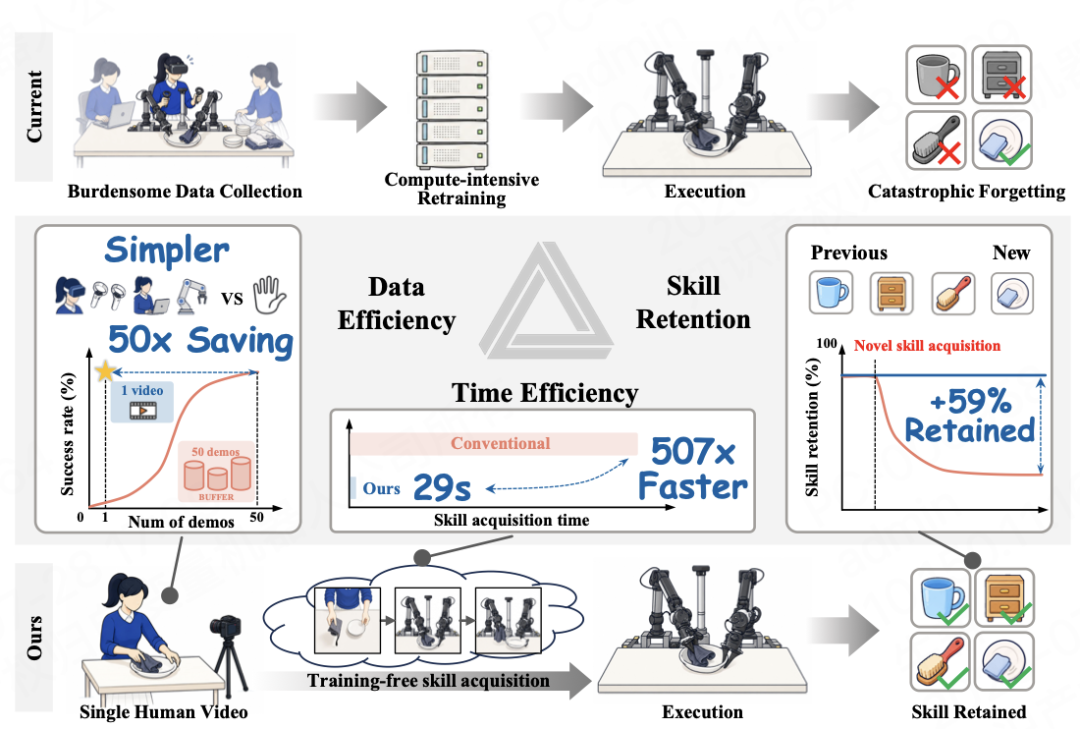
자변 로보틱스가 오늘 HOST 프레임워크(Human-to-robot One-Shot Skill AcquisiTion, 인간에서 로봇으로의 원샷 기술 습득)를 발표하고 오픈소스로 공개했다. 이 프레임워크는 “로봇이 수십 초 분량의 인간 영상을 관찰하는 것만으로 새로운 기술을 학습하면서, 이미 습득한 기술도 유지하도록 한다”고 설명한다.
HOST는 인간의 동작을 로봇의 동작으로 번역해 모방하도록 하는 대신, 로봇이 먼저 동작을 수행한 뒤의 결과를 상상하고 그 결과를 바탕으로 필요한 동작을 역산하는 혁신적인 방식을 채택했다. 그 효과는 고무적이다. 로봇이 29초 분량의 인간 영상에서 기술을 학습하는 성공률은 62%에 달해 제로샷 기준선인 45%를 넘어섰다. Pi-0.5 + 파인튜닝 방식과 비교하면 HOST는 필요한 데이터 양을 50배 줄이고 기술 학습 속도를 500배 높였다.
HOST의 아이디어는 인지과학의 ‘관찰 학습’ 이론에서 비롯됐다. 인간은 익숙하지 않은 작업을 마주했을 때 장기간의 연습이나 모든 경우의 수를 일일이 시도하지 않고도, 선행 능력을 바탕으로 뇌 속에서 동작의 예상 결과를 시뮬레이션한 뒤 그에 맞는 동작을 수행한다. 자변 연구진은 여기서 영감을 얻어 HOST의 학습 방식을 ‘훈련 중 파인튜닝 루프’에서 ‘추론 중 기술 습득’으로 전환했다. 이를 통해 로봇은 인간이 작업을 수행하는 모습을 관찰하며 새로운 기술을 학습한다.
로봇이 먼저 해결해야 할 문제는 자신의 작업 진행도와 영상 속 진행도를 어떻게 맞출 것인가이다.
예를 들어 같은 10초 동안 작업하더라도 영상 속 사람은 이미 채소를 다 썰고 볶기 시작했을 수 있지만, 로봇은 여전히 채소를 썰고 있을 수 있다. 단순히 시간만 기준으로 정렬하면 로봇은 작업 진행도를 놓치게 된다.
이에 HOST는 ‘작업 진행도에 따른 정렬’ 방식을 사용한다. HOST는 영상의 각 프레임과 로봇 조작의 각 단계를 동일한 벡터 공간의 벡터로 변환한 다음, ‘동적 시간 왜곡’ 알고리즘을 활용해 ‘인간 영상의 X번째 프레임’과 ‘로봇 조작의 Y번째 단계’를 자동으로 정렬한다. 따라서 로봇이 각 단계를 수행할 때마다 작업 진행도에 맞는 프레임을 확인할 수 있다.
이 방식을 통해 HOST는 작업 진행도 정렬에 따른 시간 오차를 한 자릿수 규모로 줄였으며, 로봇의 실행과 영상 시연을 정밀하게 동기화할 수 있게 됐다.
HOST의 핵심은 시각적 예측 기능을 갖춘 캐스케이드 정책 모델이다. 이 모델은 역할이 명확히 나뉜 두 개의 두뇌처럼 작동하는 듀얼 전문가 MoT 아키텍처를 채택했다. ‘시각 두뇌’인 영상 전문가는 영상 화면을 처리하고 작업 진행도를 파악하며 미래 장면을 예측한다. ‘동작 두뇌’인 동작 전문가는 예측된 장면을 실행해야 할 동작으로 변환하고 실행을 제어한다.
모델을 학습할 때 자변 팀은 학습 과정을 ‘동체 사전 학습’과 ‘인간-로봇 영상 학습’의 두 단계로 나눴다. 동체 사전 학습 단계에서 로봇은 로봇 자체가 작업을 수행하는 영상을 학습해 작업 완료 후의 상태를 예측하고 그에 맞는 동작을 생성하는 법을 익힌다. 인간-로봇 영상 학습 단계에서는 인간의 시연 영상을 추가로 학습해 인간이 작업을 수행하는 과정을 로봇의 관점에서 본 작업 결과로 변환한다. 그런 다음 목표 결과를 바탕으로 작업 완료에 필요한 동작을 추론해 인간의 시연을 로봇의 기술로 이전한다.
현재 HOST의 연구 논문과 코드는 모두 오픈소스로 공개됐다. 향후 로봇이 가정에서 작업할 때 전문적인 데이터 수집과 훈련 과정에서 벗어나, 직관적인 인간의 시연만으로 새로운 기술을 학습할 수 있을 것으로 기대된다.
참고
프로젝트 홈페이지
논문 링크
Github 링크
Huggingface 링크