

알리바바 통이 첸원 팀은 오늘 밤 Qwen3.8-Flash를 공식 출시했습니다. 통이 팀은 Qwen3.8-Flash-Next의 오픈 소스 가중치도 함께 공개했으며, Next의 새로운 아키텍처는 차세대 Qwen4 시리즈 모델의 기반이 될 예정입니다.
이 모델은 멀티모달 MoE 모델로, 메인 모델의 매개변수 수는 125B이며 51B 규모의 N-gram Embedding을 추가로 탑재하고 토큰당 6B 매개변수를 활성화합니다. 기본적으로 262,144 tokens 컨텍스트를 지원하며 YaRN을 통해 1M tokens까지 확장할 수 있습니다.
소개에 따르면 Qwen3.8-Flash는 네 가지 방향에서 체계적인 업그레이드를 진행했습니다.
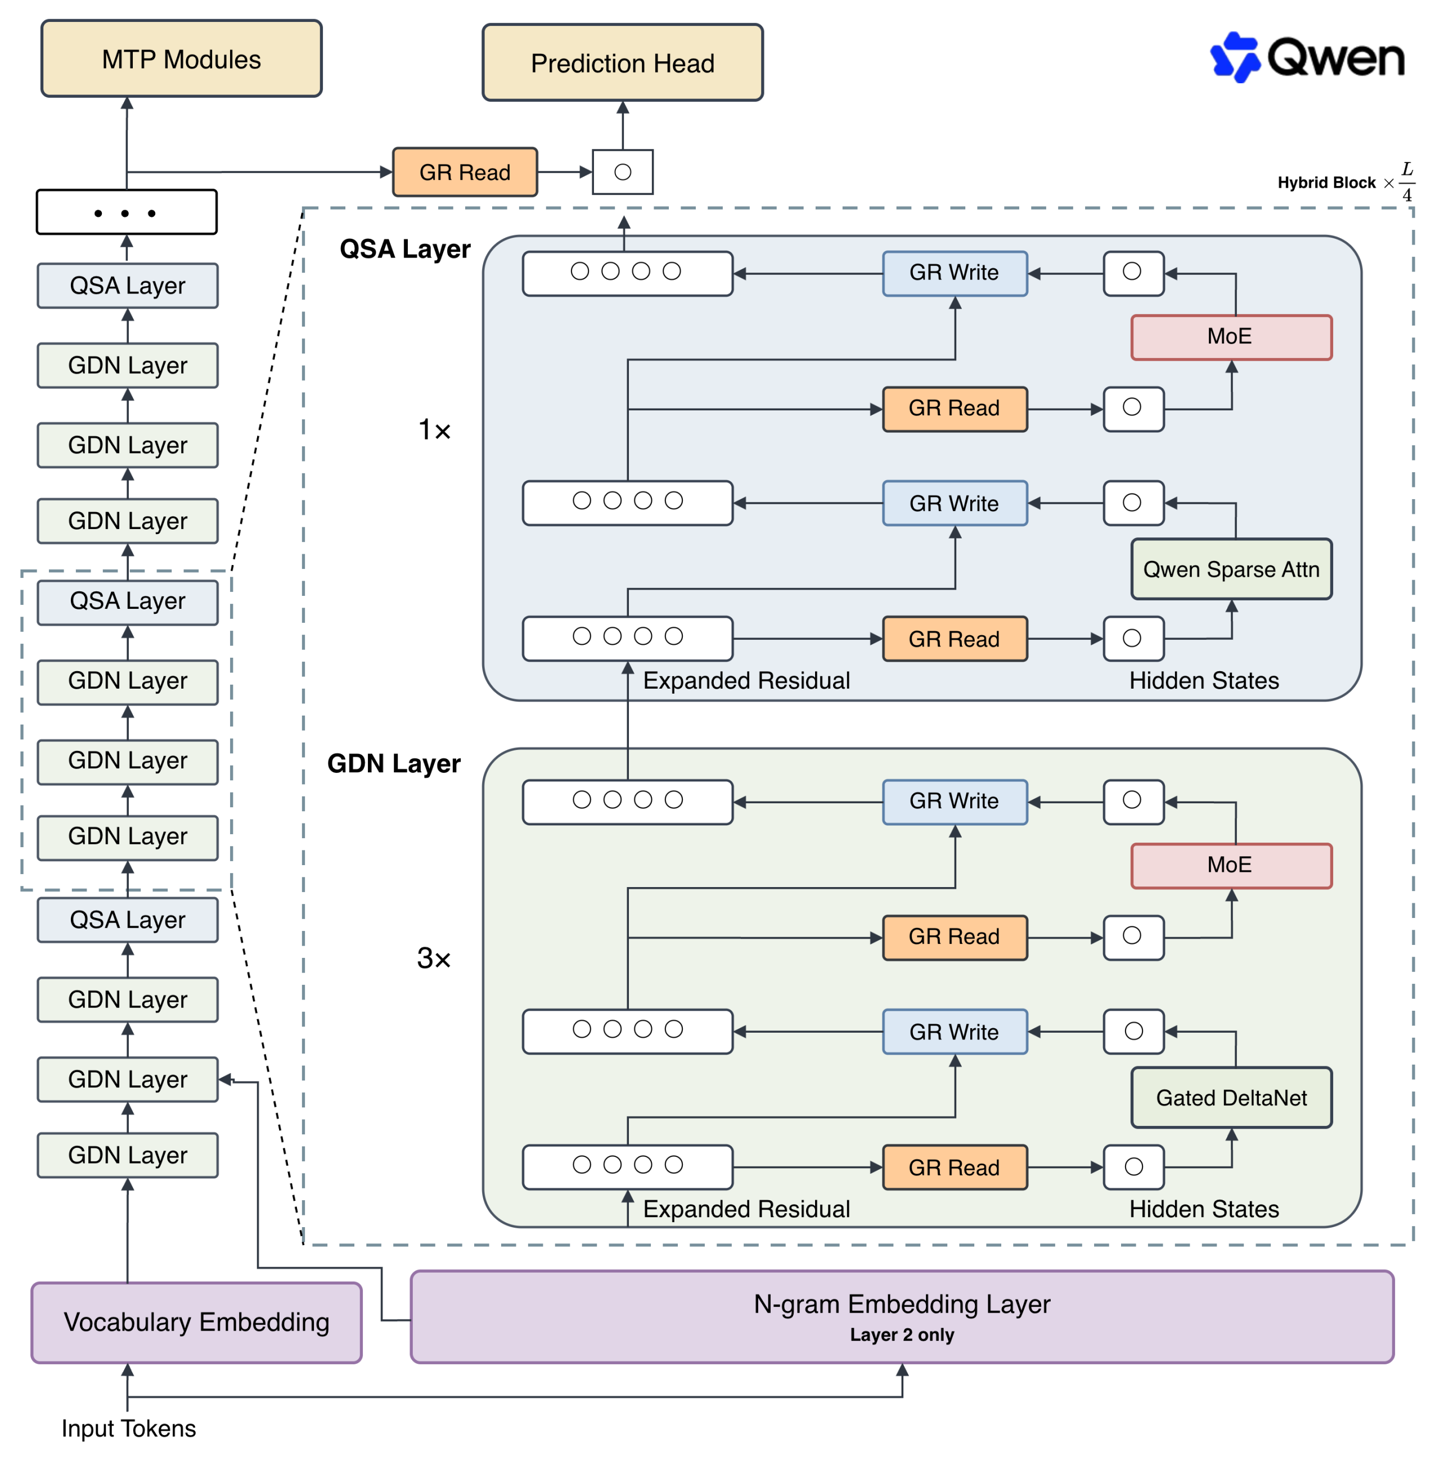
Attention 측면에서는 GDN(Gated DeltaNet)+ QSA(Qwen Sparse Attention)혼합 아키텍처를 적용했습니다. GDN은 과거 정보를 효율적으로 압축하고, QSA는 경량 Indexer를 통해 micro-block 단위로 중요한 컨텍스트를 선별해 긴 시퀀스의 Attention 오버헤드를 크게 줄입니다. 1M token의 초장문 컨텍스트 환경에서 QSA의 Attention Kernel은 Prefill 및 Decode 단계에서 각각 최대 7.6배와 4.9배의 가속을 달성했습니다.
Residual 측면에서는 Gated Residual(GR)메커니즘을 도입해 잔차 흐름을 4개의 병렬 분기로 확장하고, 동적 Gate로 정보의 읽기와 쓰기를 제어합니다. 잔차 상태는 FP8 저장을 지원해 메모리 액세스 오버헤드를 크게 줄입니다.
Embedding 측면에서는 51B 매개변수의 N-gram Embedding을 도입해 로컬 컨텍스트 조회를 통해 모델 용량을 확장합니다. 이 매개변수는 Host Memory로 오프로딩할 수 있으며, 비동기 Prefetch와 모델 연산을 중첩해 GPU 메모리를 장기간 점유하지 않습니다.
Optimization 측면에서는 Muon Optimizer를 적용하고 직교화 정밀도, 매개변수 역할 분담, 융합 행렬 분할 등의 전략을 최적화했습니다. 새로운 아키텍처에 맞춰 Scaling Law도 다시 피팅했습니다.
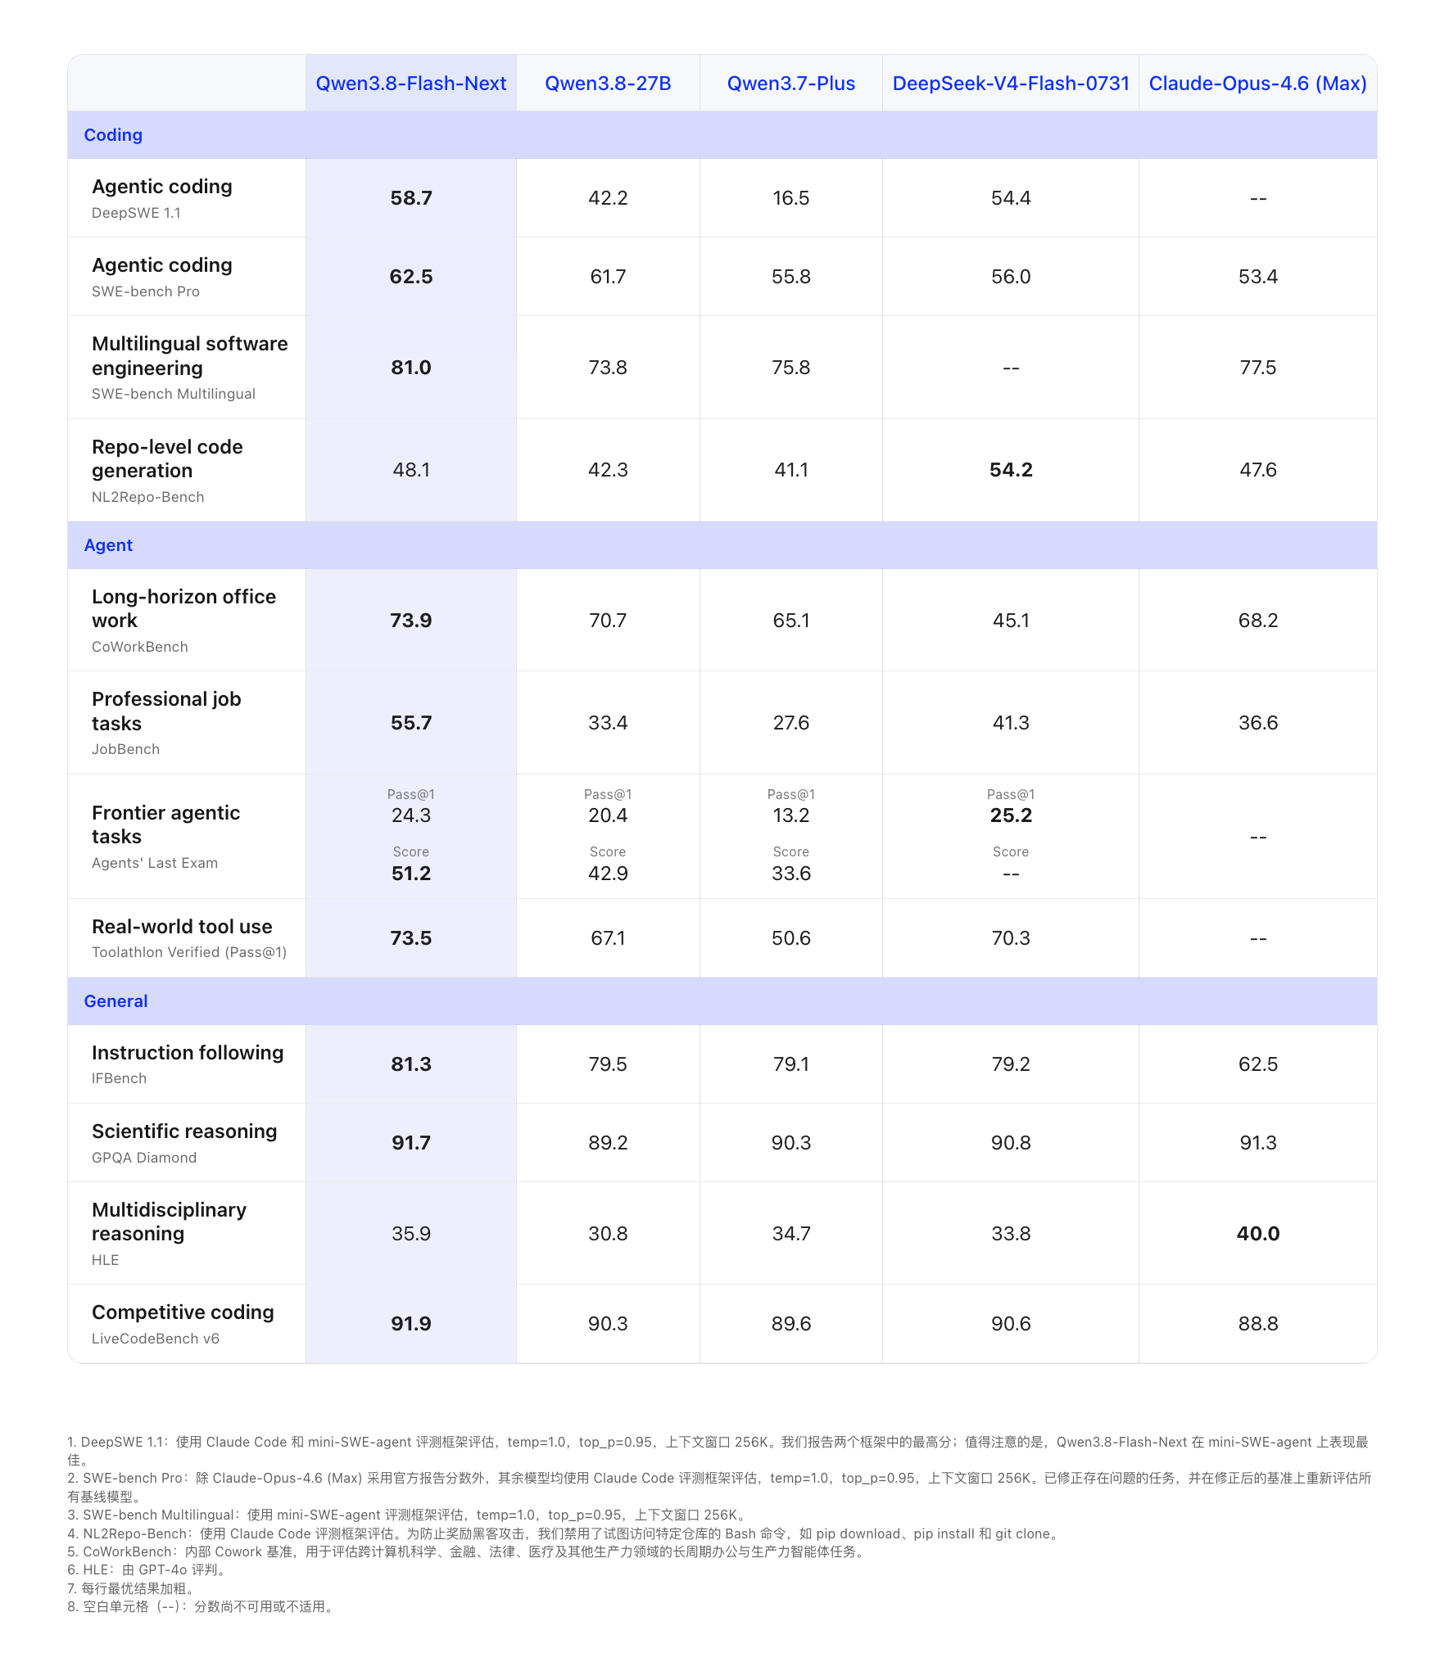
Qwen3.7-Plus와 비교하면 Qwen3.8-Flash의 학습 비용은 전자의 약 9분의 1에 불과하지만, 코딩과 사무 작업에서는 더 뛰어난 성능을 보입니다.
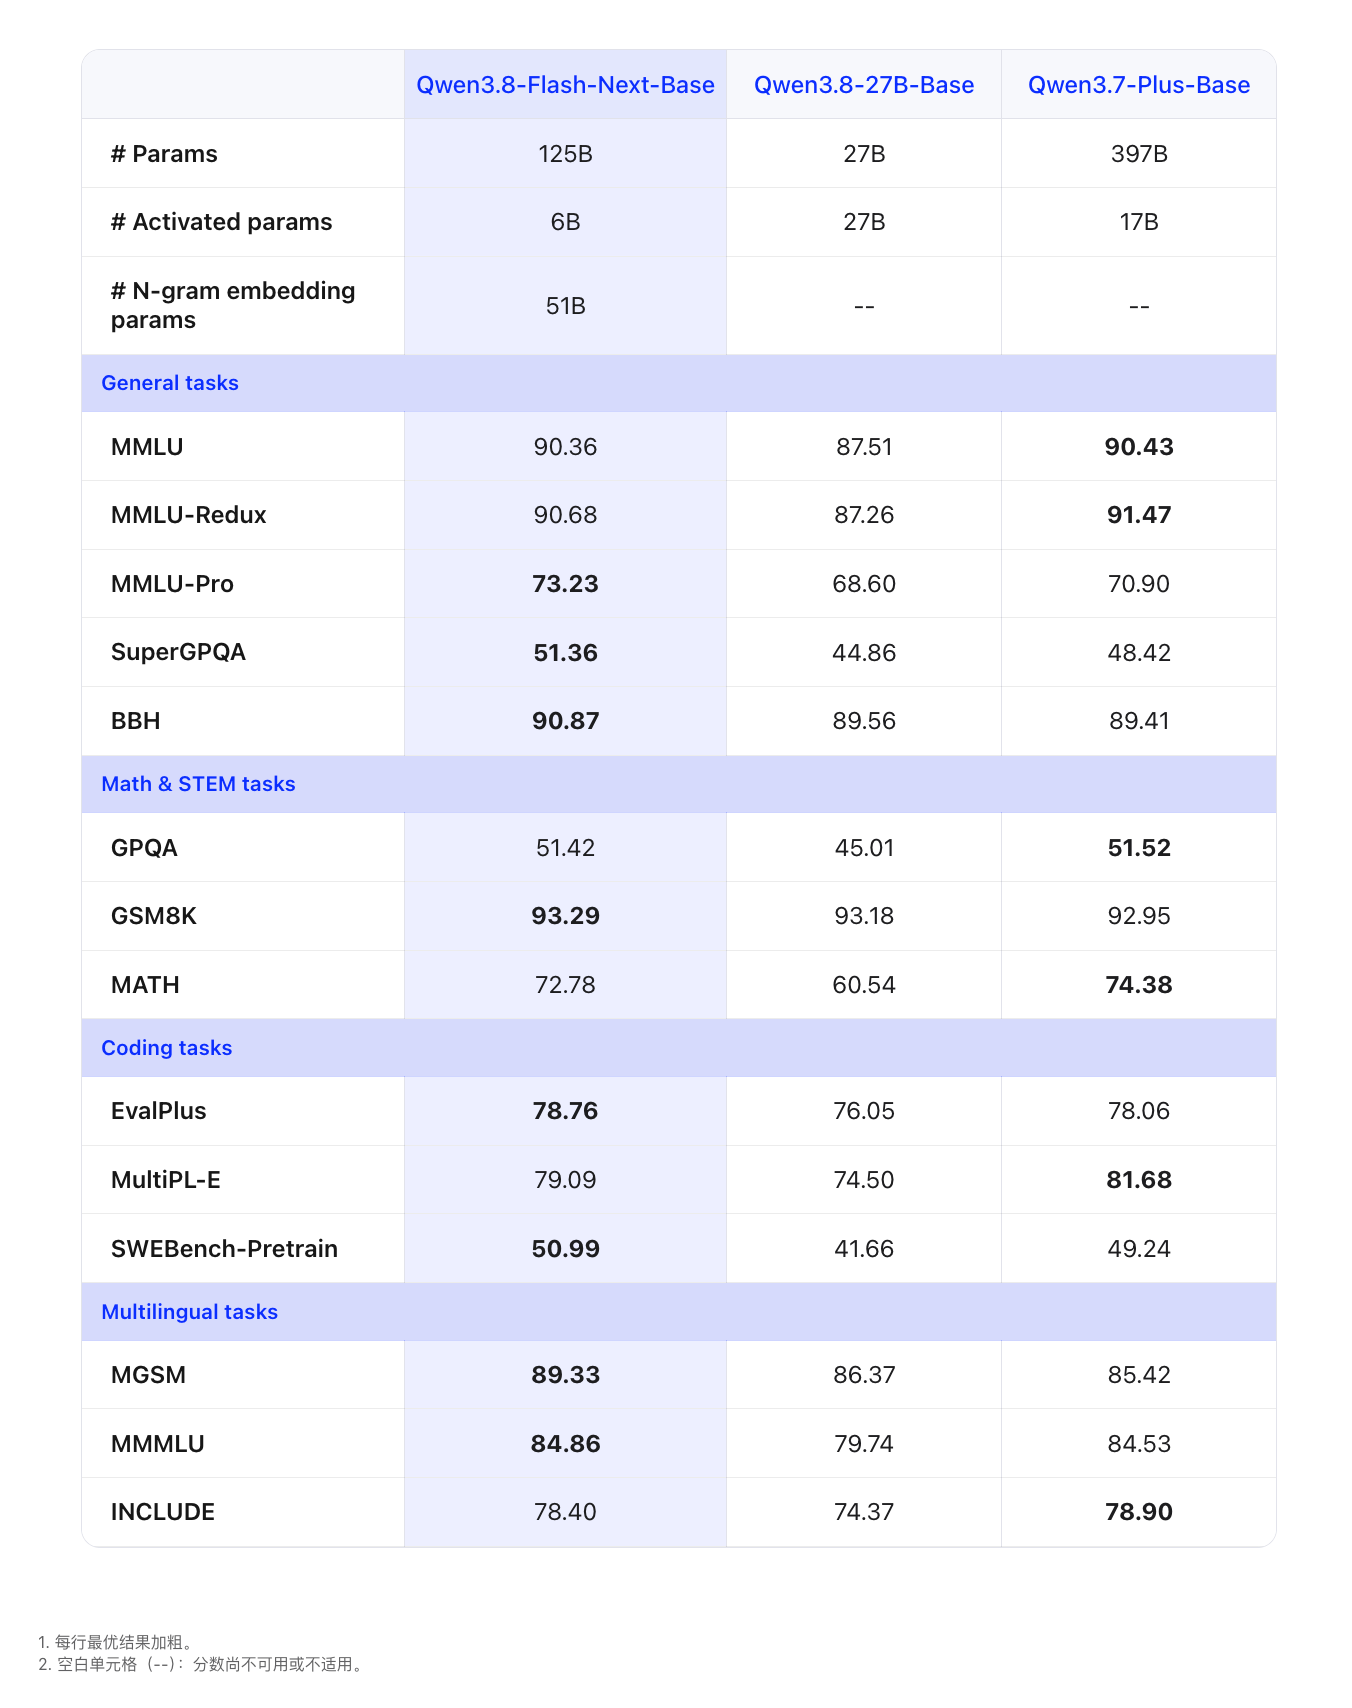
6B 활성화 매개변수 기준으로 Qwen3.8-Flash-Next-Base는 14개 benchmark 중 8개에서 최상의 결과를 기록했으며, 여기에는 MMLU-Pro, SuperGPQA, BBH, SWEBench-Pretrain, MGSM, MMMU가 포함됩니다.
텍스트 전용:
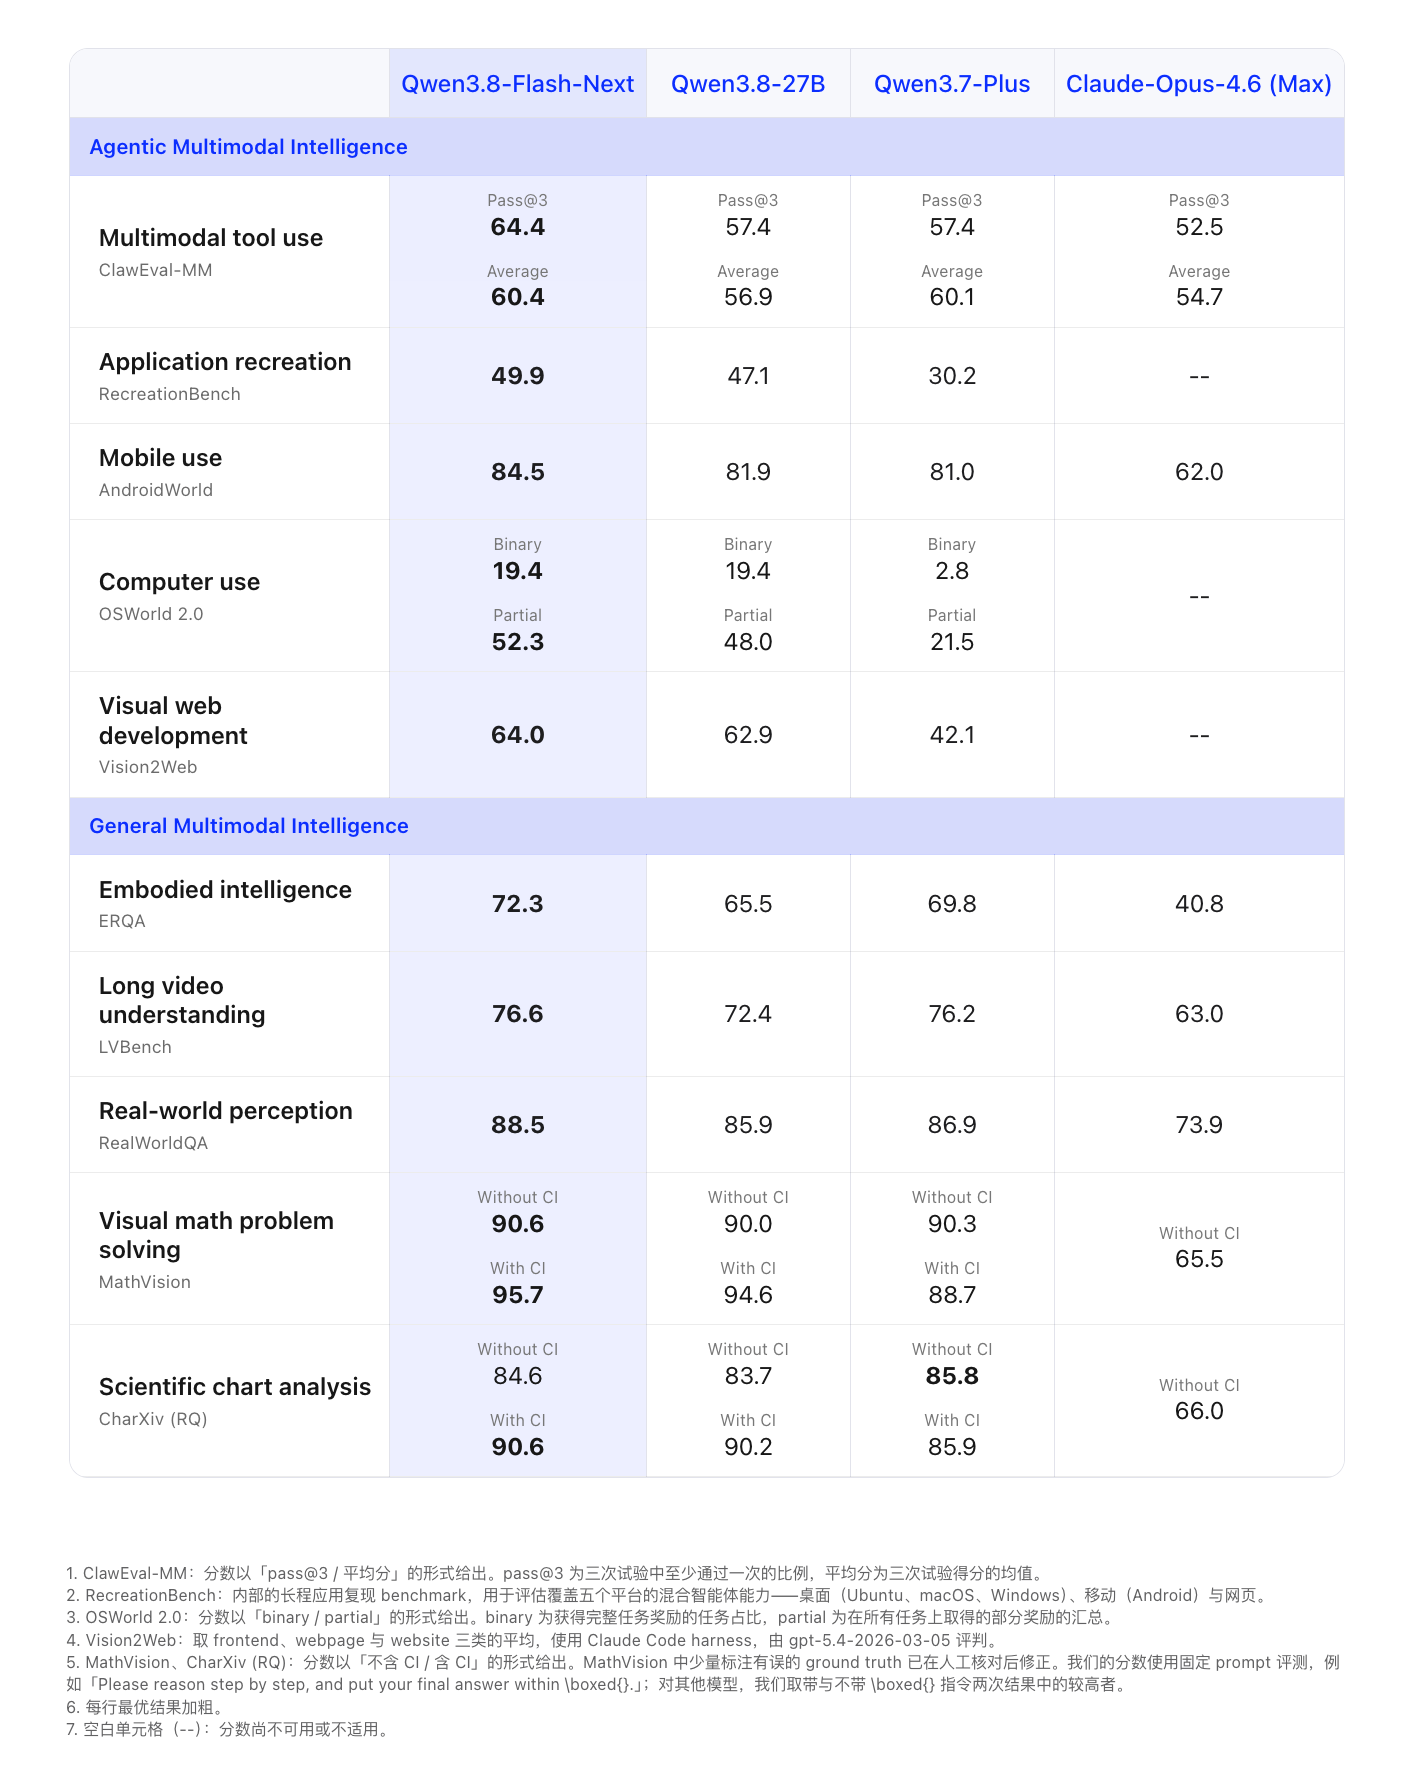
멀티모달:
모델 구조:
Base 모델 성능:
Qwen3.8-Flash는 곧 첸원 AI 플랫폼에上线되어 API 서비스를 제공합니다. 가격은 입력 토큰 100만 개당 1위안, 출력 토큰 100만 개당 3위안입니다.
모델 가중치는 베이징 시간 8월 26일 23:00에 Hugging Face와 ModelScope 플랫폼에서 오픈 소스로 공개되었으며, FP8 양자화 버전도 동시에 출시되었습니다. Qwen3.8-Flash-Next는 기본적으로 1M 컨텍스트를 지원하고 공식 도구를 내장합니다.
참고 자료:
기술 보고서: https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
기술 블로그: https://qwen.ai/ blog?id=qwen3.8-flash-next
Hugging Face: https://huggingface.co/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921FsyOPe& ;amp;amp;file=Qwen3.8-Flash-Next
ModelScope: https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921XAP2dV& ;amp;amp;file=Qwen3.8-Flash-Next