

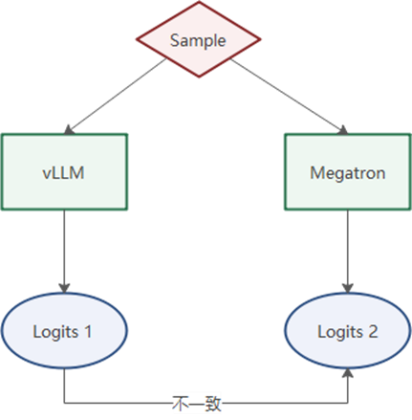
강화학습은 대규모 모델 학습의 주요 패러다임으로 자리 잡으며 모델 기술의 산업 핵심 분야 적용을 가속하고 있습니다. 이 과정에서 학습과 추론의 일관성은 매우 중요합니다. 추론과 학습 과정이 서로 결합되어 있어 인프라 차이가 불확실성을 확대할 수 있기 때문입니다.
화웨이 컴퓨팅 공식 채널은 8월 5일, 어센드가 Ascend C 프로그래밍 언어를 기반으로 완전한 학습·추론 일관성 연산자 세트를 제공한다고 발표했습니다. Qwen3-30B MoE 모델 테스트에서 Logdiff 0을 달성했으며, 어센드에 최적화된 FA 연산자 최적화를 통해 Eager 모드에서 20%-60%의 성능 향상을 얻어 개발자에게 효율적이고 안정적인 강화학습 학습 솔루션을 제공합니다.
RL 후처리에서 학습과 추론이 일치하지 않는 가장 근본적인 원인은 하위 수준의 계산 과정에서 누적 순서가 보장되지 않기 때문입니다. 학습 엔진과 추론 엔진의 모든 누적 순서를 위에서 아래까지 일치시키려면 프레임워크와 연산자 양쪽의 개선이 필요합니다. 모델 파라미터가 클수록 문제는 더욱 확대됩니다. 텐서 병렬화와 전문가 병렬화 등의 분할 전략, 집합 통신 경로 중 어느 한 단계라도 정렬되지 않으면 최종적인 true-on-policy를 구현할 수 없습니다. 연산자는 다양한 호출 시나리오도 지원해야 하며, 핵심 계산 단계에 제약을 적용하는 동시에 성능 저하를 사용 가능한 범위로 제어해야 합니다. 이는 시스템 차원의 엔지니어링 과제입니다.
학습·추론 불일치란 Rollout(추론) 엔진과 학습 엔진 사이의 수치적 불일치를 의미합니다. 두 엔진이 완전히 동일한 모델 가중치를 사용하더라도 동일한 Token 시퀀스에 대해 계산한 로그 확률(logprob)에는 미세한 차이가 발생할 수 있으며, 이 차이는 일반적으로 logdiff로 측정합니다.
어센드는 Ascend C 프로그래밍 언어를 기반으로 학습·추론 경로의 핵심 연산자에 대해 체계적인 제약과 정렬을 적용했습니다. 핵심 아이디어는 학습과 추론이 ‘누적이 필요한 부분’에서 동일한 수치 경로를 따르도록 하는 것이며, 주요 변경 사항은 다음 4가지입니다.
주의력 의미 통일: 학습 마스크 Softmax와 추론 단계별 주의력이 유효 위치에서 동일한 계산 범위를 사용하도록 정렬해, 가시적인 Token 집합의 차이로 발생하는 수치 차이를 제거합니다.
reduce 누적 순서 고정: 학습 FA와 추론 PFA / PagedAttention이 리덕션 차원에서 사용하는 분할 및 축약 순서를 제한해, ‘동일한 템플릿이지만 서로 다른 분할’로 인한 누적 순서 불일치를 방지합니다.
온라인 Softmax 분할 전략 정렬: 분할 크기와 축약 주기를 통일해 디코더 측의 다중 분할 병합 Softmax와 학습 측 분할 Softmax 간의 불일치를 방지합니다.
핵심 경로 정밀도 정렬: Softmax 누적과 같은 민감한 단계에서 정밀도 변환 전략을 통일해 혼합 정밀도 구현 차이로 발생하는 가수부 오차를 줄입니다.
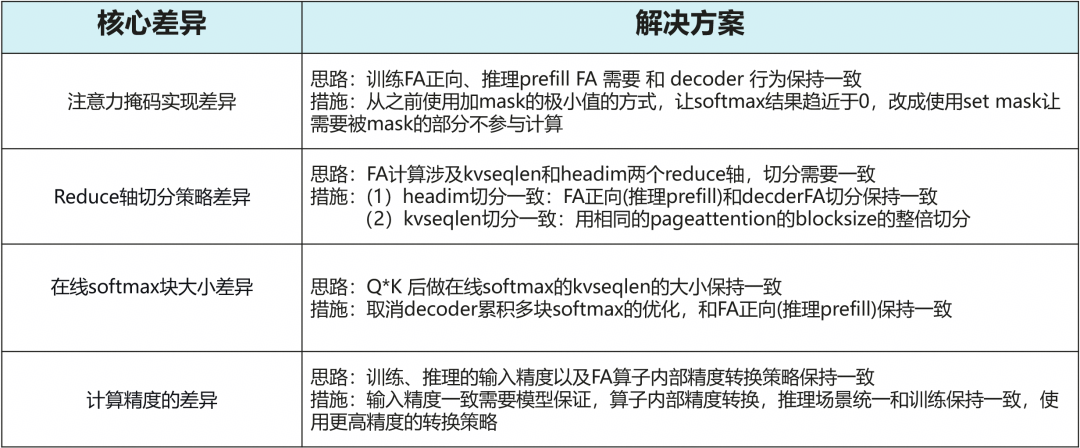
이를 바탕으로 FA 전개 및 스케줄링 최적화를 적용해, 학습·추론 일관성을 확보하는 데 더 이상 큰 성능 저하가 발생하지 않도록 했습니다. 그 결과 실제 테스트에서 logdiff=0과 엔드투엔드 가속을 동시에 달성했습니다.
화웨이는 관련 인프라를 이미 오픈 소스로 공개했으며, 잔여 logdiff를 점검하고 문제가 연산자 경로에 있는지 프레임워크 구현 차이에 있는지를 찾아낼 수 있는 ‘학습·추론 일관성 문제 식별 Skill’도 출시할 예정이라고 밝혔습니다.
오픈 소스 주소:
https://github.com/verl-project/verl-ascend-recipe/tree/main/true_on_policy