

즈푸가 오늘 GLM-5.3을 정식 출시했다. GLM-5.2와 비교해 기반 모델은 변하지 않았지만, 사후 학습 스케일링을 통해 모델의 지능 상한을 크게 높였다. 수십 배 늘어난 장기 작업 환경, 더욱 풍부하고 다양한 환경 유형, 매우 긴 사후 학습 시간이 적용됐다.
이전 세대와 비교해 GLM-5.3의 새로운 능력은 다음과 같다.
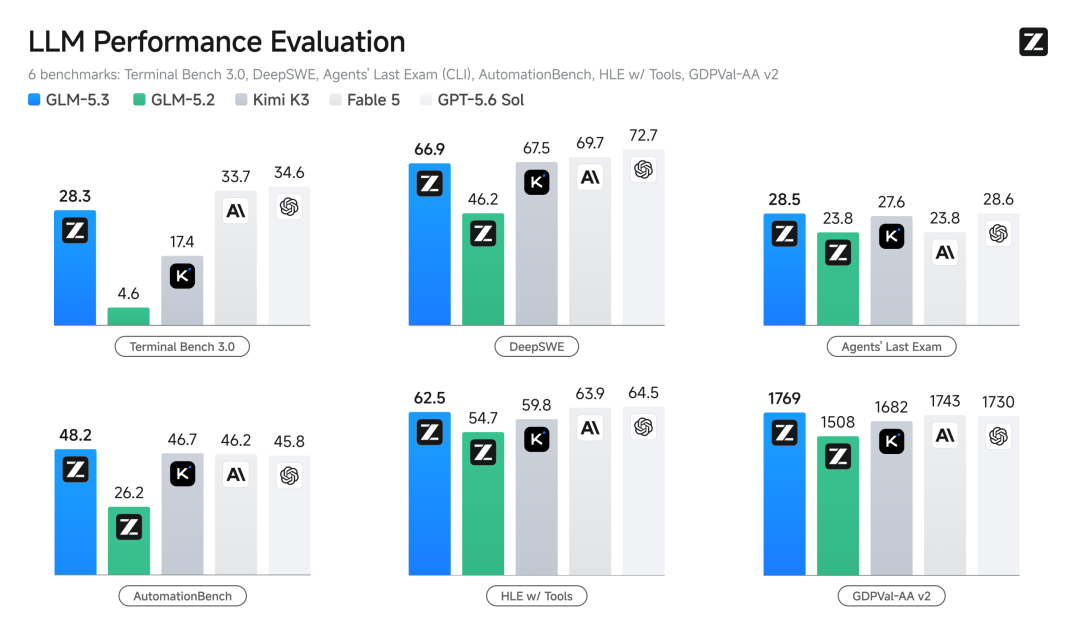
더 강력한 프로그래밍 능력. GLM-5.3은 프로그래밍 능력이 가장 뛰어난 오픈소스 모델로, 내부적으로 구축한 체감 평가에서 GLM-5.2보다 50% 향상됐다. Terminal Bench 3.0, Agents' Last Exam (CLI) 등을 포함한 공개 벤치마크에서 오픈소스 모델 중 1위를 차지했다.
사이버 보안 능력. 화이트박스 코드 검토와 취약점 발견 등 보안 작업에서 GLM-5.3은 Mythos 5와 대등한 성능을 보이며, 사이버 보안 방어 분야에서 강력한 잠재력을 드러냈다.
사후 학습 스케일링. 위의 모든 향상은 사후 학습에서 비롯됐다. IndexShare, SAO 및 지속적으로 발전하는 차세대 Slime 프레임워크를 기반으로, 즈푸는 GLM-5.2와 완전히 동일한 기반에서 강화 학습을 효율적으로 진행했다. 즈푸가 아직 이 기반 모델의 지능 상한을 완전히 개발하지 못했을 가능성도 있다.
오픈소스 공개. 즈푸는 출시 2주 후 모델 가중치를 공개할 예정이며, 그전에 안전성 평가와 모델 강화 작업을 완료한다.
즈푸는 여러 주요 벤치마크에서 GLM-5.3이 현재 가장 높은 순위의 오픈소스 모델이며, 프로그래밍 및 에이전트 능력이 Claude Fable 5에 근접하고 프로그래밍 체감 성능은 다른 중국산 모델을 앞선다고 밝혔다.
실제 터미널 환경에서 복잡한 작업을 수행하는 모델의 능력을 평가하는 Terminal-Bench 3.0에서 GLM-5.3의 점수는 4.6에서 28.3으로 향상됐다.
장기 소프트웨어 엔지니어링과 지속적인 코드 수정 능력에 초점을 맞춘 DeepSWE v1.1에서 점수는 46.2에서 66.9로 향상됐다.
다양한 실제 전문 분야를 아우르고 도구 간 협업 및 장기 작업을 강조하는 Agents' Last Exam에서 점수는 23.8에서 28.5로 향상됐다.
44개 직업을 대상으로 실제 고부가가치 지식 업무를 평가하는 GDPval-AA v2에서 1,769점을 기록하며, 프로그래밍 능력에서 발현된 전문 작업 수행 능력을 보여줬다.
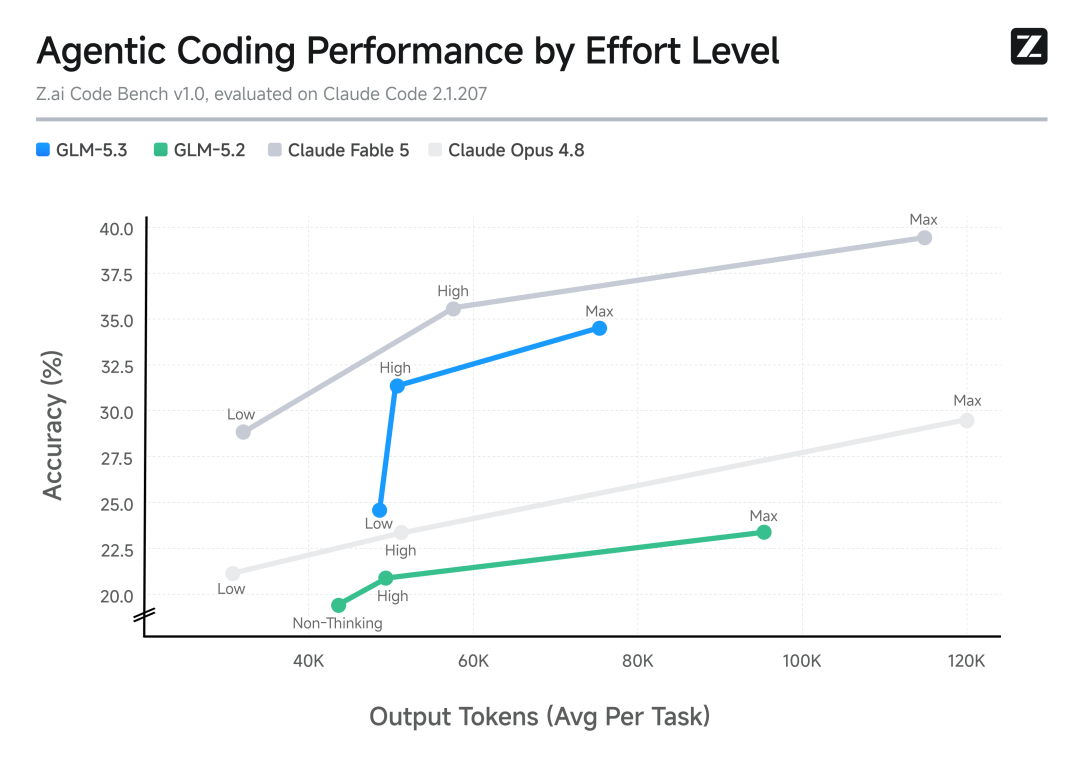
즈푸가 자체 개발한 Z.ai Code Bench는 실제 프로그래밍 환경에서 모델의 종합적인 체감 성능을 평가한다. 모델은 복잡한 로컬 개발 환경에 배치되며, 다양한 사고 수준에서 엔드투엔드 작업을 수행해 개발자가 실제로 Coding Agent를 사용할 때의 경험에 더욱 가깝게 평가한다.
테스트 결과, GLM-5.3은 성능과 Token 활용률 사이에서 더 나은 균형을 달성했다. High 수준에서 GLM-5.3은 31.4%의 정확도를 기록해 Claude Opus 4.8의 최고 수준인 29.5%를 넘어섰다. 작업당 평균 출력은 약 5만 tokens로, Opus 4.8의 약 12만 tokens보다 적었다. 이는 GLM-5.3이 더 짧은 실행 경로로 작업을 완료할 수 있음을 의미한다.
오늘부터 즈푸의 공식 프로그래밍 도구 ZCode와 생산성 도구 AutoClaw가 출시되며, GLM Coding Plan 전체 사용자 대상 서비스 및 구독이 개방된다.
TraeWork / TraeCode / 扣子, WorkBuddy / CodeBuddy, Qoder / QwenWork, CatPaw, JoyCode, OpenCode 등의 코딩 플랫폼에서 얼리 액세스를 제공한다.
API는 곧 출시되며, 전체 모델 가중치는 2주 이내에 오픈소스로 공개된다. 그전에 필요한 보안 강화를 완료해 잠재적인 공격 능력을 최대한 제한하고 방어적 가치를 유지할 예정이다.
오늘 13:00에 GLM Coding Plan의 전체 사용자 할당량이 재설정되며, 모든 사용자는 백엔드의 「사용량 통계」에서 사용 가능 할당량이 모두 복구된 것을 확인할 수 있다.