

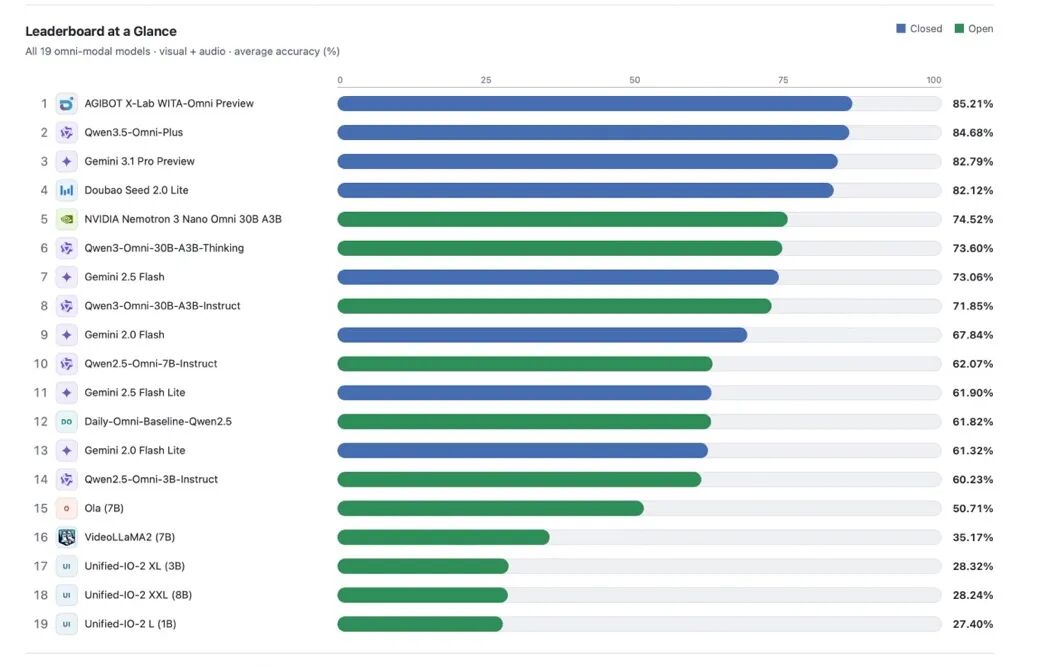
즈위안 AGIBOT 위챗 공식 계정에 따르면, 최근 체화형 멀티모달 이해 분야의 권위 있는 순위인 DailyOmni의 최신 평가 결과가 발표됐다. 즈위안이 자체 개발한 체화형 네이티브 멀티모달 대규모 모델 WITA-Omni Preview는 뛰어난 음영상 결합 이해 및 시계열 추론 능력을 바탕으로 종합 85.21점을 획득해 1위에 올랐다. 이는 Qwen, Gemini, Doubao, 엔비디아 등 중국 및 해외 주요 모델을 앞선 결과이며, 8개 세부 지표 중 6개에서 1위를 차지했다.
IT之家의 확인에 따르면, DailyOmni는 음영상 시계열 정렬과 크로스모달 공동 추론 능력을 검증하는 업계 공인 권위 제3자 순위다. 이미지와 텍스트, 짧은 동영상을 대상으로 하는 일반적인 평가 과제와 달리, 이 순위는 실제 개방 환경의 음영상 자료를 대량으로 활용한다. 시각적 화면과 환경 오디오 정보를 융합하고, 소리와 화면의 대응 관계 및 사건의 선후 순서, 크로스모달 의미를 정확히 식별하는 종합 능력을 중점적으로 평가한다. 이는 휴머노이드 로봇이 실제 물리적 공간에서 인간과 상호작용하는 데 필요한 핵심 감지 능력과 밀접하게 맞닿아 있다.
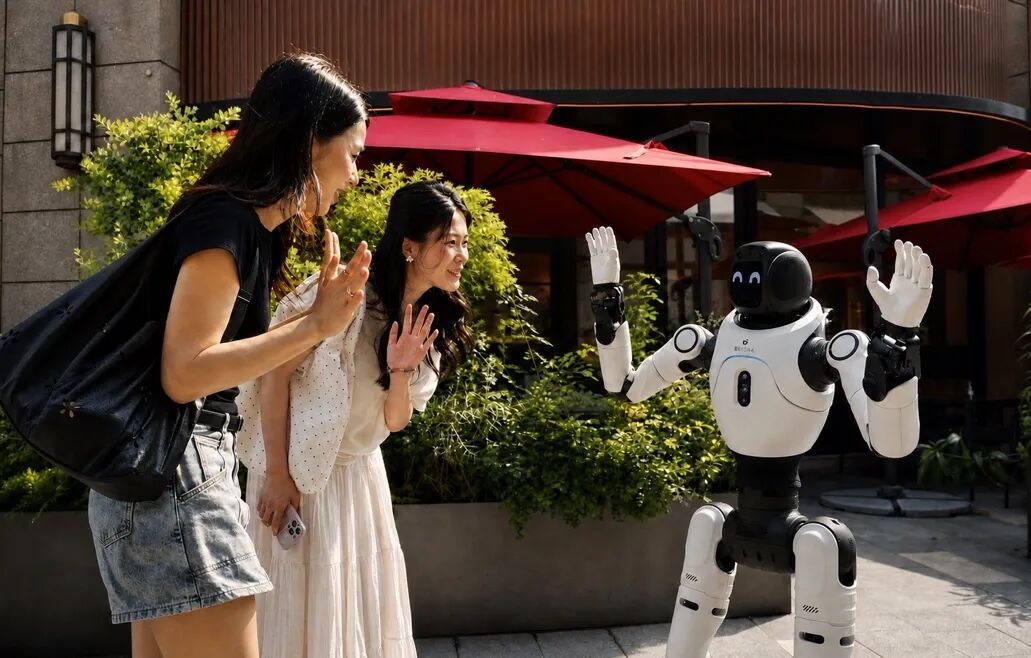
공식 설명에 따르면 WITA-Omni가 앞선 핵심 이유는 단순히 대화 모델을 로봇에 '탑재'한 것이 아니기 때문이다. 물리적 동작과 표정을 음성과 동급의 1차 출력으로 끌어올리고, 네이티브 엔드투엔드 모델 하나로 인식, 의사 결정, 표현을 통합 구동한다. 또한 Thinker–Talker 패러다임을 체화형 출력을 위한 Thinker–Talker–Actor 아키텍처로 한 단계 확장했다.
WITA-Omni의 우수성은 단순히 모델 규모에 의존한 것이 아니라, 체화형 멀티모달 상호작용을 중심으로 구축한 계층형 데이터 체계와 맞춤형 학습 방법에서 비롯됐다. 중간 학습 단계에서 WITA-Omni는 총 수천만 시간 규모의 오픈 소스 및 자체 보유 멀티모달 데이터를 사용해, 강력한 텍스트·시각 기반 모델을 '듣고, 보고 이해하며 음향과 영상을 함께 추론할 수 있는' 멀티모달 모델로 한 단계 발전시켰다.
또한 공개 음영상 데이터에는 일반적으로 실제 상호작용에서 발생하는 턴 전환, 응답 타이밍, 동작 및 표정 정보가 부족해 엔드투엔드 체화형 상호작용 모델을 직접 학습하기 어렵다. 이에 즈위안은 사람을 중심으로 실제 상호작용 장면을 겨냥한 대규모 고품질 멀티모달 데이터 세트를 구축하고, 소리, 화면, 언어, 동작, 표정 사이의 자연스러운 시계열 관계를 온전히 보존했다.