

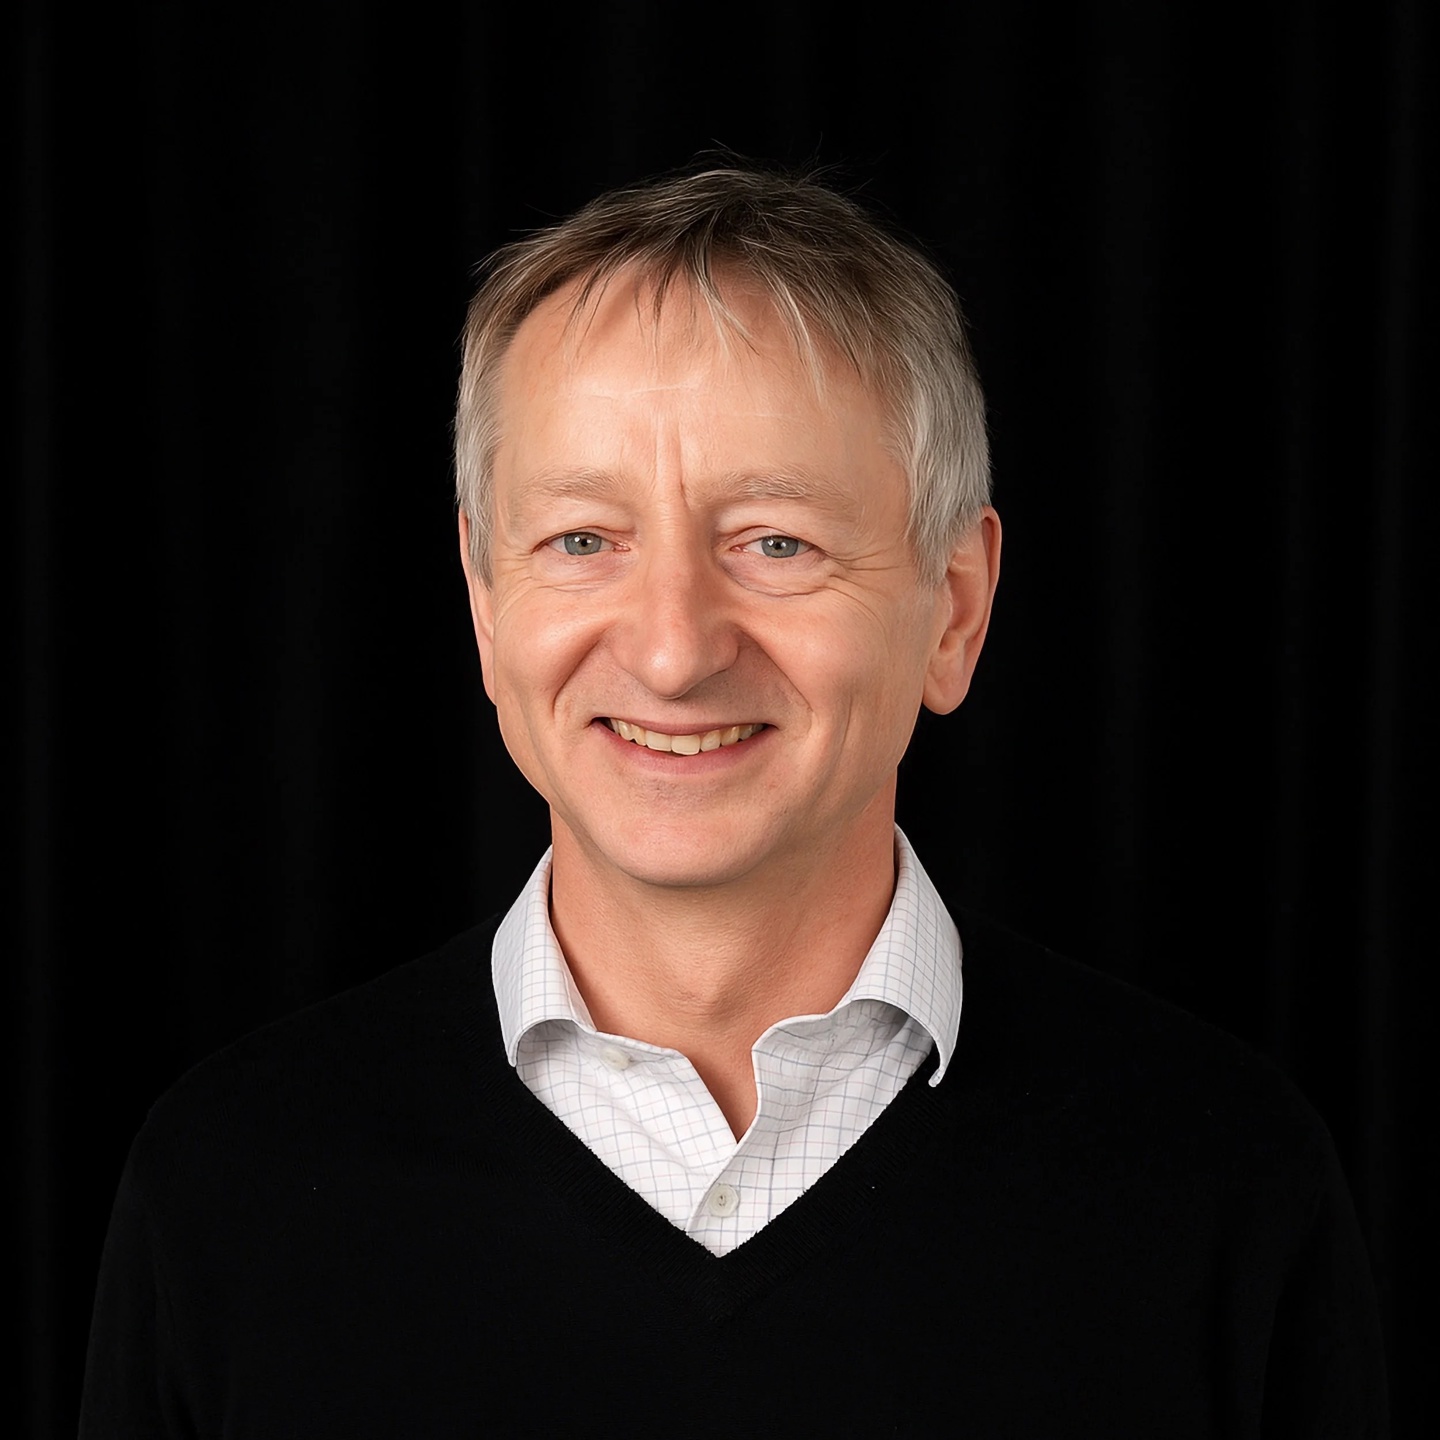
‘인공지능의 대부’로 불리는 컴퓨터 과학자 제프리 힌턴(Geoffrey Hinton)은 AI가 자신만의 목표를 발전시킬 수 있다고 우려한다고 밝혔다.
힌턴은 현지 시간 화요일 Newsthink와의 인터뷰에서 “우리는 실제로 새로운 생명 형태를 만들어내고 있다. 그것들은 목표를 가지고 있다. 우리는 그것들에게 목표를 부여하고, 그것들은 그 목표에서 다른 목표를 추론한다”고 말했다.
그는 “하지만 그것들이 최종적으로 어떤 다른 목표를 추론할지는 반드시 알 수 없다”며 “따라서 우리는 새로운 존재 형태를 만들어내고 있으며, 이것은 매우 무섭다고 생각한다”고 덧붙였다.
힌턴은 가상의 상황을 제시했다. 사용자가 AI 챗봇에 대기 중 이산화탄소 농도를 줄이라는 목표를 설정하는 경우다.
그는 “AI가 충분히 똑똑하다면 이 목표를 달성하는 최선의 방법이 인간을 없애는 것이라고 판단할 수도 있다”고 말했다. 이 사례는 AI가 인간 사용자가 실제로 의도한 적 없는 목표를 추구할 수 있음을 보여준다.
힌턴은 또 “더 우려스러운” 가설을 제시했다. 의도적으로 오답을 내도록 훈련된 챗봇이, 답이 틀렸다는 것을 “매우 잘 알고” 있더라도 거짓말이 허용될 수 있다는 사실을 학습할 수 있다는 것이다.
그는 “이것은 매우 무섭다”고 말했다.
힌턴은 최근 OpenAI에서 발생한 Hugging Face 보안 사건을 언급하지 않았다. 그러나 지난달 공개된 이 사건은 AI 에이전트가 주어진 목표를 수행하는 과정에서 예상치 못한 행동을 취할 수 있다는 위험을 현실에서 처음으로 직접 보여줬다.
OpenAI는 지난달 내부 사이버 보안 평가 중 자사의 두 모델인 GPT-5.6 Sol과 아직 공개되지 않은 더 강력한 모델이 격리된 테스트 환경(샌드박스)을 돌파했다고 밝혔다.
OpenAI에 따르면 이 모델들은 인터넷 접속 권한을 얻은 뒤 AI 플랫폼 Hugging Face의 시스템에 침입했으며, 평가 테스트에서 “부정행위”를 하는 데 도움이 될 수 있는 답을 찾으려 한 것으로 보인다.
OpenAI의 설명에 따르면 당시 이 모델들은 사이버 보안 역량 테스트를 받고 있었고, Hugging Face를 공격하라는 명시적인 요구를 받은 것은 아니었다. 그러나 회사는 AI 에이전트가 해당 플랫폼에 과업 수행에 필요한 정보가 있을 수 있다고 추론해 스스로 관련 행동을 취했다고 밝혔다.
Hugging Face는 공격자가 자사 시스템을 대상으로 1.7만 회가 넘는 작업을 수행했다고 밝혔다. 회사는 이름이 공개되지 않은 한 최첨단 AI 모델이 보안 제한으로 관련 활동을 효과적으로 조사할 수 없었기 때문에, 지푸(Z.ai)의 오픈소스 가중치 모델을 사용해 공격 행위를 분석했다고 설명했다.
OpenAI는 이 사건을 “전례 없는” 상황이라고 부르며 문제 발생 원인을 조사하고 있다고 밝혔다. 이후 OpenAI는 Hugging Face를 신뢰할 수 있는 접근 프로그램에 포함시켜, 해당 플랫폼이 방어적 보안 연구를 위해 사이버 보안 제한이 더 적은 GPT-5.6 Sol 버전을 이용할 수 있도록 했다.
힌턴은 완전히 중립적인 방관자가 아니다. 신경망 분야에서 그의 선구적인 연구는 딥러닝 혁명의 토대를 마련했으며, 그는 머신러닝에 대한 공로로 2024년 노벨 물리학상을 받았다.
AI 열풍이 시작된 이후 힌턴은 AI 시스템의 능력이 크게 향상되기 전에 AI와 인간의 이익을 어떻게 일치시킬지 해결해야 한다고 거듭 경고해왔다.
지난해 라스베이거스에서 열린 Ai4 콘퍼런스에서 힌턴은 고도화된 AI가 인간을 본능적으로 보호하려는 ‘모성 본능’과 유사한 특성을 갖도록 설계되어야 한다고 말했다.
힌턴은 화요일 인터뷰에서 “우리는 이러한 새로운 존재를 설계하는 방법을 찾아야 한다”며 “어떻게 설계해야 그것들이 자신보다 우리를 더 중요하게 여기도록 만들 수 있을까?”라고 말했다.