

화웨이는 오늘 5050억 개 파라미터의 openPangu-2.0-Pro 모델(모델 가중치, 기본 추론 코드)과 기술 보고서가 정식으로 오픈소스 공개됐다고 발표했다.
오픈소스 판구 openPangu는 화웨이의 오픈소스 AI 모델 브랜드로, 어센드(昇腾) 네이티브 학습 및 추론 기술을 통해 업계가 어센드를 활용할 수 있도록 최적의 실무 참고 사례를 제공하는 데 주력한다.
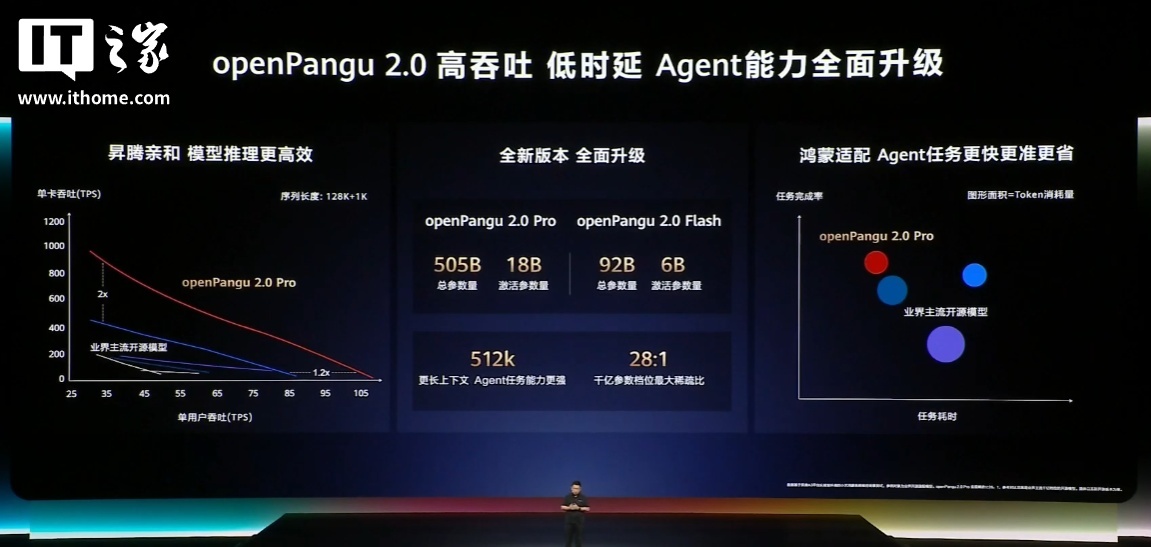
openPangu-2.0-Pro는 어센드 NPU로 학습한 대규모 혼합 전문가(MoE) 언어 모델로, 파라미터 규모는 약 505B이며 토큰당 활성화되는 파라미터 규모는 약 18B이다. 모델은 512k 컨텍스트 길이를 지원하며, 총 학습 데이터 규모는 약 34T tokens이다. 후속 학습 단계에서는 빠른 응답과 심층 추론을 통합한 미세 조정(SFT), 다중 분야 강화 학습(RL)을 완료했으며, 온라인 증류(OPD)를 통해 역량 통합을 구현했다.
openPangu-2.0-Pro는 모델 아키텍처를 전면적으로 업그레이드했다:
Attention 아키텍처: 고효율 MLA를 유지하면서 DSA+SWA 독립 계층형 혼합 아키텍처를 적용했으며, 계층 비율은 1:2다. SWA 계층은 로컬 윈도 모델링을 담당하고 DSA 계층은 희소 전역 집계를 담당해, 정확도를 유지하면서 긴 시퀀스 추론에 필요한 연산량, 메모리 및 메모리 접근 비용을 크게 줄인다.
토폴로지 아키텍처: 기존 잔차 연결을 4개 스트림의 mHC 아키텍처로 업그레이드해 표현의 다양성과 일반화 능력을 향상했다.
자기 추측 모듈: 3헤드 MTP 아키텍처를 적용해 한 번에 추가로 3개의 token을 예측하며, 모델 추론 속도를 크게 높인다.
Muon 옵티마이저: 학습 과정에 Muon 옵티마이저를 적용해 더 빠른 수렴 속도를 확보했다.
올해 6월 열린 화웨이 개발자 대회 HDC 2026 기조연설에서 화웨이 상무이사 겸 제품투자심의위원회 주임, 터미널 BG 이사회 의장인 위청둥은 openPangu 2.0이 6월 30일부터 7개 주요 구성 요소를 순차적으로 오픈소스 공개할 계획이라고 발표했다. 여기에는 새롭게 공개되는 사전 학습 코드, 후속 학습 코드, 학습 연산자가 포함된다.
6월 30일, 92B 파라미터의 openPangu-2.0-Flash 모델이 정식으로 오픈소스 공개됐다.
openPangu-2.0-Pro의 총 파라미터가 505B에 불과한 것과 관련해 위청둥은 연산 능력의 상당 부분이 중국 내 다른 기업의 수요를 지원하는 데 사용됐고 화웨이가 자체적으로 확보한 물량은 매우 제한적이라고 설명한 바 있다. 또한 AI 연산 비용이 매우 높기 때문에 화웨이는 지연 시간과 처리량 향상에 더욱 집중하고 있다고 밝혔다.
openPangu-2.0 모델 관련 구성 요소는 오픈소스 플랫폼에 순차적으로 공개되고 있으며, 오픈소스 주소는 다음과 같다:
https://ai.gitcode.com/ascend-tribe/openPangu-2.0-Pro