

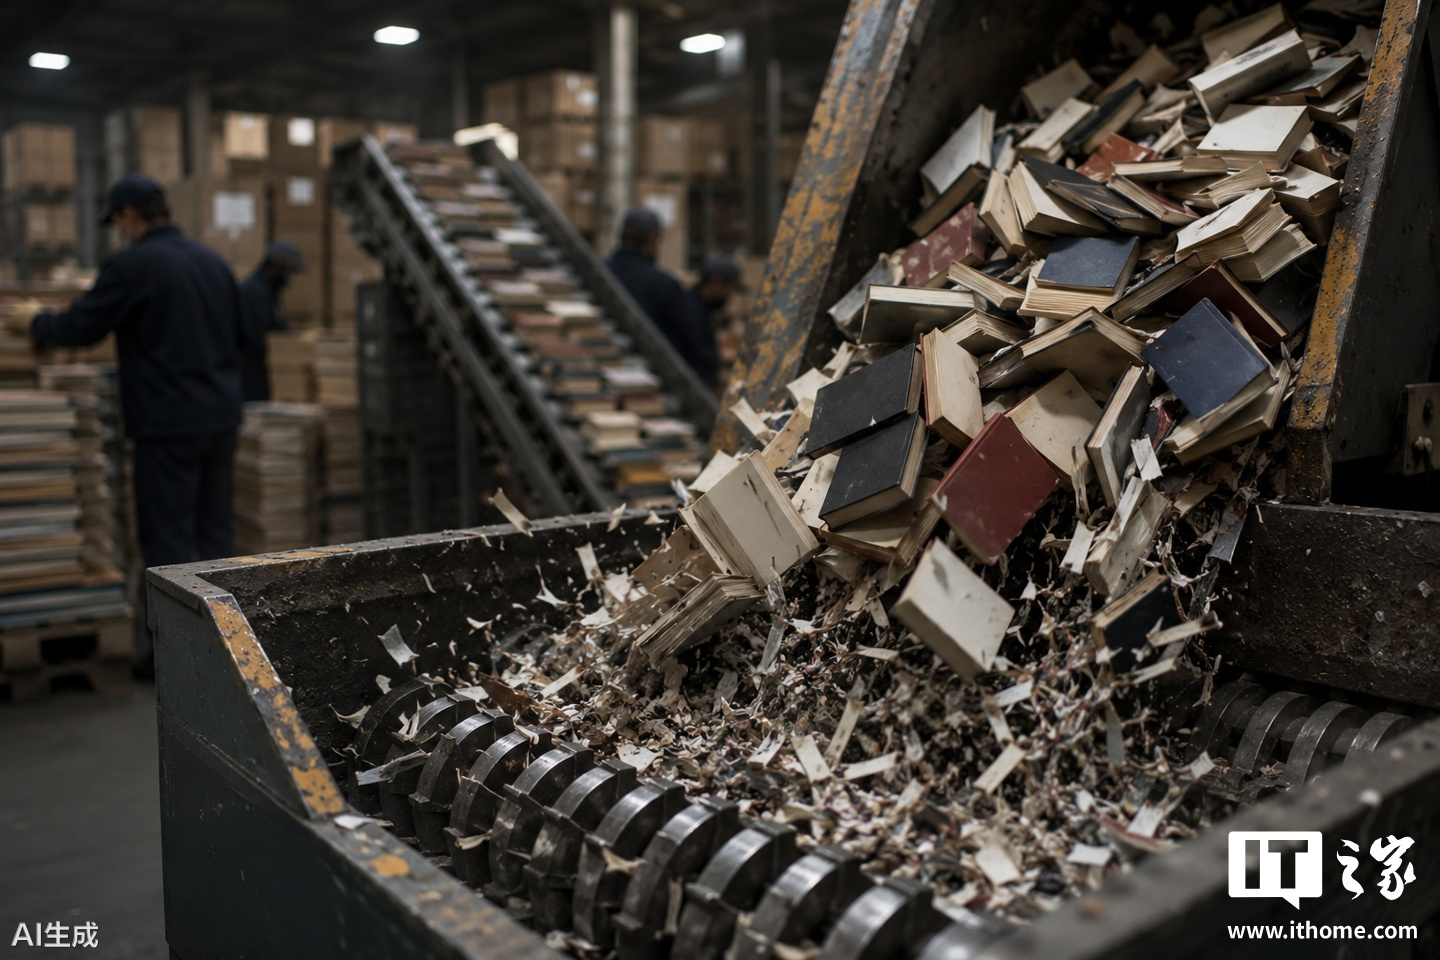
메모리와 스토리지 자원을 갈수록 부족하게 만든 AI 기업들이 이제는 인류의 문학 유산으로 시선을 돌린 것으로 보인다. 탐사 매체 404 Media의 최신 보도에 따르면, 여러 AI 기업이 여론의 반발을 피하는 동시에 AI 모델 학습에 사용할 고품질 학습 데이터를 확보하기 위해 중개업체를 통해 중고 도서를 대규모로 매입하고 있다.
AI의 발전에는 방대한 데이터가 필요하지만 모든 데이터가 가치 있는 것은 아니며, 핵심은 데이터의 품질이다. 최근 몇 년간 AI가 생성한 저품질 콘텐츠, 이른바 ‘AI 쓰레기 콘텐츠’가 인터넷을 가득 채우면서 데이터 환경을 오염시켰을 뿐 아니라 AI의 추가 학습 효과도 떨어뜨리고 있다. 이에 선도적인 AI 기업들은 인간이 만든 콘텐츠, 특히 2022년 이전에 출판된 종이책을 다시 찾기 시작했다. 이러한 콘텐츠는 독창적인 작품일 가능성이 높고 AI 생성 콘텐츠의 오염을 받지 않았을 가능성이 크기 때문이다.
사실 AI 기업이 종이책을 활용해 모델을 학습시킨 전례는 이미 있다. 현재 저작권 소송에 휘말린 주요 AI 기업 중 하나인 Anthropic은 수백만 달러를 들여 다량의 종이책을 구매하고, 그 내용을 추출해 Claude AI 모델을 학습시킨 뒤 해당 도서들을 폐기한 적이 있다. 이 회사는 Better World Books에서 대량으로 도서를 구매한 것으로 알려졌다. 법원은 정품 도서를 AI 학습에 사용하는 것이 저작권법상 ‘공정 이용’에 해당한다고 판단했지만, Anthropic은 700만 권의 불법 복제 도서가 포함된 데이터베이스를 장기간 보관해 저자와 출판사의 저작권을 침해한 혐의로 최종적으로 최대 15억 달러(참고: 현재 환율로 약 101.62억 위안)의 배상 판결을 받았다.
이와 유사한 논란은 Google에서도 발생했다. 최근 한 출판사 연합은 Google이 저작권 보호를 받는 수백만 권의 도서를 허가 없이 사용해 Gemini AI 모델을 학습시켰다며 소송을 제기했다.
1억 1,100만 권이 넘는 도서 목록 정보를 보유한 온라인 데이터베이스 ISBNdb는 오랫동안 서점, 도서관, 유통업체의 주요 플랫폼으로 활용돼 왔다. AI 산업이 빠르게 발전하면서 ISBNdb 역시 사업 방향을 조정해 AI 기업을 대상으로 한 대규모 도서 구매 서비스를 출시했다.
404 Media는 관련 주문 규모가 한 번에 1,000권을 구매하는 경우부터 한 번에 100만 권을 구매하는 경우까지 다양하다고 보도했다.
신원을 밝히지 않은 한 전문 서적상은 올해 4월 이후 도서 판매량이 전례 없이 증가했다고 밝혔다. 과거 장사가 잘될 때도 일주일에 약 20권을 판매하는 데 그쳤지만, 최근 몇 달 동안은 주간 판매량이 수백 권으로 급증해 평소의 약 다섯 배에 달했다.
Alibris와 Biblio 등 중고 도서 거래 플랫폼의 다른 서적상들도 비슷한 대량 구매 현상이 나타났다고 전했다.
현재 이러한 구매 행위가 반드시 ISBNdb나 특정 AI 기업에서 비롯됐다는 확실한 증거는 없지만, 이상 징후가 적지 않다. 예를 들어 대규모 구매 대상은 거의 모두 국제표준도서번호(ISBN)가 있는 도서였다. ISBN은 13자리 숫자로 구성된 전 세계 도서의 고유 식별 번호다.
또한 이러한 구매 행위에는 주제, 장르 또는 저자에 대한 선호가 거의 없었다. 소설, 교재, 전문 서적을 가리지 않고 구매 대상에 포함됐다. 더욱 놀라운 점은 구매자가 가격을 전혀 신경 쓰지 않는 듯했다는 것이다. 일부 도서가 시장 가격보다 훨씬 비싸도 그대로 구매했다.
Anthropic의 저작권 소송 과정에서 Google Books 프로젝트에 참여했고 이후 Anthropic의 ‘파나마 프로젝트(Project Panama)’ 디지털화 프로젝트를 담당했던 톰 하비(Tom Harvey)는 Anthropic이 종이책을 디지털화하기 위해 여러 전문 문서 스캔 업체를 고용했다고 증언했다.
협력 업체 중 하나는 Datamation Information Services로, 이 회사는 비파괴 스캔과 파괴적 스캔이라는 두 가지 도서 디지털화 서비스를 제공한다.
비파괴 스캔은 일반적으로 오버헤드 스캐너, 평판 스캐너 또는 V자형 스캔 장비를 사용해 책을 분해하지 않고 디지털화한다. 반면 파괴적 스캔은 책을 직접 해체한 뒤 각 페이지를 고속 산업용 스캐너에 넣어 처리한다.
파괴적 스캔은 효율이 더 높고 비용이 더 저렴하기 때문에 AI 기업들은 대체로 이 방식을 선택하며, 그 결과 수백만 권의 종이책이 해체돼 폐기됐다.
의심할 여지 없이 종이책은 AI에 거대한 지식의 보고다. 그러나 이러한 방식은 점점 더 많은 윤리적 논란도 불러일으키고 있다.
비판자들은 AI 기업이 디지털화 과정에서 일반 도서와 귀중한 도서, 절판 도서를 구분하는지 아직 분명하지 않다고 지적한다. 이러한 희귀 도서가 해체돼 폐기된다면 영원히 유통에서 사라질 수 있다.
더 큰 문제는 스캔된 콘텐츠가 결국 AI 기업의 사유 데이터베이스에 들어가 AI 학습에만 사용되고, 일반 대중은 이에 접근할 수 없다는 점이다.
이는 사람들이 더욱 지능적인 AI를 얻게 될 수도 있지만, 그 대가로 인류가 축적한 방대한 지식 자원이 공개되고 접근 가능한 형태로 미래 세대에 남지 않을 수 있다는 의미다.