

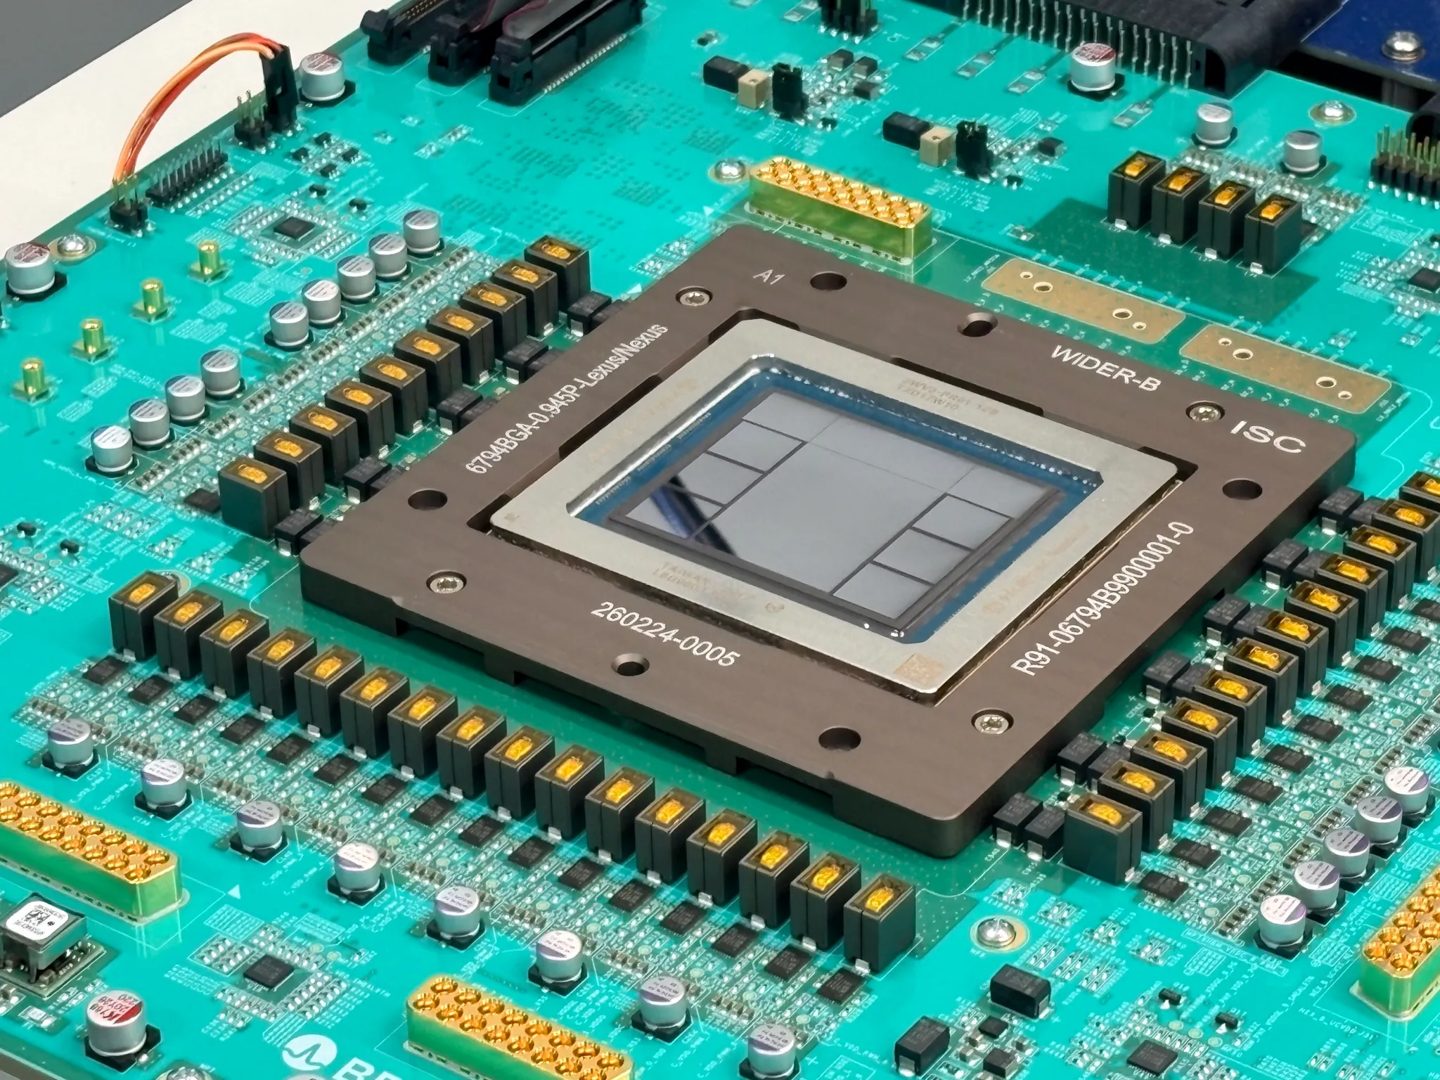
OpenAI는 오늘(25일) 저녁 Hot Chips 행사에서 새로운 추론 시스템 Jalapeño의 추가 세부 사항을 공개하고, 처음으로 벤치마크 테스트 결과를 발표했다. SemiAnalysis의 InferenceX 테스트에서 Jalapeño는 단일 사용자 토큰 처리량과 킬로와트당 처리량 모두 현재 시장의 최고급 추론 프로세서를 앞섰다.
OpenAI 하드웨어 책임자 리처드 허는 미디어 전화 회의에서 다음과 같이 밝혔다. “테스트 결과에서 가장 중요한 점은 Jalapeño가 현재 가장 앞선 제품보다 매우 크게 향상된 성능을 구현했다는 것입니다. 동일한 전력으로 더 많은 AI 워크로드를 처리하면서도 더 빠르게 응답할 수 있습니다. Jalapeño는 많은 사용자에게 효율적으로 서비스를 제공하는 동시에 매우 낮은 지연 시간을 유지할 수 있습니다.”
Jalapeño는 OpenAI와 브로드컴이 공동 개발했으며, OpenAI의 자체 모델도 연구개발에 참여했다. OpenAI는 Jalapeño를 여러 세대에 걸쳐 발전시킬 수 있는 기술 플랫폼으로 키우고, AI 제품·모델·칩·메모리를 처음부터 함께 설계하는 것을 목표로 한다.
이 칩은 주로 AI 추론을 담당한다. 즉, 이미 학습된 AI 모델을 실제로 실행해 작업을 수행하거나 AI 에이전트를 구동하는 역할이다.
OpenAI는 InferenceX 플랫폼을 사용해 Jalapeño의 추론 성능을 테스트하고, 엔비디아 GB200 및 GB300 슈퍼칩 시스템과 비교했다. OpenAI에 따르면 GPT-OSS 120B, DeepSeek R1, Kimi K2.5 1T 세 모델에서 Jalapeño가 와트당 처리할 수 있는 AI 워크로드는 비교 시스템의 1.5~1.9배였으며, 엔드투엔드 지연 시간은 비교 시스템의 약 28%~59%였다.
풀스택 공동 개발을 통해 OpenAI는 추론 과정에서 속도를 가장 쉽게 저하시키는 단계도 직접 최적화할 수 있었다. Jalapeño는 프리필과 통신 단계의 지연 시간을 줄이는 데 중점을 두었으며, OpenAI는 이 두 단계가 추론 성능의 주요 병목인 경우가 많다고 설명했다.
OpenAI는 테스트 결과를 공개한 블로그 게시물에서 Jalapeño가 설계 초기부터 데이터 이동과 통신 지연을 최대한 줄이도록 개발됐다고 밝혔다. 응답 생성에 사용되는 KV 캐시와 같은 모델 상태는 특정 위치에 저장해 로컬에 유지할 수 있으며, 시스템은 추론 단계에 따라 적절한 연산·메모리·네트워크 리소스를 배분한다.
IT之家의 취재에 따르면 OpenAI는 올해 말까지 Jalapeño를 먼저 “소규모”로 배치하고, 2027년부터 배치 규모를 점진적으로 확대할 계획이다. 다만 내년에 구체적으로 몇 개의 칩을 투입할지는 공개하지 않았다.
참고
OpenAI 공식 자료: Jalapeño’s first results show industry-leading speed and efficiency in AI inference