

알리바바 클라우드의 ‘ModelScope 커뮤니티’ 공식 위챗 계정은 어제(12일) 밤늦게 알리바바 Qwen 팀이 Qwen3.8-2.4T-A95B 모델 가중치를 공식 공개했다고 발표했다.
이번 공개는 Qwen-Max급 모델의 가중치를 처음으로 오픈소스화한 사례다. 모델의 총 매개변수는 2.4T이며, 각 Token에서 95B 매개변수가 활성화된다. 네이티브 262,144 Token 컨텍스트를 지원하고 최대 1,010,000 Token까지 확장할 수 있다.
Qwen3.8은 Qwen3.5의 혼합 아키텍처를 이어받았으며, 코딩, 사무, 연구 및 장기 Agent 작업의 엔드투엔드 완료 능력을 중점적으로 향상했다. 공식 클라우드 버전인 Qwen3.8-Max는 이 공개 가중치 모델을 기반으로 하며, 프로덕션 환경을 위한 기능을 추가했다.
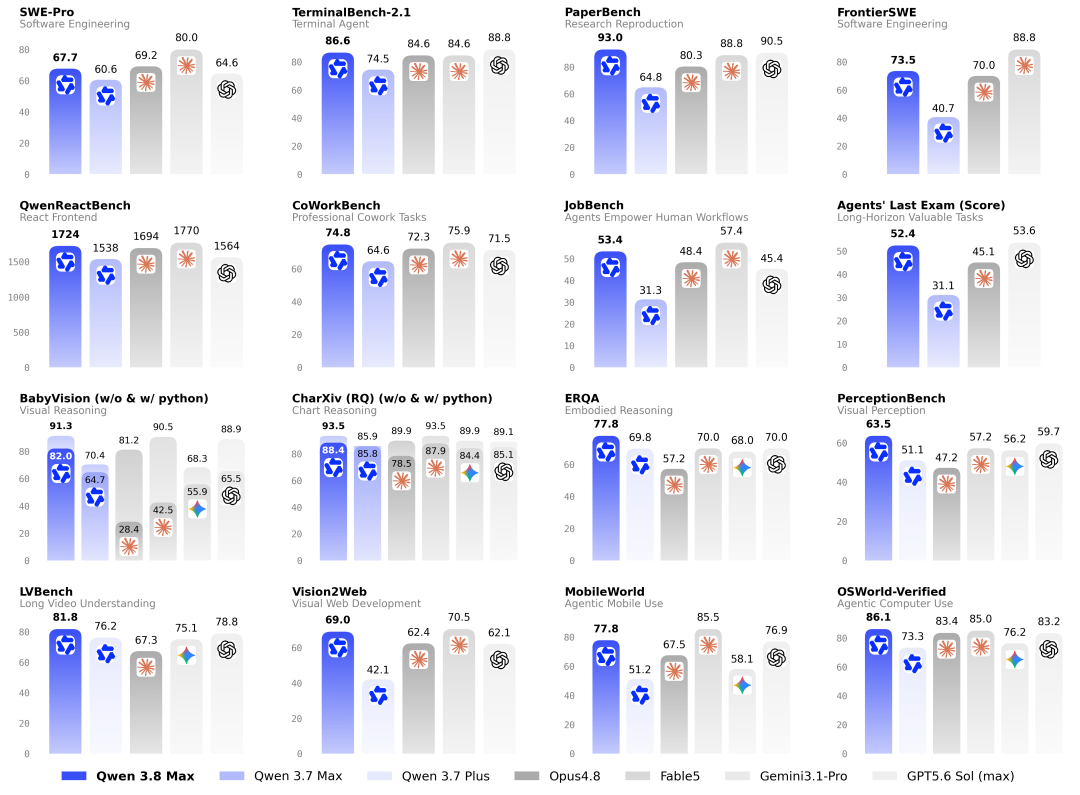
공식 평가에는 코딩 Agent, 범용 Agent, 전문 업무, 장문 컨텍스트 등의 항목이 포함됐다. Opus 4.8, Fable 5, GPT 5.6 Sol 등 모델과 비교해 항목별 결과는 엇갈렸으며, PaperBench와 IFBench 등의 Benchmark에서 비교 대상 모델 중 높은 성적을 거뒀다.
관련 링크는 다음과 같다:
모델: https://modelscope.cn/models/Qwen/Qwen3.8-2.4T-A95B
블로그: https://qwen.ai/blog?id=qwen3.8
Qwen Studio: https://chat.qwen.ai
Qwen3.8-2.4T-A95B는 인과 언어 모델로, 총 매개변수는 2.4T이며 각 Token에서 95B가 활성화된다. 모델의 각 MoE 레이어에는 512개의 전문가가 포함되며, 각 Token은 10개의 라우팅 전문가를 선택하고 동시에 1개의 공유 전문가를 활성화한다.
또한 모델은 다단계 MTP(Multi-Token Prediction) 학습을 진행해, 해당 메커니즘을 지원하는 추론 엔진에 여러 후속 Token을 예측하는 기능을 제공한다.
소개에 따르면 Qwen3.8-Max의 사무 및 Agent 후속 학습은 다음 세 단계로 요약된다:
실제 환경을 지속적으로 확장하고, 독립적인 차원에서 이를 분리한다. 차원에는 작업(Task)(단일 작업 → 다중 작업 → 여러 날에 걸친 작업), 작업 공간(Workspace)(다중 파일 → 계층형 디렉터리 → 복잡한 이기종 디렉터리), Harness(서로 다른 범주, 버전, 기술)가 포함된다. 이를 통해 환경 수가 일일이 맞춤형 통합에 의존하지 않고 조합 방식으로 자연스럽게 증가할 수 있다.
실제 작업에서 이기종 검증 방식을 내부화한 통합 보상 시스템을 구축한다. 이 시스템은 실행 기반 검증, 텍스트 및 렌더링된 시각적 출력에 대한 rubric 평가, agentic 검사를 포함한다. 다양한 형식과 모달리티를 하나의 보상 시스템으로 통합해 모든 환경에 일관되고 신뢰할 수 있는 보상 신호를 제공하고, 작업별 verifier 유지 관리에 inherent한 불일치를 제거한다.
온라인 데이터 균형 조정기를 구축해 각 batch를 재구성하고, 작업, 난이도, 작업 공간 및 harness의 분포를 고도로 균형 있게 만든다. 이를 통해 batch 간 그래디언트 분산을 낮추고, 강화 학습의 학습 연산 자원을 안정적이고 지속적으로 확장할 수 있도록 지원한다.