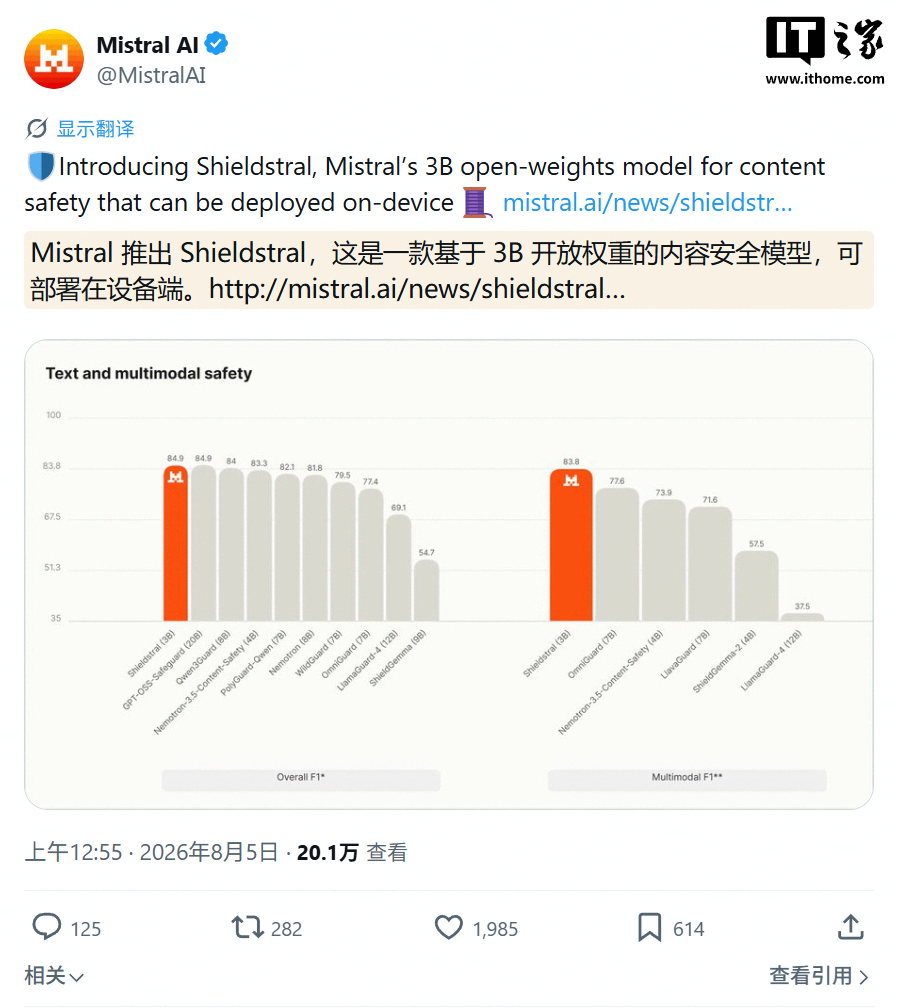
Mistral AI는 어제(8월 4일) Shieldstral 콘텐츠 검 moderation AI 모델을 출시한다고 발표했다. 총 매개변수는 3B(30억 개)이며, 오픈 웨이트 방식으로 Apache 2.0 라이선스에 따라 공개됐다.
이 모델은 Hugging Face 플랫폼에 출시됐으며 12개 언어를 지원하고, 단일 16GB GPU에서 실행할 수 있다. Mistral은 이 모델이 콘텐츠 안전성 측면에서 규모가 7배인 오픈 모델과 맞먹는 성능을 보이며, 멀티모달 콘텐츠 검 moderation 분야에서 SOTA를 달성했다고 밝혔다.
참고: SOTA는 state-of-the-art의 약자로, 특정 인공지능 작업이나 벤치마크 테스트에서 가장 뛰어난 성능과 최첨단 수준을 보이는 모델 또는 알고리즘을 의미한다. 기술의 발전과 새로운 연구의 발표에 따라 그 기준은 계속 변화한다.
Mistral은 대부분의 가드 모델이 유해성 카테고리 체계를 모델 가중치에 고정한다고 설명했다. 제품의 사용 시나리오를 변경하면 개발자는 일반적으로 모델을 다시 학습해야 한다.
반면 Shieldstral은 검 moderation 정책을 입력 내용에 포함한다. 운영자는 ‘예 또는 아니요’ 질문을 작성한 뒤 평가 상황과 엄격도 설명을 제공할 수 있으며, 모델은 단일 출력 토큰에서 보정된 안전성 점수를 생성한다.
이 모델은 각 검 moderation 작업을 이진 질의응답으로 변환하며, 입력에는 다음 3개의 레이블 필드가 포함된다.
<Instruct>: 평가 상황과 엄격도를 설명한다.
<Query>: ‘이 콘텐츠가 신체적 폭력을 조장하는가?’와 같은 단일 ‘예 또는 아니요’ 질문을 제시한다.
<Document>: 검 moderation 대상 콘텐츠를 제공한다. 프롬프트, 답변, 프롬프트와 답변의 조합 또는 선택적 텍스트가 포함된 이미지일 수 있다.
추론 시 모델은 ‘예’와 ‘아니요’ 두 토큰의 논리값만 읽은 뒤 softmax로 정규화해 연속 점수로 변환하고, 0.5를 임계값으로 이진 판단을 출력한다. 이 메커니즘은 프롬프트 분류, 답변 검 moderation, 거부 응답 감지 및 유해성 감지를 지원한다.