

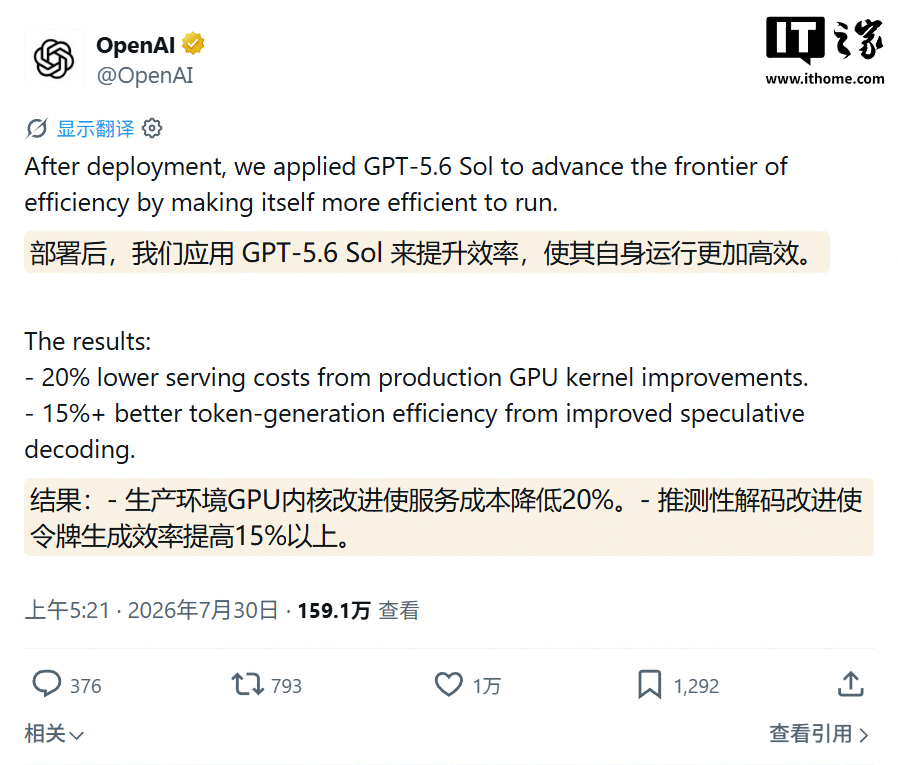
OpenAI는 어제(7월 29일) 게시글을 통해 GPT-5.6 Sol 모델로 GPT-5.6 시리즈 모델 자체의 AI 추론 과정을 최적화해 엔드투엔드 서비스 비용을 최대 20% 절감했다고 발표했다.
OpenAI는 7월 9일 자사의 최강 AI 모델인 GPT-5.6 시리즈를 출시했다. 이후 아키텍처를 최적화하는 과정에서 공식 팀은 GPT-5.6 Sol 모델을 활용해 자체 실행 효율을 높이고, 계산 비용을 낮추며, GPU 활용 효율을 개선했다.
OpenAI는 시스템이 지역, 가용 용량, 가속기 유형에 따라 요청을 할당한다고 밝혔다. 클러스터 내부에서는 부하, 컨텍스트 길이, 캐시 가용성 등의 요소도 고려해 작업을 분배한다. GPT‑5.6 Sol은 Codex를 통해 실제 운영 트래픽을 분석하고, 부하 불균형의 원인을 파악하며, 라우팅 전략을 테스트하고, 휴리스틱 규칙을 조정했다.
모델의 순전파 과정에서 GPT‑5.6 Sol은 미리 계산하거나 생략 또는 병렬 처리할 수 있는 작업을 식별하고, Codex를 통해 운영 환경의 GPU 커널을 자율적으로 다시 작성하고 최적화했다. 관련 스크린샷은 다음과 같다.
팀은 GPT-5.6 Sol 모델에 Triton과 Gluon이라는 두 프로그래밍 언어를 학습시켜 추론 엔진 커널을 최적화하도록 했다. 이에 따라 운영 환경의 GPU 커널이 엔드투엔드 서비스 비용을 최대 20% 낮췄다.
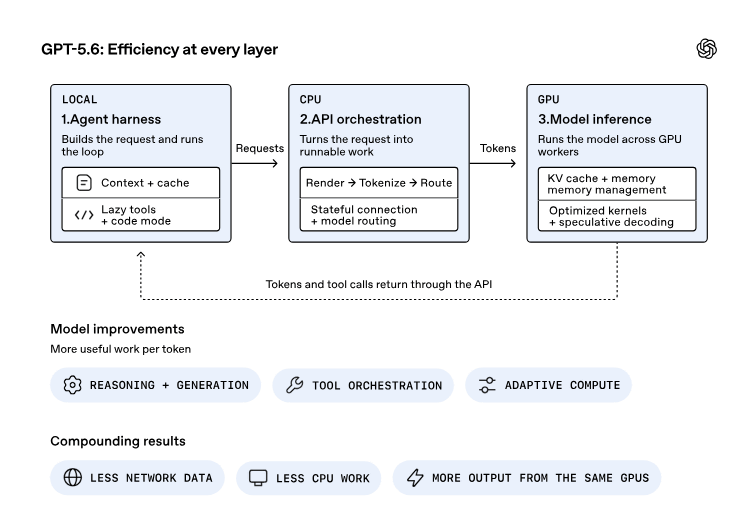
OpenAI는 오픈소스 도구 FpSan(부동소수점 정리기)을 사용해 GPT‑5.6 Sol이 작성한 커널의 정확성도 검증했다.
OpenAI는 GPT-5.6 Sol을 통해 추측 디코딩(speculative decoding)도 최적화했다. 이 추론 가속 기술은 더 작은 초안 모델이 다음 토큰을 예측한 뒤, 주 모델이 예측 결과를 검증하거나 수정하는 방식이다. OpenAI는 2026년 7월 29일 공개 게시글에서 개선 후 토큰 생성 효율이 15% 넘게 향상됐다고 밝혔다.