
도구, 뉴스 및 튜토리얼 찾기
게시된 모든 AI 콘텐츠를 한곳에서 탐색하세요.
“AI”이 카테고리의 결과 925개
AI 도구
925개발 플랫폼GLM-5.3-FlashXGLM-5.3-FlashX는 즈푸가 출시한 고속 추론 모델로, 최대 200 tokens/s의 출력 속도를 제공합니다. GLM-5.3-Flash보다 5배 빠르고 가격은 2.5배 높으며, API가 공개되었습니다. 이 모델은 10만 개의 중국산 칩 컴퓨팅... 개발 플랫폼DeepSeek V4.1 FlashDeepSeek V4 Flash는 DeepSeek가 출시한 경량 대규모 언어 모델로, 2025년 7월 31일 API를 통해 공개 베타를 시작했습니다. 빠른 속도와 비용 효율성을 앞세우며, 추론 속도는 초당 수백 tokens에 달하고, 비혼잡 시간대 캐시 적중 입력 비용은...3D 디자인KageKage는 디자이너 Meng To가 오픈 소스로 공개한 몰입형 3D 인터랙티브 경험 프로젝트입니다. 단일 HTML 파일만 사용해 Three.js로 실시간 렌더링하고 GPT Image 2로 생성한 장면 소재를 결합하여 가상의 교토 산...
 영업 리드 확보평점 8.5ApolloApollo는 영업, 영업 개발, 마케팅 및 매출 운영 팀을 위한 올인원 영업 플랫폼입니다. 공식 웹사이트에서는 연락처 데이터베이스, 데이터 보강, 아웃리치, 다이얼러, 고객 관계 관리 및 거래 관리 기능을 하나의 제품에 통합하고, 웹사이트 접속, Chrome 확장 프로그램 및 API 액세스를 제공합니다. 이를 통해 팀이 여러 영업 도구 사이를 전환하는 시간을 줄일 수 있습니다.
 3D 디자인Hunyuan3D-Buffalo 1.0 – 텐센트 혼위안이 출시한 3D 멀티모달 프레임워크Hunyuan3D-Buffalo 1.0 – 텐센트 혼위안이 출시한 3D 멀티모달 프레임워크는 공유 Hunyuan3D-VLM 백본을 통해 3D 질의응답, 공간 위치 지정, 텍스트 기반 3D 생성, 지시 기반 편집, 부품 생성을 하나의 흐름으로 통합한 프레임워크입니다. 자연어로 3D 모델 구조를 이해하고 부품을 식별하며, 지시에 따라 국소 형상을 수정하고, 의미 단위의 부품을 추출할 수 있습니다. 3D 이해·생성·편집의 선순환을 구축하여 게임, 애니메이션, 산업 디자인에 조합 가능한 3D 자산 제작 방식을 제공하는 것을 목표로 합니다. 핵심 기능은 3D 이해, 텍스트 기반 3D 생성, 지시 기반 편집, 부품 생성이며, 네 가지 작업은 동일한 3D 의미 표현과 처리 파이프라인을 공유합니다. 게임 개발자, 애니메이션 제작자, 산업 디자이너 및 3D 콘텐츠 크리에이터에게 적합하며, 자연어 상호작용으로 전문 지식의 진입 장벽을 낮추고 자산 재사용 및 반복 작업의 효율을 높입니다.
 애니메이션 제작Wan-Animate-2 – Wan-Animate 팀이 오픈 소스로 공개한 차세대 캐릭터 애니메이션 모델Wan-Animate-2는 Wan-Animate 팀이 오픈 소스로 공개한 차세대 캐릭터 애니메이션 모델입니다. Wan-Animate의 대규모 아키텍처 업그레이드 버전으로, 엔드투엔드 이중 분기 DiT를 사용해 명시적인 포즈 골격 없이도 참조 영상에서 동작 사전 정보를 포착합니다. 구동 영상의 캐릭터 애니메이션 변환, 정체성 및 외관 유지, 텍스트 기반 시점 제어를 지원하며, 고품질 Base 모드와 저스텝 Distillation 모드라는 두 가지 추론 모드를 제공합니다. 또한 실시간 스트리밍 캐릭터 애니메이션을 위해 Lite 변형 모델도 출시되었습니다. 이 모델은 버추얼 스트리머, 숏폼 영상 제작, 디지털 휴먼 등 다양한 애플리케이션에 적합하며, 동작 충실도와 정체성 일관성을 동시에 높이고 생성 지연 시간을 줄이는 것을 목표로 합니다.
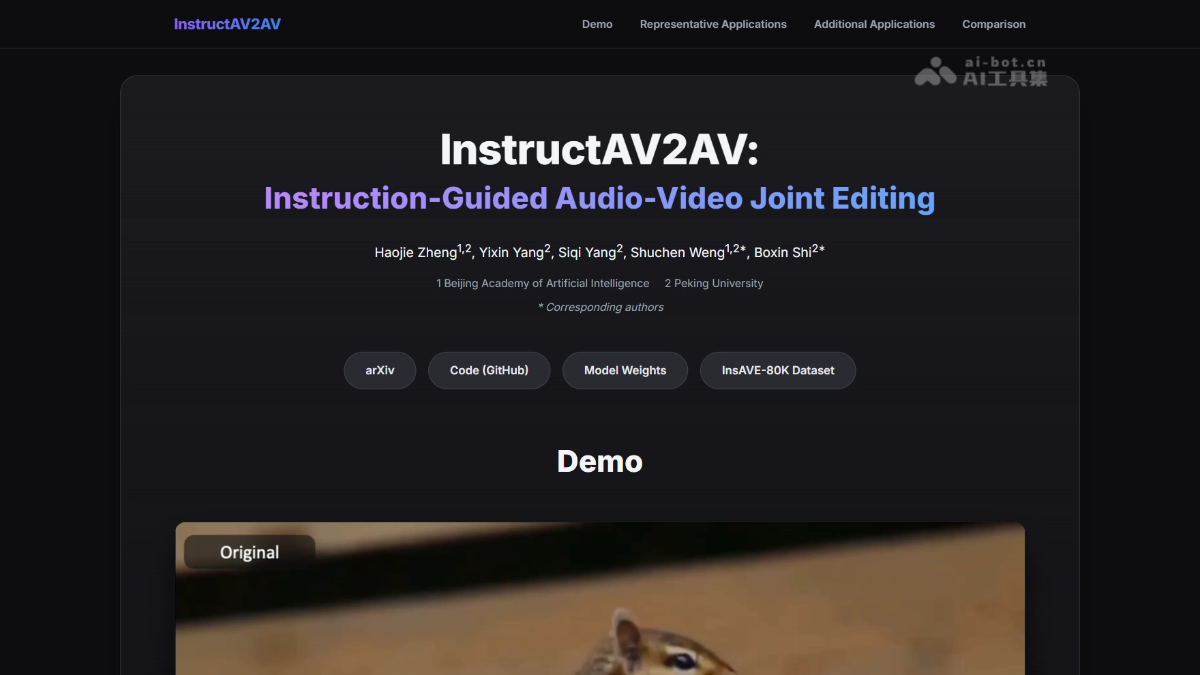 이미지 편집InstructAV2AV – 즈위안과 베이징대학교가 공동 오픈소스로 공개한 음영상 통합 편집 모델InstructAV2AV – 즈위안과 베이징대학교가 공동 오픈소스로 공개한 음영상 통합 편집 모델은 베이징 즈위안 인공지능 연구원과 베이징대학교가 공동으로 선보인 음영상 통합 편집 모델입니다. 사용자는 자연어 명령 한 문장만으로 엔드투엔드 생성 과정에서 영상 화면과 해당 음성을 동시에 편집할 수 있으며, 수동 마스크나 단계별 처리도 필요하지 않습니다. 이 모델은 대사 수정, 인물 교체, 객체 삽입 및 삭제를 지원하고 배경음과 환경음을 그대로 유지하면서 영상과 음성의 시간적 동기화를 유지할 수 있습니다. 핵심 기능으로는 정체성 보존 음성 수정, 음영상 인스턴스 교체, 인스턴스 삽입, 인스턴스 제거 및 속성 조합 편집이 있으며, 영화·영상 후반 작업, 숏폼 제작, 가상 인간 운영, 광고 기획 및 인터랙티브 콘텐츠 제작 등의 분야에 활용할 수 있습니다.
개발 플랫폼DeepSeek V4.1 FlashDeepSeek V4 Flash는 DeepSeek가 출시한 경량 대규모 언어 모델로, 2025년 7월 31일 API를 통해 공개 베타를 시작했습니다. 빠른 속도와 비용 효율성을 앞세우며, 추론 속도는 초당 수백 tokens에 달하고, 비혼잡 시간대 캐시 적중 입력 비용은...3D 디자인KageKage는 디자이너 Meng To가 오픈 소스로 공개한 몰입형 3D 인터랙티브 경험 프로젝트입니다. 단일 HTML 파일만 사용해 Three.js로 실시간 렌더링하고 GPT Image 2로 생성한 장면 소재를 결합하여 가상의 교토 산...영업 리드 확보평점 8.5ApolloApollo는 영업, 영업 개발, 마케팅 및 매출 운영 팀을 위한 올인원 영업 플랫폼입니다. 공식 웹사이트에서는 연락처 데이터베이스, 데이터 보강, 아웃리치, 다이얼러, 고객 관계 관리 및 거래 관리 기능을 하나의 제품에 통합하고, 웹사이트 접속, Chrome 확장 프로그램 및 API 액세스를 제공합니다. 이를 통해 팀이 여러 영업 도구 사이를 전환하는 시간을 줄일 수 있습니다.3D 디자인Hunyuan3D-Buffalo 1.0 – 텐센트 혼위안이 출시한 3D 멀티모달 프레임워크Hunyuan3D-Buffalo 1.0 – 텐센트 혼위안이 출시한 3D 멀티모달 프레임워크는 공유 Hunyuan3D-VLM 백본을 통해 3D 질의응답, 공간 위치 지정, 텍스트 기반 3D 생성, 지시 기반 편집, 부품 생성을 하나의 흐름으로 통합한 프레임워크입니다. 자연어로 3D 모델 구조를 이해하고 부품을 식별하며, 지시에 따라 국소 형상을 수정하고, 의미 단위의 부품을 추출할 수 있습니다. 3D 이해·생성·편집의 선순환을 구축하여 게임, 애니메이션, 산업 디자인에 조합 가능한 3D 자산 제작 방식을 제공하는 것을 목표로 합니다. 핵심 기능은 3D 이해, 텍스트 기반 3D 생성, 지시 기반 편집, 부품 생성이며, 네 가지 작업은 동일한 3D 의미 표현과 처리 파이프라인을 공유합니다. 게임 개발자, 애니메이션 제작자, 산업 디자이너 및 3D 콘텐츠 크리에이터에게 적합하며, 자연어 상호작용으로 전문 지식의 진입 장벽을 낮추고 자산 재사용 및 반복 작업의 효율을 높입니다.애니메이션 제작Wan-Animate-2 – Wan-Animate 팀이 오픈 소스로 공개한 차세대 캐릭터 애니메이션 모델Wan-Animate-2는 Wan-Animate 팀이 오픈 소스로 공개한 차세대 캐릭터 애니메이션 모델입니다. Wan-Animate의 대규모 아키텍처 업그레이드 버전으로, 엔드투엔드 이중 분기 DiT를 사용해 명시적인 포즈 골격 없이도 참조 영상에서 동작 사전 정보를 포착합니다. 구동 영상의 캐릭터 애니메이션 변환, 정체성 및 외관 유지, 텍스트 기반 시점 제어를 지원하며, 고품질 Base 모드와 저스텝 Distillation 모드라는 두 가지 추론 모드를 제공합니다. 또한 실시간 스트리밍 캐릭터 애니메이션을 위해 Lite 변형 모델도 출시되었습니다. 이 모델은 버추얼 스트리머, 숏폼 영상 제작, 디지털 휴먼 등 다양한 애플리케이션에 적합하며, 동작 충실도와 정체성 일관성을 동시에 높이고 생성 지연 시간을 줄이는 것을 목표로 합니다.이미지 편집InstructAV2AV – 즈위안과 베이징대학교가 공동 오픈소스로 공개한 음영상 통합 편집 모델InstructAV2AV – 즈위안과 베이징대학교가 공동 오픈소스로 공개한 음영상 통합 편집 모델은 베이징 즈위안 인공지능 연구원과 베이징대학교가 공동으로 선보인 음영상 통합 편집 모델입니다. 사용자는 자연어 명령 한 문장만으로 엔드투엔드 생성 과정에서 영상 화면과 해당 음성을 동시에 편집할 수 있으며, 수동 마스크나 단계별 처리도 필요하지 않습니다. 이 모델은 대사 수정, 인물 교체, 객체 삽입 및 삭제를 지원하고 배경음과 환경음을 그대로 유지하면서 영상과 음성의 시간적 동기화를 유지할 수 있습니다. 핵심 기능으로는 정체성 보존 음성 수정, 음영상 인스턴스 교체, 인스턴스 삽입, 인스턴스 제거 및 속성 조합 편집이 있으며, 영화·영상 후반 작업, 숏폼 제작, 가상 인간 운영, 광고 기획 및 인터랙티브 콘텐츠 제작 등의 분야에 활용할 수 있습니다.