
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-11-05
01OmniEdu란 무엇인가
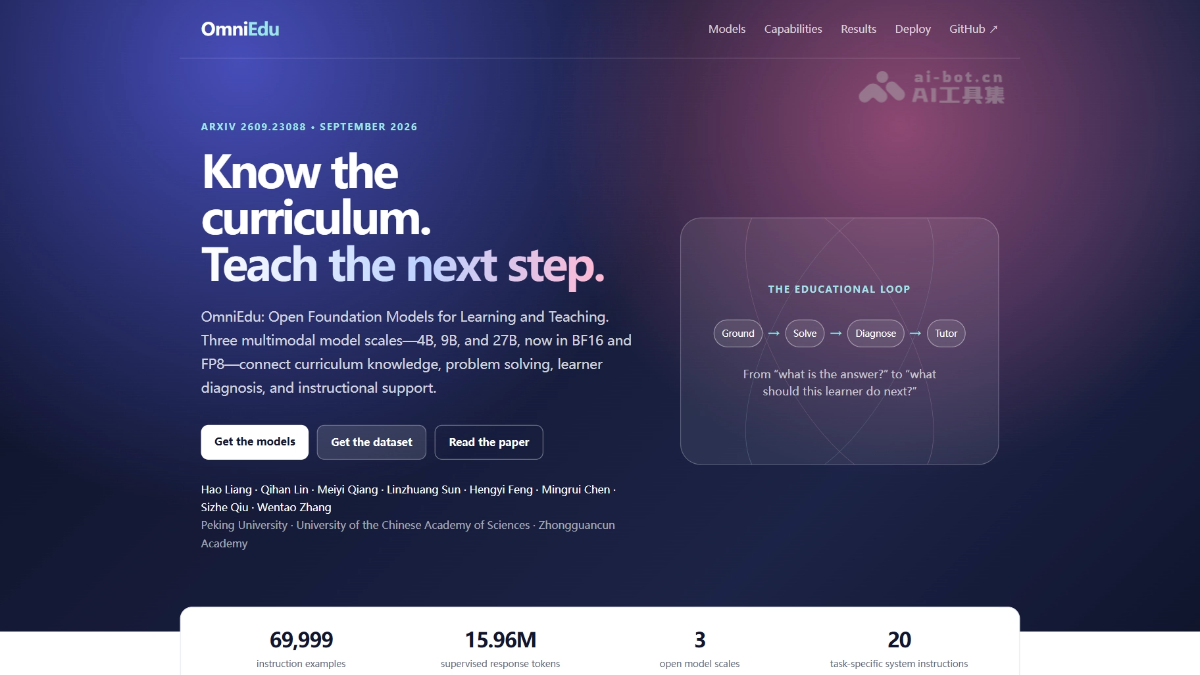
OmniEdu는 베이징대학교 DCAI 팀이 중국과학원대학교, 중관춘학원과 공동으로 오픈 소스화한 교육 멀티모달 모델 시리즈로, 27B, 9B, 4B의 세 가지 규모를 제공합니다. OmniEdu는 교육 능력을 중시하며, 교과 문제를 풀고 지식 포인트의 교육과정상 위치를 판단하고 학생의 오답 원인을 진단하며 적절한 교육 행동을 선택할 수 있습니다. 팀은 134만 건의 후보 데이터에서 약 6.9만 개의 샘플을 엄선해 학습에 사용했으며, 그 결과 모델은 여러 과목, 진단 및 지도 과제에서 SOTA 수준에 도달했습니다. 이 중 4B 소형 모델은 일반 서버에 배포할 수 있어 학교의 사용 문턱을 낮춥니다.
02OmniEdu의 주요 기능
교과 문제 풀이: 수학, 과학, 독해와 작문을 포괄하며, 정답을 제시하고 설명이 문제 조건 및 추론 과정과 일치하도록 합니다.
교육과정 이해: 문제에 해당하는 지식 포인트, 학년, 난이도와 선수 관계를 식별하고, 학습을 계속하기 전에 무엇을 보충해야 하는지 판단합니다.
진단 추론: 학생의 풀이 과정과 오답을 바탕으로 오류가 발생한 단계, 이해의 편차 및 보충이 필요한 지식을 찾아내며, 단순히 문제만 보고 추측하지 않습니다.
교육 행동: 과제에 따라 적절한 응답 방식을 선택하며, 힌트, 유도 질문, 선수 개념 복습, 오류 지적 또는 전체 설명을 포함합니다.
03OmniEdu의 기술 원리
WeChat에서 “开源”를 검색해 AI 오픈 소스 프로젝트交流群에 참여하세요.
과제 목표 기반 데이터 설계: 학습 데이터는 약 134만 개의 후보 샘플을 정제, 의미 검토, 품질 평가 및 다양성 선별 과정을 거쳐 약 6.9만 개로 추렸습니다. 각 교육 샘플은 네 가지 능력으로 분류하고 20가지 과제 지시 중 하나를 할당했습니다. 이를 통해 “샘플이 무엇을 가르치는가”와 “모델이 어떻게 응답해야 하는가”를 분리해 주석 처리하여, 모델이 과제에 따라 행동을 전환할 수 있도록 했습니다.
의미 검토 및 재작성: 언어 모델을 사용해 과제 기준에 따라 샘플을 검토하고, 문제 풀이의 정확성, 교육과정 관계, 진단 근거와 스캐폴딩 품질을 확인합니다. 기준에 미달하는 경우 지도 답변을 재작성한 뒤 다시 검토하며, 멀티모달 샘플의 이미지와 텍스트 일치 여부도 확인합니다. 동시에 출처의 라이선스 정보를 보존하고 규정을 준수하지 않는 출처는 제외합니다.
오염 제거 및 구조 통일: 메시지 형식을 통일하고 중복되거나 필드가 누락되었거나 구조가 손상된 샘플을 삭제합니다. 검증 가능한 과제의 답을 확인하고 학습 데이터와 평가 세트의 중복을 제거해 결과 왜곡을 방지합니다.
token 예산에 따른 학습 비율 균형: 긴 지도 대화는 짧은 답변보다 더 많은 지도 token을 포함하므로, 샘플 수를 기준으로 추출하면 긴 대화의 비중이 지나치게 커집니다. 과제 버킷별로 token 예산을 배분하고 핵심 차원의 기준을 높여 다양성을 선별함으로써 각 교육 과제가 실제로 받는 지도량을 제어합니다.
04OmniEdu 사용 방법
방법 1: 로컬 실행(Transformers) 의존성 설치: pip install -U torch torchvision transformers accelerate safetensors pillow를 실행합니다(FP8 가중치는 compressed-tensors를 추가로 설치해야 합니다).
모델 로드: AutoProcessor와 Qwen3_5ForConditionalGeneration.from_pretrained를 사용해 해당 모델 ID(예: lhpku20010120/Omni-Edu-4B)를 로드합니다(9B/27B는 ID만 변경하면 됩니다).
입력 구성: 학생의 문제, 풀이 또는 이미지를 chat 템플릿에 맞춰 messages로 구성하고, 이미지 문제에는 {"type": "image"} 항목을 추가합니다.
응답 생성: generate를 호출할 때 반드시 enable_thinking=False로 설정하고, batch_decode로 출력 결과를 디코딩합니다.
방법 2: 서비스 배포(vLLM, 권장) 서비스 시작: vllm serve lhpku20010120/Omni-Edu-4B --max-model-len 32768 --reasoning-parser qwen3 --default-chat-template-kwargs '{"enable_thinking": false}'를 실행합니다(FP8 버전은 Omni-Edu-4B-FP8을 사용하고, 다중 GPU 환경에서는 --tensor-parallel-size를 조정합니다).
요청 전송: curl을 통해 http://localhost:8000/v1/chat/completions에 접속하고 OpenAI 호환 형식으로 질문하면 됩니다.
방법 3: 공식 툴킷 사용 SDK 설치: pip install omniedu를 실행합니다(평가에는 omniedu[eval]을 설치해야 합니다).
대화 호출: OmniEdu.from_pretrained("4B", base_url=서비스 주소) 호출 후 model.chat(text=...)을 사용해 질문합니다.
평가 비교: omniedu eval --list를 사용해 12개의 교육 평가 벤치마크를 확인하고 보고서를 생성합니다.
05OmniEdu의 핵심 장점
과제 지시에 따른 행동 전환: 20가지 시스템 지시를 통해 동일한 모델이 과제에 따라 단계별 문제 풀이, 오류 진단, 소크라테스식 질문, 지도 대화 등 서로 다른 응답 방식을 구분할 수 있습니다.
정교하게 설계된 고품질 학습 데이터: 약 134만 개의 후보 샘플에서 의미 검토, 오염 제거, token 비율 균형을 거쳐 약 7만 개를 엄선했으며, “무엇을 배울지”와 “어떻게 가르칠지”를 명확히 구분했습니다.
SOTA급 성능: 27B는 GPT-5.4, Claude-Opus-5 등 5개 최첨단 모델과 60회 비교에서 51회 승리했으며, 여러 교육 지표에서 1위를 차지했습니다.
스캐폴딩 교육의 뚜렷한 향상: MathTutorBench의 스캐폴딩 승률이 최고 14%에서 78.74%로 상승하여, 교육 행동을 효과적으로 학습시킬 수 있음을 입증했습니다.
다양한 규모로 여러 환경에 대응: 4B, 9B, 27B를 모두 제공하며, FP8 버전은 다운로드 용량을 37%–44% 줄였습니다. 소형 모델은 학교의 일반 서버에도 배포할 수 있습니다.
06OmniEdu 프로젝트 주소
프로젝트 공식 웹사이트: https://haolpku.github.io/Omni-Edu/
GitHub 저장소: https://github.com/haolpku/Omni-Edu
HuggingFace 모델 저장소: https://huggingface.co/datasets/lhpku20010120/Omni-Edu
arXiv 기술 논문: https://arxiv.org/pdf/2609.23088
07OmniEdu의 활용 시나리오
개인 맞춤형 학습 지도: 학생이 문제를 풀 때 모델이 먼저 막힌 지점을 파악한 다음 힌트와 추가 질문으로 독립적인 사고를 유도하여 자기주도 학습 환경에 적합합니다.
오답 진단 분석: 교사가 학생의 풀이 과정을 모델에 입력하면 오답 원인과 관련 지식의 결손을 자동으로 분석하고 맞춤형 보완 방안을 생성하여 채점 부담을 줄입니다.
교육과정 연계 콘텐츠 생성: 교사가 지정한 교육과정 기준과 학년에 맞춰 연습 문제, 수준별 과제 또는 설명 자료를 생성하고 지식 포인트의 분류 및 선수 관계를 자동으로 표시합니다.
수업 상호작용 보조교사(소크라테스식 교육): 모델이 보조교사 역할을 맡아 유도 질문으로 학생의 추론을 촉진하고, 근거에 따라 교육 전략을 조정하며 수준별 수업을 지원합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0