
- 월간 방문 수
- 0
- 가격
- 무료 및 유료
- 등록일
- 2026-07-27
- 업데이트됨
- 2026-08-25
01FLUX 3 소개
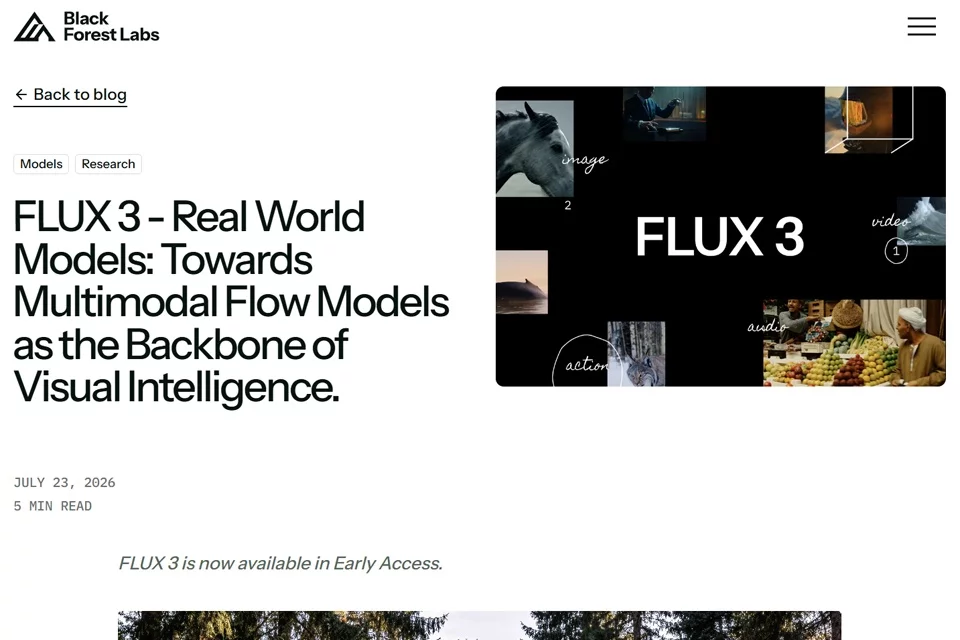
FLUX 3는 단일 이미지 생성 도구가 아니라 이미지, 비디오, 오디오를 동시에 처리하는 통합 멀티모달 모델입니다. 텍스트나 참고 이미지·비디오를 바탕으로 콘텐츠를 생성할 수 있으며, 오디오가 포함된 비디오 생성, 비디오 편집, 동작 예측도 지원합니다. 현재 제품은 Early Access 단계이며, 공식적으로 비디오, 이미지 및 관련 모델 기능을 단계적으로 공개하고 있습니다.
02FLUX 3 대상 사용자
비디오 콘텐츠 제작자
텍스트, 이미지 또는 비디오를 참고해 네이티브 오디오가 포함된 비디오를 생성하고, 키프레임, 이어쓰기, 비디오 변환을 통해 콘텐츠의 변화를 제어할 수 있습니다.
이미지 디자인 및 편집 사용자
모델을 활용해 이미지를 합성하고 편집하며, 복잡한 프롬프트, 다양한 시각 스타일, 화면 비율 및 다국어 텍스트 콘텐츠를 처리할 수 있습니다.
AI 제품 개발팀
공식 API를 통해 이미지, 비디오, 오디오 생성 및 편집 기능을 개발 중인 콘텐츠 제작 또는 시각 지능 제품에 통합할 수 있습니다.
선정된 로봇 연구 및 상업 파트너
공식 협력 범위 내에서 동작 예측과 비디오 기반 모델 미세 조정 기능을 활용해 정교한 조작 및 생산 환경 배포 시나리오를 탐색할 수 있습니다.
03FLUX 3 주요 기능
텍스트-비디오 생성
텍스트 프롬프트를 입력해 최대 약 20초 길이의 네이티브 오디오 포함 비디오를 생성할 수 있으며, 다양한 스타일과 화면 비율의 동적 콘텐츠를 빠르게 제작하는 데 적합합니다.
참고 이미지-비디오 생성
시작 화면이나 시각적 참고 이미지를 제공해 비디오를 생성할 수 있으며, 이미지 애니메이션, 화면 확장 또는 주요 대상의 시각적 특징 유지에 활용할 수 있습니다.
비디오 변환
참고 비디오를 업로드해 원본 비디오의 핵심 요소를 새로운 장면이나 맥락에 적용할 수 있으며, 콘텐츠 재구성과 스타일 변환에 적합합니다.
비디오 및 오디오 이어쓰기
입력된 비디오와 오디오를 바탕으로 이후 콘텐츠를 계속 생성해 화면의 전개와 음성 정보를 함께 이어갈 수 있습니다.
키프레임-비디오 변환
여러 개의 정의된 주요 시점을 제공해 서로 다른 상태를 연결하는 비디오를 생성할 수 있으며, 장면 변화와 전환을 더욱 세밀하게 설계할 수 있습니다.
이미지 합성 및 편집
텍스트 프롬프트나 참고 콘텐츠를 바탕으로 이미지를 생성하고 수정할 수 있으며, 다양한 스타일, 화면 비율, 해상도 및 다국어 텍스트 표현을 지원합니다.
다국어 대사 생성
비디오 생성 과정에서 다국어 대사를 처리해 인물의 표현, 화면 콘텐츠, 음성 생성을 하나의 비디오 결과물로 결합할 수 있습니다.
동작 예측
세계와 동적 규칙에 대한 모델의 이해를 바탕으로 동작을 예측하며, 전용 모델을 통해 로봇의 정교한 조작 작업도 탐색할 수 있습니다.
04FLUX 3 제품 특징
통합 멀티모달 아키텍처
모델은 동일한 아키텍처에서 이미지, 비디오, 오디오를 함께 학습하며, 서로 다른 센서가 얻은 정보를 동일한 현실을 보완하는 증거로 취급합니다.
비디오 네이티브 오디오 생성
비디오 생성 결과에 네이티브 오디오가 함께 포함되며, 단순히 무음 화면을 생성하는 것이 아니라 소리와 화면 속 물리적 사건을 연결할 수 있습니다.
콘텐츠와 동작 역량의 연결
동일한 멀티모달 기반 모델이 콘텐츠 제작과 동작 예측을 동시에 지원해 비디오 이해, 동적 모델링 및 물리 지능 연구를 위한 공통 기반을 제공합니다.
멀티숏 연속 제작
공식 소개에 따르면 지능형 에이전트를 통해 독립적인 장면을 연결해 더 긴 멀티숏 시퀀스를 구성할 수 있으며, 시각적 참고 자료를 활용해 캐릭터의 일관성을 유지할 수 있습니다.
05정보 출처
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0