
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-10-09
01Naive-N0.5-Flash란
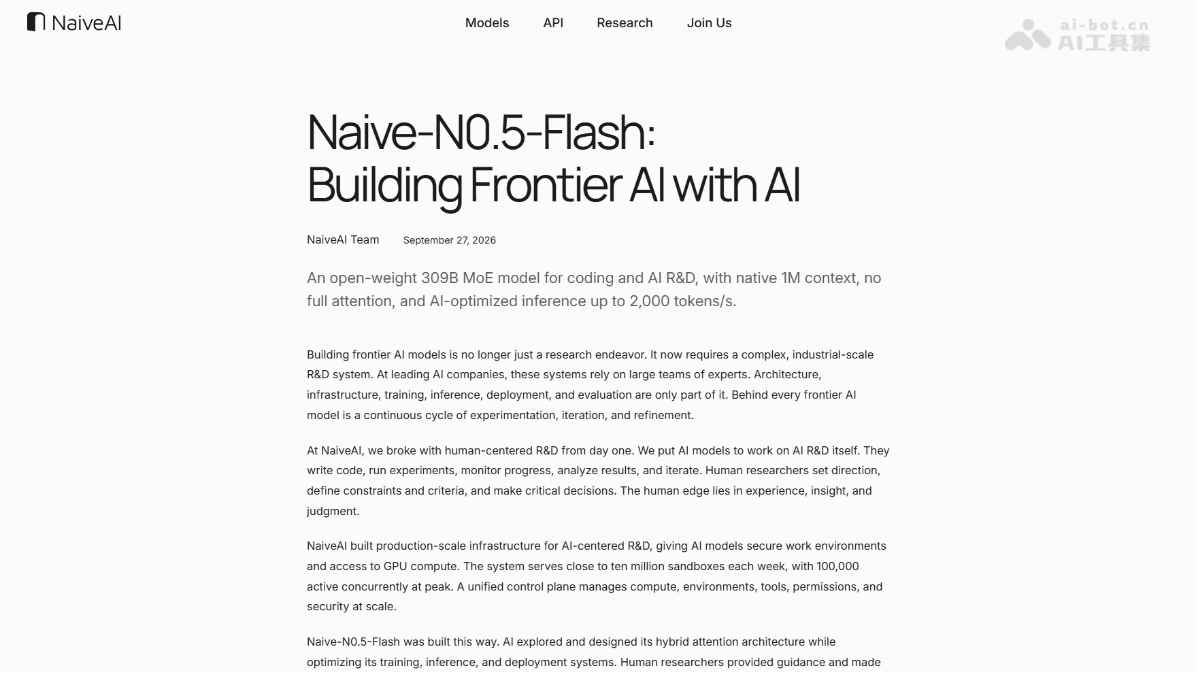
Naive-N0.5-Flash는 NaiveAI가 공개한 첫 번째 MoE 대규모 모델로, 프로그래밍 및 AI 연구개발 시나리오를 목표로 합니다. Naive-N0.5-Flash는 샤오미 MiMo-V2.5 기반 모델을 개조한 309B MoE 아키텍처이며, SWA+DSA 혼합 희소 어텐션을 사용하고 1M 컨텍스트를 기본 지원하며 전체 어텐션 계층이 없습니다. AI가 연구개발에 깊이 참여했으며, 함께 제공되는 추론 시스템 NaiveRT는 단일 스트림 디코딩에서 최고 2122 tokens/s를 달성합니다.
02Naive-N0.5-Flash의 주요 기능
장문 컨텍스트 프로그래밍: 1M token 컨텍스트를 기본 지원하여 초대형 코드 저장소와 장기 소프트웨어 엔지니어링 작업을 처리할 수 있습니다.
AI 연구개발 지원: 논문을 읽고, 방법을 재현하고, 실험을 실행하며, 결과를 분석하는 등 모델 연구개발 전 과정에 직접 참여할 수 있습니다.
추론 가속: NaiveRT 추론 시스템을 함께 제공하며, 표준 모드에서는 50 tokens/s, 초고속 모드에서는 단일 스트림 디코딩 최고 2,122 tokens/s를 지원합니다.
자율 연구: 목표, 연산 예산 및 평가 프로토콜이 주어지면 연구를 엔드투엔드로 자율 진행할 수 있습니다.
03Naive-N0.5-Flash의 기술 원리
WeChat에서 팔로우한 후 “开源”라고 답장하여 AI 오픈소스 프로젝트交流群에 참여하세요.
SWA–DSA 혼합 희소 어텐션: MiMo-V2.5 기반 모델에서 기존의 비용이 큰 전역 어텐션 계층을 DeepSeek 희소 어텐션으로 대체하고, 슬라이딩 윈도우 어텐션과 5:1 비율로 교차 적층하여 전체 네트워크에 전체 어텐션 계층을 두지 않았습니다. SWA는 128 token의 로컬 윈도우를 처리하고, DSA는 경량 인덱서로 전체 이력에 점수를 매겨 top-2048 token을 선택한 뒤 주간 네트워크에서 계산합니다.
경량 인덱서 설계: DSA의 기존 MLA를 GQA로 변경하고 인덱서 쿼리 헤드를 64개에서 16개로 줄여 인덱스 선택 경로의 처리 시간을 44% 단축했습니다. 동시에 1M 컨텍스트 Agent 작업에서 성능 저하가 발생하지 않도록 유지합니다.
3단계 학습 과정: 먼저 50B token에서 주간 네트워크를 동결하고 KL 발산 손실을 사용해 인덱서와 전체 어텐션 분포를 정렬합니다. 이후 희소 어텐션으로 전환해 3T token을 추가 사전 학습하고, 새로운 정보 선택 메커니즘에 적응시키면서 프로그래밍 및 연구개발 능력을 강화합니다. 마지막으로 200B token의 지도 미세 조정을 진행하며 학습률을 감쇠합니다. 전체 과정에서 1M 컨텍스트를 유지하고, AI가 top-k 검색 분석과 수치 안정성 수정을 자동으로 수행합니다.
혼합 시퀀스 병렬화 및 메모리 최적화: SWA는 로컬 윈도우만 필요하고 DSA는 전체 이력이 필요한 차이에 대응하기 위해 각각 Halo 시퀀스 병렬화를 적용합니다. 메모리 측면에서는 활성값 오프로딩 단위를 연산자 수준으로 세분화하고 top-k 인덱스를 명시적으로 보존하여 재계산으로 인해 선택이 바뀌는 것을 방지합니다. 512개 GPU에서 약 4일 만에 1T token을 학습할 수 있습니다.
NaiveRT 추론 최적화: 대규모 연산자 융합, PDL을 통한 상·하류 커널의 중첩 실행, 투기적 디코딩 루프의 완전한 GPU 실행으로 단일 라운드 디코딩 지연 시간을 12.3ms에서 3.4ms로 단축했습니다. 또한 랜덤 시드에 따른 비트 단위 결정론적 샘플링을 지원하여 RL 학습에서 샘플링과 학습 logprob의 일관성을 보장합니다. 모든 최적화는 엔드투엔드 실제 모델 경로를 기준으로 적용 여부를 판단합니다.
04Naive-N0.5-Flash 사용 방법
하드웨어 확인: FP8을 지원하는 NVIDIA GPU가 필요하며, 모델 가중치는 약 315GB이므로 추가 GPU 메모리를 확보해야 합니다.
가중치 가져오기: Hugging Face에서 NaiveAI/Naive-N0.5-Flash-FP8 저장소를 가져옵니다.
의존성 설치: pip install "transformers[torch,kernels]>=5.17.0"을 실행합니다.
모델 로드: AutoTokenizer와 AutoModelForCausalLM을 trust_remote_code=True, device_map="auto" 방식으로 로드합니다.
입력 구성: apply_chat_template을 통해 대화 메시지를 전달하고 입력 텐서를 생성합니다.
결과 생성: model.generate()를 호출해 응답을 생성한 후 tokenizer.decode()로 출력을 디코딩합니다.
매개변수 설정: 일반적인 시나리오에서는 temperature=1.0, top_p=0.95를 권장합니다.
고성능 추론 재현: 2,122 tokens/s 속도가 필요하면 NaiveRT 오픈소스 코드, Docker Compose 환경 및 관련 벤치마크 스크립트를 받아 직접 배포할 수 있습니다.
05Naive-N0.5-Flash의 핵심 강점
초장문 컨텍스트: 1M token 컨텍스트를 기본 지원하며 전체 네트워크에 전체 어텐션 계층이 없어 긴 시퀀스 디코딩 비용이 일반적인 아키텍처보다 훨씬 낮습니다.
탁월한 추론 속도: NaiveRT 시스템과 함께 사용하면 단일 스트림 디코딩 최고 2,122 tokens/s를 달성하며, 투기적 디코딩 지연 시간은 SGLang보다 72.4% 낮습니다.
뛰어난 연구개발 능력: PaperBench 63.2, MLE-bench-30 73.7%, NanoGPT SpeedRun 73.8s로 여러 AI 연구개발 평가에서 동급 모델을 능가합니다.
AI 네이티브 연구개발: 모델 아키텍처 설계와 시스템 최적화에 AI가 참여했으며, 인간이 목표를 설정하고 AI가 반복 작업을 수행하는 “AI가 AI를 연구개발하는” 패러다임을 구현했습니다.
자율 연구 잠재력: 목표와 예산이 주어지면 연구를 엔드투엔드로 자율 완료할 수 있으며, 400시간의 학습으로 AutoWM 세계 모델을 개발해 WorldArena 정상에 올랐습니다.
06Naive-N0.5-Flash 프로젝트 주소
프로젝트 공식 웹사이트:https://naive.ai/en/research/
GitHub 저장소:https://github.com/NaiveAI-Labs/Naive-N0.5-Flash
HuggingFace 모델 저장소:https://huggingface.co/NaiveAI/Naive-N0.5-Flash
07Naive-N0.5-Flash의 활용 시나리오
AI 연구개발 어시스턴트: 연구자가 논문을 읽고, 방법을 재현하고, 실험을 실행하며, 결과를 분석하도록 지원합니다. PaperBench 및 MLE-bench와 같은 연구개발 작업에 활용할 수 있습니다.
장기 소프트웨어 엔지니어링: 기본 제공되는 1M 컨텍스트를 활용해 대규모 코드 저장소를 처리하고, 파일 간 이해, 버그 수정 및 저장소 수준의 코드 생성을 수행합니다.
장문 컨텍스트 Agent 작업: 터미널 조작과 다중 도구 호출 등 장시간 상호작용 시나리오에서 전체 작업 이력을 유지합니다.
RL 학습 인프라: NaiveRT의 높은 단일 스트림 디코딩 속도와 비트 단위 결정론적 샘플링을 활용해 장기 강화학습 rollout을 가속하고, 뒤처지는 샘플을 줄입니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0