
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-09-15
01HiDream-O1-Video-1.0이란
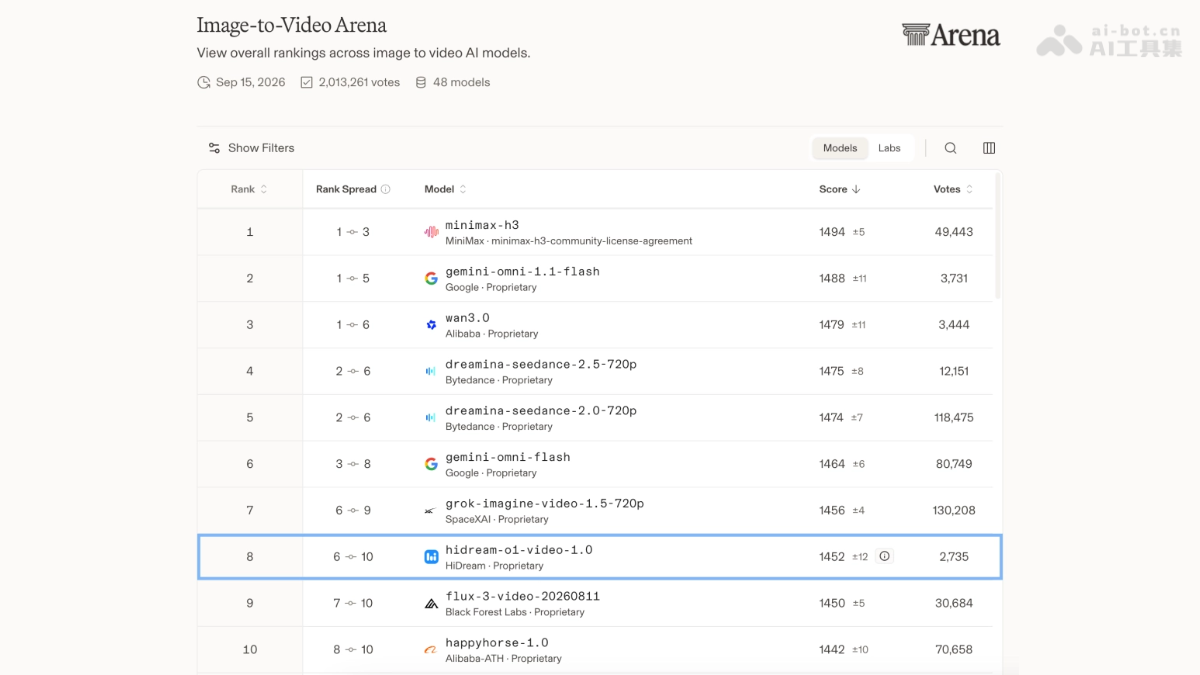
HiDream-O1-Video-1.0(약칭 HD-V1)은 즈샹미래(HiDream.ai)가 출시한 네이티브 멀티모달 동영상 생성 모델로, 텍스트·이미지·동영상 등 멀티모달 입력을 지원하며 한 번의 클릭으로 5–20초 분량의 1080p 동영상을 바로 생성할 수 있습니다. 물리 법칙 기반 생성과 오디오·영상의 네이티브 통합 기능을 갖춘 이 모델은 Artificial Analysis 이미지-동영상 순위(With Audio)에서 전 세계 4위, Arena.ai 블라인드 테스트 순위에서 8위를 기록하며 중국 AI 동영상 기술이 세계 최상위권에 진입했음을 보여줍니다.
02HiDream-O1-Video-1.0의 주요 기능
멀티모달 입력: 텍스트, 이미지, 동영상 등 다양한 모달리티를 생성 조건으로 지원합니다.
고화질 동영상 직접 생성: 한 번의 클릭으로 5–20초 길이의 1080p 고화질 동영상을 생성합니다.
의도 이해: 사전 멀티모달 이해 모듈을 통해 구어체 입력을 쇼트, 캐릭터, 동작, 음향 효과 등 전문적인 계획으로 구조화합니다.
물리 법칙 기반 생성: 중력, 충돌, 관성 등 물리 법칙을 생성 로직에 반영하여 화면의 변형과 움직임이 실제 세계와 유사하게 표현됩니다.
스마트 길이 계획: 사건의 논리와 서사 리듬에 따라 동영상 길이를 자동으로 결정하며, 고정된 구간을 기계적으로 채우지 않습니다.
음향과 영상의 통합: 텍스트, 동영상, 오디오 신호를 공동 모델링하여 입 모양, 음향 효과와 화면을 자연스럽게 동기화합니다.
서사 및 인물 일관성: 먼저 계획한 후 공동 생성하고 Reward 정렬을 수행하는 프로세스를 적용하여 긴 쇼트의 서사적 연결성을 유지하고 인물의 외형이 변하지 않도록 합니다.
03HiDream-O1-Video-1.0의 기술 원리
네이티브 올모달 통합 아키텍처: HD-V1은 즈샹이 자체 개발한 네이티브 올모달 아키텍처를 채택했습니다. 아키텍처 설계 초기부터 텍스트, 비디오, 오디오의 통합 표현을 지원하도록 설계되어, 세 가지 요소를 동일한 생성 과정에서 공동 모델링하고 상호 제약 및 정렬합니다. 화면의 움직임이 사운드의 리듬을 이끌고, 대사와 음향 효과가 장면의 감정을 보완하며, 텍스트 조건이 전체 과정에 걸쳐 유지됩니다.
사전 멀티모달 의도 이해 모듈: 모델은 먼저 멀티모달 이해 모델을 통해 사용자의 입력을 심층적으로 이해하고 구조화하여 계획합니다. 구어체이거나 모호한 자연어를 장면 길이, 촬영 장소, 등장인물, 동작과 표정, 샷 크기와 구도, 카메라 움직임과 초점 거리, 대사 및 배경음 등의 전문 필드로 변환합니다. 이해가 깊을수록 계획이 안정적이고, 계획이 안정적일수록 이후의 공동 생성이 의도에서 벗어날 가능성이 줄어듭니다. 이를 통해 의도 누락, 장면 전환의 이질감, 인물의 일관성 저하를 원천적으로 방지합니다.
물리 법칙이 내재된 생성 로직: 물체가 중력에 따라 어떻게 떨어지는지, 충돌에 어떻게 반응하는지, 관성이 어떻게 이어지는지, 빛과 그림자가 어떻게 감쇠하는지, 공간이 어떻게 연속성을 유지하는지를 반영합니다.
계획-생성-정렬의 3단계 생성 프로세스: 즈샹은 먼저 계획하고, 이후 공동 생성한 다음, 멀티모달 Reward로 정렬하는 기술 방식을 제안했습니다. 모델은 먼저 전체적인 관점에서 서사와 인물 상태를 계획하고, 공동 생성 과정에서 화면, 동작, 의미를 제약하며, 멀티모달 보상 신호를 통해 화질, 일관성, 물리적 타당성을 통합적으로 정렬합니다. 이를 통해 긴 장면에서 인물, 감정, 동기가 서로 영향을 주는 상황에서도 전체적인 자기 일관성을 보장합니다.
04HiDream-O1-Video-1.0 사용 방법
공개 상태 확인: 현재 모델은 내부 테스트 단계로, 아직 전면 공개되지 않았으며 사전 체험 자격을 신청해야 합니다https://n1y46cmwsp.feishu.cn/share/base/form/shrcnVBeO99NQQWARxNirglcbct。
신청서 작성: QR 코드를 길게 눌러 스캔한 후 신청서 페이지로 이동합니다.
신청 정보 제출: 양식의 안내에 따라 개인/기업 정보와 사용 목적을 작성하고 제출한 후 공식 심사를 기다립니다.
개통 안내 대기: 심사를 통과하면 내부 테스트 체험 자격을 받게 됩니다.
모델 기능 체험: 자격을 얻은 후 공식 제공入口에서 텍스트, 이미지 또는 동영상을 입력하면 5–20초 길이의 1080p 영상과 음성이 결합된 동영상을 한 번에 생성할 수 있습니다.
05HiDream-O1-Video-1.0의 핵심 강점
네이티브 멀티모달 아키텍처: 업계 최초로 텍스트, 영상, 오디오 신호를 공동 모델링하는 비디오 모델로, 영상과 사운드를 본질적으로 통합해 생성합니다.
물리 법칙 기반 생성: 중력, 충돌, 관성, 빛과 그림자의 감쇠, 공간적 연속성 등 물리 법칙을 모델이 실제로 이해하고 생성 로직에 반영합니다. 화면의 변형, 움직임에 대한 반응, 의성 효과가 모두 실제 인과관계에 부합합니다.
심층 의도 이해: 사전 멀티모달 의도 이해 모듈을 통해 구어체와 단편적인 사용자 입력을 장면 길이, 샷 크기와 구도, 카메라 움직임, 동작과 표정, 대사와 음향 효과 등 전문적인 구성으로 구조화해 계획합니다. 이를 통해 의도 누락과 장면 간 부자연스러운 전환을 근본적으로 방지합니다.
서사에 맞춘 영상 길이: “고정된 길이의 창에 콘텐츠를 채우는” 기존 방식을 넘어, 이벤트 전개의 논리와 서사적 리듬에 따라 모델이 영상 길이를 자율적으로 계획합니다. 동작이 끝난 뒤 의미 없이 기다리거나 시간을 채우기 위해 느리게 재생하는 문제를 방지합니다.
서사의 일관성과 인물 일관성: 먼저 계획하고, 이후 공동 생성한 다음, 멀티모달 Reward로 정렬하는 기술 경로를 채택합니다. Diffusion RL 및 인간 인지 정렬 기반 Reward 모델을 결합해 연속된 장면에서 인물, 감정, 동기가 일관되게 유지되고 흔들리지 않도록 보장합니다.
06HiDream-O1-Video-1.0의 활용 사례
광고 및 마케팅 숏폼 영상: 음성과 영상을 한 번에 출력하는 1080p 제품 영상으로 후반 작업의 더빙 비용을 절감하며, 물리적으로 사실적인 소재 표현이 고품질 제품 전시에 적합합니다.
숏폼 영상 및 소셜 미디어 콘텐츠 제작: 5–20초의 자동 조절 길이가 숏폼 영상의 리듬에 자연스럽게 맞고, 구어체 프롬프트만으로 음향 효과와 립싱크가 적용된 완성 영상을 생성할 수 있습니다.
영화·영상 프리비주얼라이제이션 및 스토리보드(Previs): 쇼트, 구도, 카메라 움직임, 음향 효과를 체계적으로 계획하여 감독이 촬영 전에 내러티브의 리듬과 화면 구현 가능성을 빠르게 검증할 수 있도록 돕습니다.
이커머스 제품 동적 전시: 제품 이미지를 입력하면 사용 장면 영상을 생성할 수 있으며, 물체의 물리적 움직임이 사실적으로 표현되고 효과음이 동기화되어 전환율 향상에 기여합니다.
교육 및 과학 대중화 콘텐츠: 단편적인 지식 포인트를 물리 법칙에 정확한 동적 시연으로 전환하여, 음성과 영상의 동기화로 이해의 문턱을 낮춥니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0