
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-10-11
01PixelUMM이란
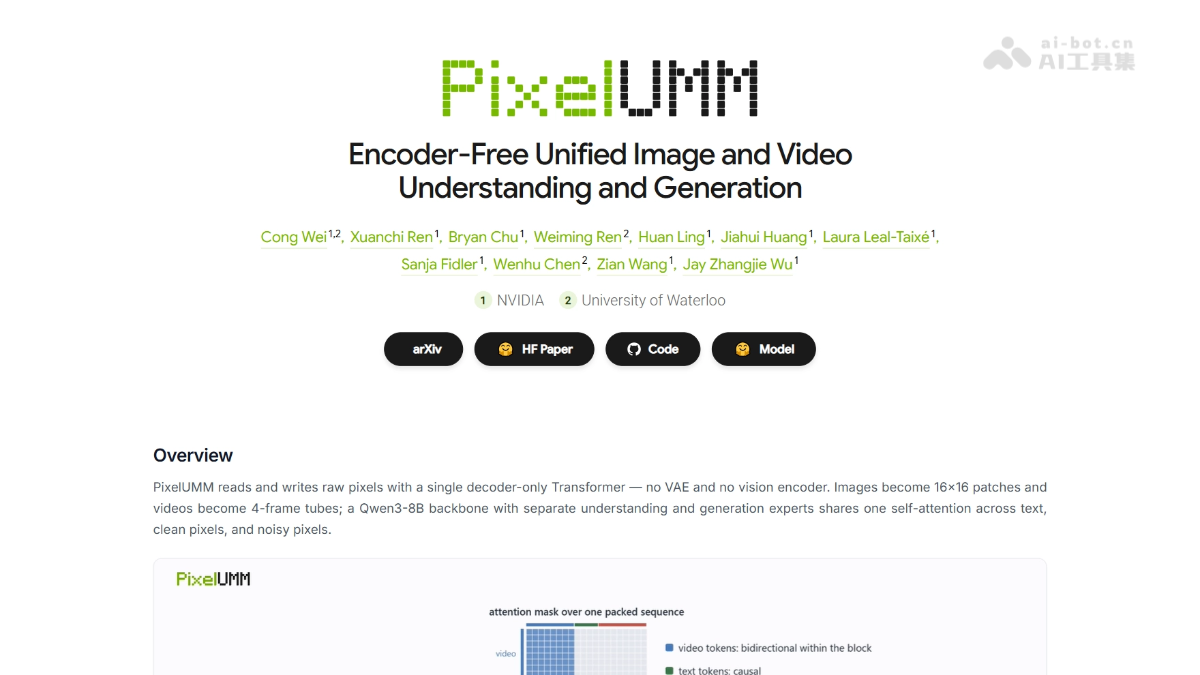
PixelUMM은 NVIDIA와 워털루대학교가 공동으로 개발한 인코더 없는 통합 멀티모달 모델입니다. 핵심적인 혁신은 VAE와 비전 인코더를 완전히 제거하고, 단일 Decoder-only Transformer로 원시 픽셀 공간에서 이미지와 비디오를 직접 읽고 쓰는 것입니다. 이해와 생성은 동일한 디코더와 self-attention을 공유합니다. 이미지는 16×16 패치로, 비디오는 4프레임 tubelet으로 분할되며, 코드가 공개되어 있습니다.
02PixelUMM의 주요 기능
텍스트-비디오 생성(T2V): 최대 832×464 해상도, 96프레임, 24fps의 4초 비디오를 생성할 수 있으며, 화질은 주요 비디오 확산 모델과 비슷합니다.
텍스트-이미지 생성(T2I): 별도의 이미지 분기나 디코더 없이 동일한 모델에서 이미지를 직접 생성합니다.
이미지 이해: VQA, OCR, 차트, 문서 등 21개 이미지 이해 작업을 수행하며, 8B급 VLM의 평균 수준에 도달합니다.
비디오 이해: MVBench, Video-MME 등 비디오 질의응답 벤치마크를 지원하며, dense와 sparse 두 가지 입력 모드를 제공합니다.
이미지-비디오 생성(I2V): 깨끗한 첫 프레임 이미지를 이해 전문가에 조건으로 주입하면 VAE로 조건 프레임을 인코딩하지 않고 후속 비디오를 생성할 수 있습니다.
비디오 편집: 입력 비디오를 시각적 조건으로 사용하고 멀티모달 컨텍스트 조건 메커니즘을 통해 편집 작업을 수행합니다.
03PixelUMM의 기술 원리
인코더 없는 아키텍처: PixelUMM은 기존 통합 모델의 VAE와 비전 인코더를 완전히 제거했습니다. 이미지는 16×16 패치로, 비디오는 4프레임 tubelet의 원시 RGB 픽셀 형식으로 직접 분할해 입력하며, 출력 역시 선형 헤드가 픽셀을 직접 회귀합니다. 전체 과정에 latent 공간의 인코딩·디코딩 손실이 없어 진정한 엔드투엔드 픽셀 입출력을 구현합니다.
MoT 공유 어텐션 구조: Qwen3-8B를 백본으로 Mixture-of-Transformers를 구성합니다. 이해 전문가와 생성 전문가는 각각 독립적인 FFN을 가지며 동일한 self-attention을 공유합니다. 이를 통해 텍스트, 깨끗한 픽셀, 노이즈 픽셀이 동일한 어텐션 공간에서 상호작용하고, 하나의 모델에서 이해와 생성을 통합합니다.
픽셀 공간 확산 학습: 생성 작업은 픽셀 공간에서 flow-matching 방식으로 직접 학습합니다. 절제 실험에 따르면 픽셀 공간과 VAE 공간의 그래디언트 노름은 거의 동일하지만, 픽셀 공간 학습이 더 안정적입니다. 또한 압축률 실험을 통해 16×16 패치와 4프레임 tubelet이 학습 난이도와 효율 사이의 최적 균형점임을 확인했습니다.
멀티모달 조건 주입 메커니즘: 텍스트 조건, 참조 이미지, 입력 비디오 등의 “깨끗한 조건”은 통합적으로 이해 전문가를 거치고, 생성할 노이즈 토큰은 생성 전문가를 거칩니다. 두 요소는 공유 어텐션에서 융합됩니다. 이를 통해 SenseNova-U1의 encoder-free 조건 방식을 이미지-비디오 생성과 비디오 편집으로 확장했습니다. 절제 실험에서는 이해 능력 저하 없이 네 가지 비디오 벤치마크가 0.89–3.49점 향상되었습니다.
선형 출력 헤드와 컨볼루션 헤드 비교: 기본 경량 선형 출력 헤드는 16픽셀 격자 아티팩트를 유발합니다. Wan 방식의 업샘플링 컨볼루션 헤드와 PixelShuffle 헤드를 비교한 결과, 컨볼루션 헤드가 아티팩트를 제거할 수 있었습니다. 그중 시간 우선 PixelShuffle이 학습 손실과 아티팩트 억제 사이에서 가장 균형이 좋았으며, 헤드를 변경하려면 재학습이 필요합니다.
04PixelUMM 사용 방법
저장소 복제: git clone https://github.com/nv-tlabs/PixelUMM을 실행하고 ENVIRONMENT.md에 따라 CUDA 환경을 구성합니다.
가중치 다운로드: Hugging Face의 nvidia/PixelUMM에서 기본 checkpoint S8-F22-R05를 다운로드하고, CHECKPOINT.md에 따라 Qwen3-8B의 구성 파일과 tokenizer 파일을 다운로드합니다.
경로 설정: PIXELUMM_CKPT, PIXELUMM_QWEN_DIR, PIXELUMM_OUTPUT 세 환경 변수가 로컬 절대 경로를 가리키도록 설정합니다.
checkpoint 확인: 먼저 check_checkpoint.py를 실행해 가중치의 무결성과 텐서 호환성을 확인합니다.
안전 검토 권한 신청: Hugging Face에서 nvidia/Cosmos-1.0-Guardrail에 대한 접근 권한을 신청하고 로그인합니다.
추론 실행: inference.py에서 --task t2i / t2v / image-vlm / video-vlm을 각각 지정하고 prompt, 해상도, 프레임 수 등의 매개변수를 설정해 이미지나 비디오를 생성하거나 이해 결과를 출력합니다.
일괄 생성(선택 사항): inference_batch.py와 YAML prompt 파일을 사용해 작업을 일괄 실행합니다.
토이 학습(선택 사항): TRAIN.md에 따라 toy 데이터셋을 다운로드하고, train_toy.py로 F22 checkpoint 기반의 네 가지 작업 학습 예제를 실행합니다.
05PixelUMM의 핵심 장점
완전한 인코더 없는 아키텍처: VAE와 비전 인코더를 제거하고 원시 픽셀 공간에서 직접 읽고 써 latent 공간의 인코딩·디코딩으로 인한 정보 손실과 아티팩트 원인을 없앱니다.
이해와 생성의 통합: 단일 decoder-only Transformer가 텍스트-이미지 생성, 텍스트-비디오 생성, 이미지 이해, 비디오 이해의 네 가지 주요 작업을 동시에 수행하며, 이해 전문가와 생성 전문가는 동일한 self-attention을 공유합니다.
간결한 아키텍처와 직접적인 추론: 경량 선형 헤드가 픽셀을 직접 회귀하므로 추가 디코더가 필요 없고 생성 경로가 더 짧습니다.
유연하고 효율적인 조건 주입: 참조 이미지와 입력 비디오 등의 깨끗한 조건을 이해 전문가에 전달하는 것만으로 이미지-비디오 생성과 비디오 편집을 구현할 수 있으며, 절제 실험을 통해 이해 능력 저하가 없음을 확인했습니다.
명확하고 확장 가능한 학습 규칙: 8B 모델은 동일한 손실에 도달하는 데 1.7B 모델의 약 3분의 1에 해당하는 학습 단계만 필요해 규모 확장에 따른 이점이 분명합니다.
06PixelUMM 프로젝트 주소
프로젝트 홈페이지: https://nv-tlabs.github.io/PixelUMM/
GitHub 저장소: https://github.com/nv-tlabs/PixelUMM
Hugging Face 모델 저장소: https://huggingface.co/nvidia/PixelUMM
arXiv 기술 논문: https://arxiv.org/pdf/2609.38597
07PixelUMM의 활용 사례
숏폼 비디오 콘텐츠 제작: 한 줄의 문구를 입력해 4초 24fps 비디오를 직접 생성할 수 있어 소셜 미디어용 소재를 빠르게 제작하는 데 적합합니다.
이미지-비디오 생성 및 비디오 편집: 첫 프레임이나 원본 비디오를 조건으로 콘텐츠를 생성하거나 수정할 수 있어 전자상거래 제품의 동적 전시와 영상 사전 시각화에 활용할 수 있습니다.
장시간 비디오 이해 및 질의응답: 입력 비디오에 대한 설명, 요약, 시간적 추론을 수행해 콘텐츠 검토, 소재 검색, 회의록 작성에 활용할 수 있습니다.
문서 및 차트 분석: OCRBench 78.0, DocVQA 90.4의 성능으로 영수증 인식, 보고서 질의응답 등 기업 문서 지능화 시나리오를 지원할 수 있습니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0