

AnyJev의 기능
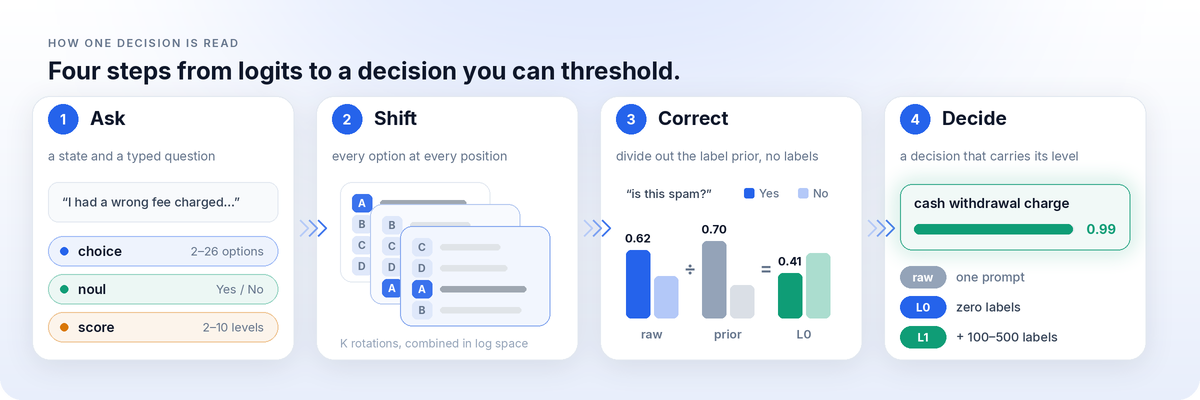
AnyJev는 오픈 언어 모델을 Jev 스타일의 의사결정 모델로 변환합니다. 모델에 답변을 생성하도록 요청한 다음 텍스트를 파싱하는 대신, AnyJev는 프리필에서 모델의 다음 토큰 분포를 읽고 확률이 포함된 타입 지정 의사결정을 반환합니다.
이는 요청 라우팅, 작업의 위험 여부 추정, 작업 완료도 점수화와 같은 워크플로에 유용합니다. 각 결과에는 사용된 의사결정 수준이 기록되므로, 후속 코드에서 보정되지 않았거나 라벨이 0개인 결과와 학습된 헤드로 생성된 결과를 구분할 수 있습니다.
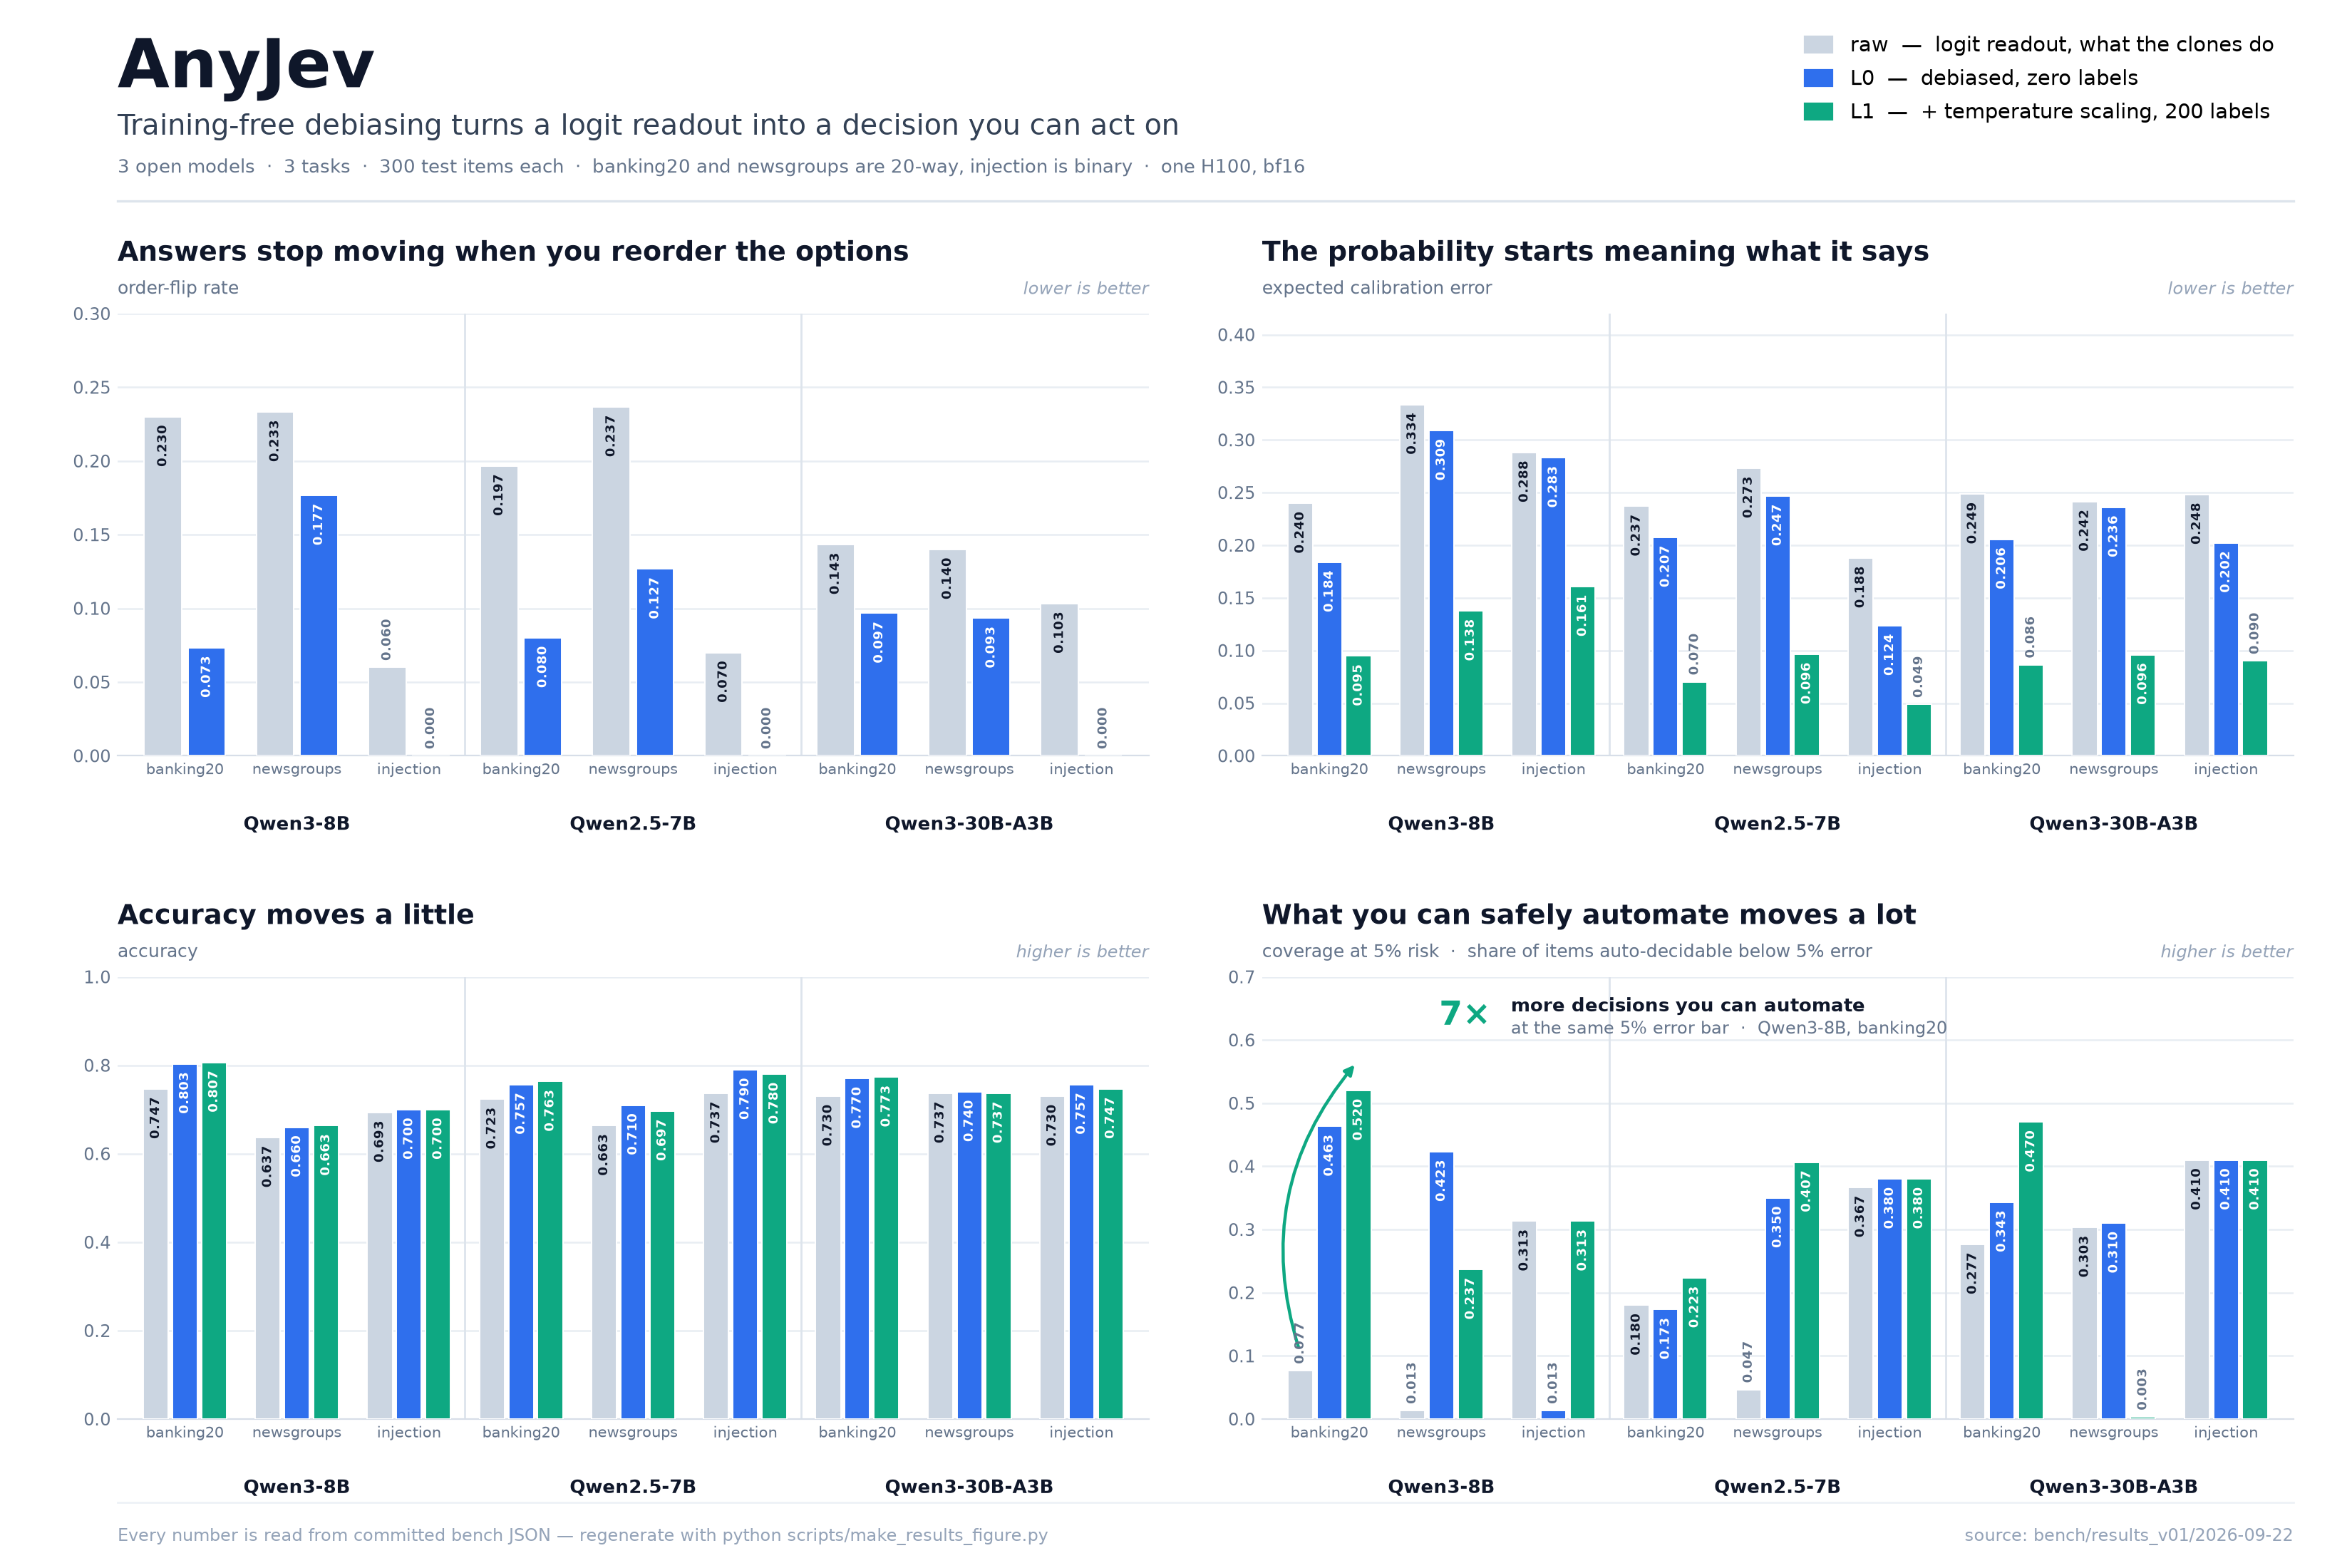
AnyJev는 원시 로짓의 두 가지 실용적인 문제를 해결합니다. 옵션 순서가 바뀌면 예측이 달라질 수 있고, 원시 신뢰도 값은 임계값 기반 자동화에 충분히 보정되지 않을 수 있습니다. README의 Qwen3-8B BANKING77 실험에서 L0는 라벨 없이 옵션 순서 변경에 따른 예측 반전율을 0.230에서 0.073으로 낮췄습니다. L1은 라벨이 있는 예시를 사용해 예상 보정 오차를 0.240에서 0.095로 낮췄습니다.
의사결정 수준
AnyJev는 데이터와 서빙 요구사항이 서로 다른 여러 수준을 제공합니다.
- raw: 라벨 토큰에 제한된 소프트맥스를 적용합니다. 위치 편향을 보정하거나 신뢰도를 보정하지 않습니다.
- L0: 라벨이 필요하지 않습니다. 순환 옵션 순열을 평가하고 위치 편향을 평균화하며, 추정된 라벨 사전확률을 나눠 제거합니다.
- L1: 질문당 약 100~500개의 라벨을 사용해 L0 위에 온도 스케일링을 적용합니다. 보정을 개선하지만 순위는 변경하지 않습니다.
- L2: 질문당 약 100~300개의 라벨을 사용해 중간 은닉 상태에서 축소 LDA 또는 릿지 헤드를 계산합니다. 로컬 모델이 필요하며 모델과 질문 모두에 종속됩니다.
다중 옵션 선택에서 L0는 순열을 평가하므로 여러 번의 프리필이 필요합니다. 반면 L2는 하나의 프롬프트를 사용하고 고정된 중간 블록에서 중단하므로, 보고된 Qwen3 실험에서는 전체 순전파보다 비용이 적습니다.
주요 기능
- 타입이 지정된
choice,noul,score질문. - 텍스트 생성이나 답변 파싱이 필요하지 않음.
- 옵션 위치 및 라벨 사전확률 효과를 보정하는 라벨 0개 L0 보정.
- 수백 개의 라벨을 사용하는 L1 온도 보정.
- 그래디언트나 모델 미세 조정 없이 몇 초 만에 학습되는 L2 폐쇄형 헤드.
level="auto"를 통한 L2, L1 또는 L0 자동 선택.observe를 사용한 점진적 라벨 수집.- 하나의 질문과 여러 상태에 대한 배치 의사결정.
- 나중에 서빙할 수 있도록 저장하고 불러올 수 있는 작은 JSON 아티팩트.
설치 및 설정
Hugging Face 백엔드 설치
Hugging Face 통합 기능과 함께 AnyJev를 설치합니다.
pip install "anyjev[hf]"현재 릴리스는 Transformers 기반 anyjev.backends.hf 백엔드를 통해 모든 의사결정 수준을 제공합니다. vLLM 및 SGLang 지원은 로드맵에 있으며 이 릴리스에서는 사용할 수 없습니다.
디사이더 생성
핵심 API를 가져오고 오픈 모델로 HFBackend를 초기화합니다.
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

decider = Decider(HFBackend("Qwen/Qwen3-8B"))
제공되는 L2 헤드는 1.7B, 4B, 8B, 30B-A3B, 32B의 다섯 Qwen3 모델을 지원합니다. L2 헤드는 기본 모델과 질문에 종속되므로, 한 모델이나 질문에 맞춰 학습한 헤드를 다른 모델이나 질문에 자동으로 재사용할 수 없습니다.
타입이 지정된 질문 정의
질문은 출력 타입, 유효한 응답 및 안정적인 이름을 정의합니다. 동일한 애플리케이션 상태에 대해 여러 질문 유형을 평가할 수 있습니다.
route = Question.choice(
    "Which team should handle this?",
    ["billing", "technical", "sales", "other"],
    name="route",
)

risky = Question.noul(
    "Is this tool call destructive or irreversible?",
    name="risky",
)

done = Question.score(
    "How complete is the task?",
    bins=5,
    name="done",
)
범주형 의사결정에는 choice, 참 또는 거짓 의사결정에는 noul, 구간화된 수치 점수에는 score를 사용합니다. 현재 문자 토큰 판독은 최대 26개의 옵션을 지원합니다.
기본 L0 의사결정 수행
L0는 기본값이며 라벨이 지정된 예시가 필요하지 않습니다. 질문에 필요한 정보가 포함된 상태를 구성한 다음 decide를 호출합니다.
state = {
    "conversation": [
        {"role": "user", "content": "I was charged twice."}
    ],
    "tool_call": {
        "name": "refund_payment",
        "arguments": {"payment_id": "pay_123"},
    },
}

result = decider.decide(state, [route, risky, done])

print(result["route"].distribution)
print(result["risky"].p_true)
print(result["done"].value)
print(result.level)
대표적인 경로 분포는 제공된 각 옵션을 확률에 매핑할 수 있습니다. 불리언 의사결정은 p_true를 노출하고, 점수 의사결정은 value를 노출합니다. 상위 수준 아티팩트가 없으면 전체 결과에는 L0가 표시됩니다.
확률은 해당 수준에 따라 해석해야 합니다. L0는 안정성을 높이고 추정된 라벨 편향을 보정하지만, 불확실성을 완전히 보정하지는 않습니다.
L1 보정 추가
질문에 대해 약 100~500개의 라벨이 지정된 상태가 있다면 calibrate를 호출해 L1 온도를 학습합니다.
decider.calibrate(risky, states, labels)L1은 L0 위에서 생성된 확률을 보정합니다. 가장 높은 순위의 답변은 바꾸지 않지만, 신뢰도 임계값을 더 의미 있게 만들 수 있습니다.
L2 폐쇄형 헤드 학습
더 높은 정확도를 위해 약 100~300개의 라벨이 지정된 예제를 사용해 질문별 L2 헤드를 학습합니다.
decider.fit_head(route, states, labels)

decider.save_artifacts("qwen3-8b.json")
학습 과정에서는 예제에 대해 모델을 한 번 실행한 다음 닫힌 형식으로 헤드를 계산합니다. 그래디언트를 사용하지 않으며 언어 모델의 가중치도 변경하지 않습니다. 프로젝트에 따르면 헤드의 크기는 일반적으로 약 100KB이며, 지원되는 소형 Qwen3 모델에서는 수 초 안에 계산할 수 있습니다.
이후 프로세스에서 저장한 아티팩트를 불러온 다음 자동 레벨 선택을 요청합니다.
decider.load_artifacts("qwen3-8b.json")

result = decider.decide(state, [route], level="auto")
print(result["route"].level)level="auto"를 사용하면 호환되는 헤드가 질문을 라우팅할 수 있을 때 AnyJev는 L2를 사용합니다. 그렇지 않으면 보정이 가능한 경우 L1으로, 그다음에는 L0으로 대체합니다.
라벨을 점진적으로 수집하기
AnyJev는 검토 큐, 관찰된 결과 또는 다른 피드백 소스에서 라벨이 들어오는 즉시 이를 수용할 수 있습니다.
decider.observe(route, state, correct_label)프로젝트의 자동 루프는 관찰 30회 시점에 헤드를 계산하고, 이후 60회, 120회 및 그 다음 마일스톤에서 이를 다시 계산합니다. 이를 통해 새 질문을 L0에서 시작한 뒤 충분한 피드백이 쌓이면 L2로 전환하는 배포 수명 주기를 지원합니다.
배치 추론
하나의 질문을 여러 상태에 적용할 때는 decide를 반복 호출하지 말고 배치 API를 사용합니다.
results = decider.decide_batch(states, route)이는 하나의 타입이 지정된 질문을 여러 입력에 적용할 때 사용하는 권장 인터페이스입니다.
패키지 데모 실행하기
저장소를 체크아웃한 뒤 모델을 다운로드하지 않고 합성 데모를 실행합니다.
python -m demo.jev_mode --backend fake배포 수명 주기를 시뮬레이션하려면 lifecycle 옵션을 추가합니다.
python -m demo.jev_mode --backend fake --lifecycle제공된 헤드를 사용해 실제 Qwen3 데모를 실행하려면 --backend fake를 제거합니다.
고급 배포 팁
질문 식별자를 안정적으로 유지하기
L2는 질문과 모델별로 학습됩니다. 새로운 선택지 집합에는 새로운 라벨과 헤드가 필요합니다. 동일한 질문의 표현을 바꾸거나 동일한 선택지의 순서를 변경하면 기존 헤드로 라우팅될 수 있습니다.
표현 조정에 라벨 없는 트래픽 사용하기
표현을 바꾼 질문의 경우 AnyJev는 약 30개의 라벨 없는 요청을 사용해 헤드의 특성 평균과 스케일을 다시 조정할 수 있습니다. 이 조정은 질문 표현과 선택지 순서에 적용되며, 애플리케이션 상태 자체의 변화를 감지하지는 않습니다.
실제 데이터 변화를 모니터링하기
상태 분포의 변화는 평균 재조정 메커니즘으로 감지할 수 없으므로, 주기적으로 라벨을 지정하는 평가 샘플을 유지하고 성능을 표본 점검해야 합니다. 표현 조정을 프로덕션 모니터링의 대체 수단으로 사용하지 마십시오.
결정 레벨에 따라 작업 제어하기
모든 결정에는 레벨이 포함됩니다. 다운스트림 시스템은 민감한 작업을 실행하기 전에 이를 검사할 수 있으며, 프로젝트는 require=를 사용한 레벨 강제도 지원합니다. 이를 통해 보정된 결정이나 L2 결정용으로 설계된 워크플로가 대체 결과를 받아 조용히 실행되는 것을 방지할 수 있습니다.
검증 후에만 임계값 선택하기
보정의 주요 이점은 신뢰도가 높은 사례를 자동화로 보내고 불확실한 사례를 에스컬레이션할 수 있다는 점입니다. 대표성을 갖춘 라벨 데이터에서 임계값을 선택하고, 표시된 확률을 자동으로 신뢰할 수 있다고 가정하지 말고 그 결과의 오류율과 적용 범위를 측정해야 합니다.
중요한 제한 사항
- L2 헤드는 다른 질문이나 기반 모델로 이전할 수 없습니다.
- 현재 프로젝트 릴리스에는 Qwen3 헤드만 포함되어 있습니다.
- L2에는 숨은 상태에 대한 접근이 필요하며, 현재는 Transformers 백엔드를 통해 제공됩니다.
- 보정으로는 모델이 근본적으로 답할 수 없는 작업을 해결하게 만들 수 없습니다.
- 하나의 라벨이 배치 사전확률에서 크게 우세한 경우 L0은 정확도를 낮출 수 있습니다.
- 현재 문자 출력은 최대 26개의 선택지만 지원합니다.
- 보고된 5% 위험 적용 범위 추정치는 300개의 예제를 기반으로 하므로 분산이 큽니다.
- 공개된 타입 지정 결정 정확도는 독립적으로 확립된 정답이 아니라 교사 LLM과의 일치도를 측정합니다.
- 보고된 결정은 완전한 에이전트 루프 내부가 아니라 독립적인 환경에서 평가되었습니다.
결론
AnyJev는 라벨이 전혀 없는 타입 지정 결정에서 보정된 확률과 효율적인 숨은 상태 헤드로 이어지는 실용적인 단계를 제공합니다. L0으로 시작해 실제 라벨을 수집하고, 보정이 우선이면 L1을 추가하며, 더 정확한 질문별 결정 경로가 필요할 때 L2를 학습하십시오. 보고된 레벨을 유지하고, 임계값을 검증하며, 프로덕션 데이터가 변할 때 라벨이 지정된 샘플을 모니터링하십시오.
구현 세부 정보와 현재 계획은 AnyJev 저장소, 레벨 계약, 벤치마크 문서 및 로드맵에서 확인할 수 있습니다.