

Jeff란 무엇인가요?
Jeff는 빠른 제로샷 분류를 위해 설계된 소형 Qwen3.5 및 Gemma 4 파인튜닝 모델 제품군입니다. 자연어로 상황을 제시하고, 사용 가능한 옵션을 정의하면, 한 번의 순전파만으로 각 옵션에 대해 보정된 확률을 받을 수 있습니다.
일반적인 생성 모델과 달리 Jeff는 애플리케이션이 파싱해야 하는 산문을 생성하지 않습니다. 지원 요청 라우팅, 의도 감지, 콘텐츠 조정, 음성 명령, 게임의 움직임과 같은 작업에서 직접 결정을 내리도록 설계되었습니다. 카테고리를 명확하게 설명한다면 해당 카테고리가 학습 데이터에 포함되어 있지 않아도 됩니다.
Jeff는 Jev와 동일한 요청 형식을 사용하지만, 독립적인 프로젝트이며 TypeSafe와 제휴하거나 TypeSafe의 보증을 받지 않습니다. 학습 코드는 오픈 소스 AutoJev 레시피를 기반으로 합니다.
주요 기능
- 빠른 로컬 추론: 보고된 벤치마크에서 Jeff-Qwen3.5-0.8B는 RTX PRO 6000에서 결정 하나를 내리는 데 약 22ms, MLX를 사용하는 Apple M4 Max에서 28ms가 걸립니다.
- 보정된 출력: 각 결정에는 확률, 선택된 옵션, 신뢰도가 포함됩니다.
- 제로샷 카테고리: 고정된 라벨 집합으로 제한되지 않고 요청 시점에 옵션을 설명합니다.
- 세 가지 질문 유형:
choice,noul,score질문을 사용할 수 있습니다. - 요청 일괄 처리: 동일한 상태에 대한 여러 독립 질문에 함께 답할 수 있습니다.
- 로컬 백엔드: NVIDIA GPU 또는 CPU에서 PyTorch로 실행하거나, Apple 실리콘에서 Qwen 모델과 함께 MLX를 사용할 수 있습니다.
- 도메인 적응: 제로샷 성능이 충분하지 않을 때 Jeff 체크포인트를 파인튜닝할 수 있습니다.
모델 선택
Jeff는 Hugging Face에서 세 가지 모델 체크포인트를 제공합니다.
- Jeff-Qwen3.5-0.8B: 16비트 가중치가 1.7GB인 8억 개 파라미터 모델입니다. 빠른 옵션 선택에 권장되는 균형점입니다.
- Jeff-Qwen3.5-2B: 16비트 가중치가 4.2GB인 20억 개 파라미터 모델입니다. 보고된 벤치마크 패널에서 전반적으로 더 높은 점수를 기록하지만 더 느리고 더 신중합니다.
- Jeff-Gemma4-E2B: 유효 파라미터 20억 개, 저장 파라미터 46억 개, 16비트 가중치 9.3GB인 모델입니다. 프로젝트의 MLX 백엔드는 Qwen 모델만 지원합니다.
처음 배포할 때는 Jeff-Qwen3.5-0.8B로 시작하세요. 애플리케이션의 대표적인 예시로 평가한 후에만 다른 체크포인트로 전환하세요.
Jeff 설치 및 다운로드
이 저장소는 uv를 사용해 의존성을 동기화하고 명령을 실행합니다. 프로젝트 디렉터리에서 기본 의존성을 설치하고 0.8B 체크포인트를 다운로드하세요.
uv sync
uv run hf download mstrasser/Jeff-Qwen3.5-0.8B --local-dir checkpoints/jeff-0.8b
체크포인트는 checkpoints/jeff-0.8b에 저장됩니다. 다른 공개 모델을 사용하려면 Hugging Face 저장소와 로컬 디렉터리를 변경할 수 있습니다.
PyTorch로 서비스 실행
NVIDIA GPU 또는 CPU에서 기본 PyTorch 백엔드로 서버를 시작하세요.
JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serveApple 실리콘에서 MLX로 서비스 실행
호환되는 Mac에서는 추가 Mac 의존성을 설치하고 MLX 백엔드를 선택하세요. MLX 서비스 실행은 Qwen 체크포인트에서 사용할 수 있습니다.
uv sync --extra mac
JEFF_BACKEND=mlx JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serve
두 명령 모두 로컬 8765 포트에서 서비스를 제공합니다.
첫 번째 분류 요청 보내기
요청에는 상황을 설명하는 state와 하나 이상의 결정을 정의하는 questions 객체가 포함됩니다. 다음 예제에서는 고객 메시지를 라우팅하고 고객이 화가 났는지 독립적으로 추정하도록 Jeff에 요청합니다.
curl -s localhost:8765/v1/systemone \
  -H 'content-type: application/json' \
  -d '{
    "model": "jeff-latest",
    "state": "환불 요청: 고객이 소포가 찌그러진 상태로 도착했으며 돈을 돌려받고 싶다고 말합니다.",
    "questions": {
      "route": {
        "type": "choice",
        "instructions": "어느 팀에서 처리해야 하나요?",
        "criteria": {
          "1": "환불 및 결제",
          "2": "파손 또는 분실 소포",
          "3": "계정 및 로그인 문제"
        }
      },
      "angry": {
        "type": "noul",
        "instructions": "고객이 화가 났나요?"
      }
    }
  }'
Jeff는 한 번의 요청으로 두 질문을 모두 평가합니다. 각 답변에는 확률, 선택된 옵션, 신뢰도 값이 포함됩니다. 애플리케이션에서 선택된 답변을 그대로 사용하거나 자체 신뢰도 임계값을 적용할 수 있습니다.
질문 유형 이해하기
Choice
choice 질문은 최대 255개의 옵션 중 하나를 선택합니다. criteria에는 짧은 식별자를 넣고, 연결된 값으로 각 옵션의 의미를 설명하세요.
"route": {
  "type": "choice",
  "instructions": "어느 팀에서 처리해야 하나요?",
  "criteria": {
    "1": "환불 및 결제",
    "2": "파손 또는 분실 소포",
    "3": "계정 및 로그인 문제"
  }
}
Noul
noul 질문은 예 또는 아니요로 답하는 결정을 확률로 반환합니다. 메시지가 화났는지, 긴급한지, 안전하지 않은지 또는 관련성이 있는지 확인하는 데 유용합니다.
"angry": {
  "type": "noul",
  "instructions": "고객이 화났습니까?"
}
점수
score 질문은 사용자가 설명한 척도에 따라 답변을 배치합니다. 범주형 레이블 대신 등급이 있는 평가가 애플리케이션에 필요할 때 사용합니다.
효과적인 의사 결정 프롬프트 작성
프롬프트의 표현은 소형 분류기에 상당한 영향을 줍니다. Jeff를 사용할 때는 다음 방법이 특히 중요합니다.
- 코드에서 추론하고 Jeff로 결정하세요. 결정론적 규칙, 미래 상태 및 여러 단계의 결과를 애플리케이션에서 계산하세요. 최종 판단을 위해 그 결과를 Jeff에 전달하세요.
- 결과를 직접 설명하세요. 모델에게 자동차가 두 턴 후 도착할 것이라고 예측하게 하는 대신, 특정 이동을 하면 자동차에 치이게 된다고 명시하세요.
- 옵션 설명의 형식을 일관되게 유지하세요. 옵션은 비슷한 구조와 비교 가능한 수준의 세부 정보를 사용해야 합니다. 일관되지 않은 표현은 결정에 편향을 줄 수 있습니다.
- 짧은 옵션 키를 사용하세요. 긴 내부 식별자보다
{"1": "Engagement letter"}를 사용하세요. 긴 키는 옵션 설명을 개선하지 않으면서 처리 비용만 늘립니다. - 서로 독립적인 질문을 결합하세요. 여러 결정이 동일한 상태를 공유한다면 입력을 반복해서 보내지 말고 한 번의 요청으로 전송하세요.
- 대표 데이터를 테스트하세요. 벤치마크 결과는 유용한 참고 자료이지만 특정 워크플로의 성능을 보장하지는 않습니다.
Jeff는 플래너가 아니라 분류기입니다. 코드가 관련 사실을 준비하고 모델이 명확하게 설명된 대안 중 하나를 선택하도록 할 때 가장 잘 작동합니다.
성능 및 제한 사항
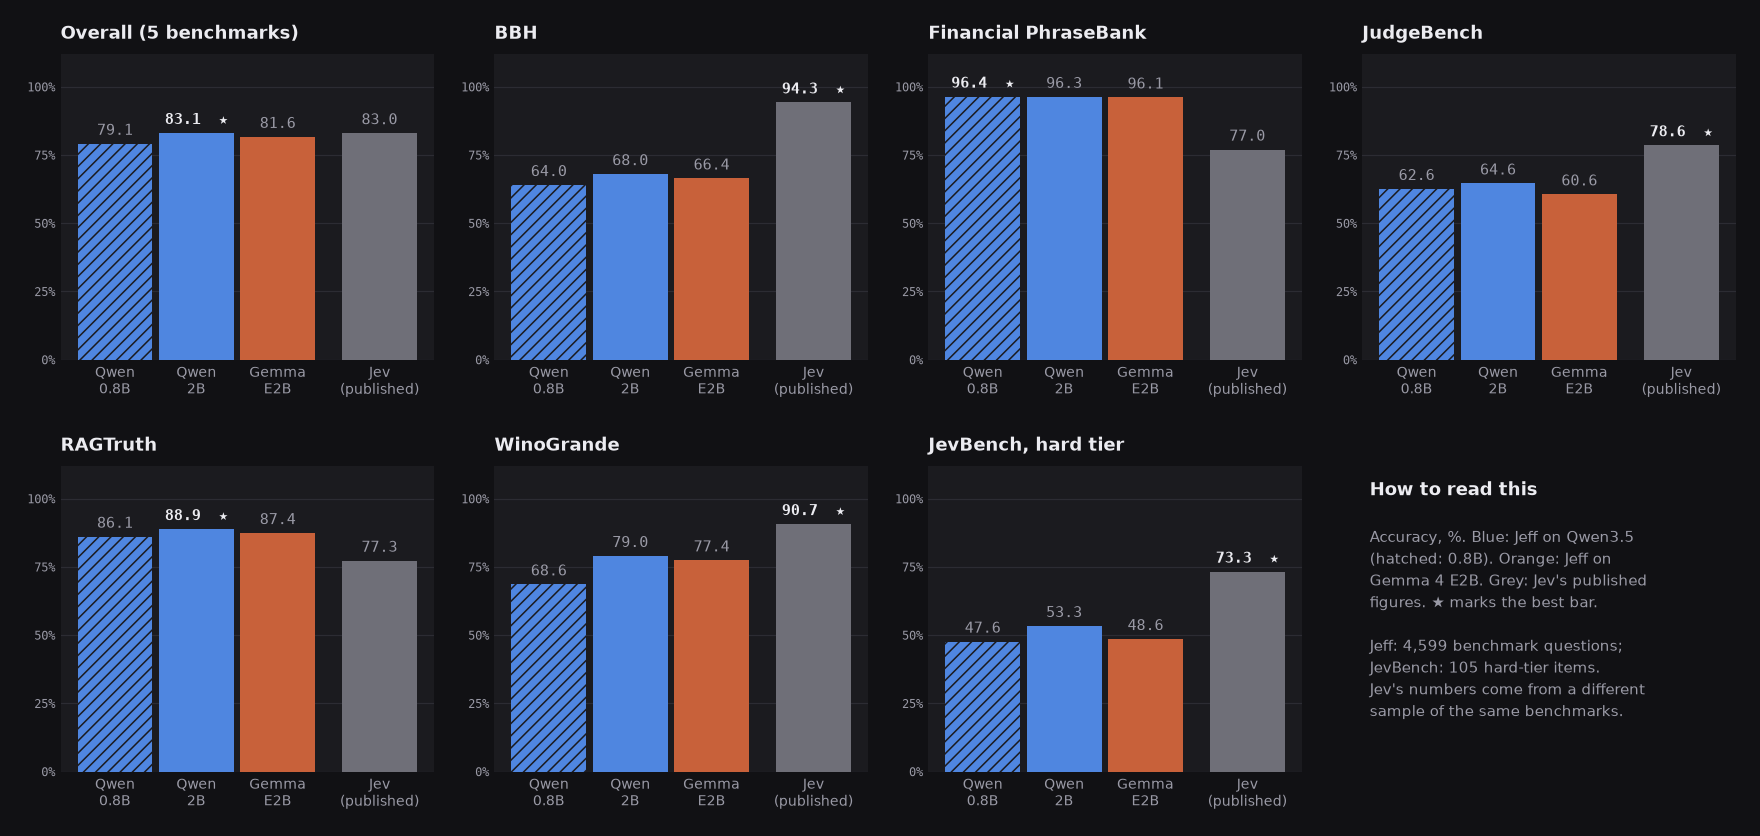
5개의 공개 벤치마크에서 프로젝트 평가 결과 Jeff-Qwen3.5-0.8B는 79.1점, Jeff-Qwen3.5-2B는 83.1점, Jeff-Gemma4-E2B는 81.6점을 기록했습니다. Qwen 2B의 결과는 Jev가 공개한 종합 수치 83.0에 가까웠지만, Jev와 AutoJev의 수치는 동일한 벤치마크에서 서로 다른 샘플을 대상으로 측정되었습니다.
결과는 작업에 따라 크게 달라집니다. Jeff는 Financial PhraseBank 및 RAGTruth를 비롯한 여러 분류 및 그라운딩 평가에서 강력한 성능을 보이지만, BBH, JudgeBench 및 JevBench의 어려운 등급과 같은 추론 중심 벤치마크에서는 여전히 더 큰 시스템보다 낮은 성능을 보입니다.
약 200토큰 입력에 대한 보고된 0.8B 모델의 추론 시간 중앙값은 RTX PRO 6000에서 22ms, MLX를 사용하는 M4 Max에서 28ms, 32스레드 CPU에서 463ms였습니다. 이 수치는 하드웨어에 따라 달라지므로 실제 배포 환경에서 다시 측정해야 합니다.
게임 하네스 사용해 보기
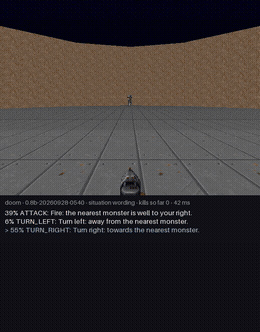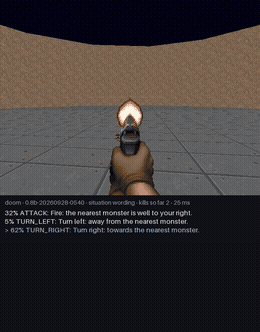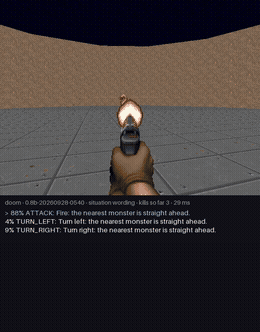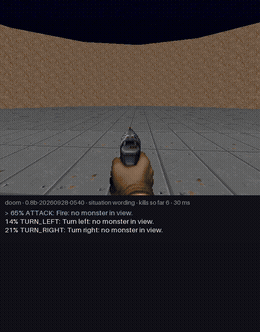
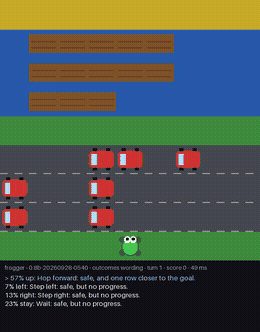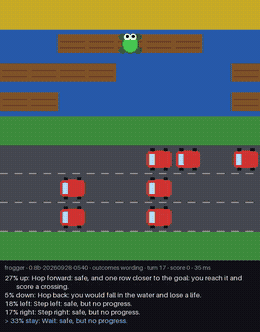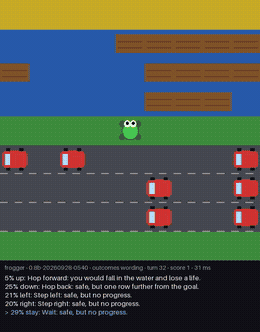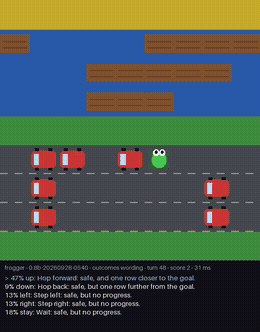
저장소에는 동적으로 설명된 합법적 이동에 대한 결정을 보여 주는 Doom, Frogger 및 Pac-Man 실험이 포함되어 있습니다. 실행하기 전에 선택적 게임 종속성을 설치하세요.
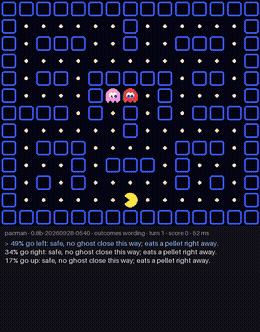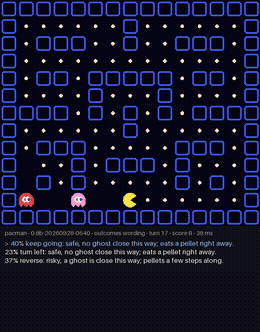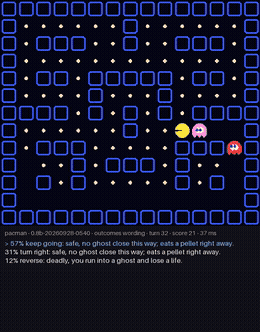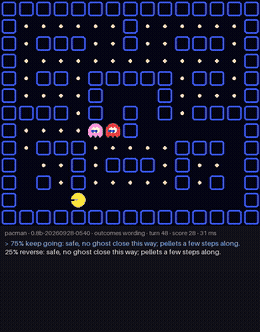
uv sync --extra gamesJeff 서버가 이미 실행 중이라면 제공된 Doom 및 Frogger 평가를 시작할 수 있습니다.
uv run python -m jeff.games --game doom --player jeff --criteria situation --url http://127.0.0.1:8765 --video --out runs/games/doom.json
uv run python -m jeff.games --game frogger --player jeff --criteria outcomes --url http://127.0.0.1:8765 --out runs/games/frogger.json
비교를 위해 규칙 기반 Pac-Man 플레이어를 실행할 수도 있습니다.
uv run python -m jeff.games --game pacman --player rule --out runs/games/pacman-rule.json이 실험은 중요한 한계도 보여 줍니다. 벤치마크 순위가 대화형 게임 성능을 반드시 예측하는 것은 아닙니다. 공개된 결과에서 0.8B Jeff 모델은 여러 사례에서 2B Jeff 모델보다 게임을 더 잘 플레이했습니다. 이는 2B 모델의 종합 벤치마크 점수가 더 높았음에도 나타난 결과입니다.
도메인에 맞게 Jeff 미세 조정하기
제로샷 정확도가 충분하지 않다면 Jeff 체크포인트에서 시작해 애플리케이션의 예제로 학습하세요. README에 따르면 약 11,000개의 애플리케이션별 예제를 사용한 음성 내비게이션 미세 조정으로 한 GPU에서 약 30분 만에 홀드아웃 정확도가 31.7%에서 95.8%로 향상되었습니다.
autojev-train --initial-checkpoint <jeff> --epochs 1 ...저장소는 더 폭넓은 학습 워크플로도 제공합니다. 일반적인 순서는 데이터 혼합을 구성하고, 학습을 실행한 다음, 선택한 체크포인트를 평가하는 것입니다.
uv run autojev-mix ...
scripts/train.sh RUN data/mix/public.jsonl data/mix 5e-6 40 Qwen/Qwen3.5-0.8B <revision> --epochs 1
uv run autojev-evaluate --data data/panel.jsonl --local --checkpoint checkpoints/RUN/selected --output runs/eval/RUN.json
공개된 레시피는 1개 에포크 동안의 전체 가중치 미세 조정, 256개 배치, 옵션 문자에 대한 교차 엔트로피, 확률 보정을 위한 피팅된 온도를 사용합니다. 체크포인트는 벤치마크 패널이 아니라 개발 세트를 사용해 선택합니다.
완전한 로컬 합성 데이터 파이프라인, 누수 필터링, 학습률 스윕 및 대시보드 워크플로는 scripts/train_all.sh를 참조하세요. 프로젝트의 학습 데이터 출처와 라이선스는 docs/data-sources.md에 문서화되어 있습니다.
고급 배포 팁
- 자체 데이터로 측정값을 보정하세요. 보정된 범용 모델이라도 에스컬레이션 또는 대체 동작에 사용할 애플리케이션별 임계값이 필요할 수 있습니다.
- 안전한 대체 경로를 추가하세요. 신뢰도가 너무 낮으면 요청을 사람, 결정론적 규칙 또는 더 뛰어난 모델로 전달하세요.
- 상태를 간결하게 유지하세요. 결정에 필요한 사실을 제공하고, 소형 모델의 집중을 방해할 수 있는 관련 없는 텍스트는 피하세요.
- 표현을 다양하게 평가하세요. 프로덕션 스키마를 확정하기 전에 지침과 기준을 일관되게 표현한 여러 문안을 비교하세요.
- 모델은 실증적으로 선택하세요. 지연 시간에 민감한 옵션 선택에는 0.8B 모델을 사용하되, 적합한 모든 체크포인트를 자체 검증 세트로 테스트하세요.
- 모달리티 제한을 준수하세요. README에 따르면 Jeff는 영어 텍스트만 지원합니다.
결론
Jeff는 자유 형식 텍스트를 생성하거나 파싱하지 않고도 빠른 로컬 확률 기반 의사 결정을 애플리케이션에 추가할 수 있는 실용적인 방법을 제공합니다. Jeff-Qwen3.5-0.8B로 시작하고, 각 옵션을 명확하게 설명하며, 서로 독립적인 질문을 하나의 요청으로 묶고, 실제 애플리케이션 예제로 평가하세요. 제로샷 동작만으로 충분하지 않다면 도메인별 데이터로 기존 Jeff 체크포인트를 파인튜닝하세요.