

WeMM-Embedding이란?
WeMM-Embedding은 WeChat Vision 팀이 개발한 범용 멀티모달 임베딩 모델 제품군입니다. 텍스트, 이미지, 동영상, 시각 문서 및 인터리브된 멀티모달 입력을 통합 벡터 표현으로 변환합니다. 이러한 벡터는 서로 다른 모달리티의 콘텐츠를 표현하고 비교해야 하는 워크플로를 지원할 수 있습니다.
각 모델은 전용 <embedding> 토큰 위치에 있는 마지막 레이어의 은닉 상태에서 임베딩을 추출한 다음 L2 정규화를 적용합니다. 오디오 입력은 현재 지원되지 않습니다.
주요 기능
- 통합 멀티모달 표현: 동일한 모델 제품군이 텍스트, 이미지, 동영상, 시각 문서 및 인터리브된 입력을 처리합니다.
- 다양한 모델 크기: 2B, 4B, 9B 파라미터 변형 중에서 선택할 수 있습니다.
- Matryoshka 표현 학습: 저장 공간이나 검색 효율성이 중요한 경우 지원되는 더 짧은 벡터 차원을 사용할 수 있습니다.
- 두 가지 추론 인터페이스: Transformers와 Sentence Transformers 모두에 대한 예제가 제공됩니다.
- 프로덕션 서빙: 저장소에는 vLLM 및 SGLang용 구성과 래퍼 스크립트가 포함되어 있습니다.
- 평가 도구: 포함된 MMEB-v3 파이프라인은 단일 노드 및 다중 노드 추론을 지원합니다.
모델 및 차원 선택
모델 목록에는 Hugging Face의 세 가지 변형이 포함되어 있습니다. 사용 가능한 컴퓨팅 자원과 필요한 전체 임베딩 크기에 따라 모델을 선택하세요.
- WeMM-Embedding-2B: 64, 128, 256, 512, 1024 및 2048 차원을 지원합니다.
- WeMM-Embedding-4B: 64, 128, 256, 512, 1024 및 2560 차원을 지원합니다.
- WeMM-Embedding-9B: 64, 128, 256, 512, 1024, 2048 및 4096 차원을 지원합니다.
지원되는 차원이 작을수록 벡터 저장 공간과 후속 계산량이 줄어듭니다. 예를 들어 README에 따르면 256차원의 2B 모델은 MMEB-v2에서 전체 차원의 이미지 및 동영상 성능 중 98.7%를 유지합니다.
설치 및 설정
1. 저장소와 모델 가져오기
저장소의 로컬 사본에서 작업한 다음 Hugging Face 페이지에서 모델을 다운로드하거나, 지원되는 경우 관련 예제가 Hugging Face 모델 식별자를 사용하도록 구성하세요.
2. 종속성 설치
프로젝트에 지정된 버전을 설치합니다.
pip install -r requirements.txt3. 재현성을 위해 Transformers 버전 고정
프로젝트는 추론 및 재현성을 위해 transformers==5.2.0 사용을 권장합니다. 이후 릴리스에서는 전처리 동작이 달라질 수 있기 때문입니다.
pip install transformers==5.2.0예제를 실행하기 전에 모델, 테스트 이미지 및 테스트 동영상의 경로를 준비하세요.
Transformers를 사용한 기본 사용법
Transformers 예제는 텍스트, 이미지 및 동영상 입력에 대해 각각 독립적인 임베딩을 생성합니다. 로컬 모델 경로와 지원되는 출력 차원을 지정하여 실행하세요.
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
자리 표시자 경로를 시스템에 있는 파일의 경로로 바꾸세요. 2B 모델에서 2048은 전체 벡터 크기입니다. 차원을 명시하지 않고 모델의 전체 임베딩 차원을 사용하려면 --dimension을 생략하세요.
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4
Sentence Transformers를 사용한 기본 사용법
Sentence Transformers 예제는 SentenceTransformer.encode()를 통해 텍스트, 이미지 및 동영상 입력을 처리합니다. --dimension을 통한 Matryoshka 차원 선택도 지원합니다.
python examples/sentence_transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
--dimension 2048SentenceTransformer는 모델을 직접 로드할 수 있으므로 로컬 경로를 Hugging Face 모델 식별자로 바꿀 수 있습니다.
python examples/sentence_transformers_inference.py \
  --model tencent/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Matryoshka 임베딩 올바르게 사용하기
Matryoshka 임베딩을 사용하면 전체 벡터를 선택한 모델이 지원하는 차원 중 하나로 줄일 수 있습니다. 마지막 축을 잘라낸 다음 축소된 벡터를 다시 정규화하세요.
embedding = torch.nn.functional.normalize(
    embedding[..., :d],
    dim=-1
)d에는 모델에 대해 나열된 차원만 지정하세요. 잘라내면 벡터 노름이 변경되므로 두 번째 정규화 단계가 중요합니다. 제공된 명령줄 예제를 사용할 때는 --dimension으로 원하는 Matryoshka 차원을 선택하세요.
vLLM으로 모델 서빙
저장소에서는 vLLM 0.27.0으로 테스트했다고 설명합니다. 풀링 서버를 시작하고 모델의 임베딩 채팅 템플릿을 지정하세요.
MODEL_PATH=/path/to/WeMM-Embedding-2B
vllm serve "$MODEL_PATH" \
  --runner pooling \
  --chat-template "$MODEL_PATH/embedding_chat_template.jinja"
동일한 기능을 하는 래퍼는 scripts/serve_vllm.sh에서 사용할 수 있습니다.
SGLang으로 모델 서빙
프로젝트에서 문서화한 테스트 버전은 SGLang 0.5.9입니다. 임베딩 서버를 시작하기 전에 제공된 동영상 패치를 적용하세요.
MODEL_PATH=/path/to/WeMM-Embedding-2B
python scripts/patch_sglang_video.py
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --is-embedding \
  --enable-precise-embedding-interpolation
저장소에는 한 번의 명령으로 실행할 수 있는 래퍼인 scripts/serve_sglang.sh도 제공됩니다.
MMEB-v3 평가 실행
mmeb_v3_eval/ 디렉터리에는 보고된 MMEB-v3 결과에 사용된 평가 코드가 포함되어 있습니다. 이 코드는 공식 VLM2Vec 파이프라인을 기반으로 하며 WeMM-Embedding 백본, 정렬된 데이터셋 지침, 배치 추론, 멀티 노드 멀티 GPU 실행, 64프레임 비디오 샘플링을 추가합니다.
먼저 평가 디렉터리로 이동한 다음 데이터를 다운로드합니다.
cd mmeb_v3_eval
DATA_ROOT=/path/to/MMEB-V3 bash scripts/download_data.sh
그런 다음 모델, 데이터셋, 출력 경로를 지정해 평가를 실행합니다.
MODEL_PATH=/path/to/WeMM-Embedding-2B \
DATA_BASEDIR=/path/to/MMEB-V3 \
OUTPUT_DIR=exps/wemm_embedding \
bash scripts/run_eval.sh
문서화된 데이터 설정과 단일 노드 또는 멀티 노드 명령은 mmeb_v3_eval/README.md를 참조하세요.
고급 팁
- 모델에 맞는 차원 사용: 2B 모델에 2560차원을 요청하거나 4B 모델에 4096차원을 요청하지 마세요. 선택한 체크포인트에 나열된 차원만 사용하세요.
- 잘린 벡터 재정규화: 전체 임베딩을 수동으로 줄인 경우 항상 이후에 L2 정규화를 적용하세요.
- 전처리 재현성 유지: 결과를 재현할 때는 권장 Transformers 버전을 사용하세요. 릴리스에 따라 전처리가 변경될 수 있습니다.
- 적절한 로딩 방식 사용: 문서화된 Transformers 명령은 모델 경로를 사용하며, Sentence Transformers 예제에서는
tencent/WeMM-Embedding-2B를 직접 로드할 수도 있습니다. - 지원되지 않는 오디오 고려: 현재 모델은 오디오를 입력으로 받지 않으므로 보고된 MMEB-v3 오디오 점수는 0입니다.
- 편의를 위해 서빙 래퍼 사용:
scripts/의 셸 스크립트는 문서화된 vLLM 및 SGLang 실행 구성을 패키징합니다.
성능 맥락
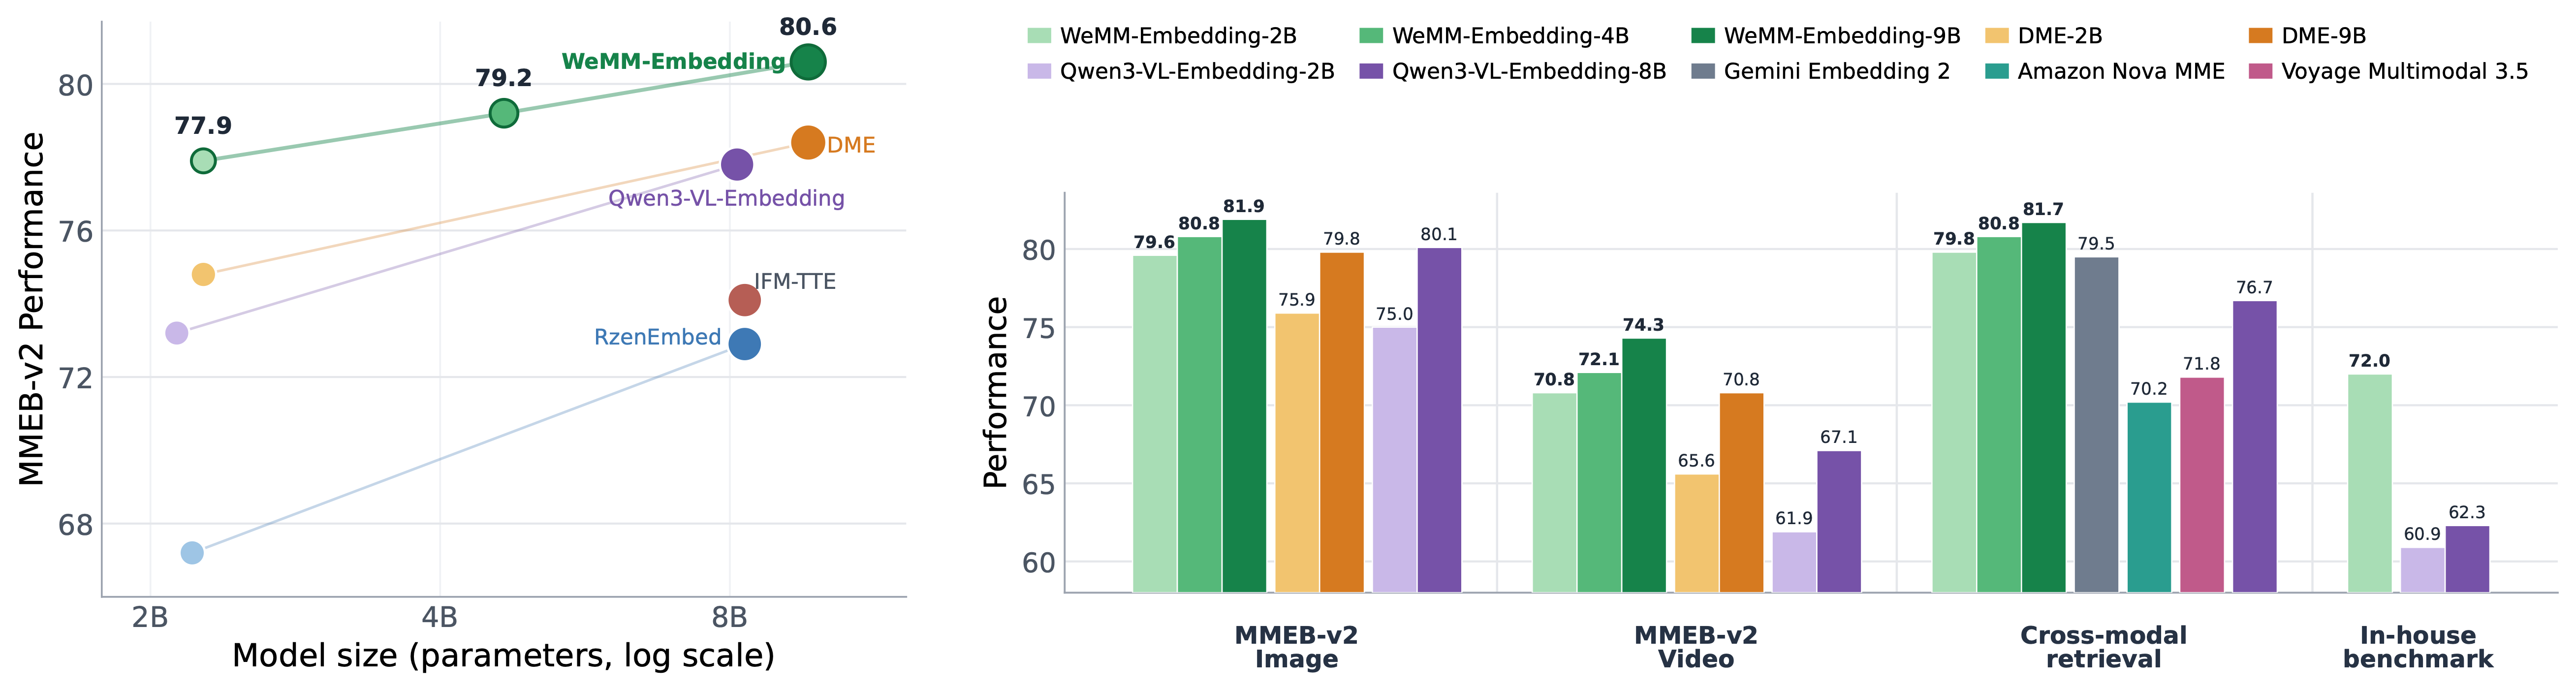
README에는 78개의 MMEB-v2 데이터셋과 전체 190개의 MMEB-v3 태스크에 대한 결과가 보고되어 있습니다. MMEB-v2에서 2B, 4B, 9B 변형의 평균 점수는 각각 77.9, 79.2, 80.6입니다. MMEB-v3에서 보고된 전체 점수는 각각 56.0, 58.2, 59.5입니다. 지표는 태스크 그룹에 따라 다릅니다. 이미지 및 비디오 태스크에는 Hit@1, 시각 문서 및 텍스트 태스크에는 NDCG@5, 에이전트, MCMR, 오디오 태스크에는 Hit@1이 사용됩니다.
벤치마크 점수는 문서에 명시된 태스크 범위를 고려해 해석해야 합니다. MMEB-v3는 WeMM-Embedding에서 지원되지 않는 오디오를 포함한 태스크에 0점을 부여합니다.
결론
WeMM-Embedding은 여러 시각 및 텍스트 입력 유형에서 정규화된 표현을 생성하는 하나의 모델 제품군을 제공합니다. 2B 체크포인트와 제공된 추론 예제로 시작하고, 압축 벡터가 유용할 때 지원되는 Matryoshka 차원을 선택하세요. 서빙이나 평가가 필요하면 vLLM, SGLang 또는 MMEB-v3 파이프라인으로 확장하면 됩니다. 별도의 언급이 없는 한 Tencent가 작성한 저장소 코드는 Apache License 2.0에 따라 공개됩니다.