

DeepInfer-SM80이란?
DeepInfer-SM80은 vLLM V1 엔진을 통해 NVIDIA Ampere GPU에서 DeepSeek-V4.1을 실행하기 위한 최적화된 Python, Triton, TileLang 모듈 모음입니다. 이 프로젝트는 NVIDIA Blackwell을 대상으로 하는 DeepSeek의 DeepInfer에서 핵심 아이디어를 가져와 Ampere 하드웨어의 기능에 맞게 핵심 실행 경로를 재설계했습니다.
이 프로젝트는 tcgen05 워프 그룹 명령어, Tensor Memory, 하드웨어 UE8M0 스케일 명령어, 스트리밍 멀티프로세서당 228KB의 공유 메모리와 같은 Blackwell 전용 기능에 의존하지 않습니다. 대신 Ampere의 mma.sync.aligned.m16n8k16 Tensor Core, SM 인식 스케줄링, 정수 비트 시프트 기반 UE8M0 디코딩, YOCO 공유 KV 재사용을 사용합니다.
데이터센터용 A100 및 A800과 같은 SM80 GPU는 물론, RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10, A30을 포함한 SM86 장치를 지원합니다. 커널은 CTA당 공유 메모리를 최대 48KB만 사용하므로 SM86 장치의 더 낮은 공유 메모리 제한에서도 실행할 수 있습니다.
사용해야 하는 이유
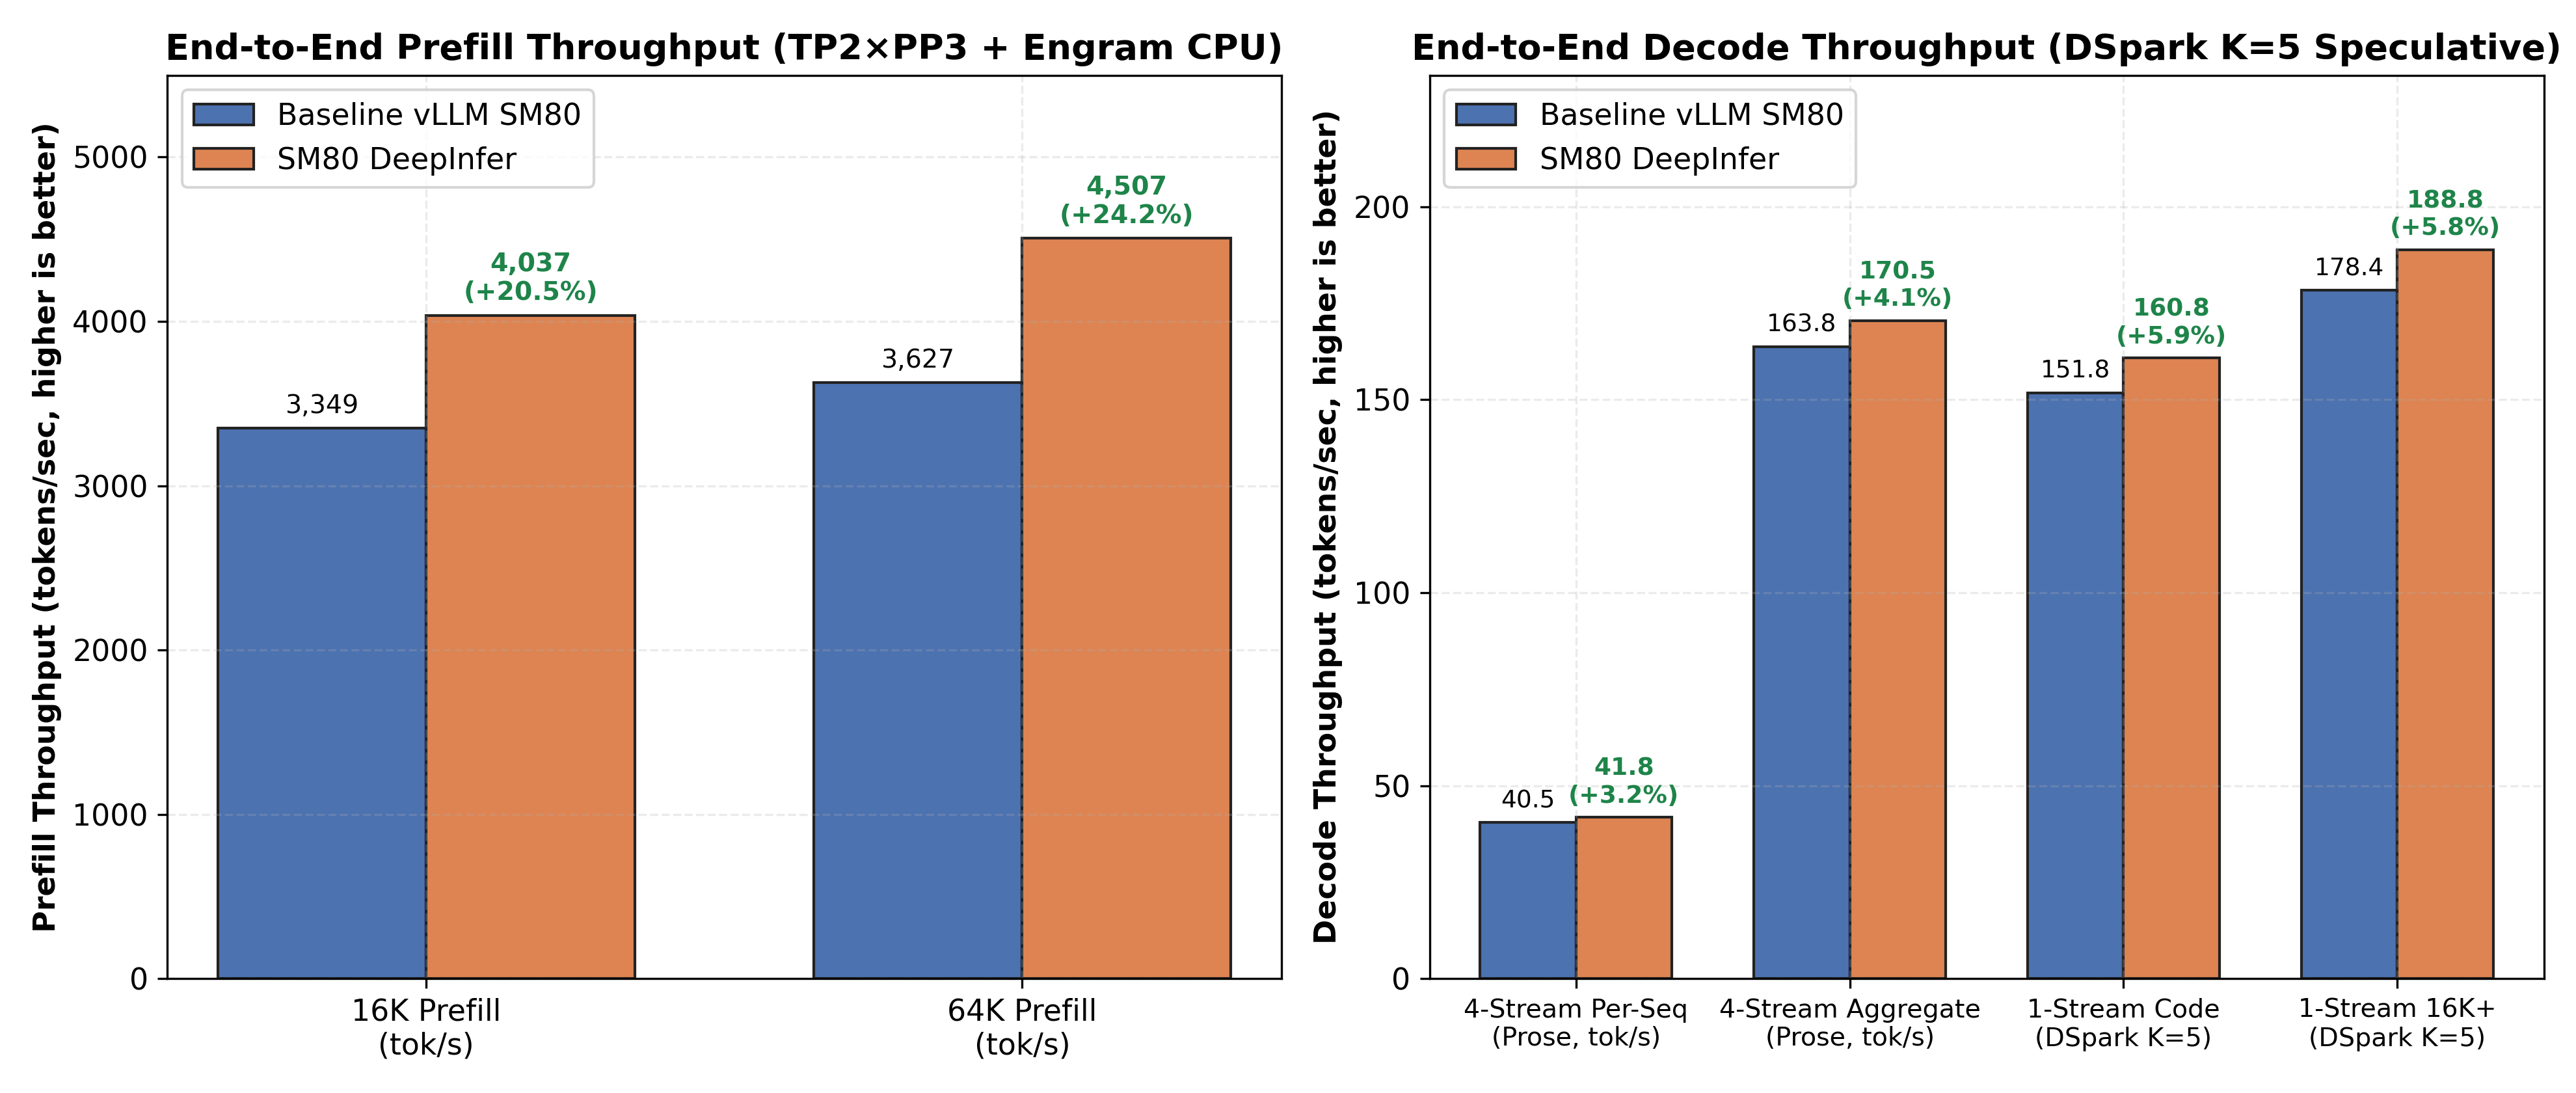
DeepInfer-SM80은 DeepSeek-V4.1 프리필, 희소 어텐션, KV 캐시 액세스, 잔차 라우팅, 긴 컨텍스트 추론에서 비용이 큰 연산에 중점을 둡니다. 저장소는 6개의 GA100 64GB GPU, TP2 × PP3, K=5를 사용하는 DSpark 추측 디코딩, 최대 컨텍스트 길이 1,048,576토큰으로 구성된 프로덕션 설정에서 다음 결과를 보고합니다.
- 16K 콜드 프리필: 초당 4,037.0토큰으로, 기존 초당 3,349.4토큰에서 향상되었습니다.
- 64K 콜드 프리필: 초당 4,506.8토큰으로, 기존 초당 3,627.3토큰에서 향상되었습니다.
- 64K 첫 토큰 생성 시간: 10.7초로, 기존 13.2초에서 단축되었습니다.
- 4개 스트림 추측 디코딩: 총 초당 170.5토큰으로, 기존 초당 163.8토큰과 비교됩니다.
- 단일 스트림 Python 코드 디코딩: 초당 160.8토큰으로, 기존 초당 151.8토큰과 비교됩니다.
- GPU 상주 KV 용량: 4,648,480토큰이며, 기준 구성 대비 추가 VRAM 오버헤드가 없습니다.
이 측정값은 저장소에서 테스트한 하드웨어와 서빙 설정을 기준으로 합니다. 다른 Ampere GPU, 모델 구성, 워크로드 또는 vLLM 환경에서는 결과가 달라질 수 있습니다.
주요 최적화
통합 512차원 희소 MLA
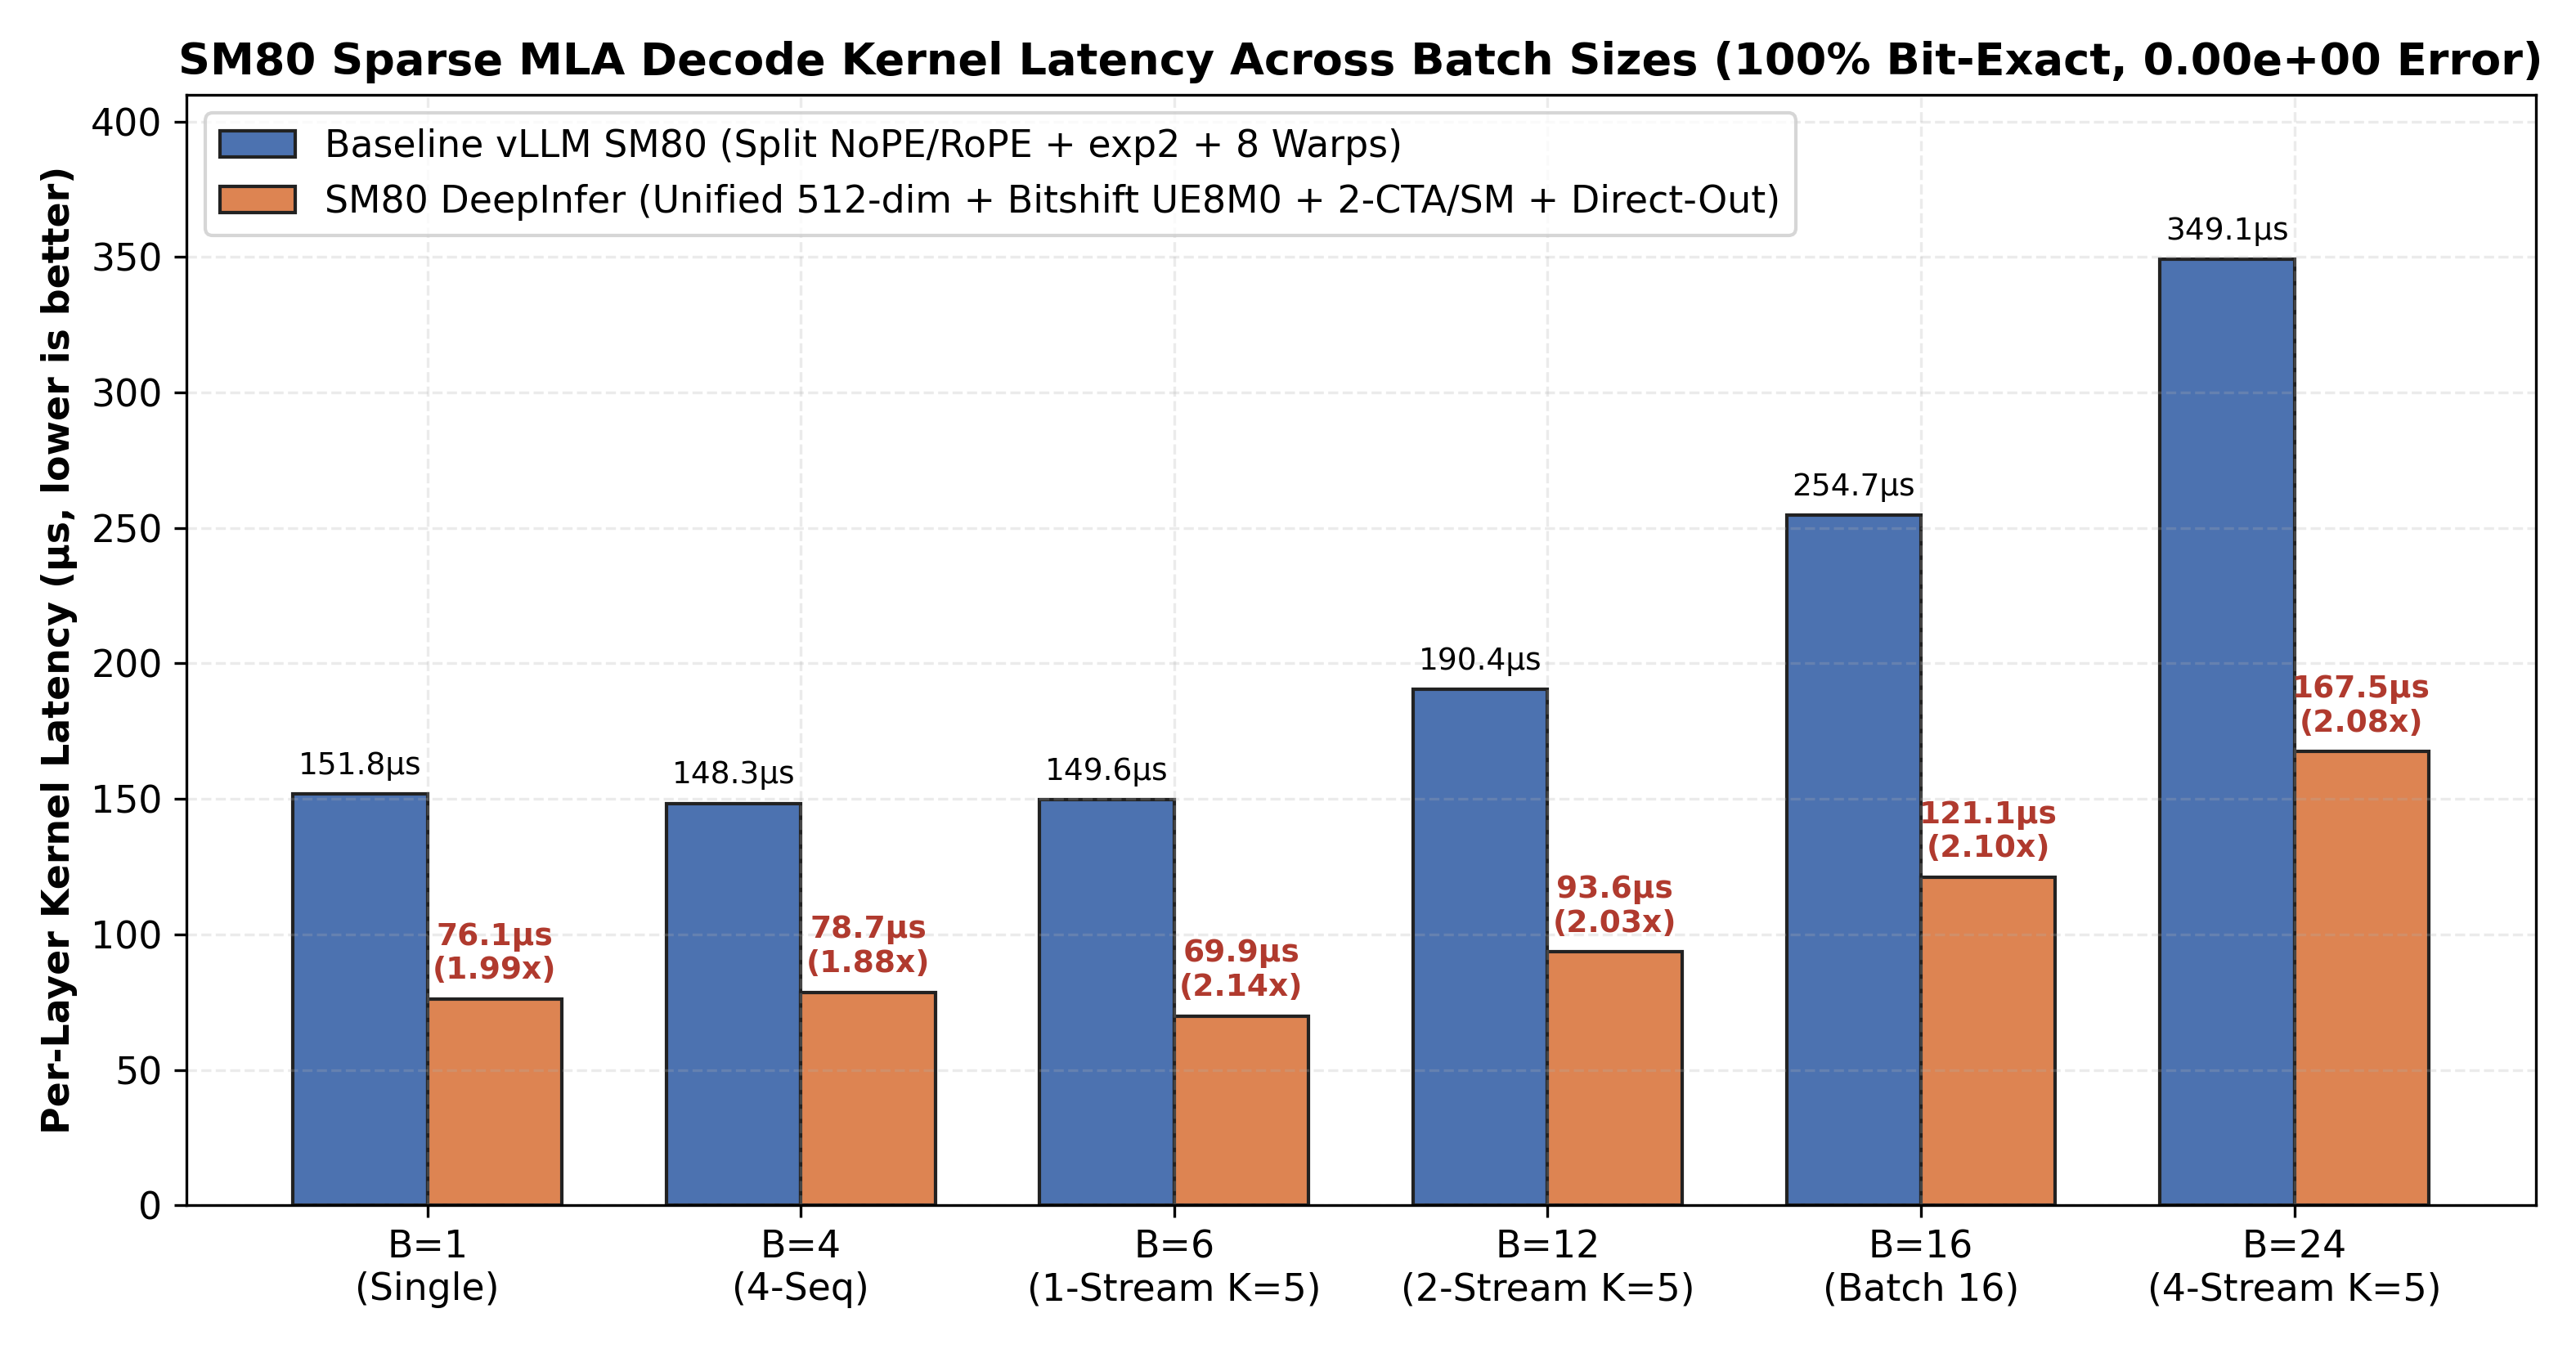
DeepSeek-V4.1의 DeepSelect 희소 어텐션은 UE8M0 2의 거듭제곱 블록 스케일을 사용하는 float8_e4m3fn 형식의 448차원 NoPE 잠재 표현과 64차원 BF16 RoPE 접미부를 저장합니다. DeepInfer-SM80은 전체 512차원 타일을 로드하고 NoPE와 RoPE 부분을 별도로 처리하는 대신 단일 Tensor Core 내적 경로를 통해 처리합니다.
이 커널은 exp2 기반 UE8M0 변환을 IEEE-754 정수 비트 시프트로 대체합니다.
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)유효한 UE8M0 지수의 경우 이 방식은 비트 단위로 동일한 FP32 스케일 값을 생성하면서 연산을 초월 함수 파이프라인에서 정수 파이프라인으로 이동합니다.
튜닝된 구성은 BLOCK_N=64, num_warps=4, num_stages=2를 사용합니다. 레지스터 압력을 줄여 SM80 스트리밍 멀티프로세서마다 두 개의 CTA가 상주할 수 있습니다. num_kv_splits == 1인 경우 커널은 최종 출력에 직접 기록하여 별도의 리덕션 단계 실행을 피합니다.
단일 CTA Top-K 및 SWA 인덱스 결합
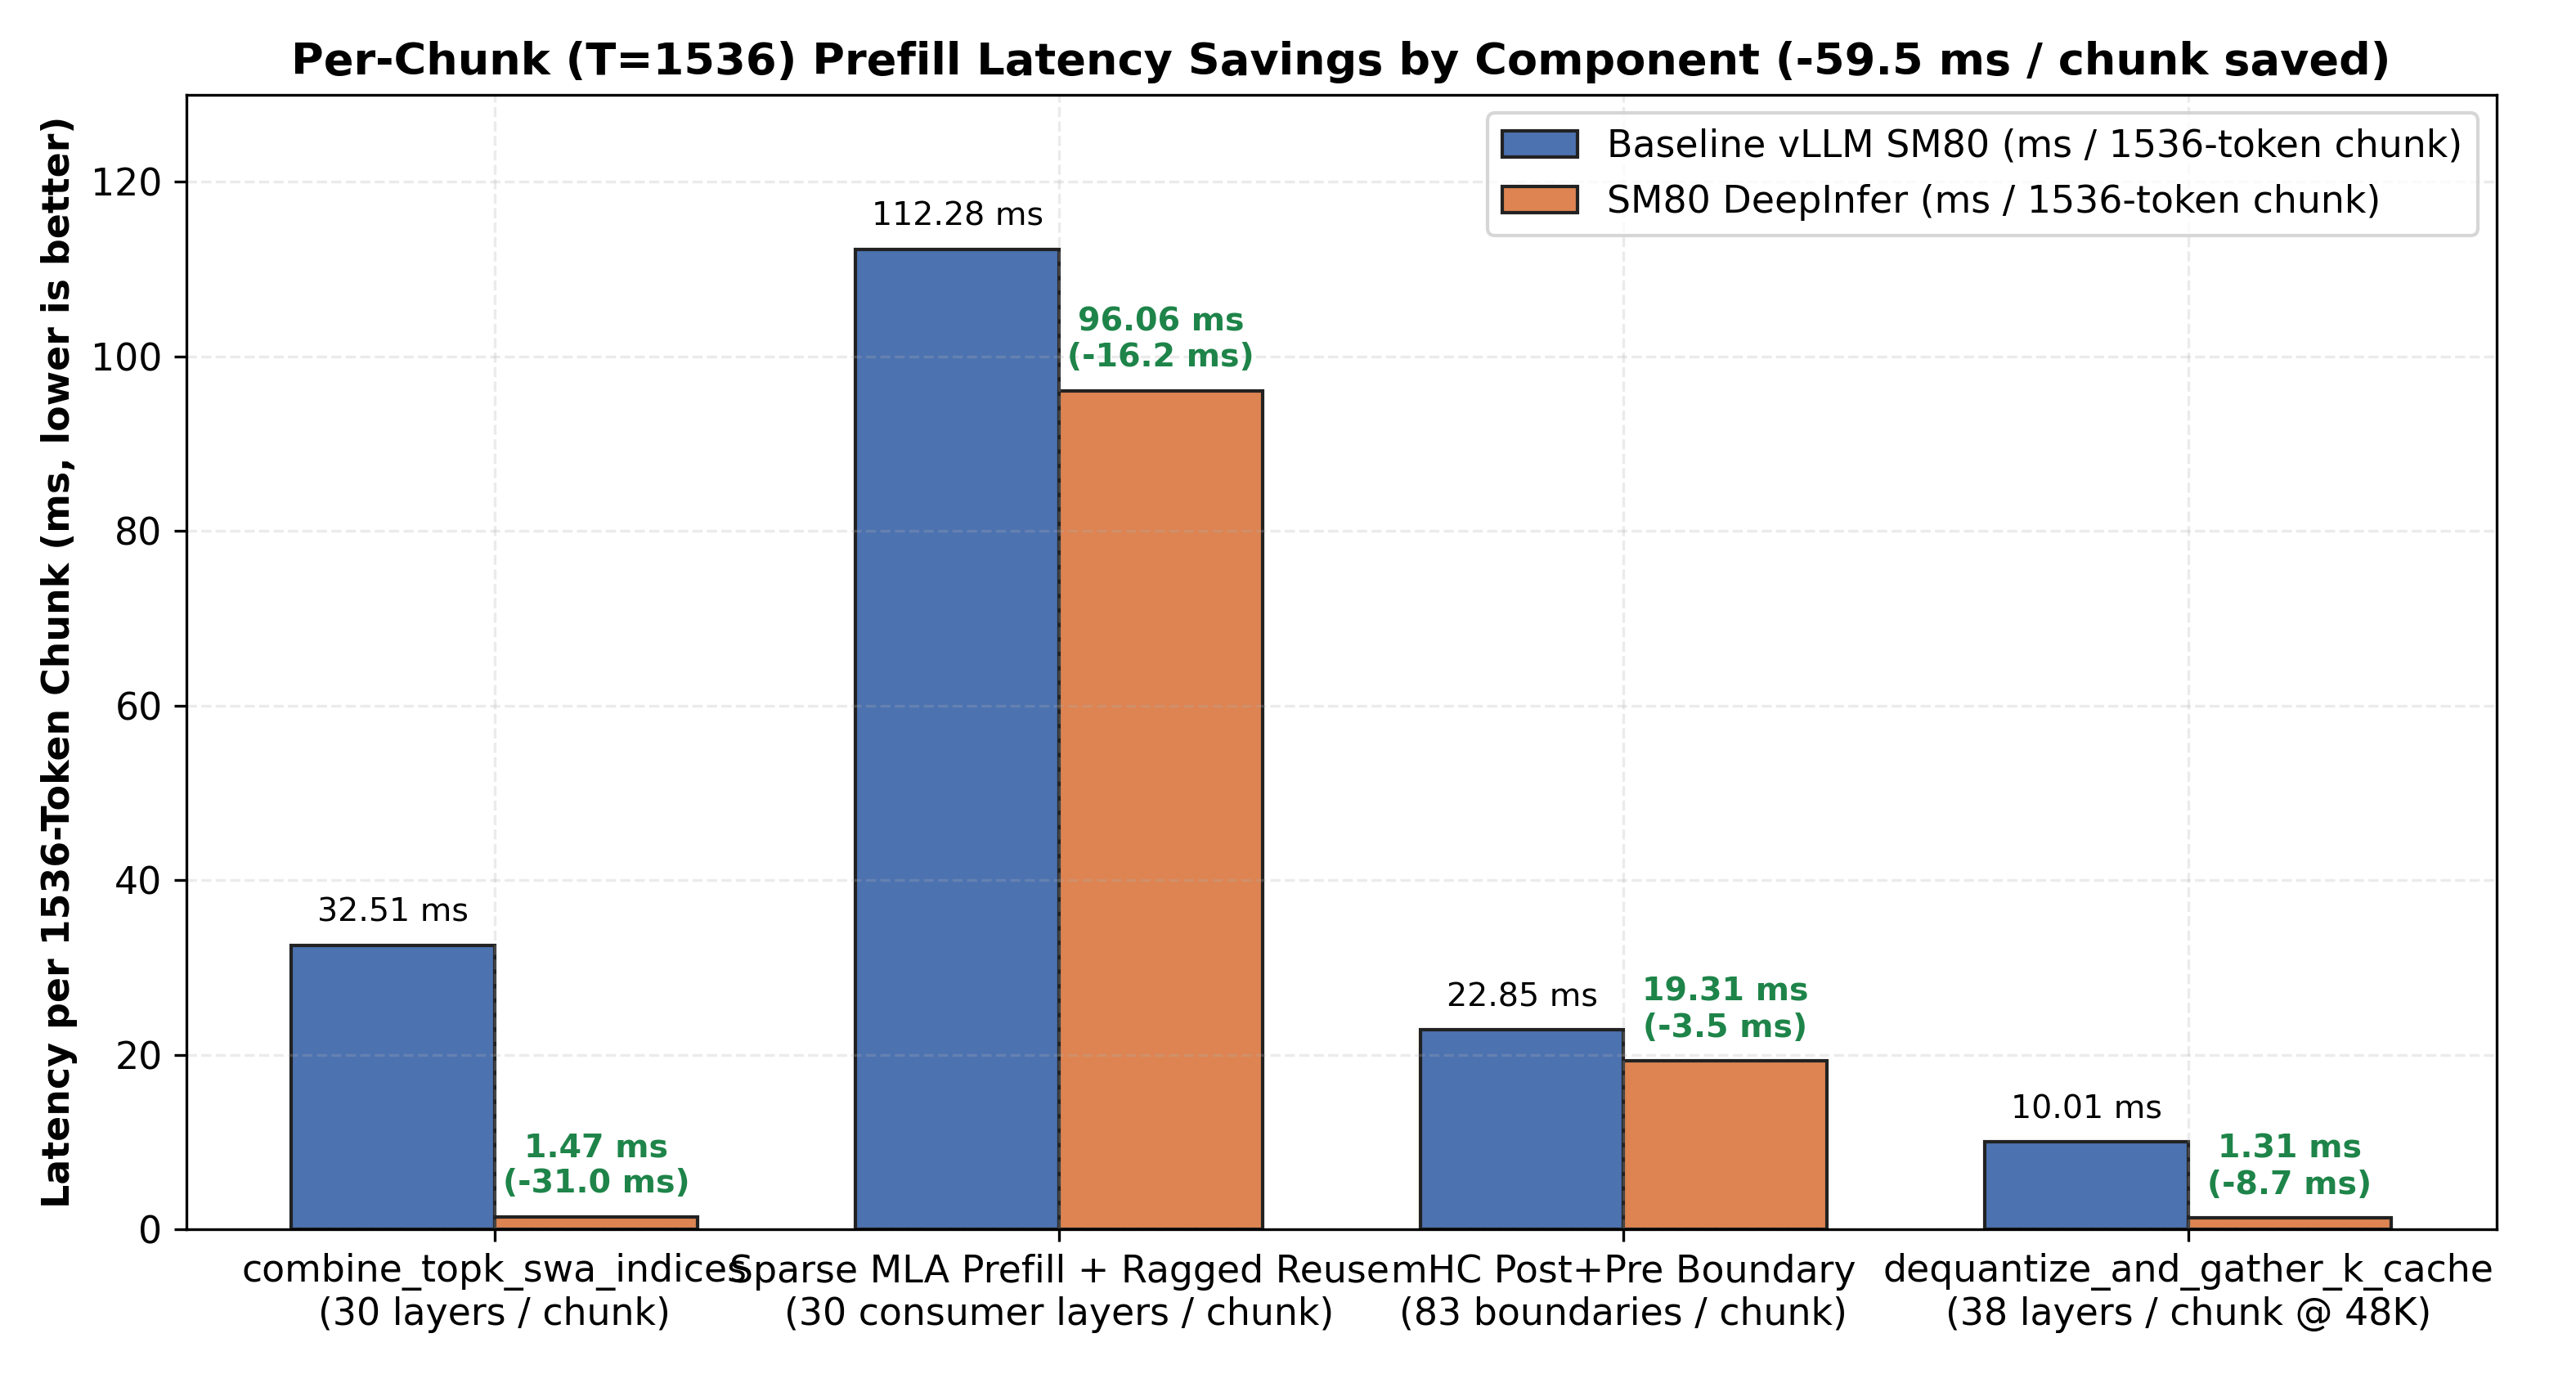
최적화된 _combine_topk_swa_indices_kernel은 여러 PyTorch 할당 및 연산을 쿼리 토큰당 하나의 CTA를 사용하는 단일 Triton 커널로 대체합니다. T=1536에서 측정된 지연 시간은 1,083.72마이크로초에서 48.88마이크로초로 감소하여 22.17배 빨라졌습니다.
워프 간 쓰기 경쟁을 방지하기 위해 각 출력 행을 서로 겹치지 않는 세 영역으로 나눕니다.
- 압축된 Top-K 인덱스는
[0, topk_len)을 차지합니다. - 슬라이딩 윈도우 어텐션 인덱스는
[topk_len, topk_len + swa_len)을 차지합니다. - 나머지 열은
-1로 패딩됩니다.
README는 테스트한 모든 시퀀스 길이와 0, 1, 2의 압축 비율에서 비트 단위로 정확히 일치하는 출력을 보고합니다.
더 빠른 KV 캐시 역양자화 및 수집
dequantize_and_gather_k_cache 경로는 동일한 비트 시프트 기반 UE8M0 변환을 사용합니다. 또한 Triton 커널에 전달된 대상 스트라이드를 사용해 기록하므로 중간 torch.empty 할당과 후속 .copy_() 연산을 제거합니다.
측정된 속도 향상은 16K 컨텍스트에서 4.02배, 48K 컨텍스트에서 7.64배이며, 보고된 테스트에서 기준 구현과 비트 단위로 정확히 일치했습니다.
SM80에 맞게 튜닝된 mHC 잔차 라우팅
DeepSeek-V4.1은 각 순전파 과정에서 83개 경계에 대해 4개 스트림의 다양체 제약 하이퍼 연결 라우팅을 수행합니다. DeepInfer-SM80은 모델의 은닉 크기 5,120에 맞춘 정렬된 (6, 8, 128) 분할 형상을 추가합니다. 8개 슬라이스는 각각 640개 요소를 포함하며, 이는 128로 나누어떨어집니다.
또한 프로젝트는 소행렬 임계값을 32에서 16으로 낮춰 토큰 수가 16 이상이면 Tensor Core T.gemm 경로를 사용할 수 있도록 합니다. 보고된 mhc_fused_post_pre_delayed 속도 향상은 T=12에서 2.89배, T=6에서 1.30배입니다.
YOCO 메타데이터 재사용
DeepSeek-V4.1의 You-Only-Cache-Once 아키텍처에서 21~39번 레이어는 20번 레이어의 전체 해상도 KV 캐시에서 읽습니다. 이러한 소비 레이어들은 확장된 시퀀스 길이, 블록 테이블, 압축 비율을 공유합니다.
DeepInfer-SM80은 20번 레이어를 처리할 때 비정형 K 메타데이터를 vLLM 정방향 컨텍스트에 저장합니다. 이 데이터를 21~39번 레이어에서 재사용하면 프리필 청크마다 중복된 메타데이터 생성 GPU 커널 체인 19개를 제거할 수 있습니다.
설치 전 준비
지원되는 NVIDIA Ampere GPU에서 DeepSeek-V4.1을 실행할 vLLM V1 환경이 필요합니다. 이 저장소는 통합 패치와 6개의 교체 모듈을 제공하지만, README에는 CUDA, Python, Triton, TileLang 또는 vLLM의 정확한 버전이 지정되어 있지 않습니다. 패치 및 기존 DeepSeek-V4.1 배포 환경과 호환되는 vLLM 체크아웃을 사용하세요.
지원되는 하드웨어 그룹은 다음과 같습니다.
- SM80 데이터센터 GPU: A100 40 GB, A100 80 GB, GA100 64 GB, A800 40 GB 또는 80 GB.
- SM86 워크스테이션 및 소비자용 GPU: RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10, A30.
소프트웨어는 Apache License 2.0에 따라 배포됩니다.
설치 옵션 A: 통합 패치 적용
이 방법은 수정된 6개 파일을 vLLM 소스 체크아웃에 모두 적용합니다. 해당 체크아웃의 루트 디렉터리에서 터미널을 열고 다음을 실행하세요.
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patch/path/to/Deepinfer-SM80을 복제하거나 다운로드한 프로젝트의 위치로 바꾸세요. 이 패치에는 희소 MLA, 캐시 수집, Top-K 및 SWA, mHC, 워밍업, YOCO 메타데이터 재사용 변경 사항이 포함되어 있습니다.
설치 옵션 B: 드롭인 모듈 설치
환경에 따라 파일을 직접 교체하는 편이 적합하다면 프로젝트의 vLLM 모듈 트리를 설치된 vLLM 패키지 위에 복사하세요.
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm//path/to/site-packages/vllm/을 실제 vLLM 패키지 디렉터리로 바꾸세요. Docker 배포에서는 동일한 파일을 읽기 전용 오버레이로 바인드 마운트할 수도 있습니다.
드롭인 트리는 다음 기능 영역을 수정합니다.
model_executor/kernels/mhc/: TileLang mHC 실행 및 워밍업.models/deepseek_v4_1/amd/rocm.py: Triton Top-K 및 SWA 결합기.models/deepseek_v4_1/common/ops/cache_utils.py: KV 캐시 수집.models/deepseek_v4_1/nvidia/model.py: YOCO 메타데이터 재사용.v1/attention/ops/rocm_aiter_mla_sparse.py: 통합 희소 MLA 커널.
최적화된 파일 2개의 경로에
rocm또는amd가 포함되어 있지만, 저장소에서는 해당 파일을 Ampere 대상 vLLM 통합의 일부로 명시적으로 사용합니다. 드롭인 파일을 적용할 때 제공된 디렉터리 구조를 유지하세요.
기본 사용법: 커널 검증
패치 또는 드롭인 모듈을 설치한 후 대상 A100, A800, RTX 3090, RTX A6000 또는 기타 지원되는 Ampere GPU에서 제공된 독립형 마이크로벤치마크를 실행하세요.
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
벤치마크 파일은 희소 MLA 및 KV 수집 커널, TileLang mHC 커널, Top-K 및 SWA 결합기를 다룹니다. 목적은 로컬 커널 지연 시간을 측정하고 최적화된 출력을 기준 구현과 비교해 검증하는 것입니다.
다음 명령으로 저장소의 벤치마크 차트를 생성하세요.
python3 benchmarks/generate_charts.py전체 벤치마크 데이터 세트는 benchmarks/results/sm80_benchmark_summary.json에서도 확인할 수 있습니다.
수치 검증 이해하기
여러 최적화 경로는 비트 단위로 동일한 결과를 내는 것으로 보고되었습니다.
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
다른 Tensor Core 경로에서는 BF16 누적 또는 MMA 실행 순서가 달라질 수 있으므로 결과가 약간 달라질 수 있습니다. 측정된 융합 mHC 구성의 최대 차이는 1.9e-3 미만이며, 측정된 희소 어텐션 프리필 구성에서는 4.8e-3 미만입니다.
프롬프트 로그확률의 음의 로그 가능도 결과는 실행 간 변동 범위 내에 유지되었습니다. 배포 환경을 평가할 때는 모든 최적화 연산자가 비트 단위로 동일하다고 가정하지 말고 성능과 수치 출력을 모두 확인하세요.
고급 배포 팁
테스트된 6-GPU 프로덕션 구성에는 TP2 × PP3 사용
64 GB 또는 80 GB Ampere GPU 6개를 사용하는 경우, 저장소에서는 14,14,12 레이어 분할과 함께 TP2 × PP3를 권장합니다. 테스트 구성에서 이 배치는 선택된 단일 스트림 코드 및 긴 생성 워크로드에서 초당 160.8~188.8토큰, 64K 콜드 프리필에서 초당 4,506.8토큰, 약 465만 개의 GPU 상주 KV 토큰 용량을 제공했습니다.
이 용량은 벤치마크 구성에서 100만 토큰 컨텍스트 약 4.43개에 해당합니다.
대안 이해하기
- PP6: 약 450만~470만 토큰의 용량을 제공하지만, 텐서 병렬화가 1이고 요청이 6개의 파이프라인 스테이지를 통과하므로 단일 스트림 디코드가 상당히 느려진다고 README에 설명되어 있습니다.
- 비대칭 TP2 및 TP4: 예상 용량을 약 600만 토큰으로 늘리지만, MoE 중간 크기 2,304를 폭 576의 TP4 파티션으로 나누면 Marlin 타일 효율이 저하됩니다.
1백만 토큰 배포를 위한 토폴로지를 선택하기 전에 저장소의 docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md를 참조하세요.
실제 워크로드 벤치마크
가장 큰 성능 향상은 자주 호출되는 연산자에서 나오지만, 엔드투엔드 개선 효과는 프롬프트 길이, 동시성, 추측 디코딩, 토폴로지, GPU 모델에 따라 달라집니다. 먼저 격리된 벤치마크를 실행한 다음, 프로덕션 애플리케이션과 동일한 프롬프트, 컨텍스트 크기, 동시성 수준을 사용해 전체 서빙 워크로드를 비교하세요.
직접 출력 고속 경로 유지
희소 MLA 디코드 최적화는 num_kv_splits == 1일 때 두 번째 리덕션 실행을 건너뜁니다. 어텐션 스케줄링이나 분할 동작을 수정하는 경우 커널을 다시 측정하세요. 직접 출력 경로는 보고된 디코드 성능 향상의 중요한 요소이기 때문입니다.
YOCO 메타데이터를 Forward Context에 유지
레이어 20의 메타데이터 캐시가 유용한 이유는 레이어 21–39의 모든 소비자가 동일한 KV 소스를 공유하기 때문입니다. 모델 실행 또는 forward context 처리를 변경할 때 이 재사용을 유지해야 합니다. 그렇지 않으면 엔진이 각 소비자 레이어에 대해 동일한 가변 길이 메타데이터를 반복해서 재구성할 수 있습니다.
결론
DeepInfer-SM80은 KV 캐시 VRAM 오버헤드를 추가하지 않고 NVIDIA Ampere에서 DeepSeek-V4.1을 가속하는 데 집중된 경로를 제공합니다. 이 최적화는 Ampere를 고려한 희소 어텐션, 비트시프트 UE8M0 디코딩, 직접 KV 캐시 출력, 경쟁 조건이 없는 Top-K 및 SWA 결합기, 정렬된 mHC 라우팅, YOCO 메타데이터 재사용을 결합합니다.
통합 패치를 적용하거나 6개의 드롭인 모듈을 설치하는 것부터 시작하세요. 세 가지 마이크로벤치마크 모음을 모두 실행해 하드웨어에서 지연 시간과 수치 동작을 확인한 다음, 실제 서빙 워크로드로 최적화된 vLLM 환경을 평가하세요. 6개 GPU와 1백만 컨텍스트를 사용하는 배포에서는 저장소에서 테스트된 TP2 × PP3 구성을 주요 기준점으로 사용하세요.