

AIBuildAI LLM-Post-Train Agent란?
AIBuildAI LLM-Post-Train Agent는 대규모 언어 모델의 자동화된 맞춤형 포스트 트레이닝을 수행하는 재귀적 자기 개선 에이전트입니다. 하나의 고정된 학습 레시피를 적용하는 대신, 작업을 분석하고, 후보 포스트 트레이닝 알고리즘을 설계하며, 학습 데이터를 수집하고 정제하고, 코드를 작성하고, 실험을 실행하고, 결과를 평가한 뒤 모델을 반복적으로 개선합니다.
이 저장소에는 에이전트를 실행하고, 분석하고, 수정하는 데 필요한 소스 코드가 포함되어 있습니다. 독점 데이터, 모델 제품군, 평가 절차, 배포 목표에 맞춘 포스트 트레이닝 전략이 필요한 조직과 연구자를 위해 설계되었습니다.
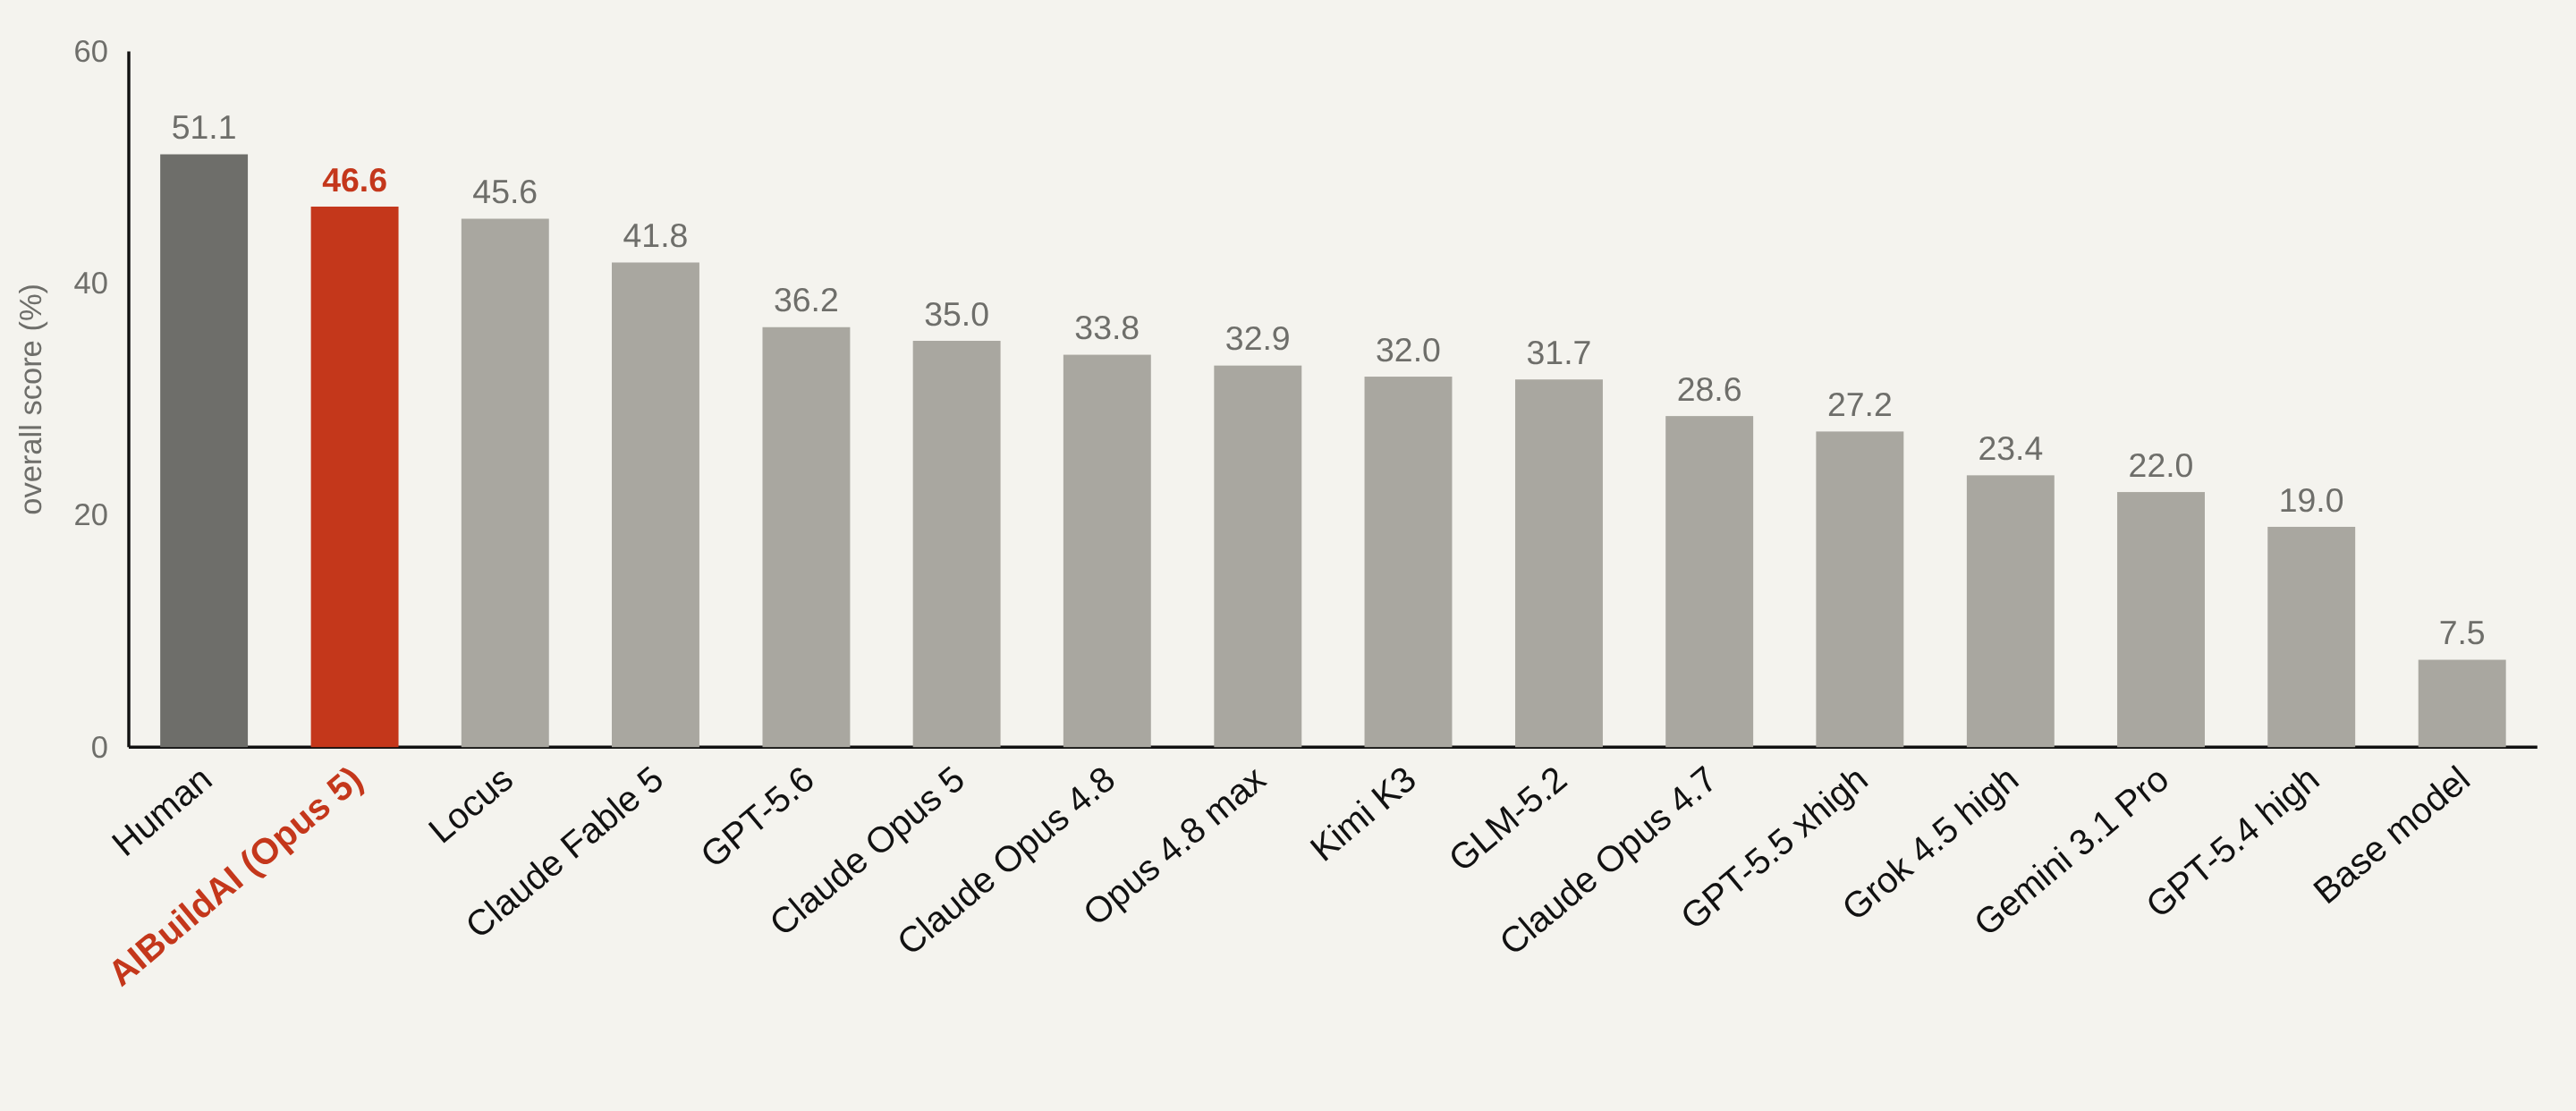
PostTrainBench에서 이 프로젝트는 종합 점수 46.6%를 기록해 평가된 모델과 에이전트 중 1위를 차지했으며, 인간 전문가 기준 점수 51.1%에 이어 두 번째로 높은 성과를 보였습니다.
에이전트 작동 방식
실행은 작업과 점수 산정 절차로 시작됩니다. 시스템은 변경할 수 없는 작업 설명을 준비하고, 기준선을 설정하고, 실험을 시작하며, 동일한 점수 프로그램으로 완료된 각 후보를 평가하고, 가장 우수한 결과를 산출물로 변환합니다.
다음 두 가지 기능이 이 시스템을 일반적인 코딩 에이전트와 구별합니다.
- 지식 시스템: 에이전트는 MCP를 통해 AIBuildAI Knowledge Base를 조회할 수 있습니다. 엄선된 스킬 문서에는 포스트 트레이닝 워크플로, 방법론, 데이터셋, 프레임워크가 정리되어 있습니다.
- 메타 검색: 메타 에이전트는 미리 정해진 실험 토폴로지를 실행하는 대신 작업을 조사하고 해당 작업에 특화된 검색 프로그램을 작성할 수 있습니다.
또한 모든 실행에는 실시간 웹 작업 공간, 영구 실행 그래프, 작업 일지 단위, 샌드박스 처리된 하위 프로세스, 리소스 제어 기능이 제공됩니다. 실행 이벤트는 ~/.aibuildai/postgresql 아래의 전용 PostgreSQL 클러스터에 저장되므로 실행을 재개하거나 재현할 수 있습니다.
주요 기능
- LLM 포스트 트레이닝 실험의 자동 설계 및 실행.
- 메타 검색과 여러 고정 검색 방법을 포함한 작업별 검색 전략.
- 방법론, 데이터셋, 프레임워크, 워크플로 의사결정을 위한 지식 검색.
- 타입이 지정된 에이전트, 결정론적 프로그램, 중첩 검색.
- 작업에서 정의한 평가와 일관된 후보 순위 산정.
- 로컬 작업 공간 서비스를 통한 실시간 브라우저 기반 모니터링.
- 메모리 및 프로세스 제한을 위한 Bubblewrap 샌드박스와 cgroup-v2.
- 이전 실행에서 생성된 로컬 메모리.
- 집계 후 선택적으로 제공되는 논문 초안 작성 및 PDF 컴파일.
- Claude 및 Anthropic 호환 엔드포인트를 통해 제공되는 기타 모델 지원.
시스템 요구 사항
프로젝트를 설치하기 전에 호스트가 다음 요구 사항을 충족하는지 확인하세요.
- systemd 사용자 세션이 있는 x86_64 Linux.
- Python 3.11~3.13.
gcc와make를 포함한 C 도구 체인.- zlib 및 readline 개발 헤더.
bubblewrap패키지에서 제공하는bwrap과 활성화된 비권한 사용자 네임스페이스.- GitHub 릴리스 및
ftp.postgresql.org에 대한 네트워크 액세스. - Claude Code 로그인, Anthropic API 키 또는 Anthropic 호환 엔드포인트를 통해 사용할 수 있는 다른 모델.
- CUDA GPU를 권장하지만, 에이전트가 사용 가능한 하드웨어를 감지하여 활용합니다.
첫 실행에서는 공식 소스 tarball에서 전용 PostgreSQL 설치를 빌드합니다. 또한 ruff, tectonic, micromamba, caddy, PostgreSQL 등의 도구를 고정된 버전으로 ~/.cache/aibuildai에 다운로드합니다. 시스템은 호스트에 설치된 동등한 도구 대신 자체 관리되는 사본을 사용합니다.
conda는 필요하지 않습니다. 에이전트는 자체 관리되는 micromamba 설치를 사용해 Program 환경을 생성합니다.
cgroup-v2 위임 확인
실행은 하나의 cgroup-v2 트리로 제한됩니다. systemd 사용자 관리자는 최소한 memory 및 pids 컨트롤러를 위임해야 합니다. 다음 명령으로 현재 구성을 확인하세요.
U=$(id -u)
cat /sys/fs/cgroup/user.slice/user-$U.slice/user@$U.service/cgroup.subtree_control
출력에 memory와 pids가 포함되어야 합니다. 둘 중 하나라도 없으면 관리자가 /etc/systemd/system/user@$U.service.d/ 아래의 드롭인 파일에 Delegate=pids memory cpu를 추가하고, systemd를 다시 로드한 뒤 사용자가 다시 로그인해야 합니다.
에이전트 설치
1. 운영 체제 패키지 설치
Debian 또는 Ubuntu에서는 컴파일러, 필수 헤더, bubblewrap을 설치하세요.
sudo apt-get install build-essential zlib1g-dev libreadline-dev bubblewrap2. 저장소 복제
git clone https://github.com/aibuildai-inc/aibuildai-llm-posttrain-agent.git
cd aibuildai-llm-posttrain-agent
3. Python 가상 환경 생성
python -m venv .venv
source .venv/bin/activate
4. 고정된 종속성 설치
pip install -r requirements.lock
pip install -e . --no-deps
편집 가능한 설치를 통해 aibuildai 명령을 사용할 수 있습니다. 이 코드베이스에서 검증된 버전은 고정된 claude-agent-sdk 버전이므로 lock 파일을 사용하세요.
저장소를 수정하고 품질 검사를 실행할 계획이라면 개발 종속성도 설치하세요.
pip install -r requirements-dev.lock5. 자체 관리 도구를 선택적으로 준비
도구는 첫 실행 중 다운로드 및 빌드할 수 있습니다. 미리 준비하려면 다음을 실행하세요:
aibuildai setup모델 액세스 구성
옵션 1: Claude Code 로그인 사용
claude auth login옵션 2: API 키 제공
export AIBUILDAI_API_KEY=sk-ant-...AIBUILDAI_API_KEY가 설정되지 않은 경우 애플리케이션은 먼저 ANTHROPIC_AUTH_TOKEN을 확인한 다음 ANTHROPIC_API_KEY를 확인합니다.
다른 Anthropic 호환 엔드포인트 사용
AIBUILDAI_BASE_URL을 엔드포인트로 설정하고 해당 키를 AIBUILDAI_API_KEY에 입력하세요:
export AIBUILDAI_BASE_URL=https://openrouter.ai/api
export AIBUILDAI_API_KEY=your-key
export AIBUILDAI_SMALL_FAST_MODEL=provider/model-iddeepseek-로 시작하는 단순 모델 식별자는 자동으로 DeepSeek의 Anthropic 호환 엔드포인트를 대상으로 합니다. OpenRouter 모델 식별자에는 제공업체 접두사가 포함되며 AIBUILDAI_BASE_URL과 AIBUILDAI_SMALL_FAST_MODEL을 모두 설정해야 합니다.
엔드포인트가 Claude 모델 등급에 다른 이름을 사용하는 경우 AIBUILDAI_HAIKU_MODEL, AIBUILDAI_SONNET_MODEL, AIBUILDAI_OPUS_MODEL로 매핑하세요. 하위 에이전트가 역할에 구성된 모델과 다른 모델을 실행해야 하는 경우 AIBUILDAI_SUBAGENT_MODEL을 사용하세요.
선택적 서비스 설정
AIBUILDAI_KB_BASE_URL은 지식 베이스 MCP 서비스를 선택합니다. 기본적으로 클라이언트는 프로젝트의 공개 고정 스냅샷을 사용합니다.AIBUILDAI_KB_TOKEN은 지식 서비스에 인증이 필요한 경우 bearer 토큰을 제공합니다.AIBUILDAI_WEB_PORT는 로컬 워크스페이스 서비스 포트를 선택합니다.AIBUILDAI_WEB_NAME은 동일한 호스트에서 실행되는 두 번째 워크스페이스 서비스의 이름을 지정하며, 웹 포트를 명시적으로 설정해야 합니다.
기본 실행 생성 및 시작
각 실행은 하나의 YAML 파일로 설명합니다. 문서가 포함된 시작 구성을 생성하려면 다음을 실행하세요:
aibuildai config > task.yaml생성된 파일에는 모든 구성 필드, 기본값 및 해당 문서가 포함됩니다. 필수 최상위 섹션은 run, llm, work_units, search, resources이며, 시작 구성 파일에는 이 섹션들이 채워져 있습니다.
다음 명령으로 실행을 시작하세요:
aibuildai run task.yaml이 명령은 http://127.0.0.1:<port>/run/<run-id>와 유사한 워크스페이스 URL을 출력합니다. URL을 열어 실행을 실시간으로 확인하세요. 브라우저는 선택 사항이며, 브라우저 없이도 정상적으로 실행이 계속됩니다.
GSM8K 예제 실행
포함된 예제는 GSM8K의 초등학교 수준 수학 문장제 문제를 풀도록 Qwen/Qwen3-1.7B-Base를 추가 학습합니다. 저장소에 따르면 이 예제는 GPU 1개에서 약 2시간이 걸립니다.
1. 작업 폴더 빌드
bash examples/gsm8k-qwen3-1.7b-base/setup.sh ~/gsm8k-example설정 과정에서 기본 모델 가중치와 GSM8K의 두 분할을 포함해 약 4GB를 다운로드합니다. 작업 설명과 고정된 채점기를 ~/gsm8k-example/task/에 기록하고, 실행 자체의 Program 환경에 설치되는 패키지를 위해 pip 캐시를 미리 준비합니다.
생성된 작업 폴더에는 에이전트가 조정할 수 있는 기본 가중치, 학습 문제 7,473개, 채점기, 그리고 해당 채점기가 읽는 1,319개 문제의 테스트 분할이 포함됩니다.
2. 추가 학습 시작
aibuildai run ~/gsm8k-example/task.yaml이 예제는 메타 검색, 90분의 탐색 시간 제한, 그리고 이에 맞춘 에이전트별 예산을 사용합니다. README에서는 실제 실행을 위해 해당 예산을 늘릴 것을 권장합니다.
3. 채점 계약 이해
채점기가 성공 여부를 완전히 정의합니다. 채점기는 질문과 답변 접두사를 차례로 모델에 입력하고, 탐욕적으로 디코딩한 뒤 마지막 #### 뒤의 숫자를 추출합니다. README에 따르면 조정되지 않은 기본 모델은 처음부터 요구된 답변 형식을 따르지 않기 때문에, 기본 모델의 첫 200개 테스트 문제 점수는 0.105입니다.
4. 최종 모델 평가
산출물은 병합된 모델 디렉터리입니다. <run-home>을 생성된 실행 디렉터리 이름으로 바꾸고, 실행의 Program 환경을 사용해 모든 테스트 예제를 평가하세요:
H=~/gsm8k-example/playground/gsm8k-qwen3-1.7b-base/<run-home>
$H/program-environment/env/bin/python ~/gsm8k-example/task/grade/evaluate.py --model-path $H/deliverable/final_model --limit -1
자체 작업에 에이전트 사용
examples/gsm8k-qwen3-1.7b-base.yaml을 복사하거나aibuildai config으로 전체 시작 구성을 생성합니다.- 실행에서 사용할 수 있는 모든 항목을 포함하는 작업 폴더를 만듭니다.
- 필요한 모든 데이터 파일과 함께 README, 작업 설명서 또는 논문 등 읽을 수 있는 작업 설명을 포함합니다.
run.data_root을 해당 폴더로 설정합니다.- 모델, 검색, 예산, 작업 단위 및 리소스 설정을 검토합니다.
aibuildai run으로 YAML 파일을 실행합니다.
설정 중 시스템은 전체 작업 폴더를 읽고, 설명을 실행의 README로 고정하며, 이를 바탕으로 실행의 점수 프로그램을 구성합니다. 따라서 작업 폴더는 완전해야 하며 예상 산출물과 평가 방법을 명확하게 정의해야 합니다.
구성은 run.setup_from_scratch 및 run.task_prompt도 지원합니다. 이러한 설정을 사용하면 미리 준비된 작업 폴더에서 시작하는 대신 Setup이 작업 설명에서 데이터와 평가 방법을 가져올 수 있습니다.
중요한 구성 선택 사항
모델 선택
llm.default.model은 에이전트가 사용하는 기본 모델을 선택합니다. effort 및 max_thinking_tokens와 같은 설정으로 추론을 조정할 수 있습니다. llm.by_role을 사용하면 개별 역할에 모델을 고정할 수 있고, llm.auto를 사용하면 라우터가 역할에 따라 모델을 선택하도록 할 수 있습니다.
검색 방식
search.kind는 실험 전략을 제어합니다. README에 설명된 지원 값은 다음과 같습니다.
- 메타 에이전트가 작업별 검색 프로그램을 작성하는
meta. - 전체 실험을 대상으로 트리 검색을 수행하는
nb_tree. nb.- 일반 스타터에서 기본값인
tree. linear.parallel.
search.input의 내용은 선택한 전략에 따라 달라집니다. 메타 검색은 report 옵션을 사용하며, 고정 전략은 자체 매개변수를 사용하고 parallel 및 early_stopping을 포함할 수 있습니다.
시간 및 비용 한도
run.budget.wall_clock_minutes의 기본값은 1,440분입니다. 한도에 도달하면 새로운 탐색은 시작되지 않지만, 진행 중인 작업과 결과 전달은 완료될 수 있습니다. run.budget.cost_usd는 선택적 실행 수준 소프트 비용 한도를 제공합니다.
work_units 아래의 각 항목에는 자체 예산이 있습니다. 작업 단위는 고정 시간, 깊이에 따라 조정되는 시간 또는 여유 시간이 포함된 예상 소요 시간을 사용할 수 있습니다.
리소스 한도
resources.work_unit.cpu_max_cores 및 resources.work_unit.memory_max_gb를 사용하여 각 작업 단위에 CPU와 메모리 하드 한도를 적용할 수 있습니다. 각 단위는 메모리와 프로세스에 cgroup 한도가 적용된 bubblewrap 샌드박스에서 실행되며, 작업 폴더는 읽기 전용으로 마운트됩니다.
고급 팁
지식 검색 활성화
에이전트가 AIBuildAI Knowledge Base를 참조하도록 하려면 kb MCP 구성을 추가하세요. 클라이언트는 스킬 검색, 스킬 로드 및 참조 문서 읽기 도구를 제공합니다. 코퍼스에는 워크플로 지침, 방법론 카드, 데이터셋 카드 및 프레임워크 카드가 포함됩니다.
기본 공개 서비스는 고정된 코퍼스 스냅샷을 사용합니다. 자체 버전을 호스팅하려면 오픈 소스 지식 베이스 저장소를 배포하고 AIBUILDAI_KB_BASE_URL이 해당 저장소를 가리키도록 설정하세요.
작업별 토폴로지에는 메타 검색 사용
고정 트리 검색은 학습 전에 스윕을 실행하거나, 이후에 토너먼트를 진행하거나, 여러 모델을 결합하는 등 모든 워크플로를 자연스럽게 표현할 수 없습니다. search.kind: meta를 사용하면 메타 에이전트가 작업을 조사하고, 파일럿을 실행하며, 번들된 설계 스킬과 지식 베이스를 참조하고, Python 검색 패키지를 작성합니다.
생성된 패키지는 다음 세 가지 기본 요소로 구성됩니다.
- Agent: 도구, 정책 및 타입이 지정된 출력을 사용하는 LLM 세션입니다.
- Program: 전용 리소스 한도가 적용된 관리형 워커에서 실행되는 결정론적 계산입니다.
- Search: 타입이 지정된 입력과 출력을 사용하여 Agent, Program 및 중첩된 Search를 생성하고 조정할 수 있는 오케스트레이터입니다.
패키지는 검증되며, 선택적으로 LaTeX 설계 보고서를 통해 검토할 수 있습니다. 그런 다음 동일한 저널링된 실행에서 하위 검색으로 실행됩니다. 토폴로지와 관계없이 실행의 가치는 모든 노드가 얻은 점수 중 최상위 점수로 유지됩니다.
재사용 가능한 로컬 메모리 구축
작업에 대한 실행을 충분히 축적한 후, 그 교훈을 편집 가능한 로컬 메모리 문서로 통합하세요.
aibuildai memorize task.yamlmemory.enable을 설정하면 모든 에이전트에 해당 로컬 메모리가 주입됩니다. 실행에서 학습한 지식은 컴퓨터에 유지되며 원격 지식 베이스에 추가되지 않습니다.
외부 도구 제어
disallowed_tools를 사용하면 모든 역할이 선택한 기본 제공 도구를 사용하지 못하도록 할 수 있습니다. 예를 들어 평가 규칙에서 오프라인 워크플로를 요구하는 경우 WebSearch 및 WebFetch를 금지할 수 있습니다.
MCP 통합 추가
mcps 구성으로 지식 베이스, Kaggle 대회 제출 또는 사용자 지정 MCP 서버를 활성화할 수 있습니다. Kaggle 통합은 submission.max_submissions에서 최대 제출 횟수 설정을 지원합니다.
논문 생성
집계 후 논문 초안을 작성하려면 writer.enable을 활성화하거나, 완료된 실행 디렉터리에서 논문 명령을 실행하세요.
aibuildai write-paper <run-dir>이 명령은 완료된 실행을 바탕으로 논문 초안을 작성하고 PDF로 컴파일합니다.
소스 변경 사항 검증
이 프로젝트 버전에는 테스트 스위트가 포함되어 있지 않습니다. 저장소 검증 명령은 다음과 같습니다.
./check.sh이 검증 명령은 pyright, ruff, semgrep 및 잠금 파일 변경 여부 검사를 실행합니다. 사용하기 전에 requirements-dev.lock을 설치하세요.
실행 결과 이해
각 실행은 구성된 플레이그라운드 루트 아래에 홈 디렉터리를 생성합니다.
{playground_root}/<task-name>/<timestamp>_<run-id>/
  run_config.json
  public/
  private/
  deliverable/
  workspace/
  program-environment/
resource_samples.jsonlrun_config.json에는 재개에 사용되는 최종 구성과 실행 ID가 포함됩니다.public/에는 후보자를 위해 Setup에서 준비한 고정 README와 데이터가 포함됩니다.private/에는 점수 프로그램, 메트릭 매니페스트, 기준선 시도 및 우승 기록이 포함됩니다.deliverable/에는 실행 가능한 모델 패키지 또는 작업에서 정의한 다른 결과물이 포함됩니다.workspace/에는 시도, 아티팩트, 임시 데이터 및 검색별 작업 디렉터리가 포함됩니다.program-environment/에는 실행을 위해 격리된 Program 환경이 포함됩니다.resource_samples.jsonl에는 실행 중 수집한 호스트 리소스 측정값이 기록됩니다.
결론
AIBuildAI LLM-Post-Train Agent는 모델 후훈련 워크플로를 설계하고, 실행하고, 평가하고, 개선하기 위한 엔드투엔드 시스템을 제공합니다. 제공된 GSM8K 예제로 시작하여 설치를 확인하고 실행 구조를 익히세요. 그런 다음 명확한 작업 폴더와 평가기를 정의하고, 적절한 검색 전략을 선택하며, 현실적인 예산과 리소스 제한을 설정한 후, 라이브 작업 공간에서 생성된 실험을 추적하세요.
아키텍처에 대한 자세한 내용은 저장소의 아키텍처 문서를 참조하세요. 이 프로젝트는 Apache License 2.0에 따라 배포됩니다.