

Jev Skills의 기능
Awesome Jev Skills는 AI 에이전트 워크플로에 구조화된 의사 결정을 추가할 수 있는 설치 가능한 9가지 스킬 모음입니다. Jev는 후보 중에서 선택하고, 입력을 분류하며, 정의된 기준을 점수로 평가합니다. 컨텍스트 수집, 도구 호출, 작업 수행, 결과 검증은 계속 에이전트가 담당합니다.
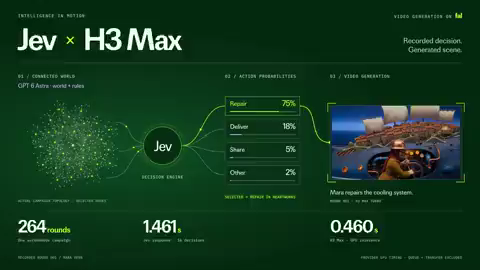
이 저장소에는 90개의 시나리오와 14개의 기록된 입력-출력 예제가 포함되어 있습니다. 레시피는 장기 실행 에이전트, 평가, 라우팅, 컨텍스트 관리, 브라우저 상호작용, 받은 편지함 분류, 문서 증거, 개발자 도구, 시뮬레이션, 게임, 창작 워크플로를 다룹니다.
Jev는 선택하거나 점수를 매깁니다. 버튼을 클릭하거나, 메시지를 보내거나, 파일을 수정하거나, 미디어를 렌더링하거나, 선택한 작업을 실행하지는 않습니다.
주요 기능
- 구조화된 의사 결정 유형:
choice를 사용해 후보 하나를 선택하고,noul을 사용해 독립적인 참 또는 거짓 판단을 내리며,score를 사용해 등급 수준으로 평가합니다. - 특화 스킬: 분류, 문서, 사용자 인터페이스, 라우팅, 컨텍스트, 코드 검토, 코드 탐색, 시뮬레이션용 스킬을 설치합니다.
- 에이전트 체크포인트: 반복되는 실패를 감지하거나, 완료 증거를 평가하거나, 경로를 선택하거나, 제안된 작업이 목표 달성에 기여하는지 Jev에 요청할 수 있습니다.
- 병렬 판단: 공유 상태에 대한 여러 독립 질문을 하나의 요청에 포함하거나, 호스트 에이전트가 제한된 동시성으로 독립 요청을 예약하도록 할 수 있습니다.
- 오프라인 검증:
--dry-run을 사용해 네트워크 호출이나 분류 결과 생성 없이 입력을 검증합니다. - 명시적 시뮬레이션 모드: OpenRouter 키를 사용할 수 없는 경우, 현재 에이전트는 해당 모드를 승인한 후에만 동일한 판단을 시뮬레이션할 수 있습니다.
스킬 선택
jev: 사용자 지정 의사 결정을 정의하거나 일반 에이전트 체크포인트를 추가합니다.jev-triage: 메시지, 티켓 또는 피드백을 분류하고 우선순위를 지정합니다.jev-documents: 소스 구간을 선택하고 뒷받침하는 증거를 평가합니다.jev-ui: 이미 관찰한 브라우저 또는 데스크톱 작업 중에서 선택합니다.jev-route: 도구, 모델 또는 전문가를 추천합니다.jev-context: 관련성을 평가하고 컨텍스트 압축이 적절한 시점을 판단합니다.jev-code-review: 검토할 코드 변경 사항의 우선순위를 정합니다.jev-find-code: 관찰한 파일 목록에서 다음 위치를 선택합니다.jev-simulation: 시뮬레이션 세계에서 가능한 작업을 선택합니다.
설치
에이전트 지원 설치 권장
권장 방법은 Codex, Claude Code 또는 OpenCode에 설치 작업을 맡기는 것입니다. 다음 프롬프트를 에이전트에 붙여 넣으세요.
현재 에이전트에 일반 스킬과 모든 시나리오 스킬을 포함한 Jev Skills를 설치하세요. 이 설치 가이드를 읽고 따르며 설치를 확인하세요:
https://raw.githubusercontent.com/wuyoscar/jev-skill/main/docs/install.md
에이전트는 환경을 확인하고 기본적으로 현재 프로젝트에 설치한 후 오프라인으로 설치를 검증합니다. 기본 설치 경로에는 Node, npm 또는 Vercel 계정이 필요하지 않습니다. 에이전트가 표시하는 승인 요청을 처리하세요.
수동 설치 또는 문제 해결은 수동 설치 가이드를 참조하세요.
실제 Jev 액세스 구성
실제 Jev 호출에는 OPENROUTER_API_KEY가 필요합니다. OpenRouter 설정에서 키를 만들고 로컬에서 구성하세요. 키를 채팅에 붙여 넣지 마세요. 라이브 호출은 API를 사용하며 사용 요금이 발생할 수 있습니다.
키를 찾을 수 없으면 에이전트는 경고를 표시하고 다음 선택지 중 하나를 기다려야 합니다.
- 옵션 A: 키를 발급받아 로컬에서 구성한 다음 실제 Jev를 사용합니다.
- 옵션 B: 현재 에이전트가 동일한 컨텍스트, 후보 및 기준으로 분류를 시뮬레이션하도록 허용합니다.
시뮬레이션 결과에는 mode: agent_simulation 및 jev_called: false를 표시해야 합니다. 이는 Jev 응답이나 보정된 Jev 확률이 아니므로 에이전트는 확률 값을 만들어 내서는 안 됩니다.
시뮬레이션 모드와 드라이 런 모드는 다릅니다. 시뮬레이션은 현재 에이전트의 판단을 생성합니다. 드라이 런은 요청 형식만 검증하며 분류를 수행하지 않습니다.
기본 사용법
설치된 분류 예제 사용해 보기
설치가 끝나면 에이전트에 jev-triage에 포함된 예제를 사용하도록 요청하세요. 이 연습에서는 입력을 표시하고, 실행 모드를 확인하며, 에이전트가 메일함 작업을 수행하지 못하게 합니다.
jev-triage 스킬을 사용하고 설치된 폴더의 assets/example.json을 읽으세요. 컨텍스트, 질문 및 후보를 표시하세요. OPENROUTER_API_KEY가 없으면 A: 실제 Jev를 사용하도록 키 구성 또는 B: 현재 에이전트가 시뮬레이션하도록 허용 중 하나를 선택하라고 요청하세요. 내 선택을 기다리세요. API 모드에서는 --dry-run으로 검증한 다음 Jev를 한 번 호출하세요. 시뮬레이션 모드에서는 결과에 "Agent simulation; Jev not called"라고 표시하고 확률을 만들어 내지 마세요. 전체 입력, 출력 및 모드를 표시하세요. 내 메일함에 액세스하거나 작업을 실행하지 마세요.에이전트가 새로 설치된 스킬을 찾지 못하면 설치 디렉터리를 확인하고, 사용하는 클라이언트에서 필요할 경우 세션을 다시 로드하도록 요청하세요.
요청 구조 이해하기
Jev 요청에는 모델, 공유 상태, 하나 이상의 질문이 포함됩니다. 각 질문은 해당하는 경우 유형, 지침, 후보 기준을 정의합니다. 다음의 축약된 예시는 동일한 파서 오류가 반복된 후 에이전트가 무엇을 해야 하는지 묻습니다.
{
  "model": "typesafe/jev-1.13",
  "state": {
    "goal": "CSV 파서를 수정하고 완료를 선언하기 전에 테스트를 확인합니다.",
    "recent_result": "동일한 UnicodeDecodeError가 두 번 발생했으며 소스 변경은 없습니다.",
    "observation": "파서가 명시적인 인코딩 없이 파일을 엽니다."
  },
  "questions": {
    "next_step": {
      "type": "choice",
      "instructions": "근거에서 다음으로 유용한 단계를 선택합니다.",
      "criteria": {
        "inspect_input": "입력 및 파일 열기 코드를 검사합니다.",
        "retry_unchanged": "일시적인 조건이 변경된 경우에만 다시 시도합니다.",
        "report_done": "테스트가 통과한 경우에만 완료를 보고합니다.",
        "ask_user": "중요한 권한이나 정보가 누락된 경우 질문합니다."
      }
    },
    "stuck": {
      "type": "noul",
      "instructions": "변경 없이 시도한 결과 동일한 오류가 반복되었습니까?"
    }
  }
}
저장소에 기록된 합성 API 예시에서 Jev는 inspect_input을 선택하고 stuck = true를 반환했습니다. 이는 제공된 근거에 따른 결정이며, 실제 수리 작업을 실행한 것이 아닙니다.
선택적 명령줄 사용하기
jev-decide가 설치되어 있다면 완전한 요청을 request.json으로 저장합니다. 먼저 오프라인에서 유효성을 검사합니다.
jev-decide decide request.json --dry-runOpenRouter로 전송될 데이터를 검토하고 승인한 후, 한 번의 실제 요청을 보내 결과를 저장합니다.
jev-decide decide request.json > result.json일반 스킬만 설치되어 명령을 사용할 수 없다면 Python 스크립트를 사용합니다.
python3 <actual-skill-directory>/scripts/jev.py decide request.json --dry-run항상 result.json을 검사합니다. 종료 코드 0은 결과가 선택되었거나 점수가 매겨졌음을 의미하고, 2는 검토가 필요함을 의미하며, 1은 오류가 발생했음을 의미합니다. 성공적으로 선택되었더라도 선택된 작업이 실행되는 것은 아닙니다.
실무 워크플로: 의사 결정 체크포인트 추가
Jev는 사소한 에이전트 단계마다 사용하는 것이 아니라 의미 있는 의사 결정 지점을 위해 설계되었습니다. 오류가 반복되거나, 경로를 선택해야 하거나, 에이전트가 완료를 주장하려는 시점에 체크포인트를 추가합니다.
CSV 파싱을 수정하고 원래 테스트를 통과하는 동안 의사 결정을 지원하려면 jev 스킬을 사용하세요. 키가 없으면 실제 Jev와 현재 에이전트 시뮬레이션 중 하나를 선택하도록 요청하세요. 오류가 반복되거나, 경로를 선택해야 하거나, 완료를 주장하려는 시점에는 선택한 모드를 사용하세요. 목표, 승인 검사, 관련 기록, 최신 도구 결과, 권한, 각 후보 작업의 의미를 제공하세요. 기존 권한 범위 내에서만 작업하고 이후 결과를 확인하세요.완료 체크포인트에는 아티팩트 식별자, 테스트 실행 증빙, 리비전 해시, 파일 시스템 검사, 작업 상태와 같은 실제 근거가 제공되어야 합니다. Jev는 제공된 근거가 주장을 뒷받침하는지 판단할 수 있지만, 테스트가 실제로 실행되었는지 또는 파일이 존재하는지를 인증할 수는 없습니다. 이러한 사실은 도구에서 확인해야 합니다.
레코드를 안전하게 분류하기
피드백, 지원 티켓 또는 기타 레코드의 경우 소규모로 익명화된 샘플부터 시작합니다. 더 큰 배치를 처리하기 전에 범주, 질문, 외부로 전송할 데이터를 합의합니다.
- 대표 레코드 세 개를 선택합니다.
- 각 레코드의 식별자, 원문, 관련 맥락을 보존합니다.
billing,bug,how-to,other와 같은 범주를 정의합니다.- 사용자의 컴퓨터 밖으로 전송될 내용을 정확히 검토합니다.
- 실제 API 모드 또는 명시적으로 승인된 시뮬레이션 모드를 선택합니다.
- 확실하지 않은 결과는 사람의 검토를 위해 별도로 보관합니다.
- 배치 크기나 예산을 늘리기 전에 샘플을 검사합니다.
각 레코드에 대해 범주와 긴급도처럼 여러 질문을 하나의 요청으로 묻을 수 있습니다. 독립적인 요청의 경우 호스트 에이전트가 제한된 동시성을 사용할 수 있지만, CLI 자체는 병렬 작업을 시작하지 않습니다.
고급 팁
전체 맥락 제공
Jev는 에이전트의 대화를 자동으로 상속하지 않습니다. 목표, 규칙, 관련 기록, 원본 근거, 현재 관찰 내용, 권한, 후보 의미, 승인 검사를 포함하세요. 의사 결정 질문은 좁게 유지하되 근거를 인위적으로 축소하지는 마세요.
관련된 모든 필드 업데이트
템플릿을 조정할 때는 state, questions, criteria를 함께 업데이트하세요. 예시 텍스트만 변경하면 후보 정의가 실제 작업과 일치하지 않게 될 수 있습니다.
의사 결정과 권한 부여 분리
높은 점수를 받은 작업이 자동으로 허용되는 것은 아닙니다. 기존 권한과 안전 제어가 여전히 실행을 관리합니다. 마찬가지로 계획과 제안된 도구 호출이 일치한다고 해서 어느 쪽이든 권한이 부여되었다는 뜻은 아닙니다.
종속 단계에는 최신 상태 사용
독립적인 판단은 하나의 상태를 공유하거나 동시에 실행할 수 있습니다. 종속된 결정은 이전 작업 후의 최신 관찰 내용을 사용해야 합니다. Jev는 개방형 계획 수립, 도구 실행, 텍스트 생성을 대체하지 않습니다.
값을 올바르게 해석
noul 질문에서 probability는 선택된 값이 false인 경우에도 해당 문장이 참일 확률을 나타냅니다. 1.29 / 2와 같은 루브릭 점수는 확률이 아니라 평가 점수입니다.
근거와 모드 보존
전체 입력, 정규화된 출력, 가능한 경우 원시 영수증, 실행 모드를 저장합니다. 선택된 답변에 맞추기 위해 모순되는 증거를 다시 작성하지 마세요. 에이전트 시뮬레이션을 실제 API 응답으로 제시해서는 안 됩니다.
Jev를 호스트 도구와 결합하기
브라우저 클릭, 메시지 전송, 파일 편집, 음악 생성, 동영상 렌더링에는 각각 별도의 도구가 필요합니다. Jev는 후보의 순위를 매기거나 관찰된 합법적 작업 중 하나를 선택할 수 있으며, 호스트 애플리케이션이 선택된 작업을 실행하고 검증합니다.
결론
Jev Skills는 에이전트 워크플로에 명시적 선택, 분류, 점수, 증거 검사를 추가하기 위한 재사용 가능한 패턴을 제공합니다. 에이전트 지원 설치부터 시작하고, 제공된 예제를 테스트한 다음, --dry-run으로 요청을 검증하고, 규모를 확장하기 전에 소량의 샘플을 검토하세요. 완전한 컨텍스트, 명확하게 정의된 후보, 명시적인 실행 모드, 그리고 결과에 중대한 영향을 미치는 모든 작업 후의 독립적인 검증이 있을 때 최상의 결과를 얻을 수 있습니다.