

예전에는 동영상에 자막을 넣는 일이 꽤 번거로웠습니다.
어려운 게 아니라, 손이 많이 갔습니다.
동영상을 녹화한 뒤 자막을 추가하려면 먼저 음성을 텍스트로 변환해야 합니다. 어떤 도구를 사용하든 변환 결과는 문장부호도, 문장 구분도 없는 긴 텍스트 한 덩어리로 나오는 경우가 많습니다.
그다음에는 직접 조정해야 합니다. 어디서 문장을 나눌지, 어디서 줄을 바꿀지, 잘못 인식된 이름은 무엇인지 일일이 확인하고 고쳐야 하죠.
다른 언어로 번역해야 한다면 더 번거롭습니다. 한 문장씩 번역한 뒤 다시 타임라인에 맞춰야 하니까요.
10분짜리 동영상 하나에 자막만 넣어도 한두 시간이 걸릴 수 있습니다.
그러다 무료 오픈소스 도구 하나를 발견했습니다.
하는 일은 아주 간단합니다. 동영상을 끌어다 놓고 언어를 선택한 다음 시작을 누르면 됩니다.
그러면 나머지는 도구가 알아서 처리합니다.
음성 인식, 스마트 문장 분할, 오탈자 수정, 전문 용어 통일, 다른 언어로 번역, 자막 파일 생성까지요.
전부 자동입니다.
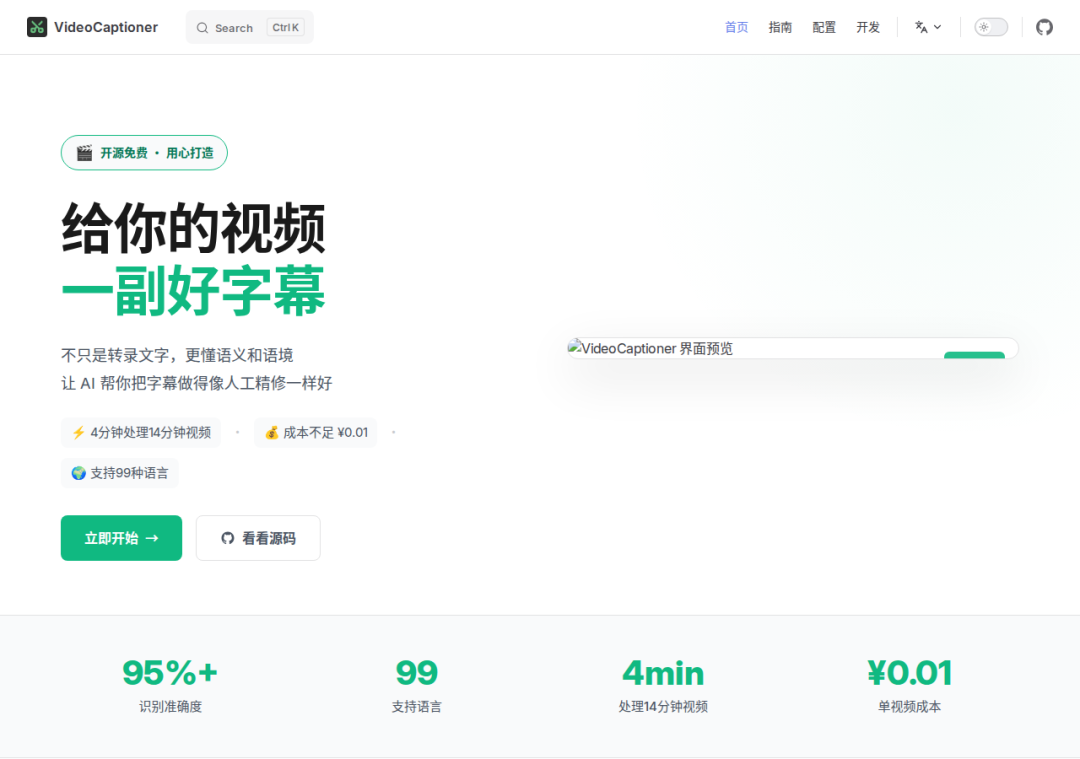
속도도 빠릅니다. 14분짜리 동영상 하나를 약 4분 만에 처리할 수 있습니다.
비용도 매우 저렴합니다. 공식 설명에 따르면 1센트도 들지 않는다고 합니다.
음성 인식에는 Whisper를 사용하며 정확도는 95% 이상입니다. 중국어, 영어, 일본어, 한국어, 프랑스어, 독일어 등 99개 언어를 인식할 수 있습니다.
문장 분할에는 대규모 언어 모델을 사용합니다. 단순히 멈춘 시간을 기준으로 자르는 것이 아니라, 의미를 제대로 이해한 뒤 문장을 나눕니다. 그래서 결과 자막도 “나는 오늘 재미 있는 곳에 갔어요”처럼 어색하게 끊기는 대신 “나는 오늘 아주 재미있는 곳에 갔어요”처럼 자연스럽게 나옵니다.
자주 발생하는 인식 오류도 자동으로 수정합니다. 전문 용어나 익숙하지 않은 인명은 음성 인식만으로 잘못 인식될 수 있는데, 문장을 나누는 동시에 이런 부분도 바로잡아 줍니다.
다국어 자막이 필요하다면 37개 언어로 번역할 수 있습니다. 번역에도 대규모 언어 모델을 사용하기 때문에 기계 번역 특유의 어색함이 적고, 문맥을 반영해 훨씬 자연스럽게 읽힙니다.
출력 형식은 SRT, ASS, VTT를 지원합니다. 일반적으로 사용하는 자막 형식은 거의 모두 지원한다고 볼 수 있습니다.
또 하나 마음에 들었던 세부 기능이 있습니다. 과학·교양풍, 뉴스풍, 애니메이션풍 등 여러 자막 스타일 템플릿이 기본으로 제공됩니다. 다양한 유형의 동영상에 맞는 스타일이 필요하다면 템플릿을 바로 적용하면 되므로 직접 스타일을 조정할 필요가 없습니다. 특히 테두리와 그림자가 들어간 일본 애니메이션풍 자막은 2차원 콘텐츠에 그대로 사용할 수 있습니다.
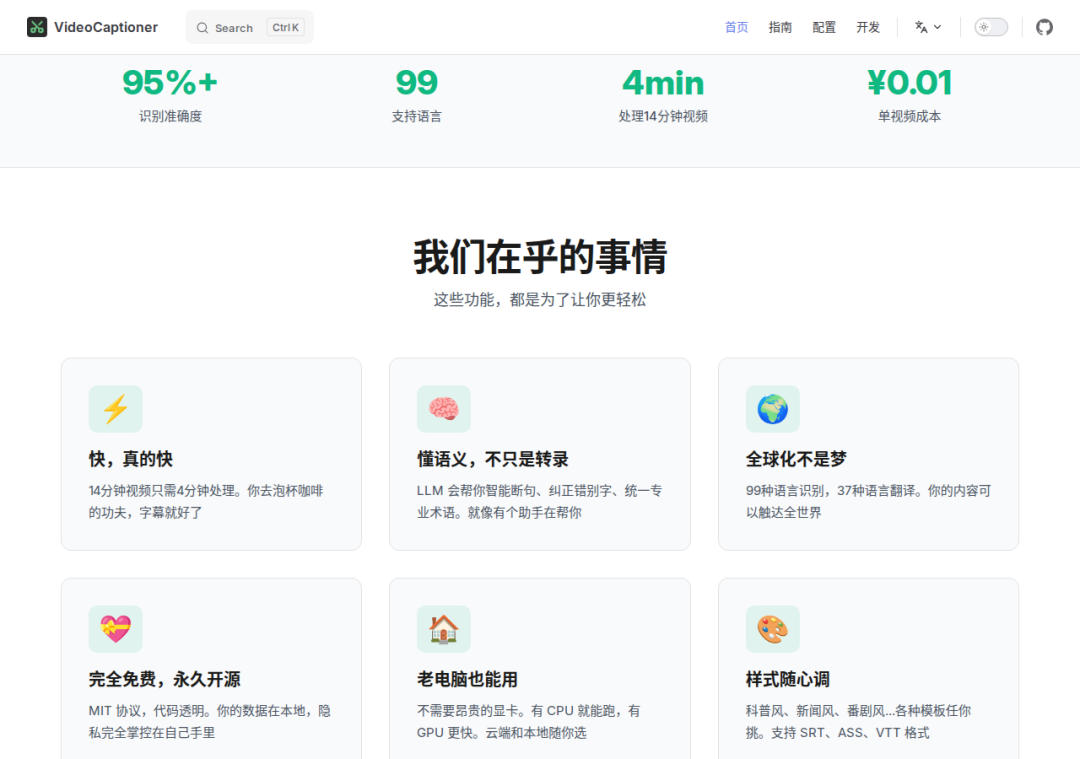
게다가 완전히 로컬에서 실행됩니다. 동영상을 어떤 서버에도 업로드할 필요 없이 모든 처리가 자신의 컴퓨터에서 이루어집니다. 데이터 privacy도 걱정할 필요가 없습니다. 많은 온라인 자막 도구는 동영상을 업로드해야 하므로, 원본 영상을 다른 사람의 서버에 올려야 한다는 점을 꺼리는 사람도 있습니다. 이 도구는 그럴 필요 없이 로컬에서 처리하고 로컬에서 파일을 출력합니다.
하드웨어 요구 사항도 높지 않습니다. 비싼 그래픽 카드가 없어도 CPU만 있으면 실행할 수 있습니다. 외장 그래픽 카드가 있으면 더 빠르지만, CPU만으로도 정상적으로 처리됩니다. 직접 일반 노트북으로 테스트해 보니 10분짜리 동영상의 결과가 약 6~7분 만에 나왔고, 충분히 감당할 만한 속도였습니다.
일괄 처리 모드도 제공합니다. 여러 동영상을 한 번에 끌어다 놓으면 대기열에 등록되어 자동으로 처리됩니다. 처리가 끝난 뒤 자막 파일을 한꺼번에 내보낼 수 있습니다. 시리즈 콘텐츠를 만드는 사람이라면 반복 작업을 크게 줄일 수 있는 기능입니다.
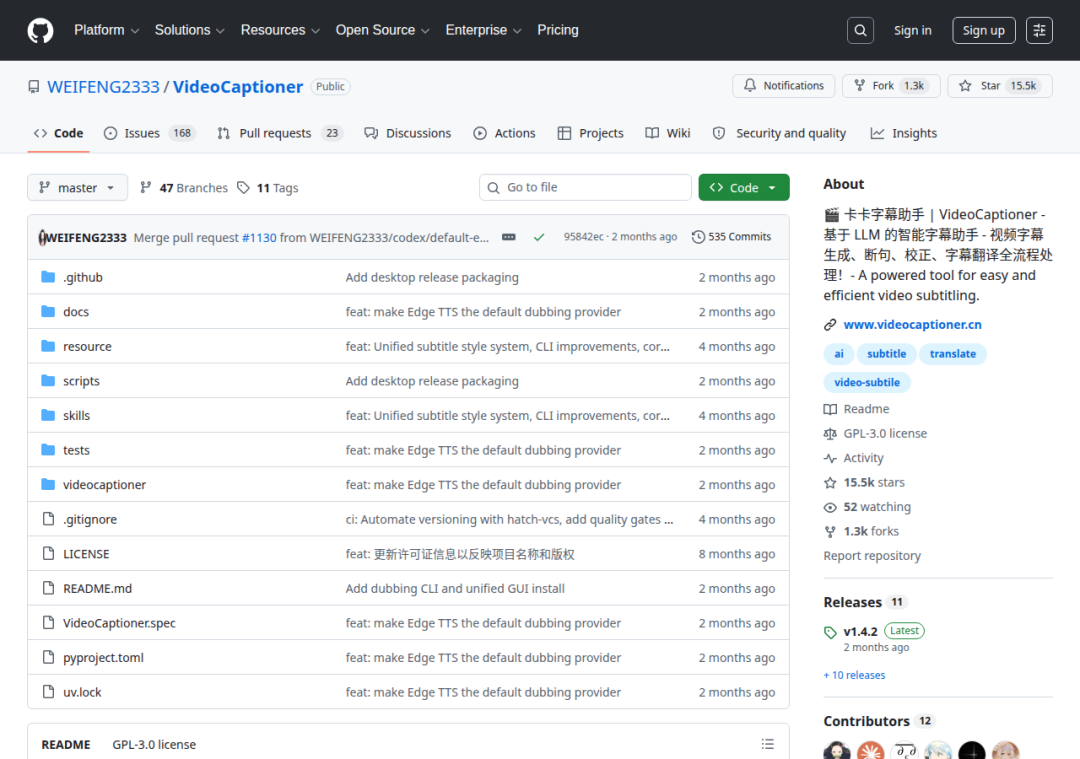
숏폼 동영상을 만드는 사람, 온라인 강의를 제작하는 사람, 다국어 콘텐츠를 만드는 사람 모두에게 적합합니다. 자막을 자주 다룬다면 한 번 찾아보세요. 무료 오픈소스라 비용이 들지 않고, 첫 번째는 GitHub, 두 번째는 공식 웹사이트입니다.
오픈소스 주소: github.com/WEIFENG2333/VideoCaptioner