

시스템 디자인 트레이너란?
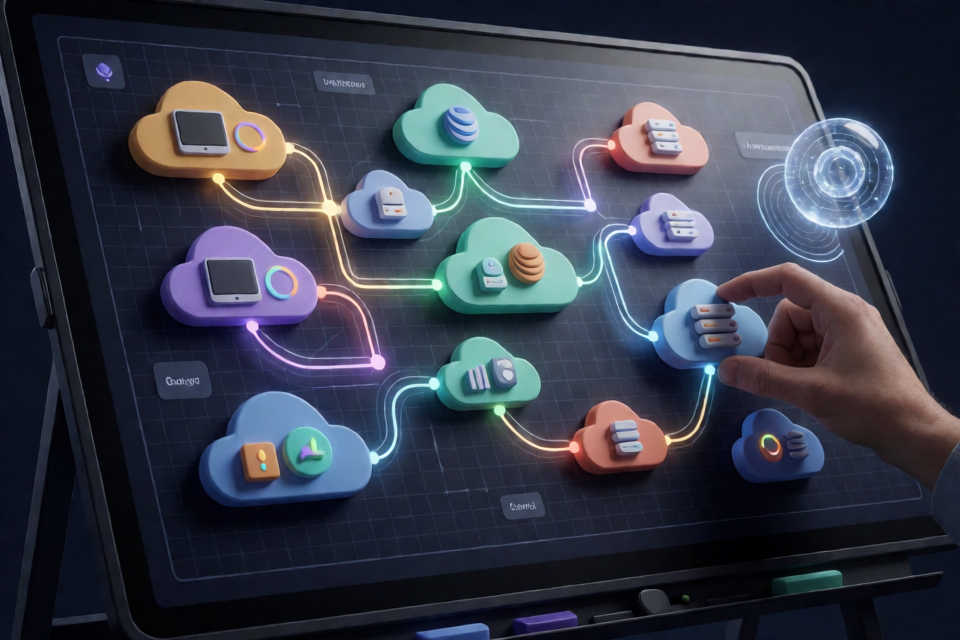
시스템 디자인 트레이너는 시스템 디자인 면접을 연습하기 위한 대화형 화이트보드입니다. 시나리오를 선택하고, AWS 또는 Azure 컴포넌트를 캔버스로 드래그한 다음, 이를 연결해 아키텍처를 구성하고 결정론적 용량 시뮬레이션을 실행할 수 있습니다.
시뮬레이터는 각 컴포넌트가 지원할 수 있는 트래픽 양을 추정하고, 시스템 병목 지점을 식별하며, 아키텍처 위험을 강조 표시합니다. 설계가 준비되면 Jev가 용량 계산만으로는 판단할 수 없는 확장성, 안정성, 데이터 설계, 작성한 설명 등의 선택 사항을 평가할 수 있습니다.
주요 기능
- 대화형 아키텍처 캔버스: 이 화이트보드는
@xyflow/react를 통해 React Flow로 구축되었습니다. - 구조화된 연습: 프로젝트에는 4개 챕터에 걸쳐 15개의 레벨이 포함되어 있습니다.
- 실시간 용량 모델링: 각 노드에는 사용률과 지원 가능한 사용자 수의 추정치가 표시됩니다.
- 아키텍처 진단: 시뮬레이터는 단일 장애점, 누락된 로드 밸런서, 데이터베이스에 직접 연결된 클라이언트를 표시합니다.
- 비용 및 가용성 추정: 처리량 계산과 함께 추가 지표를 제공합니다.
- 면접관 방식의 평가: Jev는 확장성, 안정성, 데이터 설계, 작성한 설명을 점수화한 뒤 다음에 개선할 부분을 추천합니다.
- 사용자 지정 기술: Kafka, MongoDB, NGINX와 같은 기술을 입력할 수 있습니다. Jev는 해당 기술의 아키텍처 역할을 분류하여 애플리케이션이 용량 프로필을 할당할 수 있도록 합니다.
- 로컬 진행 상황 저장: 설계와 시나리오 진행 상황은 브라우저에 저장됩니다.
- 자유 연습: 구조화된 레벨 외부에서도 자유롭게 사용할 수 있는 화이트보드가 제공됩니다.
프로젝트 설치 및 실행
1. 종속성 설치
저장소를 복제하거나 다운로드하고, 터미널에서 해당 디렉터리를 연 다음 npm 종속성을 설치합니다.
npm install2. 로컬 환경 파일 생성
포함된 환경 템플릿을 .env.local로 복사합니다.
cp .env.example .env.local3. Jev 구성
실제 Jev 답변을 받으려면 .env.local에 TYPESAFE_API_KEY 값을 추가합니다. Jev는 @typesafe-ai/sdk를 사용하여 lib/server/jev.ts에 구현되어 있습니다.
API 키가 없어도 애플리케이션을 실행할 수 있습니다. 이 경우 Jev 응답은 명확하게 표시된 모의 응답으로 대체되므로 외부 평가 없이도 나머지 작업 흐름을 살펴볼 수 있습니다.
4. 개발 서버 시작
npm run dev트레이너를 사용하려면 개발 서버가 표시하는 로컬 주소를 엽니다.
첫 시스템 디자인 연습 완료하기
- 문제 선택. 100만 명의 사용자를 위한 인프라 설계와 같은 시나리오를 선택합니다. 각 시나리오는 고정된 사용자 수와 요구 사항을 제공합니다.
- 목표 확인. 레벨에는 설계를 실행할 때 확인되는 필수 목표와 선택적 보너스 목표가 포함되어 있습니다.
- 클라우드 컴포넌트 추가. 적절한 AWS 또는 Azure 컴포넌트를 화이트보드로 드래그합니다.
- 아키텍처 연결. 시나리오에 맞게 클라이언트, 네트워킹 컴포넌트, 애플리케이션 서비스, 캐시, 큐, 데이터베이스 사이에 요청 경로와 데이터 경로를 만듭니다.
- 설계 실행. 사용률, 지원 사용자 추정치, 가용성, 비용, 아키텍처 경고를 검토합니다.
- 병목 해결. 과부하된 컴포넌트나 구조적 경고를 바탕으로 설계를 업데이트한 다음 다시 실행합니다.
- Jev 피드백 요청. 준비가 되면 평가를 위해 설계와 작성한 설명을 제출합니다.
레벨 점수 계산 방식
모든 필수 목표를 달성하면 별 1개를 획득합니다. 각 보너스 목표는 별 1개를 추가로 제공합니다. 별은 XP를 제공하고 등급에 반영되며, 진행 상황은 브라우저에 유지됩니다.
챕터 4에서는 Azure Architecture Center의 참조 아키텍처를 다시 구축해야 합니다. 이러한 레벨 중 하나를 완료하면 트레이너가 원본 아키텍처로 연결되는 링크를 제공합니다.
용량 모델 이해하기
용량 엔진은 lib/simulate.ts에 있습니다. 이 엔진은 결정론적으로 작동하며 AI를 사용하지 않습니다. 피크 부하는 다음 관계식을 사용하여 시나리오에서 도출됩니다.
DAU × 일일 요청 수 ÷ 86,400 × 피크 계수이 모델은 부하를 읽기와 쓰기로 나눈 다음, 연결된 그래프를 따라 Users 노드에서 부하를 전파합니다.
일반적인 컴포넌트가 트래픽에 미치는 영향
- CDN: 시나리오에서 엣지 캐시가 가능한 것으로 표시한 트래픽 일부를 흡수합니다.
- 캐시: 캐시 적중률에 따라 읽기 요청을 흡수합니다. 이 모델은 캐시 비적중 시 형제 배치와 인라인 배치를 모두 지원합니다.
- 큐: 동기 경로에서 쓰기 요청을 제거하고 평균 요청률에 맞춰 점진적으로 처리합니다.
- 형제 컴포넌트: 같은 종류의 컴포넌트는 부하를 균등하게 나눕니다. 예를 들어 로드 밸런서에 두 개의 애플리케이션 그룹이 연결되어 있으면 두 그룹 사이에 트래픽을 분산합니다.
- SQL 데이터베이스: 쓰기 용량은 하나의 프라이머리로 제한됩니다.
- NoSQL 데이터베이스: 쓰기 용량은 파티션 수에 따라 확장됩니다.
각 노드는 사용률과 supports ~N users 추정치를 보고합니다. 이 추정치는 시나리오 사용자 수를 사용률로 나누어 계산합니다. 전체 시스템 용량은 지원 가능한 사용자 추정치가 가장 낮은 병목에 의해 결정됩니다.
설계 반복 예시
모든 클라이언트 트래픽을 하나의 애플리케이션 컴포넌트로 직접 보낸 다음 데이터베이스로 전달하는 설계를 가정해 보겠습니다. 시뮬레이션을 실행하면 애플리케이션 또는 데이터베이스가 병목으로 드러날 수 있으며, 안정성 경고도 함께 표시될 수 있습니다.
그런 다음 적절한 분산, 캐싱, 비동기 처리 또는 데이터 컴포넌트를 추가하여 아키텍처를 수정할 수 있습니다. 예를 들어 로드 밸런서 뒤에 동일한 애플리케이션 그룹을 배치하면 애플리케이션 트래픽을 분산할 수 있고, 캐시는 적중률에 따라 데이터베이스 읽기를 줄일 수 있으며, 큐는 쓰기 작업을 동기 경로에서 분리할 수 있습니다. 변경할 때마다 모델을 다시 실행하여 병목이 다른 곳으로 이동했는지 확인하세요.
더 높은 용량 추정치가 나온다고 해서 설계가 자동으로 올바른 것은 아닙니다. Jev를 사용하여 안정성, 데이터 설계, 확장성 및 선택의 근거 사이의 트레이드오프를 평가하세요.
Jev 효과적으로 사용하기
결정론적 시뮬레이터는 계산된 수치를 사실로 Jev에 제공합니다. Jev는 처리량 공식으로 환원할 수 없는 판단을 담당합니다.
- 평가 점수: 확장성, 안정성, 데이터 설계 및 작성된 설명을 검토합니다.
- 개선 항목 선택: 다음에 개선해야 할 항목을 선택합니다.
- 체크리스트 판단: 시나리오 체크리스트의 각 항목에 대해 하나의 Noul을 생성합니다.
- 사용자 지정 컴포넌트 분류: 입력한 기술에 아키텍처 역할을 할당하여 트레이너가 해당 용량 프로필을 적용할 수 있게 합니다.
더 효과적인 피드백을 받으려면 작성한 설명을 구체적으로 작성하세요. 트래픽 흐름, 확장 가정, 장애 처리, 읽기 및 쓰기 패턴, 그리고 각 주요 컴포넌트가 포함된 이유를 설명하세요.
고급 팁
모든 컴포넌트가 아닌 병목을 최적화하세요
시스템은 제한 컴포넌트가 지원하는 사용자 수만큼만 사용자를 지원할 수 있습니다. 지원 가능한 사용자 추정치가 가장 낮은 노드부터 시작하세요. 설계를 변경한 후에는 시뮬레이션을 다시 실행하세요. 한 병목을 해소하면 다른 병목이 드러날 수 있기 때문입니다.
동기 경로와 비동기 경로를 비교하세요
큐는 동기 요청 경로에서 쓰기를 분리하고 평균 부하에 맞춰 원활하게 처리합니다. 시나리오에서 비동기 처리가 허용되는 경우 모델을 사용하여 직접 쓰기 경로와 큐 기반 아키텍처를 비교하세요.
캐시 배치를 테스트하세요
시뮬레이터는 cache-aside 패턴에서 형제 컴포넌트로 사용되는 캐시와 인라인으로 배치된 캐시를 인식합니다. 배치 위치와 적중률이 다운스트림 읽기 트래픽에 어떤 영향을 미치는지 확인하세요.
구조적 경고를 확인하세요
사용률에만 집중하지 마세요. 단일 장애 지점, 누락된 로드 밸런서, 클라이언트와 데이터베이스 간 직접 연결을 확인하세요. 원시 용량이 충분하더라도 이러한 경고를 통해 안정성 또는 보안과 관련된 설계 취약점을 발견할 수 있습니다.
카탈로그 수치의 출처를 확인하세요
용량, 가용성 및 비용 데이터는 lib/catalog.ts에 정의되어 있습니다. 각 수치에는 컴포넌트 속성 카드에 표시되는 출처가 포함되어 있습니다. 값은 공식 제한, 공식 SLA, 공급업체 벤치마크, 가정 또는 공개된 제한이 없는 서비스로 분류됩니다.
- 공식 제한: 계정 수준 요청 제한과 같은 AWS 또는 Azure의 공개 할당량입니다.
- 공식 SLA: 공급업체의 월간 가동 시간 약정입니다.
- 공급업체 벤치마크: 공개된 성능 수치이지만 보장되지는 않습니다.
- 가정: 공급업체 수치를 이용할 수 없어 모델링한 값입니다. 프로젝트에서는 모든 비용도 가정으로 취급합니다.
- 공개된 제한 없음: 독립적으로 확장되는 것으로 모델링된 서비스이므로 병목이 되지 않습니다.
README에는 이러한 출처를 2026년 9월에 마지막으로 확인했다고 명시되어 있습니다. 클라우드 할당량은 변경될 수 있고 많은 할당량은 증설할 수 있으므로 시뮬레이션 결과는 보장이 아닌 추정치로 취급해야 합니다.
시나리오를 탐색하거나 확장하세요
시나리오 정의는 lib/scenarios.ts에 저장되어 있으며, 15개의 구조화된 레벨은 lib/levels.ts에 정의되어 있습니다. 연습 프롬프트를 확장하려면 lib/scenarios.ts에 시나리오를 추가하세요.
브라우저 저장 방식 이해하기
캔버스 설계는 localStorage에 시나리오별로 저장되며 진행 상황도 브라우저에 보관됩니다. 브라우저 저장 공간은 현재 브라우저 프로필과 환경에 한정된다는 점을 기억하세요.
결론
System Design Trainer는 대화형 클라우드 아키텍처 캔버스, 결정론적 용량 모델링, 구조화된 목표 및 Jev 기반 설계 검토를 결합합니다. 시뮬레이터로 측정 가능한 동작을 테스트하고, 경고를 통해 구조적 문제를 발견하며, Jev를 사용하여 시스템 설계 면접에서 요구되는 추론과 트레이드오프 분석을 개선하세요.