

NamiGPT란 무엇인가
NamiGPT는 중국어 초보자를 위한 대규모 언어 모델 기초 튜토리얼입니다. PyTorch를 사용해 GPT-2를 처음부터 구현하며, 기존 Transformer 모듈을 호출하지 않습니다. 또한 OpenAI 공식 사전 학습 가중치를 불러와 추론과 텍스트 생성을 수행할 수 있습니다.
이 프로젝트는 학습 효율을 최우선 목표로 삼지 않고 이해를 강조합니다. 핵심 모델은 gpt2/model.py에 있으며 코드가 200줄도 되지 않습니다. 튜토리얼은 “고양이가 물고기를 먹는다”라는 세 단어 예시를 바탕으로 토큰화, 벡터, 어텐션 행렬, 최종 생성 과정을 단계별로 설명합니다.
NamiGPT라는 이름은 Karpathy의 nanoGPT에 경의를 표한 것입니다. 중국어 프로그래밍 입문자를 위한 교육에 더 중점을 두고, 최소한의 예제로 GPT-2의 각 단계를 설명합니다.
배우게 될 내용
- Tokenizer가 텍스트를 token ID로 변환하는 방법
- Embedding과 위치 인코딩이 모델 입력을 구성하는 방법
- Self-Attention과 Multi-Head Attention의 계산 방법
- 잔차 연결, LayerNorm, FFN, 활성화 함수가 각각 어떤 역할을 하는지
- 여러 Transformer Block을 쌓아 GPT-2를 구성하는 방법
- OpenAI 공식 가중치를 직접 구현한 모델에 불러오는 방법
- 그리디, 온도, top-k 전략으로 텍스트를 생성하는 방법
- 테스트를 통해 직접 구현한 모델과 HuggingFace 구현의 일치 여부를 검증하는 방법
프로젝트의 주요 특징
핵심 구성 요소를 처음부터 구현
NamiGPT는 기존 Transformer 모듈을 직접 호출하지 않습니다. 모델 본체에는 LayerNorm, Attention, FFN, Block, GPT 등의 구성 요소가 포함되어 있어 데이터와 텐서가 어떻게 흐르는지 한 줄씩 살펴보기에 적합합니다.
챕터 스크립트를 독립적으로 실행 가능
추론 파트는 토크나이저, Embedding, 위치 인코딩, 셀프 어텐션, 멀티헤드 어텐션, 잔차 연결, 층 정규화, 피드포워드 네트워크, 활성화 함수, Transformer Block, 블록 쌓기, 가중치 불러오기, 텍스트 생성, 해석 가능성 등 15개의 단계별 주제로 구성됩니다. 각 주제에는 실행 가능한 해당 스크립트가 제공됩니다.
인터랙티브 시각화 제공
프로젝트는 Transformer 아키텍처의 동적 시각화와 전체 추론 행렬 시각화를 제공합니다. 코드나 수식을 이해하기 어려울 때는 “고양이가 물고기를 먹는다” 예시의 행렬 요소가 한 칸씩 계산되는 과정을 관찰할 수 있습니다.
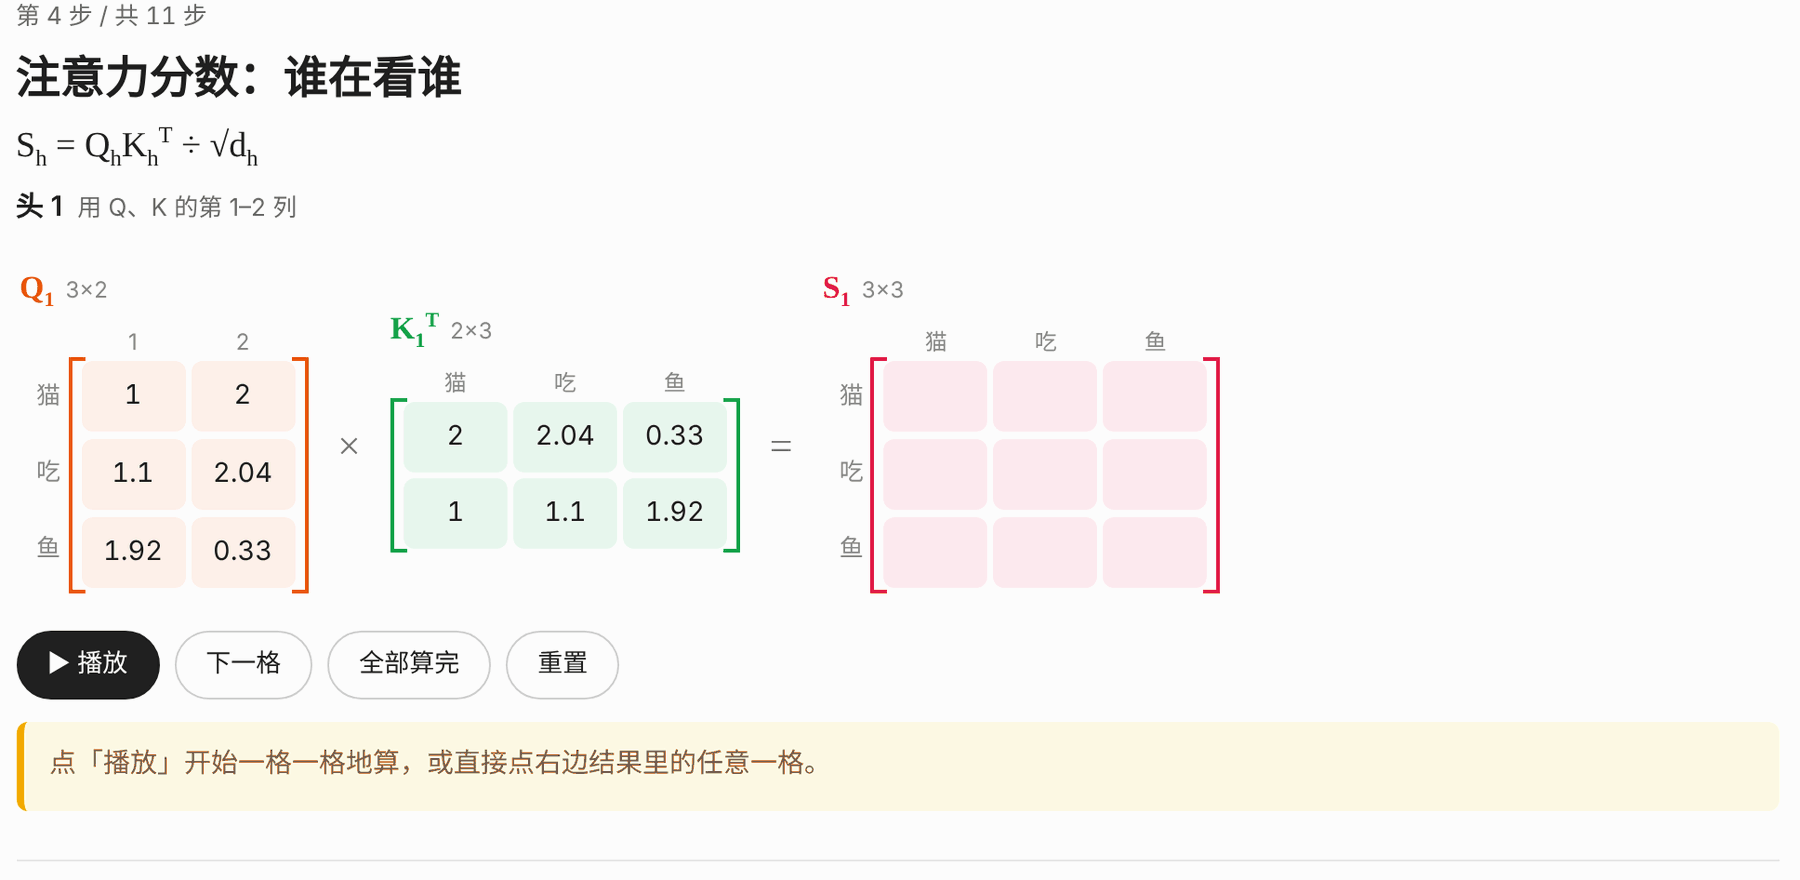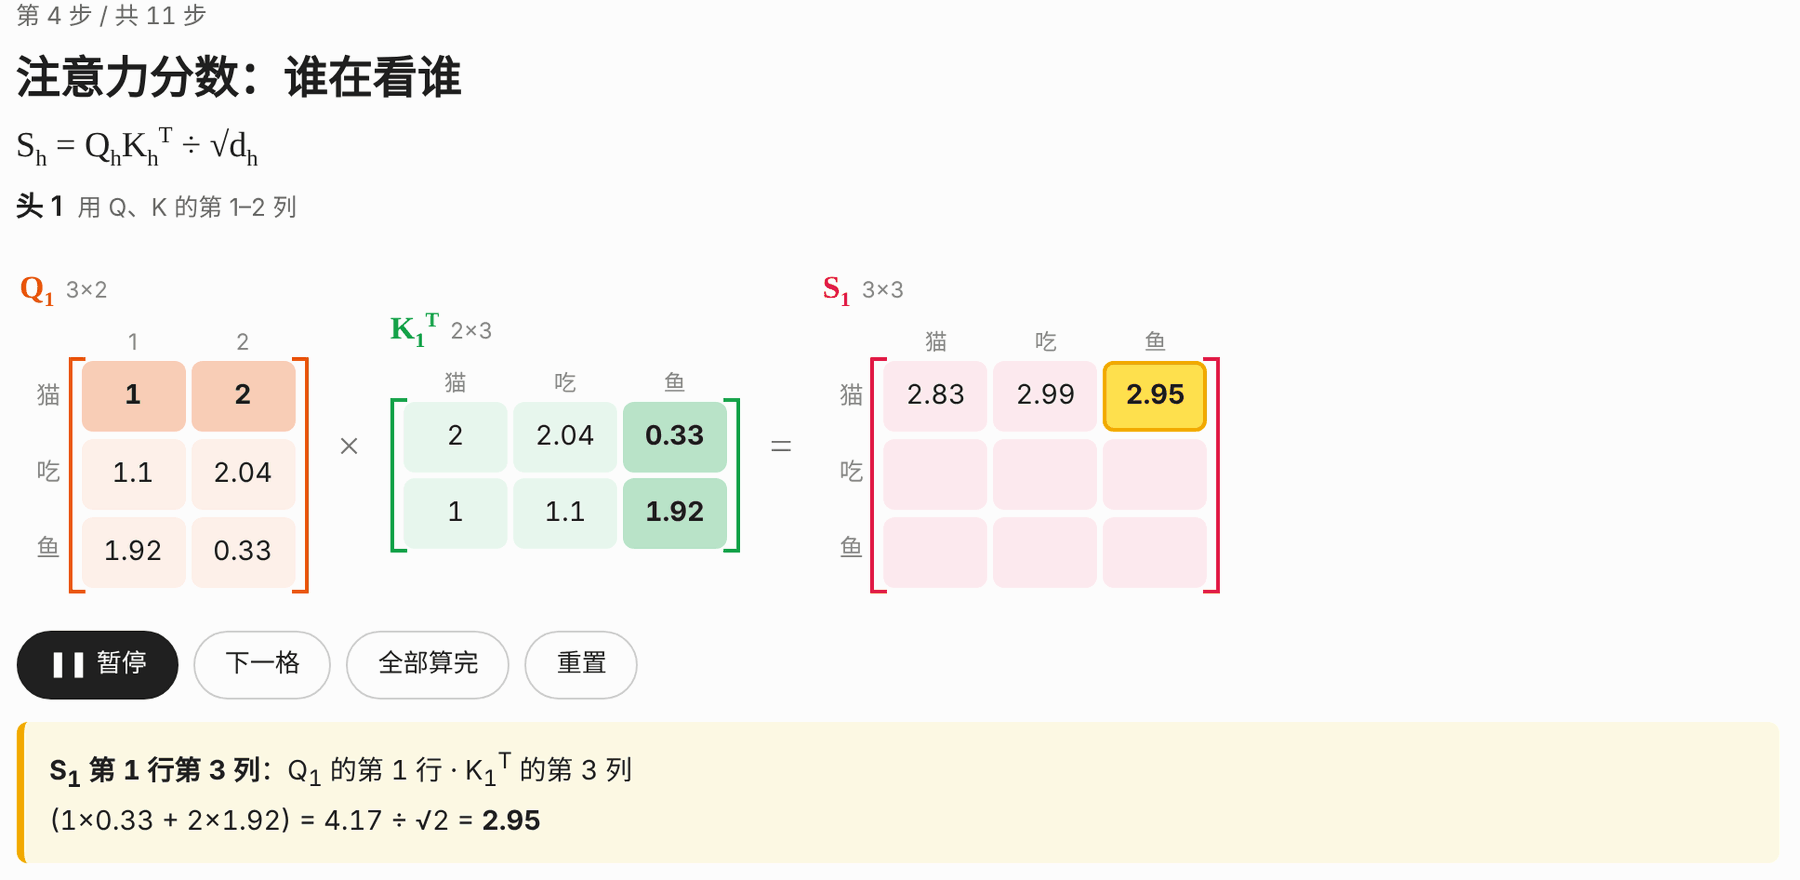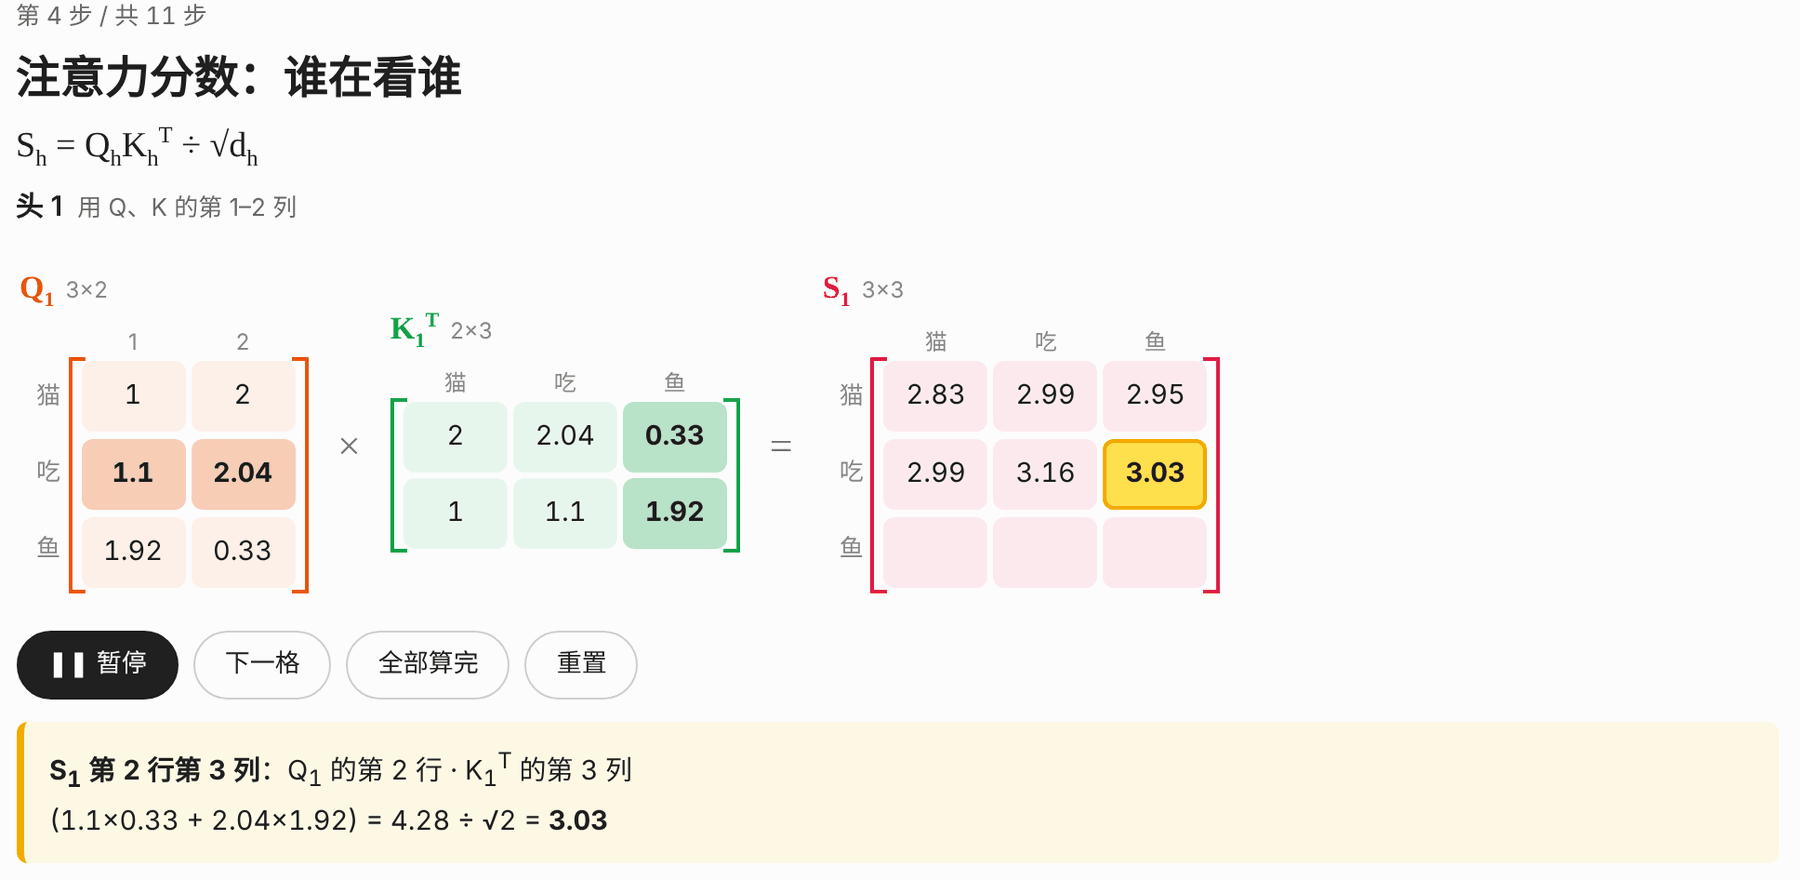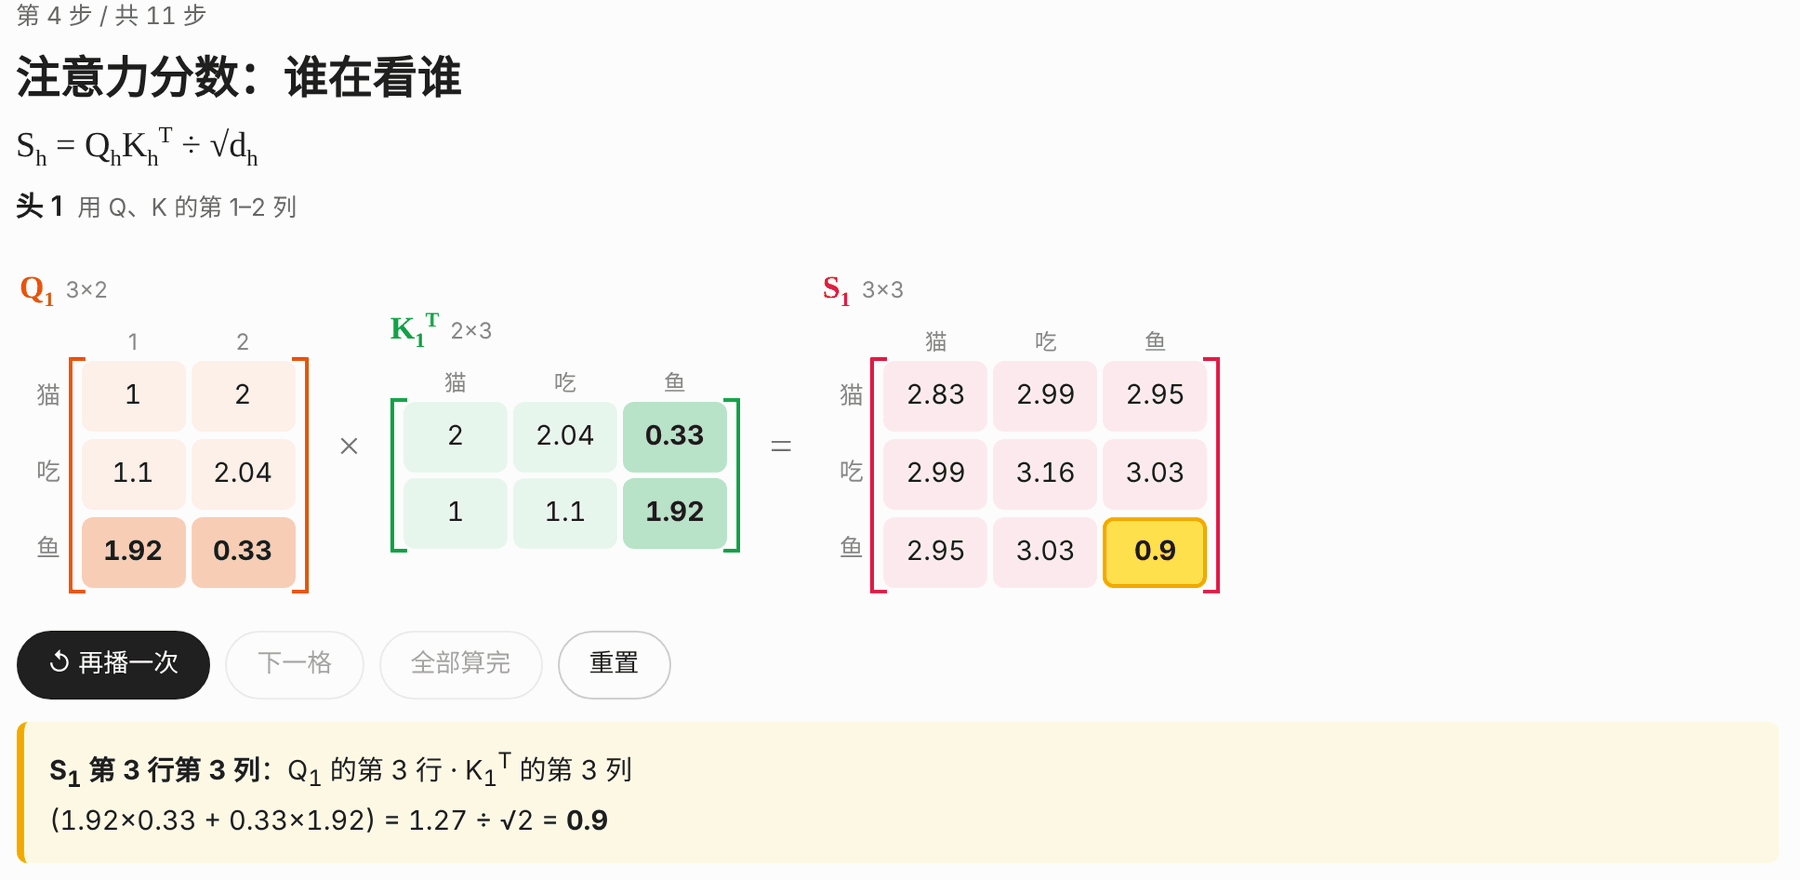
먼저 한 장의 그림으로 이해하는 Transformer를 살펴본 다음, 대규모 언어 모델 추론 시각화를 사용해 챕터 코드와 대조하는 것을 권장합니다.
HuggingFace 결과와 정렬
저장소에는 형태 검사와 HuggingFace 공식 구현과의 정렬 테스트가 포함되어 있습니다. 무작위 가중치를 사용해 빠르게 비교할 수 있을 뿐 아니라, 실제 GPT-2 가중치를 다운로드해 추가로 검증할 수도 있습니다.
설치 전 준비
시작하기 전에 기본적인 Python 코드 독해 능력과 행렬 곱셈 같은 기초 선형대수 개념에 대한 이해가 필요합니다. 프로젝트에서 명시한 실행 환경은 Python 3.9 이상과 PyTorch 2.x입니다.
먼저 저장소를 복제하고 프로젝트 디렉터리로 이동한 후 의존성을 설치합니다.
git clone https://github.com/aa1143/NamiGPT.git
cd NamiGPT
pip install -r requirements.txt
HuggingFace에서 공식 가중치를 다운로드할 때 네트워크가 제한된다면 현재 터미널에서 미러 주소를 설정할 수 있습니다.
export HF_ENDPOINT=https://hf-mirror.com이 미러는 공식 가중치를 다운로드하는 데만 사용됩니다. 이후 from_pretrained를 호출할 때도 모델 구조는 여전히 NamiGPT의 직접 구현에서 제공됩니다.
첫 번째 단계: 챕터별로 GPT-2 이해하기
초보자에게 가장 적합한 방법은 완성된 모델을 바로 읽는 것이 아니라 추론 데이터 흐름에 따라 챕터별로 학습하는 것입니다.
- 입력 단계: 먼저 Tokenizer, Embedding, 위치 인코딩을 익힙니다.
- 어텐션 단계: Self-Attention을 이해한 뒤 Multi-Head Attention으로 확장합니다.
- 모듈 단계: 잔차 연결, LayerNorm, FFN, 활성화 함수를 학습합니다.
- 모델 단계: 구성 요소를 Transformer Block으로 결합하고, 이를 쌓아 완전한 GPT-2를 구성합니다.
- 응용 단계: 공식 가중치를 불러오고 텍스트를 생성한 뒤 해석 가능성 결과를 확인합니다.
각 스크립트는 독립적으로 실행할 수 있습니다. 예를 들어 멀티헤드 어텐션 챕터를 실행하려면 다음 명령을 사용합니다.
python chapters/01-inference/ep06_multi_head_attention.py전체 그림과 설명이 포함된 내용은 NamiGPT 그림 튜토리얼에서 확인할 수 있으며, 저장소의 원고는 docs/01-inference/에 있습니다.
두 번째 단계: GPT-2를 불러와 텍스트 생성하기
설치가 완료되면 NamiGPT가 제공하는 모델 로딩 및 생성 인터페이스를 바로 가져올 수 있습니다. 아래 예제는 GPT-2 tokenizer를 사용해 영어 프롬프트를 token ID로 인코딩한 다음, 직접 구현한 모델과 공식 124M 가중치를 불러옵니다.
import tiktoken, torch
from gpt2 import from_pretrained, generate

enc = tiktoken.get_encoding("gpt2")
model = from_pretrained("gpt2")

ids = torch.tensor([enc.encode("The cat sat on the")])
out = generate(
    model,
    ids,
    max_new_tokens=30,
    temperature=0.8,
    top_k=50,
)
print(enc.decode(out[0].tolist()))
코드 실행 과정
tiktoken.get_encoding("gpt2")가 GPT-2에서 사용하는 인코더를 가져옵니다.enc.encode(...)가 프롬프트 텍스트를 token ID로 변환합니다.torch.tensor가 ID를 모델에 필요한 배치 텐서로 감쌉니다.from_pretrained("gpt2")가 직접 구현한 GPT-2를 생성하고 공식 124M 가중치를 불러옵니다.generate가 프롬프트 텍스트 뒤에 최대 30개의 새 token을 생성합니다.enc.decode가 출력 token ID를 다시 텍스트로 변환합니다.
주의: GPT-2는 대화용으로 미세 조정되지 않았습니다. 기존 내용을 이어 쓰는 데 강점이 있으며, 채팅 모델처럼 질문에 답하는 모델은 아닙니다. 학습 말뭉치가 주로 영어로 구성되어 있으므로 처음에는 영어 프롬프트를 사용하는 것이 좋습니다.
세 번째 단계: 생성 매개변수 이해하기
예제에서는 두 가지 중요한 샘플링 매개변수를 사용합니다.
temperature=0.8: 후보 token의 확률 분포를 조정합니다. 프로젝트의 생성 모듈은 온도 전략을 지원합니다.top_k=50: 확률이 높은 상위 50개의 후보 token 중에서만 선택합니다. 프로젝트는 그리디 생성과 top-k 생성을 모두 지원합니다.
학습할 때는 프롬프트 텍스트를 그대로 유지하고 온도나 top-k만 조정한 뒤 이어쓰기 결과를 비교해 볼 수 있습니다. 이를 통해 생성 전략이 출력에 미치는 영향을 직관적으로 확인할 수 있지만, 구체적인 매개변수는 실험 목표에 따라 선택해야 합니다.
네 번째 단계: Gradio 웹 데모 실행
브라우저에서 프롬프트를 입력하고 이어쓰기 결과와 각 단계의 후보 단어 확률을 확인하려면 Gradio를 설치한 후 저장소의 데모 프로그램을 실행할 수 있습니다.
pip install gradio
python demo/app.py
웹 데모는 모델의 각 단계별 예측을 관찰하는 데 적합하고, 챕터 스크립트는 개별 구성 요소의 계산 과정을 연구하는 데 적합합니다. 두 가지를 함께 사용하면 최종 텍스트와 내부 확률 변화를 연결해 볼 수 있습니다.
다섯 번째 단계: 테스트 실행
어텐션, 가중치 로딩, 생성 로직을 수정한 후에는 테스트를 실행하는 것이 좋습니다. 기본 테스트는 무작위 가중치를 사용해 비교하므로 사전 학습 모델을 다운로드할 필요가 없으며, 일반적으로 빠르게 완료됩니다.
pytest tests/ -v실제 GPT-2 가중치를 사용해 추가 정렬 테스트를 수행하려면 다음 명령을 실행합니다.
TEST_PRETRAINED=1 pytest tests/ -v두 번째 명령은 실제 가중치를 추가로 다운로드하므로 처음 실행할 때는 다운로드가 완료될 때까지 기다려야 합니다.
저장소 구조 한눈에 보기
gpt2/config.py: 124M, 355M, 774M, 1.5B 사양을 포함한 모델 구성gpt2/model.py: LayerNorm, Attention, FFN, Block, GPT 모델 본체gpt2/load_weights.py: 공식 가중치를 직접 구현한 모델에 로드gpt2/generate.py: 그리디, 온도, top-k 생성 로직chapters/01-inference/: 각 튜토리얼에 대응하는 데모 스크립트docs/01-inference/: 튜토리얼 원고demo/app.py: Gradio 웹 데모tests/: 형태 검사 및 HuggingFace 정렬 테스트
고급 팁: HuggingFace와 정렬할 때 중요한 세 가지 사항
1. 인과 마스크를 올바르게 적용하기
GPT-2는 자기회귀 언어 모델입니다. 시퀀스의 각 단어는 자신과 앞에 있는 단어만 읽을 수 있으며, 뒤에 있는 token을 미리 볼 수 없습니다. 인과 마스크를 빠뜨리면 공식 가중치를 성공적으로 불러오더라도 모델 출력이 잘못됩니다.
2. 가중치를 옮길 때 전치 처리하기
GPT-2 원본 구현은 Conv1D를 사용하며 가중치 형태는 [in, out]입니다. 반면 PyTorch의 nn.Linear는 [out, in]을 사용합니다. 따라서 공식 매개변수를 직접 구현한 선형 계층에 불러올 때는 반드시 전치해야 합니다.
또한 c_attn은 Query, Key, Value의 매개변수를 하나로 이어 붙입니다. 직접 구현한 모델과 정렬할 때는 먼저 이를 해당하는 세 부분으로 나눈 다음 올바른 위치에 넣어야 합니다.
3. tanh 근사 GELU 사용하기
GPT-2는 GELU의 tanh 근사 버전을 사용하지만 PyTorch의 nn.GELU()는 기본적으로 정확한 버전을 사용합니다. 항목별로 정렬하려면 다음과 같이 설정해야 합니다.
nn.GELU(approximate="tanh")이 세 가지 세부 사항은 작아 보이지만 직접 구현한 모델이 공식 구현의 결과를 재현할 수 있는지에 직접적인 영향을 줍니다. 오차를 추적할 때는 마스크, 매개변수 형태, 활성화 함수 버전을 차례로 확인할 수 있습니다.
권장 학습 및 디버깅 방법
- 먼저 아키텍처 동적 시각화를 통해 GPT-2가 Transformer의 디코더 부분만 사용한다는 전체 구조를 이해합니다.
- 현재 챕터의 스크립트를 실행하고 입력, 출력, 중간 텐서의 형태를 기록합니다.
- 어텐션 행렬이 이해하기 어려울 때는 온라인 행렬 시각화를 참고해 각 칸을 확인합니다.
- 구성 요소 하나를 완성한 후
gpt2/model.py의 해당 구현을 읽습니다. - 구현을 수정한 후 먼저 무작위 가중치 테스트를 실행하고, 필요에 따라 실제 가중치 테스트를 실행합니다.
- 마지막으로 텍스트 생성 예제와 Gradio 페이지를 사용해 전체 모델의 동작을 관찰합니다.
이 순서를 따르면 아키텍처, 행렬 계산, 챕터 코드, 완성된 모델, 최종 출력을 하나로 연결할 수 있어 처음부터 GPT-2의 복잡한 다층 구조에 압도되는 일을 피할 수 있습니다.
정리
NamiGPT는 기초 행렬 계산부터 완전한 GPT-2 추론까지 이어지는 학습 경로를 제공합니다. 먼저 독립된 장별 스크립트를 실행해 각 구성 요소를 이해한 다음, OpenAI 공식 가중치를 불러와 영어 텍스트를 이어 쓰고, 마지막으로 시각화 및 HuggingFace 정렬 테스트를 통해 자신의 이해와 수정 내용을 검증할 수 있습니다.
프로젝트 코드는 MIT 라이선스를 따르며, docs/ 디렉터리의 문서는 CC BY-NC 4.0 라이선스를 따릅니다. 재배포 시 출처를 밝혀야 하며 상업적 이용은 금지됩니다.