
LLaMA Factory(현재 LlamaFactory로 이름 변경)는 대규모 언어 모델을 위한 통합 미세 조정 프레임워크입니다. 이 프로젝트는 베이항대학교 정야오웨이 박사 팀이 시작했으며, ACL 2024 논문을 통해 학술적 근거를 제시했습니다. 프레임워크는 "코드 없는 CLI + Web UI" 설계를 채택해 미세 조정 과정을 간소화하는 것을 목표로 합니다. LlamaFactory는 GitHub에서 누적 72 000개 이상의 Stars를 획득했으며, 대규모 모델 미세 조정 분야의 참고 구현으로 자리 잡았습니다.
>
1. 프로젝트 개요
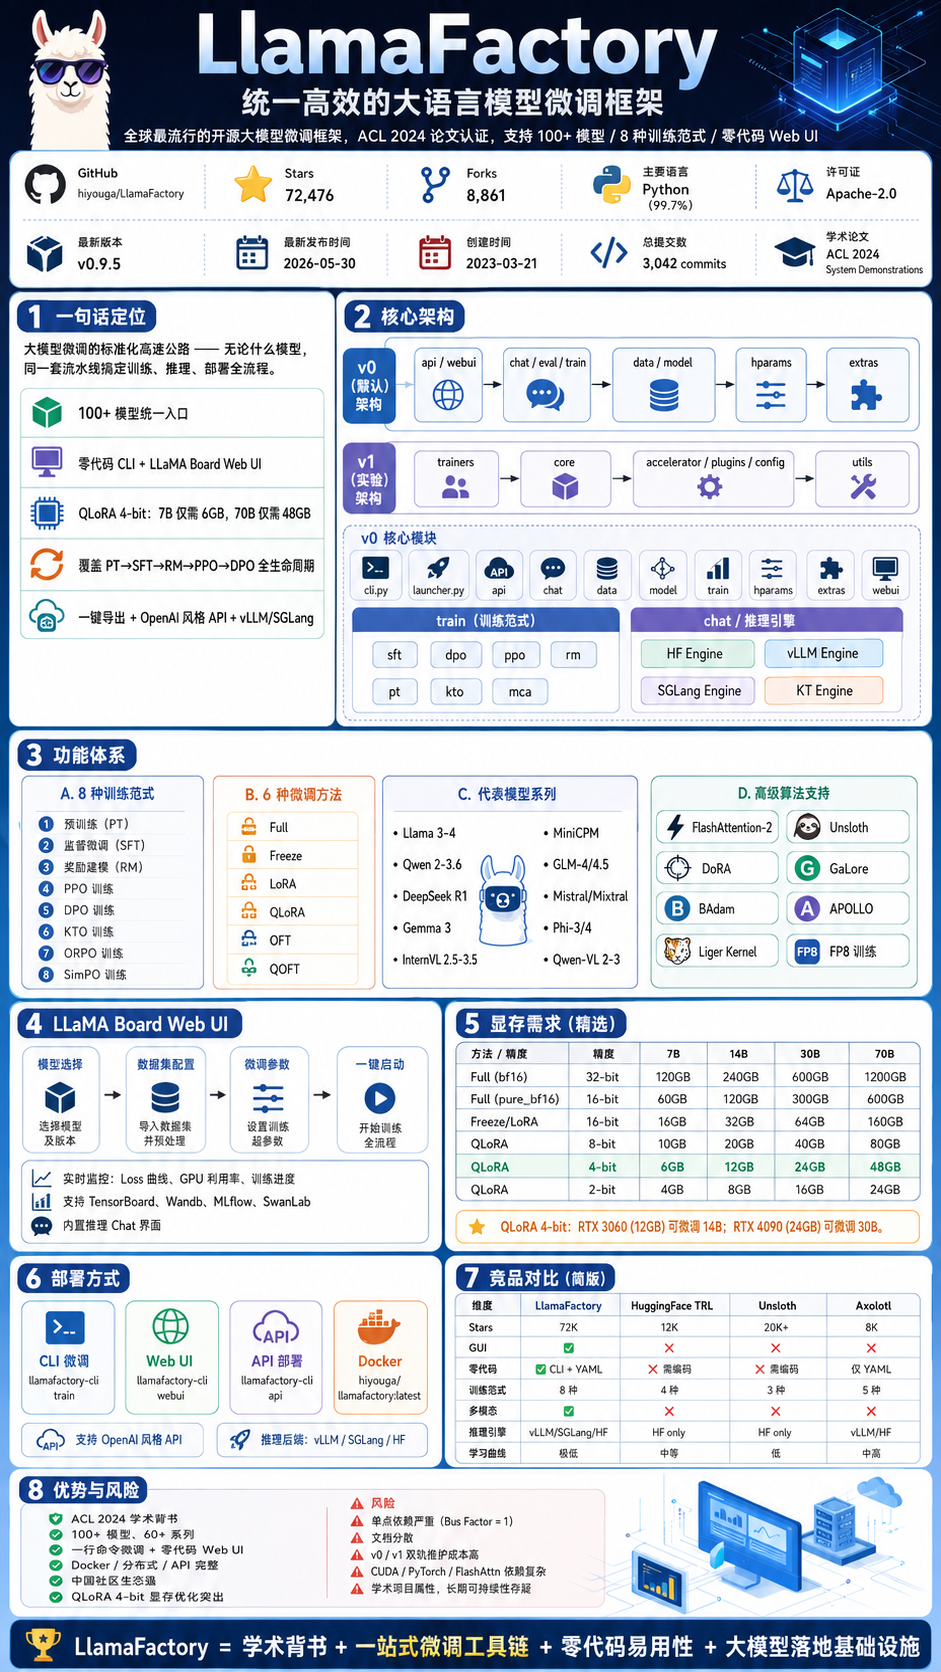
항목|세부 내용
프로젝트 정식 명칭|LlamaFactory(구 LLaMA-Factory)
GitHub 주소|github.com/hiyouga/LlamaFactory
Stars|72,476 ⭐
Forks|8,861
주요 언어|Python(99.7%)
라이선스|Apache-2.0
생성일|2023-03-21
최신 버전|v0.9.5(2026-05-30)
총 커밋 수|3,042 commits
핵심 기여자|hiyouga(정야오웨이, 2,188 commits, 전체 커밋의 72%)
학술 논문|ACL 2024 System Demonstrations
저장소 크기|~412.9 MB
Open Issues|57
창립자 정야오웨이(hiyouga)는 베이항대학교 박사 과정 학생으로, 제1저자로 ACL, CVPR, WWW 등 국제 최고 수준 학회에서 여러 논문을 발표했으며 AAAI, EMNLP 등의 학회 심사위원을 맡았습니다. 수상 경력으로는 화웨이 컵, 란차오 컵 전국 1등상, 베이항대학교 학생 올해의 인물, Ascend 생태계 오픈 소스 공헌상 등이 있습니다. 협력 팀원으로는 베이항대학교 교수 장리충, 장쥔하오, 예옌한, 뤄저옌, 펑장츠, 마융창 등이 있습니다.
2. 프로젝트 포지셔닝과 핵심 가치
2.1 한 문장으로 보는 포지셔닝
표준화된 대규모 모델 미세 조정 파이프라인: 모든 모델에 적용 가능한 통합 프로세스로, 데이터 준비, 모델 학습, 추론 검증 및 배포 등 전체 과정을 포괄합니다.
2.2 해결하는 핵심 문제
문제점|LLaMA Factory의 해결책
모델마다 미세 조정 과정이 달라 전환 비용이 높음|알고리즘-모델-데이터 "분리" 설계, 100+ 모델을 위한 통합 진입점
미세 조정 코드의 진입 장벽이 높고 딥러닝 전문 지식이 필요함|코드 없는 CLI + LLaMA Board Web UI(Gradio)
VRAM 부족으로 소비자용 GPU에서 대규모 모델을 학습할 수 없음|QLoRA 4-bit: 7B는 6GB, 70B는 48GB만 필요
오픈 소스 커뮤니티에 원스톱 도구 체계가 부족함|PT→SFT→RM→PPO→DPO 전체 수명 주기 지원
추론 배포가 복잡함|원클릭 내보내기 + OpenAI 스타일 API + vLLM/SGLang
2.3 설계 철학: 알고리즘-모델-데이터 "분리"
한 인터뷰에서 정야오웨이는 모델 추론 과정을 표준화된 고속도로를 달리는 차량에 비유했습니다. 모델 자체는 다양한 유형의 차량에 해당하고, 데이터는 차량에 실린 화물에 해당합니다. 모델이 이 고속도로에서 원활하게 작동하기만 하면 미세 조정 과정은 매개변수 조정만으로 완료할 수 있습니다.
3. 기술 아키텍처 심층 분석
3.1 이중 아키텍처 병렬 설계
LLaMA Factory는 v0(안정 버전)와 v1(실험 버전) 두 가지 아키텍처를 동시에 제공하며, 환경 변수 USE_V1을 설정해 두 버전 간에 전환할 수 있습니다.
v0(기본값): api/webui → chat/eval/train → data/model → hparams → extras
v1(실험): trainers → core → accelerator/plugins/config → utils
v0 아키텍처는 현재 주류 구현으로, 전체 기능과 완비된 문서를 제공합니다. v1 아키텍처는 아직 실험 단계이며 더욱 모듈화된 계층형 설계를 채택했습니다.
3.2 v0 핵심 모듈 상세 설명
src/llamafactory/
├── cli.py              # CLI 진입점, llamafactory-cli 명령 분배
├── launcher.py          # 런처, USE_V1에 따른 분배
├── api/                 # OpenAI 스타일 REST API
│   ├── app.py           # FastAPI 애플리케이션
│   ├── chat.py          # 대화 엔드포인트
│   └── protocol.py      # 프로토콜 정의
├── chat/                # 추론 엔진 계층
│   ├── base_engine.py   # 추상 기본 클래스
│   ├── hf_engine.py     # HuggingFace 네이티브 추론
│   ├── vllm_engine.py   # vLLM 고성능 추론
│   └── sglang_engine.py # SGLang 추론
├── data/                # 데이터 처리 계층
│   ├── template.py      # 100+ 모델 Prompt 템플릿 등록
│   ├── mm_plugin.py     # 멀티모달(이미지/동영상/오디오) 처리
│   ├── loader.py        # 데이터 세트 로더
│   ├── processor/       # 학습 단계별 프로세서
│   └── converter.py     # 형식 변환(Alpaca/ShareGPT)
├── model/               # 모델 계층
│   ├── loader.py        # 모델+토크나이저 로드, 양자화, LoRA
│   └── patcher.py       # 모델 호환성 패치
├── train/               # 학습 계층
│   ├── sft/             # 지도 미세 조정
│   ├── dpo/             # DPO 선호도 최적화
│   ├── ppo/             # PPO 강화 학습
│   ├── rm/              # 보상 모델링
│   ├── pt/              # 사전 학습
│   ├── kto/             # KTO 학습
│   └── mca/             # Megatron-Core 어댑터
├── hparams/              # 매개변수 설정 계층
│   ├── model_args.py    # 모델 매개변수
│   ├── data_args.py     # 데이터 매개변수
│   ├── finetuning_args.py # 미세 조정 매개변수
│   └── training_args.py # 학습 매개변수(HF TrainingArguments 상속)
├── extras/               # 도구 패키지
│   ├── constants.py     # 전역 상수/열거형
│   └── packages.py      # 종속성 검사
└── webui/                # LLaMA Board Web 인터페이스
    ├── interface.py     # Gradio 인터페이스 구축
    ├── runner.py        # 학습 작업 시작
    └── components/      # UI 구성 요소
3.3 학습 과정(v0 Training Flow)
llamafactory-cli train xxx.yaml
  → run_exp() [tuner.py]
    → read_args() → YAML/JSON 설정 파싱
    → get_train_args() → 4개의 형식화된 dataclass 생성:
        ModelArguments + DataArguments + FinetuningArguments + TrainingArguments
    → 구체적인 학습 함수로 라우팅:
        run_sft / run_dpo / run_ppo / run_rm / run_pt / run_kto
    → (선택 사항) export_model() → LoRA 가중치 병합 및 내보내기
3.4 추론 엔진 매트릭스
엔진|특징|적용 시나리오
HF Engine|네이티브 HuggingFace, 최고의 호환성|개발 디버깅, 소규모 추론
vLLM Engine|270% 추론 가속, PagedAttention|고성능 온라인 추론
SGLang Engine|RadixAttention, 구조화된 생성|배치 추론, 복잡한 생성
KT Engine|지식 이전 전용|모델 증류
4. 기능 체계
4.1 지원 학습 패러다임(8종 × 6종 미세 조정 방법 = 48가지 조합)
학습 패러다임|Full|Freeze|LoRA|QLoRA|OFT|QOFT
사전 학습(PT)|✅|✅|✅|✅|✅|✅
지도 미세 조정(SFT)|✅|✅|✅|✅|✅|✅
보상 모델링(RM)|✅|✅|✅|✅|✅|✅
PPO 학습|✅|✅|✅|✅|✅|✅
DPO 학습|✅|✅|✅|✅|✅|✅
KTO 학습|✅|✅|✅|✅|✅|✅
ORPO 학습|✅|✅|✅|✅|✅|✅
SimPO 학습|✅|✅|✅|✅|✅|✅
4.2 지원 모델 시리즈(60+ 시리즈, 100+ 변형)
대표 모델 엄선:
모델 시리즈|파라미터 규모|특징
Llama 3-4|1B–402B|Meta의 플래그십 오픈 소스 모델
Qwen 2-3.6|0.5B–397B|알리바바 통이치엔원 전체 시리즈
DeepSeek R1|1.5B–671B|추론 모델 증류 버전
Gemma 3|270M–27B|Google 경량 모델
InternVL 2.5-3.5|1B–241B|멀티모달 비전 언어 모델
MiniCPM|0.5B–9B|엣지 배포 최적화
GLM-4/4.5|9B–355B|지푸 ChatGLM 시리즈
Mistral/Mixtral|7B–8x22B|MoE 전문가 혼합
Phi-3/4|3.8B–14B|Microsoft 소형 고성능 모델
Qwen-VL 2-3|2B–235B|비전 언어 모델
4.3 고급 알고리즘 지원
알고리즘|기능|도입 버전
FlashAttention-2|어텐션 계산 가속|2023-09
Unsloth|훈련 170% 가속 + VRAM 50% 절감|2023-12
DoRA|가중치 분해 LoRA|2024-02
GaLore|그래디언트 저랭크 최적화|2024-03
BAdam|블록 좌표 하강 최적화|2024-04
APOLLO|고차 최적화기|2025-Q1
Liger Kernel|Triton 커널 가속|2025
FP8 훈련|Transformer Engine 지원|2025
4.4 LLaMA Board Web UI
Gradio 기반으로 구축된 노코드 시각화 인터페이스
모델 선택 → 데이터셋 구성 → 파인튜닝 파라미터 → 클릭 한 번으로 훈련 시작
실시간 모니터링: Loss 곡선, GPU 사용률, 훈련 진행률
TensorBoard, Wandb, MLflow, SwanLab 등 다양한 백엔드 로그 지원
추론용 Chat 인터페이스 내장, 훈련 완료 후 바로 테스트 가능
4.5 배포 방식
# CLI 파인튜닝 (한 줄 명령어)
llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml

# Web UI
llamafactory-cli webui

# OpenAI 스타일 API 배포
API_PORT=8000 llamafactory-cli api examples/inference/qwen3.yaml

# Docker
docker run -it --rm --gpus=all hiyouga/llamafactory:latest
5、하드웨어 요구 사항 (VRAM 추정)
방법|정밀도|7B|14B|30B|70B
Full (bf16)|32-bit|120GB|240GB|600GB|1200GB
Full (pure_bf16)|16-bit|60GB|120GB|300GB|600GB
Freeze/LoRA|16-bit|16GB|32GB|64GB|160GB
QLoRA|8-bit|10GB|20GB|40GB|80GB
QLoRA|4-bit|6GB|12GB|24GB|48GB
QLoRA|2-bit|4GB|8GB|16GB|24GB
QLoRA 4-bit 양자화를 사용하면 단일 RTX 3060(12 GB VRAM)에서 14 B 파라미터 모델을, 단일 RTX 4090(24 GB VRAM)에서 30 B 파라미터 모델을 파인튜닝할 수 있습니다.
6、버전 발전
버전|날짜|주요 변경 사항
v0.1.0|2023-03|최초 릴리스, LLaMA 파인튜닝 지원
초기 반복|2023|SFT + LoRA/QLoRA, DPO, Web UI, FlashAttention-2, Unsloth
초기 반복|2024 Q1-Q3|DoRA, GaLore, BAdam, FSDP+QLoRA, vLLM, 멀티모달 LLaVA, 논문 발표
v0.9.1|2025 Q1|Llama 3.2 Vision, LLaVA-NeXT, Pixtral, Video-LLaVA
v0.9.2|2025 Q1|MiniCPM-o, SwanLab, APOLLO 최적화기
v0.9.3|2025 Q2|Llama 4, Gemma 3, Qwen3, InternVL3, Qwen2.5-Omni
v0.9.4|2025-12|🔄 저장소를 LlamaFactory로 변경, Python 3.9-3.10 지원 중단
v0.9.5|2026-05-30|Qwen3.5/3.6, Gemma 4, Transformers v5 호환
v1.x (실험)|2026|새 아키텍처 trainers → core → accelerator, 모듈식 재작성
주요 이정표 해설
ACL 2024 논문 발표 —— 학술적 공신력으로 Stars가 1만에서 3만+로 급증
2024년 하반기 —— 멀티모달 지원(LLaVA/Video/오디오)으로 새로운 시장 개척
2025년 —— 월간 업데이트 주기를 유지하고 Qwen3/DeepSeek/Llama4를 지원하며 중국 오픈 소스 커뮤니티의 첫 번째 선택으로 자리매김
저장소 이름 변경 —— LLaMA-Factory → LlamaFactory, Meta 브랜드 의존성 제거
v1 실험 아키텍처 —— 대규모 재구성이 임박했음을 시사
7、커뮤니티 생태계
7.1 프로젝트 생태계 매트릭스
프로젝트|설명|Stars
LlamaFactory|핵심 파인튜닝 프레임워크|72K+
EasyR1|VLM 강화학습(GRPO/DAPO/Reinforce++)|신흥
FastEdit|효율적인 모델 사실 편집|보관됨
llamafactory-community|커뮤니티 교류 센터|-
Easy Dataset|합성 데이터 생성 도구|서드파티
DataFlow|데이터 처리 파이프라인|서드파티
7.2 커뮤니티 인기
중국 AI 커뮤니티: CSDN, 즈후, 블로그원에 수백 편의 튜토리얼/실전 경험 공유
기업 도입: 알리바바 클라우드, 화웨이 어센드, Amazon AWS, NVIDIA가 공식 추천
교육 분야: 푸단대학교 및 여러 대학에서 대규모 모델 강의 교육 도구로 사용
중국어 지원: ModelScope(마타 커뮤니티), OpenMind Hub 미러 다운로드를 기본 지원
LLaMA Factory Online: 온라인 플랫폼 서비스를 제공했으나 2026-06-20 종료
7.3 경쟁 제품 비교
프레임워크|Stars|핵심 특징|모델 지원|사용 편의성
LlamaFactory|72K|원스톱 GUI/CLI, ACL 논문 공신력|100+|⭐⭐⭐⭐⭐
HuggingFace TRL|12K|HF 공식 도구 체인, 생태계와 긴밀한 통합|모든 HF 모델|⭐⭐⭐
Axolotl|8K|YAML 기반, 고급 사용자 맞춤 설정|주요 모델|⭐⭐⭐
Unsloth|20K+|극한의 성능 최적화(2-5배 가속)|LLaMA/Mistral 등|⭐⭐⭐⭐
Firefly|5K|중국어 대규모 모델 최적화|중국어 모델 중심|⭐⭐⭐
LLaMA-Adapter|6K|학술 연구 지향|LLaMA 시리즈|⭐⭐
LlamaFactory의 핵심 강점:
동시에 ACL 논문 + 7만 Stars + 상용 도입 사례 + 노코드 GUI를 보유한 유일한 프레임워크
가장 폭넓은 모델 지원( GPT-2부터 Llama 4까지, 순수 텍스트부터 멀티모달까지)
중국 커뮤니티 생태계가 가장 강력함(HuggingFace 미러 + ModelScope 통합)
8、SWOT 분석
8.1 강점 (Strengths)
강점|상세 내용
🔬 학술적 권위|ACL 2024 논문, 학술 인용 500+회
🎯 매우 낮은 진입 장벽|한 줄 명령어 파인튜닝, Web UI 노코드 조작
🌐 가장 폭넓은 모델 지원|100+ 모델, 60+ 시리즈, 텍스트/비전/비디오/오디오
🇨🇳 중국 커뮤니티 생태계|ModelScope/OpenMind 미러, 풍부한 중국어 튜토리얼
🔧 산업급 도구 체인|Docker/분산/API 배포를 모두 지원
💾 극한의 VRAM 최적화|QLoRA 4-bit로 소비자용 GPU에서 70B 실행
8.2 약점 (Weaknesses)
약점|상세 내용
👤 심각한 단일 의존성|hiyouga 한 명이 커밋의 72%(2,188/3,042)를 차지, Bus Factor = 1
📚 분산된 문서|README가 매우 김(68KB), Wiki/ReadTheDocs/커뮤니티 글의 정보가 파편화됨
🐛 Issue 적체|Open Issues는 57개뿐이지만 Issue 영역의 논의량은 매우 큼
🏗️ v0/v1 이중 트랙 분열|이중 아키텍처 유지 비용이 높고 v1은 장기간 안정화되지 않음
📦 복잡한 패키지 의존성|CUDA/PyTorch/FlashAttn 버전 조합에서 오류가 발생하기 쉬움
🔒 학술 프로젝트 성격|전담 운영팀이 없어 장기 지속 가능성이 불확실함
8.3 기회 (Opportunities)
기회|상세 내용
🚀 Agent 파인튜닝 분야|Function Calling / Tool Use 파인튜닝 수요 급증
🎥 멀티모달 확장|Video/Audio/3D 모델 파인튜닝의 블루오션 시장
☁️ 클라우드 네이티브 SaaS|LLaMA Factory Online은 종료되었지만 기업용 관리형 서비스 수요는 여전히 존재
🏢 기업 교육 시장|대규모 모델 파인튜닝 교육 과정 및 인증 체계
🔗 MCP 통합|AI Agent 인프라를 위한 파인튜닝 백엔드
8.4 위협 (Threats)
위협|상세 내용
🏢 대기업 자체 개발 프레임워크|알리바바 PAI, 화웨이 ModelArts가 통합 솔루션 제공
🔄 HF 공식 경쟁|HuggingFace TRL/peft 생태계가 점점完善됨
📉 파인튜닝 수요 감소|Prompt Engineering + RAG가 일부 파인튜닝 분야를 대체
👨🎓 창립자의 졸업|정야오웨이 박사 졸업 후 프로젝트 유지 관리 역량이 저하될 가능성
9、위험 평가
위험 유형|위험 수준|설명
Bus Factor|🔴 높음|단일 핵심 개발자가 커밋의 72%를 차지하므로, 이탈 시 프로젝트가 중단될 위험이 매우 높음
기술 부채|🟡 중간|v0/v1 이중 아키텍처, 68KB README, 문서 파편화
의존성 체인|🟡 중간|CUDA/PyTorch/FlashAttn 버전 매트릭스 유지 비용이 높음
상용화|🟢 낮음|Apache-2.0 라이선스로 상업적 제한 없음
커뮤니티 건강도|🟢 건강|7.2만 Stars, 활발한 글로벌 커뮤니티, 광범위한 기업 도입
10. 기술적 강점과 혁신
10.1 "표준화된 고속도로" 아키텍처
기존 파인튜닝에서는 모델마다 별도의 어댑테이션이 필요합니다. LLaMA Factory는 템플릿 등록 메커니즘과 monkey‑patch 기술을 결합해 어댑테이션 비용을 크게 낮췄습니다.
# 새 모델 추가는 3단계면 충분합니다:
# 1. template.py의 TEMPLATES 딕셔너리에 Prompt 템플릿 등록
# 2. patcher.py에 모델 호환성 패치 추가(필요한 경우)
# 3. mm_plugin.py에 멀티모달 지원 추가(필요한 경우)
10.2 4계층 파라미터 설정 시스템
YAML/JSON 설정 파일
  → parser.py 파싱
    → ModelArguments(모델 선택, 양자화)
    → DataArguments(데이터셋, 템플릿, 전처리)
    → FinetuningArguments(LoRA rank/target, 학습 방법)
    → TrainingArguments(HF 상속, 분산 학습/로그/checkpoint)
10.3 데이터 파이프라인 표준화
이 도구는 Alpaca와 ShareGPT라는 두 가지 주요 데이터 형식을 지원하며, 50개 이상의 사전 구성 데이터셋을 자동으로 변환하고 JSON, JSONL, CSV, Parquet, Arrow 등의 파일 형식과 호환됩니다.
10.4 점진적 양자화 지원
16 비트 전체 정밀도부터 2 비트 QLoRA까지 6가지 정밀도 수준을 지원하며, A100 서버 클러스터와 일반 노트북 등 다양한 하드웨어 환경에서 사용할 수 있습니다.
11. 경쟁 제품 비교 매트릭스
차원|LlamaFactory|HuggingFace TRL|Unsloth|Axolotl
Stars|72K|12K|20K+|8K
모델 지원|100+ 시리즈|모든 HF|LLaMA/Qwen/Mistral|주요 시리즈
GUI|✅ LLaMA Board|❌|❌|❌
코드 없음|✅ CLI + YAML|❌ 코딩 필요|❌ 코딩 필요|YAML만 지원
학습 패러다임|8종|4종 (SFT/DPO/PPO/GRPO)|3종|5종
양자화 범위|2-16bit|4-16bit|4-16bit|4-16bit
멀티모달|✅ 이미지/동영상/오디오|❌|❌|❌
중국어 생태계|✅ ModelScope + 魔搭|⚠️ 우회 접속 필요|⚠️ 우회 접속 필요|❌
학술 논문|ACL 2024|-|-|-
추론 엔진|vLLM/SGLang/HF|HF only|HF only|vLLM/HF
학습 곡선|매우 낮음|중간|낮음|중상
12. 배포 실전 핵심 사항
12.1 빠른 시작(3단계)
# Step 1: 설치
git clone --depth 1 github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e ".[torch,metrics]"

# Step 2: Web UI 시작
llamafactory-cli webui

# Step 3: 브라우저에서 localhost:7860을 열고 모델 → 데이터셋 → 학습을 선택하세요!
12.2 프로덕션 환경 권장 사항
# Docker 배포(권장)
docker run -it --rm --gpus=all \
    -v ./hf_cache:/root/.cache/huggingface \
    -v ./data:/app/shared_data \
    -v ./output:/app/output \
    -p 7860:7860 -p 8000:8000 \
    hiyouga/llamafactory:latest

# API 배포(OpenAI 호환)
API_PORT=8000 llamafactory-cli api \
    examples/inference/qwen3.yaml \
    infer_backend=vllm
12.3 Windows 사용자 유의 사항
PyTorch GPU 버전을 수동으로 설치해야 합니다:
pip install torch torchvision torchaudio --index-url download.pytorch.org/whl/cu126QLoRA를 사용하려면 Windows 전용 bitsandbytes 사전 컴파일 버전을 설치해야 합니다
Windows에서 FlashAttention-2를 사용하려면 수동 컴파일이 필요합니다
dataloader_num_workers: 0을 설정해 직렬화 오류를 방지하세요
13. 향후 전망
v1 아키텍처 안정화:실험 브랜치는 2026-2027년에 주 아키텍처가 될 것으로 예상되며, 모듈화 수준이 더욱 높아질 전망입니다
에이전트 파인튜닝 심화:Tool Use / Function Calling 파인튜닝이 표준 기능이 될 것입니다
추론 모델(Reasoning) 파인튜닝:DeepSeek-R1 증류 + GRPO 파인튜닝(EasyR1 프로젝트)
클라우드 네이티브 호스팅:LLaMA Factory Online 종료 후 서드파티 호스팅 솔루션이 등장할 가능성이 있습니다
멀티모달 학습 통합:동일한 프레임워크에서 텍스트/이미지/동영상/오디오를 파인튜닝
14. 평가 및 요약
차원|평점|평가
기술 아키텍처|9.5/10|모듈화 설계, 이중 아키텍처 발전, 풍부한 엔진 매트릭스
기능 완성도|10/10|8가지 학습 패러다임 × 6가지 파인튜닝 방법 × 100+ 모델
사용 편의성|10/10|한 줄 명령어 파인튜닝 + 코드 없는 Web UI, 업계 최고 수준
문서 품질|7.5/10|README는 상세하지만 지나치게 길고 파편화가 심함
커뮤니티 활성도|9.5/10|72K Stars, 중국 커뮤니티에서 이례적으로 높은 인기
프로덕션 준비도|9.0/10|Docker/API/분산 학습을 모두 지원하며 기업 검증이 충분함
지속 가능성|6.5/10|Bus Factor=1, 학술 프로젝트 성격으로 장기 전망이 불확실함
혁신성|8.5/10|ACL 논문, 템플릿 등록 메커니즘, 4계층 파라미터 시스템
종합 평점: 9.
한 문장 요약
LLaMA Factory는 ACL 2024 논문을 기반으로 구현된 오픈 소스 대규모 언어 모델 파인튜닝 프레임워크로, GitHub에서 약 72 000개의 별을 받아 커뮤니티의 인정을 얻었습니다. 이 프레임워크는 “알고리즘‑모델‑데이터 분리”라는 설계 이념을 따르며, 코드가 필요 없는 명령줄 인터페이스(CLI)와 Web UI를 제공하고 100개 이상의 모델 파인튜닝을 지원해 대규모 언어 모델 파인튜닝의 기술적 진입 장벽을 크게 낮춥니다. 대규모 언어 모델 애플리케이션을 실제 환경에 도입하기 위한 기반 인프라로 활용할 수 있습니다.