

Rizzo Flow란 무엇인가요?
Rizzo Flow는 구조화되지 않은 텍스트 또는 JSON 상태를 확률이 포함된 타입 지정 의사결정으로 변환하는 오픈 소스 로컬 우선 시스템입니다. 언어 모델에 문장이나 JSON을 토큰 단위로 생성하도록 요청하는 대신, 한 번의 순전파 이후 제한된 답변 문자 집합에 대한 모델의 확률을 읽습니다.
이 설계는 다음과 같은 의사결정을 지원합니다.
true일 확률이 포함된 불리언 답변.- 이름이 지정된 여러 옵션 중 선택하며, 각 옵션의 확률 제공.
- 순서가 있는 평가 기준 단계에 따른 점수.
- 대표 앵커를 기반으로 한 수치 추정.
Rizzo Flow는 llama.cpp를 통해 자체 하드웨어에서 실행됩니다. Apple Metal, NVIDIA CUDA, Vulkan, AMD ROCm, Intel SYCL 또는 CPU 실행을 사용할 수 있습니다. 또한 Jev 호환 HTTP 인터페이스를 제공하므로, 호환 애플리케이션은 호스팅 서비스 대신 로컬 URL을 대상으로 지정할 수 있습니다.
Rizzo Flow는 독립 프로젝트입니다. Jev의 독점 아키텍처나 학습 방식을 재현하는 것이 아니라, Jev를 뒷받침하는 인터페이스 패턴을 재현합니다. 자체 대표 데이터로 보정하지 않는 한 확률은 보정되지 않습니다.
제로 토큰 의사결정의 작동 방식
각 요청에서 Rizzo Flow는 프롬프트의 시작 부분에 상태를 배치하고 한 번 처리합니다. 이후 질문은 공유된 상태 캐시에서 분기됩니다. 가능한 각 답변은 대문자로 된 문자에 매핑되며, 시스템은 허용된 문자에 대한 로짓만 읽습니다.
- 상태를 텍스트로 변환하고 모델의 KV 캐시에 미리 입력합니다.
- 각 질문을 제한된 객관식 문제로 표현합니다.
- 동일한 상태를 공유하는 질문을 마이크로 배치로 평가합니다.
- 허용된 답변 로짓을 소프트맥스로 확률로 변환합니다.
- Python 코드가 스키마 검증을 거친 불리언, 선택지, 점수 또는 수치 데이터를 반환합니다.
디코딩 루프, 샘플링된 텍스트, 출력 파싱 또는 JSON 복구가 없습니다. 하지만 생성 토큰이 0개라고 해서 계산이 0이라는 의미는 아닙니다. 상태와 질문 프롬프트에는 여전히 모델 추론이 필요합니다.
주요 기능
- 완전한 로컬 실행: 모델 추론이 사용자의 컴퓨터에서 수행됩니다.
- 타입 지정 결과: 애플리케이션이 생성된 문장이 아닌 구조화된 값을 받습니다.
- 확률 분포: 선택지 및 점수 결과에서 최댓값 답변만이 아니라 확률을 확인할 수 있습니다.
- 네이티브 기본 요소 4가지: 불리언, 선택지, 점수, 수치.
- 선택적 답변 보류: 네이티브 API가 근거 부족, 불확실성 또는 범위를 벗어난 수치 결과를 보고할 수 있습니다.
- 공유 상태 배칭: 한 요청에 포함된 여러 질문이 상태의 KV 캐시를 재사용합니다.
- Jev 호환 엔드포인트: 기존 클라이언트가
/v1/systemone및/v1/models를 사용할 수 있습니다. - 긴 컨텍스트 모델: Spark-X2.5는 최대 1,048,576 토큰의 네이티브 컨텍스트를 지원하지만, Rizzo Flow는 질문당 기본값으로 8,192 토큰을 사용합니다.
- 로컬 도구: 서버에 플레이그라운드, 대화형 OpenAPI 문서, Snake 데모가 포함되어 있습니다.
사전 요구 사항
Rizzo Flow를 설치하기 전에 다음 항목을 준비하세요.
- Python 3.11 이상.
- Git.
- 의존성과 환경 관리를 위한 uv.
- 선택한 모델과 런타임을 저장할 충분한 디스크 공간.
기본 Spark-X2.5-4B Q8_0 모델의 다운로드 용량은 약 4.4 GB입니다. 런타임 다운로드 용량은 플랫폼에 따라 다르며, Mac에서는 약 11 MB부터 CUDA 패키지에서는 약 570 MB까지입니다.
서버 설치 및 시작
저장소를 복제하고, 고정된 의존성을 동기화하고, 기본 런타임과 모델을 다운로드한 다음 서비스를 시작합니다.
git clone https://github.com/Rizzo-AI-Academy/rizzo-flow
cd rizzo-flow
uv sync --locked
uv run rizzo download
uv run rizzo serve
다운로드 명령은 현재 컴퓨터에 맞는 공식 사전 빌드 llama.cpp 패키지를 선택하고 SHA-256 체크섬을 확인한 뒤 Spark-X2.5-4B Q8_0을 다운로드합니다. 중단된 다운로드는 중단된 지점부터 재개할 수 있습니다.
프로젝트 문서에 따르면 모델 로딩에는 약 10초가 걸립니다. 서비스가 준비되면 다음 주소를 여세요.
- 시각적 플레이그라운드:
http://127.0.0.1:8017/playground - 대화형 OpenAPI 문서:
http://127.0.0.1:8017/docs - Snake 데모:
http://127.0.0.1:8017/snake
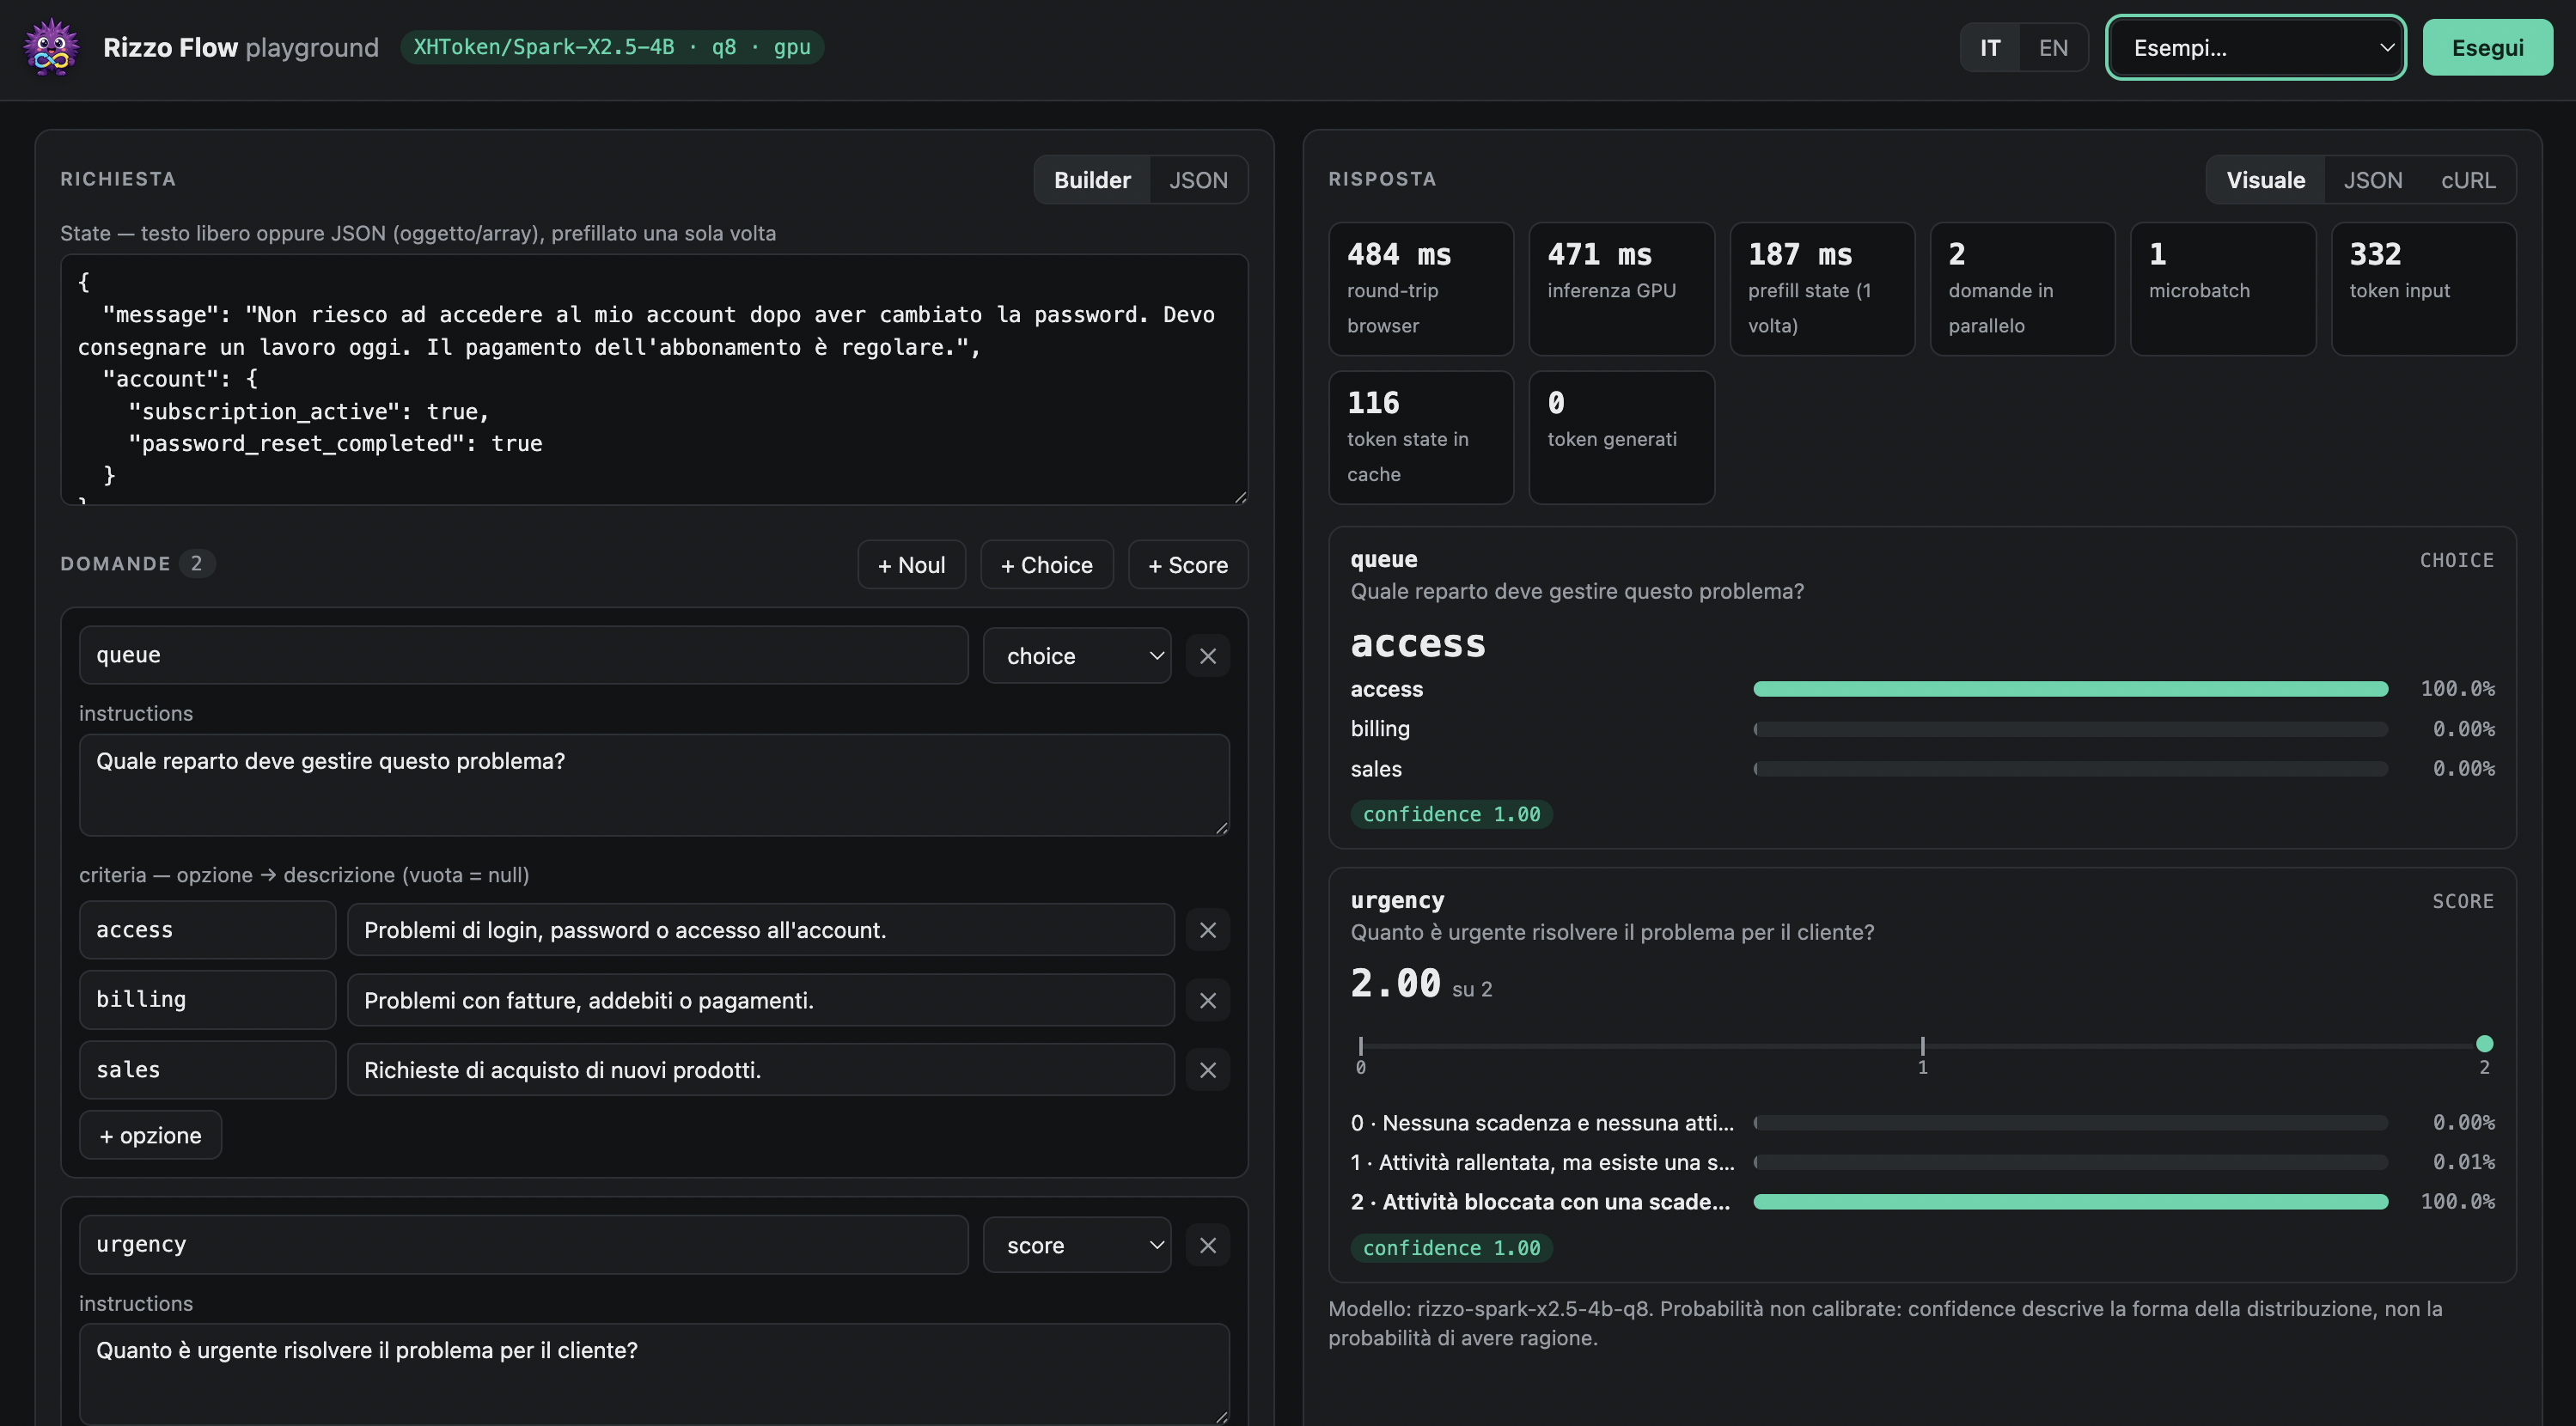
플레이그라운드에는 미리 준비된 예제, 질문 빌더, 두 API를 위한 원시 JSON 편집기, 확률 막대, 처리 시간 세부 정보, 동등한 cURL 명령이 포함되어 있습니다. 외부 요청을 보내지 않으며 영어와 이탈리아어 간에 전환할 수 있습니다.
더 작은 모델 사용
처음 다운로드를 더 빠르게 진행하려면 1.7B 모델을 설치하세요.
uv run rizzo download --size 1.7b
uv run rizzo serve --size 1.7b
1.7B Q8_0 파일은 약 1.8GB이며 약 2배 빠르게 실행되지만, README에서는 정확도가 훨씬 낮다고 경고합니다. 또한 abstention이 활성화되면 evidence 부족 옵션을 선택하는 경향이 있으므로, 자신의 워크로드에서 신중하게 테스트해야 합니다.
첫 번째 결정 내리기
가장 빠른 API 테스트는 Jev 호환 POST /v1/systemone 엔드포인트를 사용하는 것입니다. 다음 요청은 지원 메시지가 긴급성을 나타내는지 묻습니다.
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "Help! My payouts have been failing for 3 days.",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this convey urgency?"
      }
    }
  }'
noul 결과는 yes일 확률이며, 0에서 1 사이의 숫자로 표시됩니다. 요청에서 rizzo-latest 또는 편의상 제공되는 별칭을 사용하더라도 응답에는 실제 로컬 모델 식별자가 포함됩니다.
한 번의 요청으로 여러 질문하기
Rizzo Flow는 동일한 state에 대해 여러 질문을 평가하도록 설계되었습니다. 하나의 요청에 결합하면 질문들이 state의 KV 캐시를 공유할 수 있습니다.
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "Help! My payouts have been failing for 3 days.",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this convey urgency?"
      },
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments, invoicing, refunds",
          "technical": "Bugs and outages",
          "sales": null
        }
      },
      "frustration": {
        "type": "score",
        "instructions": "How frustrated is the customer?",
        "criteria": ["Calm", "Frustrated", "Very angry"]
      }
    }
  }'
응답에는 noul의 yes 확률, 모든 choice 옵션의 확률, 그리고 범례가 포함된 확률 가중 점수가 포함됩니다. usage.output_tokens 값은 항상 0입니다.
네이티브 decisions API 사용하기
네이티브 POST /v1/decisions 엔드포인트는 숫자형 질문과 abstention을 포함한 Rizzo Flow의 전체 기능을 제공합니다. 네 가지 질문 유형은 다음과 같습니다.
boolean: 타입이 지정된 값과 true일 확률을 반환합니다.choice: 선택된 옵션과 전체 옵션 분포를 반환합니다.score: 순서가 지정된 수준에 대해 확률 가중 점수와 정규화된 점수를 반환합니다.numeric: 추정값, 중앙값, 분산, 범위 미만 또는 초과 확률을 반환합니다.
앵커에서 숫자 값 추정하기
숫자형 질문은 증가하는 대표 앵커를 정의합니다. 다음 예시는 모델에 보고된 충전율을 읽도록 요청합니다.
curl http://127.0.0.1:8017/v1/decisions \
  -H 'Content-Type: application/json' \
  -d '{
    "state": {"measurement": 75, "unit": "percent"},
    "questions": {
      "fill": {
        "type": "numeric",
        "instructions": "Read the reported fill percentage.",
        "unit": "percent",
        "anchors": [
          {"value": 0, "description": "Empty"},
          {"value": 50, "description": "Half full"},
          {"value": 75, "description": "Three quarters full"},
          {"value": 100, "description": "Completely full"}
        ]
      }
    }
  }'
앵커는 통계적 구간이 아니라 대표값입니다. 보고되는 평균은 가장 낮은 앵커와 가장 높은 앵커 사이에 유지되며, 분위수는 이러한 앵커에 대한 이산 확률 분포를 설명합니다.
abstention 이해하기
네이티브 질문에서는 기본적으로 abstention이 허용됩니다. Rizzo Flow는 내부적으로 evidence 부족 옵션을 추가하며, 숫자형 질문에는 범위 미만과 범위 초과 가능성도 포함됩니다. 선택한 옵션과 정책에 따라 기본 값이 null이 되고 상태가 insufficient_evidence, out_of_range 또는 uncertain을 보고할 수 있습니다.
Jev 호환 형식은 abstention을 사용하지 않습니다. yes/no 결과는 정확히 두 옵션을 기준으로 계산됩니다. 네이티브 API를 통해 더 작은 1.7B 모델을 사용하는 경우, 프로젝트의 권장 사항에 따라 allow_abstain을 false로 설정하고 데이터에서 그 영향을 검증하는 것이 좋습니다.
서버 없이 결정 실행하기
스크립트, 테스트 또는 일회성 평가의 경우 요청 파일을 CLI에 직접 전달합니다.
uv run rizzo decide examples/ticket.json가상 환경을 활성화한 뒤 uv run 접두사 없이 사용할 수도 있습니다.
source .venv/bin/activate
rizzo decide examples/ticket.json
PowerShell에서는 다음 명령으로 활성화합니다.
.venv\Scripts\activate모델, 양자화 및 디바이스 선택하기
기본 구성은 Spark-X2.5-4B Q8_0을 사용합니다. 문서에 나오는 다른 양자화 방식은 Q4_K_M과 BF16입니다.
- 4B Q8_0: 약 4.4GB이며 기본 구성입니다.
- 4B Q4_K_M: 약 2.6GB입니다.
- 4B BF16: 약 8.2GB입니다.
- 1.7B Q8_0: 약 1.8GB입니다.
- 1.7B Q4_K_M: 약 1.1GB입니다.
- 1.7B BF16: 약 3.4GB입니다.
서버를 시작하기 전에 런타임에서 인식하는 디바이스를 확인합니다.
uv run rizzo devices그런 다음 디바이스 제품군을 명시적으로 선택할 수 있습니다.
uv run rizzo serve --device cuda
uv run rizzo serve --device vulkan
uv run rizzo serve --device metal
uv run rizzo serve --device cpu
지정된 디바이스 제품군은 힌트가 아니라 요구 사항이므로, Rizzo Flow는 명시적으로 지정된 GPU 제품군을 CPU로 자동 변경하지 않습니다. 추가 런타임 패키지는 별도로 다운로드할 수 있습니다:
uv run rizzo download --only runtime --runtime rocm
uv run rizzo download --only runtime --runtime sycl
uv run rizzo download --only runtime --runtime cpu
고급 구성 및 실용적인 팁
관련 질문을 일괄 처리하기
동일한 상태에 대한 질문은 하나의 요청에 모두 배치하세요. 이는 Rizzo Flow 설계의 핵심입니다. 상태는 한 번만 미리 채워지고 질문 접미사는 마이크로 배치로 평가됩니다. 기본 질문 마이크로 배치 크기는 4이며 --batch-size로 변경할 수 있습니다.
uv run rizzo serve --batch-size 8배치가 클수록 항상 더 좋은 것은 아닙니다. 대상 머신에서 지연 시간과 메모리 사용량을 비교하세요.
컨텍스트를 신중하게 늘리기
Spark-X2.5는 기본적으로 100만 토큰의 네이티브 컨텍스트를 지원하지만, 서버는 질문당 기본값을 8,192토큰으로 설정합니다. --ctx로 제한을 높일 수 있습니다:
uv run rizzo serve --ctx 32768KV 캐시는 시작 시 할당됩니다. 4B 모델의 경우 README는 토큰당 약 144KiB, 즉 기본 제한에서 약 1.4GiB, 32,000토큰에서 4.8GiB로 추정합니다. 구성된 제한을 초과하는 입력은 잘리지 않고 거부됩니다. 약 60,000토큰을 초과하면 schema.py에 있는 저장소의 256KB 상태 제한도 높여야 합니다.
호환 엔드포인트 보안 설정
서버를 시작하기 전에 RIZZO_API_KEY를 설정하면 Jev 호환 엔드포인트에 Bearer 인증이 필요하게 됩니다:
export RIZZO_API_KEY="replace-with-a-secret"
uv run rizzo serve
Windows PowerShell에서는 다음과 같이 설정합니다:
$env:RIZZO_API_KEY = "replace-with-a-secret"
uv run rizzo serve
인증에 실패하면 HTTP 401이 반환됩니다. 잘못된 요청 데이터에는 HTTP 422가 반환될 수 있습니다.
호환 클라이언트 리디렉션
호스팅된 TypeSafe API용으로 설계된 클라이언트는 기본 URL을 변경하여 로컬 서비스에 연결할 수 있습니다:
export TYPESAFE_BASE_URL=http://127.0.0.1:8017프로젝트 설명에 따르면 이 환경 변수 설정은 공식 SDK용으로 설계되었지만 아직 해당 SDK에서 테스트되지는 않았습니다. 인터페이스는 호환되지만 기반 로컬 모델은 Jev가 아닙니다.
신뢰도와 확률을 올바르게 다루기
호환 API의 신뢰도 값은 선택지 분포의 형태를 나타냅니다. 답변이 정확하다는 검증된 확률은 아닙니다. 마찬가지로 원시 모델 확률도 과도하게 확신하거나 다른 방식으로 보정되지 않을 수 있습니다.
대표성을 갖춘 라벨 데이터셋에서 결정을 검증하고, 필요한 경우 실제 배포 환경에 맞게 보정하세요. 서버는 --calibration을 통해 보정 파일을 허용합니다:
uv run rizzo serve --calibration fit.json보정 결과는 이를 생성한 모델 파일, 런타임, 양자화 및 하드웨어 백엔드에 종속됩니다. CUDA, Vulkan, Metal은 서로 다르게 반올림할 수 있으며, 양자화에 따라 반환되는 확률이 달라질 수 있습니다.
답변 슬롯 제한 준수
각 후보는 하나의 대문자에 매핑되므로 질문당 최대 26개의 답변 슬롯이 생성됩니다. 내부 기권 및 범위 선택지도 슬롯을 사용합니다. 따라서 기권이 없으면 하나의 선택형 질문에서 일반 선택지를 최대 26개까지 지원하고, 기권이 있으면 25개까지 지원합니다. 숫자형 질문은 범위 미만, 범위 초과 및 선택적 근거 부족 선택지도 슬롯을 차지하므로 사용할 수 있는 앵커가 더 적습니다.
사용자 지정 모델 파일 또는 llama.cpp 빌드 사용
--model을 사용하여 특정 GGUF 파일로 서버를 시작할 수 있습니다:
uv run rizzo serve --model /path/to/model.gguf사용자 지정 llama.cpp 설치를 사용하려면 RIZZO_LLAMA_DIR를 libllama가 포함된 디렉터리로 지정하세요. README에서는 바인딩이 해당 버전의 헤더에 연결되어 있으므로 llama.cpp 커밋 161755f를 요구합니다.
Snake 데모 살펴보기
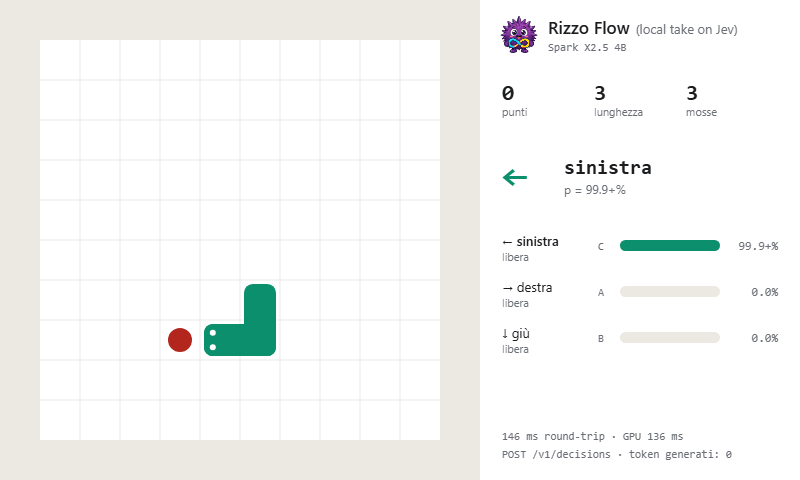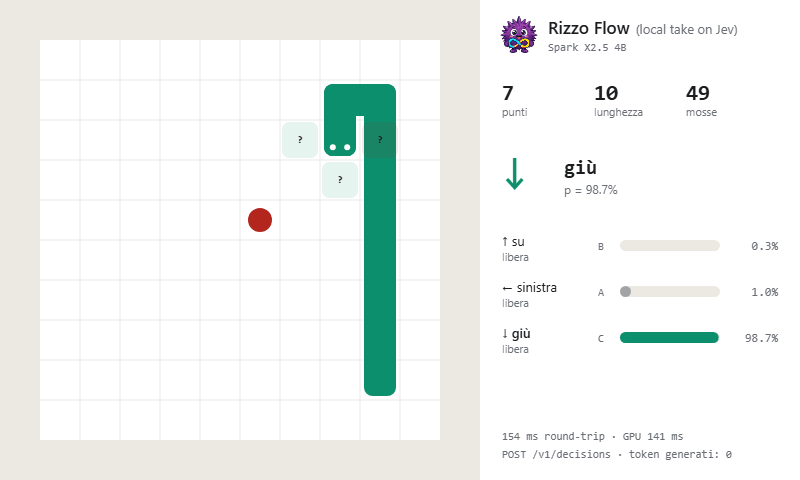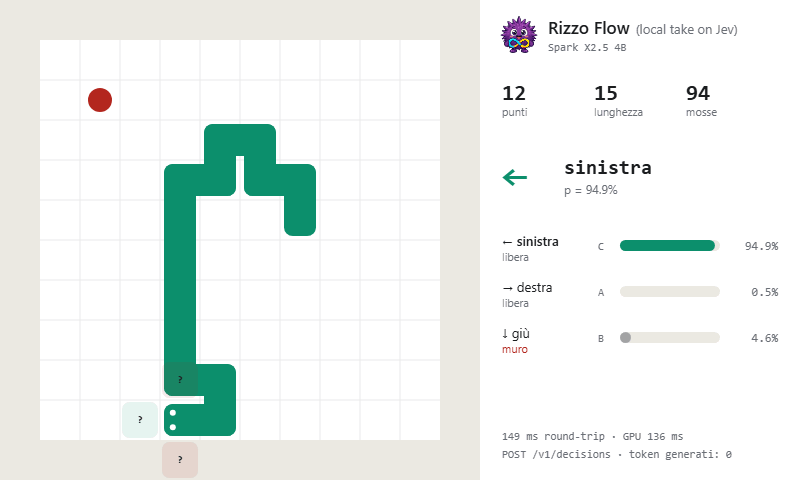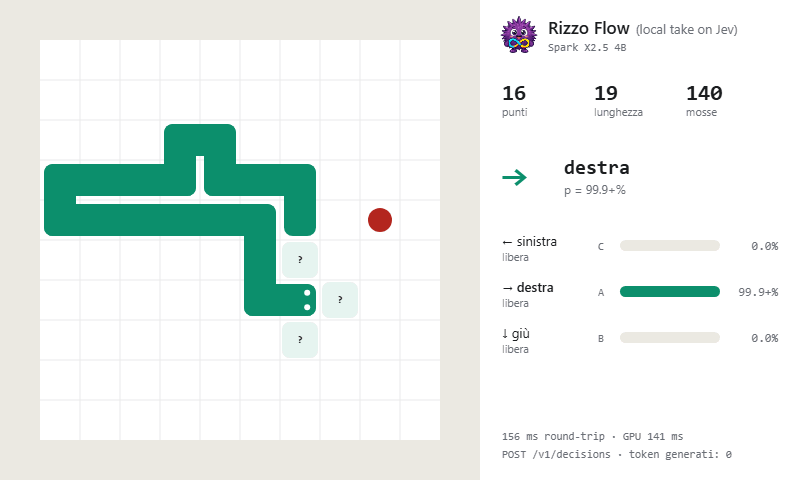
로컬 Snake 페이지는 유형화된 결정이 대화형 애플리케이션을 제어하는 방식을 보여줍니다. 매 이동마다 보드 설명과 가능한 이동을 나열한 선택형 질문을 포함하는 하나의 POST /v1/decisions 요청이 전송됩니다. 페이지에는 텍스트를 생성하지 않고 답변 확률, 로짓, 소요 시간 및 결정 로그가 표시됩니다.
이 데모는 중요한 모델링 교훈도 보여줍니다. 입력 표현이 중요하다는 점입니다. README에 따르면 4B 모델은 ASCII 그리드만 사용하는 경우보다 이동별로 계산된 센서를 사용할 때 훨씬 더 우수한 성능을 보입니다. 이러한 관찰은 소수의 비공식 게임에서 얻은 것이므로 벤치마크로 간주해서는 안 됩니다.
운영 점검
GET /health를 사용하여 모델 출처와 파일 해시를 확인하세요. 요청 및 응답 스키마는 request.schema.json과 response.schema.json에서도 확인할 수 있습니다. 재현 가능한 배포를 위해 모델, 양자화, 런타임, 백엔드, 컨텍스트 구성 및 보정 설정을 고정하세요.
README는 RTX 5060 Ti에서 Spark-X2.5-4B Q8_0으로 짧은 결정을 수행할 때 약 50밀리초가 걸린다고 보고하지만, 이는 하드웨어와 작업량에 따라 달라집니다. 같은 문서에서는 Apple Silicon, AMD, Intel, Linux NVIDIA 및 CPU 구성이 모두 동등한 수준으로 테스트되지는 않았다고 설명하므로, 지연 시간 기대치를 설정하기 전에 자체 머신에서 벤치마크를 수행하세요.
결론
Rizzo Flow는 텍스트를 생성하지 않고 구조화되지 않은 상태를 타입이 지정된 확률적 의사결정으로 변환할 수 있는 실용적인 로컬 인터페이스를 제공합니다. 플레이그라운드에서 시작해 관련 질문을 하나의 요청으로 결합하고, 수치 추정이나 거부(abstention)가 필요할 때는 네이티브 API를 사용하세요. 프로덕션에서 사용하기 전에 실제 애플리케이션을 반영하는 데이터로 정확도, 지연 시간, 보정, 양자화 및 백엔드 동작을 테스트하세요.