

DeepSelect란 무엇인가요?
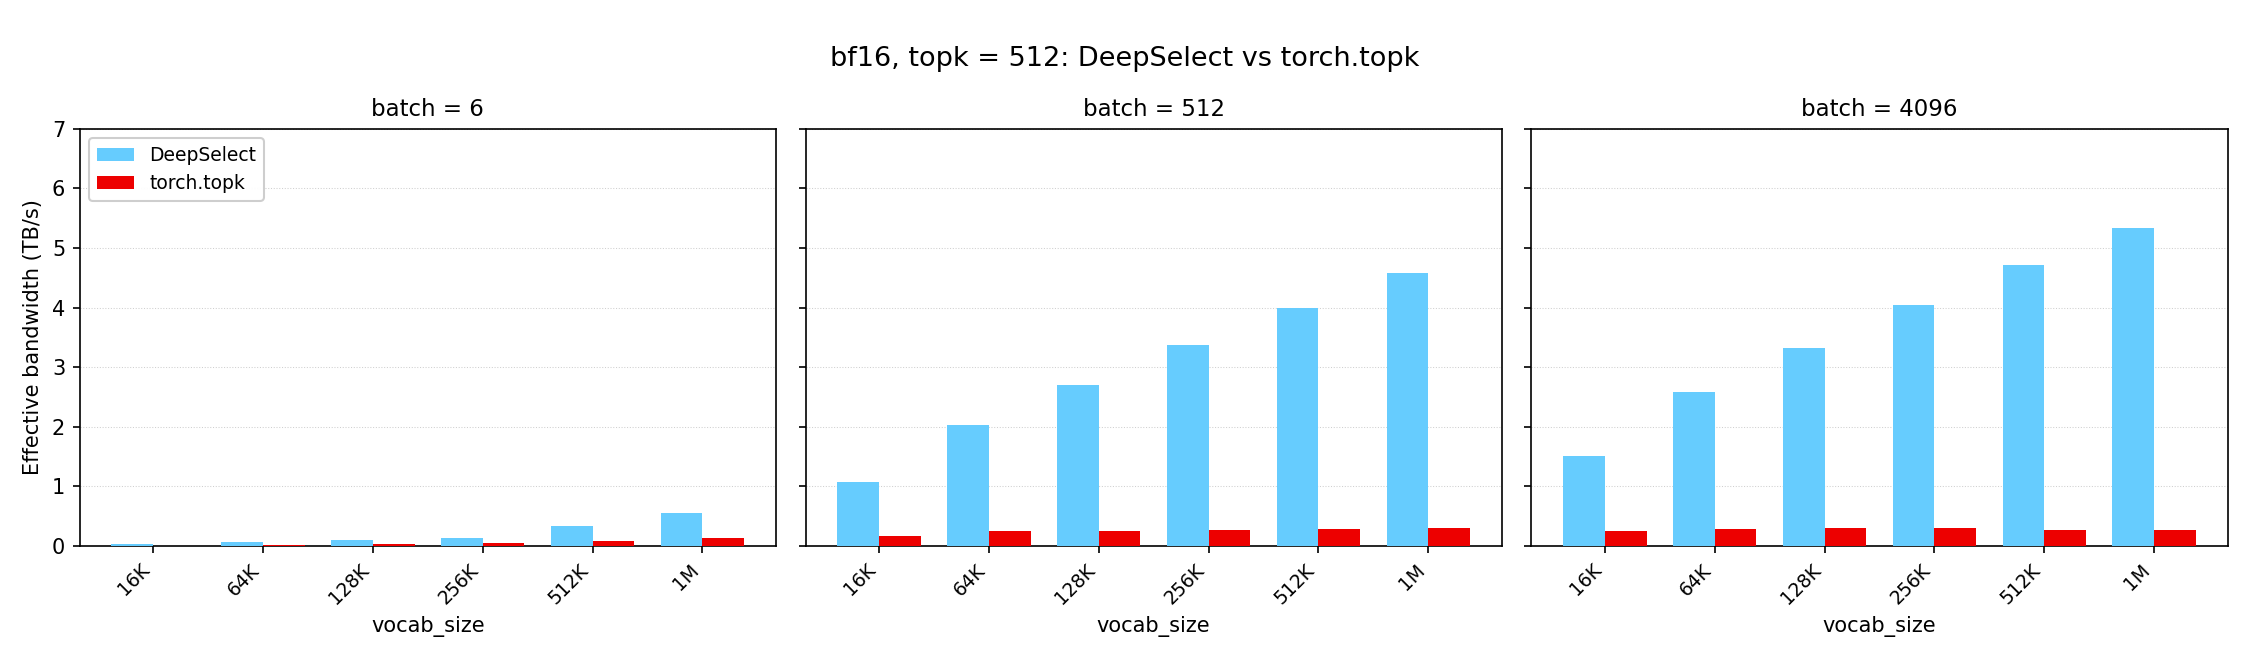
DeepSelect는 DeepSeek Sparse Attention 및 샘플링에 사용되는 TopK 커널의 고성능 구현입니다. 프로젝트 README에 따르면 라이브러리가 지원하는 워크로드에서 기본 torch.topk보다 2~20배 빠른 성능을 제공할 수 있습니다.
가능한 모든 TopK 구성을 최적화하는 대신, DeepSelect는 두 가지 시나리오에 집중합니다. 하나는 torch.bfloat16 입력을 사용하는 Lightning Indexer 워크로드이고, 다른 하나는 torch.float32 입력을 사용하는 샘플링 워크로드입니다.
지원되는 워크로드
Lightning Indexer 시나리오
- 입력 유형:
torch.bfloat16 - 배치 크기: 1 이상, 작은 배치와 큰 배치 모두 최적화
- 어휘 크기: 1 이상, 작은 어휘와 큰 어휘 모두 최적화
- TopK 크기: 작고
4096이하
성능을 높이려면 결과를 정렬해야 하는 경우가 아니라면 sorted_index를 비활성화하세요. 값이 필요하지 않다면 return_value=False로 설정하여 값 출력을 건너뛸 수 있습니다.
샘플링 시나리오
- 입력 유형:
torch.float32 - 배치 크기: 1 이상
- 어휘 크기: 약 128K
- TopK 크기: 작고
4096이하
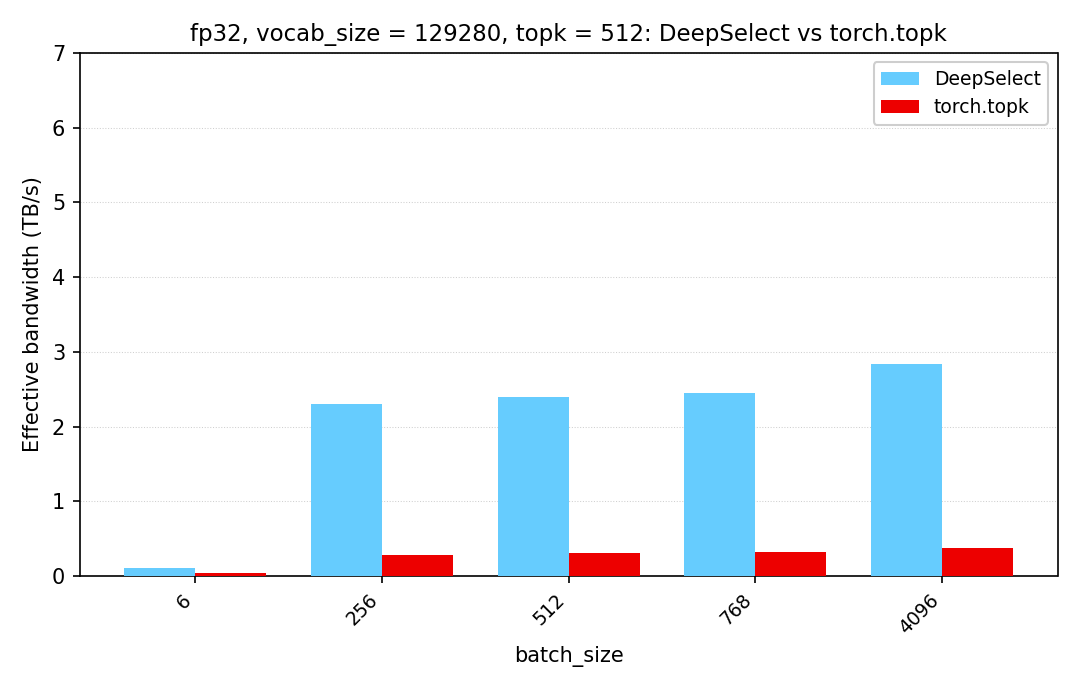
TopK는 부동소수점 연산을 수행하지 않으므로 저장소에서는 부동소수점 처리량이 아닌 유효 메모리 대역폭을 사용해 성능을 측정합니다. 벤치마크는 동일한 입력에서 torch.topk를 기준으로 한 상대 성능을 보고합니다.
주요 기능
- DeepSeek Sparse Attention 및 샘플링 워크로드에 특화된 TopK 커널
- 각 대상 시나리오에서
torch.bfloat16및torch.float32입력 지원 torch.int32또는torch.int64인덱스 출력 설정- 인덱스만 필요할 때 오버헤드를 줄이는 선택적 값 출력
- 행별 배타적 상한을 통한 가변 길이 행
- 사용자가 소유한 인덱스 출력 버퍼
- 내장 NaN 검사
설치
저장소를 복제하고 서브모듈을 초기화한 다음 프로젝트 디렉터리에서 패키지를 설치합니다.
git clone https://github.com/deepseek-ai/DeepSelect.git
cd DeepSelect
git submodule update --init --recursive
pip install -v .
예제에서는 CUDA 텐서를 사용하므로 device="cuda"에서 입력을 생성하세요.
기본 TopK 사용법
PyTorch와 DeepSelect를 가져오고 2차원 입력 텐서를 생성한 다음 deep_select.topk를 호출합니다.
import torch
import deep_select

batch_size = 4
vocab_size = 204800
topk = 1024

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.bfloat16,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=True,
    indices_type=torch.int32,
    return_value=True,
)

print(values.shape)   # (4, 1024)
print(indices.shape)  # (4, 1024)
입력의 형태는 (batch_size, vocab_size)여야 합니다. 마지막 차원은 연속적이어야 하며, 행 스트라이드는 deep_select.get_stride_requirement()[0]바이트의 배수여야 합니다.
반환되는 값은 x와 동일한 데이터 유형을 사용합니다. 인덱스는 indices_type으로 선택한 유형을 사용하며, torch.int32 또는 torch.int64로 설정할 수 있습니다. sorted_index=True이면 각 행에서 반환되는 인덱스가 오름차순으로 정렬됩니다.
인덱스만 반환하기
후속 코드에서 선택된 값이 필요하지 않다면 값 출력을 비활성화하세요.
values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=False,
    indices_type=torch.int32,
    return_value=False,
)
README에 따르면 값 출력을 건너뛰면 약 10% 더 빠릅니다. 정렬된 출력이 필요하지 않다면 정렬을 요청하지 마세요. 정렬에는 오버헤드가 추가되기 때문입니다.
스트라이드 정렬 처리
DeepSelect는 입력 행과 출력 행에 정렬 요구 사항을 적용합니다. 런타임에 다음과 같이 확인할 수 있습니다.
input_alignment, output_alignment = deep_select.get_stride_requirement()

print("Input row-stride alignment:", input_alignment, "bytes")
print("Output row-stride alignment:", output_alignment, "bytes")
입력의 행 스트라이드가 필요한 입력 정렬의 배수가 아니라면 DeepSelect에 전달하기 전에 텐서에 패딩을 추가하세요. 마지막 차원은 연속적인 상태로 유지해야 합니다.
DeepSelect는 기본적으로 두 출력 모두 할당합니다. 출력의 스트라이드는 deep_select.get_stride_requirement()[1]바이트에 맞춰 정렬되므로 반환된 텐서는 비연속적일 수 있습니다. 출력을 사용하는 코드는 표준 연속 스트라이드를 가정해서는 안 됩니다.
기존 인덱스 버퍼 사용
호출자가 관리하는 버퍼에 인덱스를 기록하려는 경우 API에서 output_idx=를 사용할 수 있습니다. 이 버퍼는 동일한 출력 스트라이드 요구 사항을 충족해야 합니다. 사용자 지정 버퍼를 구성하기 전에 전체 함수 시그니처는 deep_select/interface.py를 참조하세요.
가변 길이 행 사용
end를 사용하여 각 행에 배타적 상한을 지정할 수 있습니다. 같은 배치의 행마다 유효한 길이가 다를 때 유용합니다.
import torch
import deep_select

batch_size = 2
vocab_size = 129280

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.float32,
    device="cuda",
)

end = torch.tensor(
    [129280, 100000],
    dtype=torch.int32,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    1000,
    end=end,
    sorted=True,
    indices_type=torch.int64,
)
여기서 첫 번째 행은 129280개의 요소를 모두 사용할 수 있지만, 두 번째 행은 처음 100000개의 요소로 제한됩니다. 행의 길이가 요청된 TopK 크기보다 짧으면 DeepSelect는 출력에 value_oob_fill_value와 idx_oob_fill_value를 채웁니다.
NaN 처리
NaN 검사는 항상 활성화됩니다. 기본적으로 abort_when_nan_found=True이므로 커널은 NaN을 감지하면 trap()을 호출하고 중단합니다. 유효 길이가 요청된 TopK 크기보다 작거나 같은 행은 NaN 검사를 수행하지 않습니다.
특히 기본 중단 동작을 유지하는 경우 NaN이 발생할 수 있다면 커널을 실행하기 전에 입력 데이터를 검증하거나 정제하세요.
성능 및 고급 팁
- 지원되는 TopK 범위를 지키세요. DeepSelect는 최대
4096을 포함한 작은 TopK 값을 지원합니다. 더 큰 값은 지원되지 않습니다. - 의도한 워크로드에 맞추세요. 프로젝트에서 설명하는 Lightning Indexer 시나리오에는
torch.bfloat16을 사용하고, 샘플링 시나리오에는torch.float32를 사용하세요. - 가능하면 정렬을 생략하세요. 인덱스나 값으로 정렬하면 성능 비용이 발생하므로, 후속 처리에 필요한 경우에만 요청하세요.
- 가능하면 값을 생략하세요. 인덱스만 사용하는 경우
return_value=False로 설정하세요. - 정렬 요구 사항을 일찍 확인하세요. 성능이 중요한 루프에서 호환되지 않는 텐서를 수정하는 대신
get_stride_requirement()를 기준으로 텐서 형태와 패딩을 계획하세요. - 출력이 연속적이라고 가정하지 마세요. DeepSelect는 출력 행 스트라이드를 정렬하므로 결과 텐서가 비연속적일 수 있습니다.
- 실제 형태로 벤치마크하세요. TopK 성능은 입력 형식, 배치 크기, 어휘 크기 및 TopK 크기에 따라 달라집니다. 애플리케이션에서 사용하는 정확한 구성을 테스트하세요.
제공된 벤치마크 실행
저장소의 테스트 스크립트에는 성능 모드가 포함되어 있습니다.
python3 tests/test.py --perf-only이 벤치마크는 동일한 입력에서 DeepSelect와 torch.topk를 비교하고 유효 메모리 대역폭을 사용해 비율을 보고합니다.
결론
DeepSelect는 호환되는 DeepSeek Sparse Attention 및 샘플링 워크로드를 위한 특수 TopK 커널을 제공합니다. 정렬된 2차원 CUDA 텐서로 시작하고, topk를 4096 이하로 유지하며, 불필요한 경우 정렬이나 값 출력을 비활성화하세요. 프로덕션 통합 시 스트라이드 요구 사항을 확인하고, 출력이 비연속적일 수 있음을 고려하며, 애플리케이션에서 사용하는 정확한 텐서 형태로 벤치마크하세요.