

Tiny Classifiers의 기능
tiny-classifiers는 작고 특정 작업에 맞춘 텍스트 분류기를 학습시키기 위한 실용적인 레시피입니다. 1,700만 개의 파라미터를 가진 Ettin-17M 인코더를 사용하고 모든 가중치를 파인튜닝한 뒤, 결과를 표준 Hugging Face 모델로 저장합니다.
이 프로젝트는 은행 메시지 라우팅, 뉴스 분류, 사용자 의도 인식, 감정 분석, 법률 문서의 사전 정의된 범주 할당과 같은 분류 작업을 위해 설계되었습니다. 레이블이 지정된 예제가 충분하지 않은 경우, 더 큰 언어 모델을 교사로 사용해 학습 세트에 레이블을 지정할 수 있습니다.
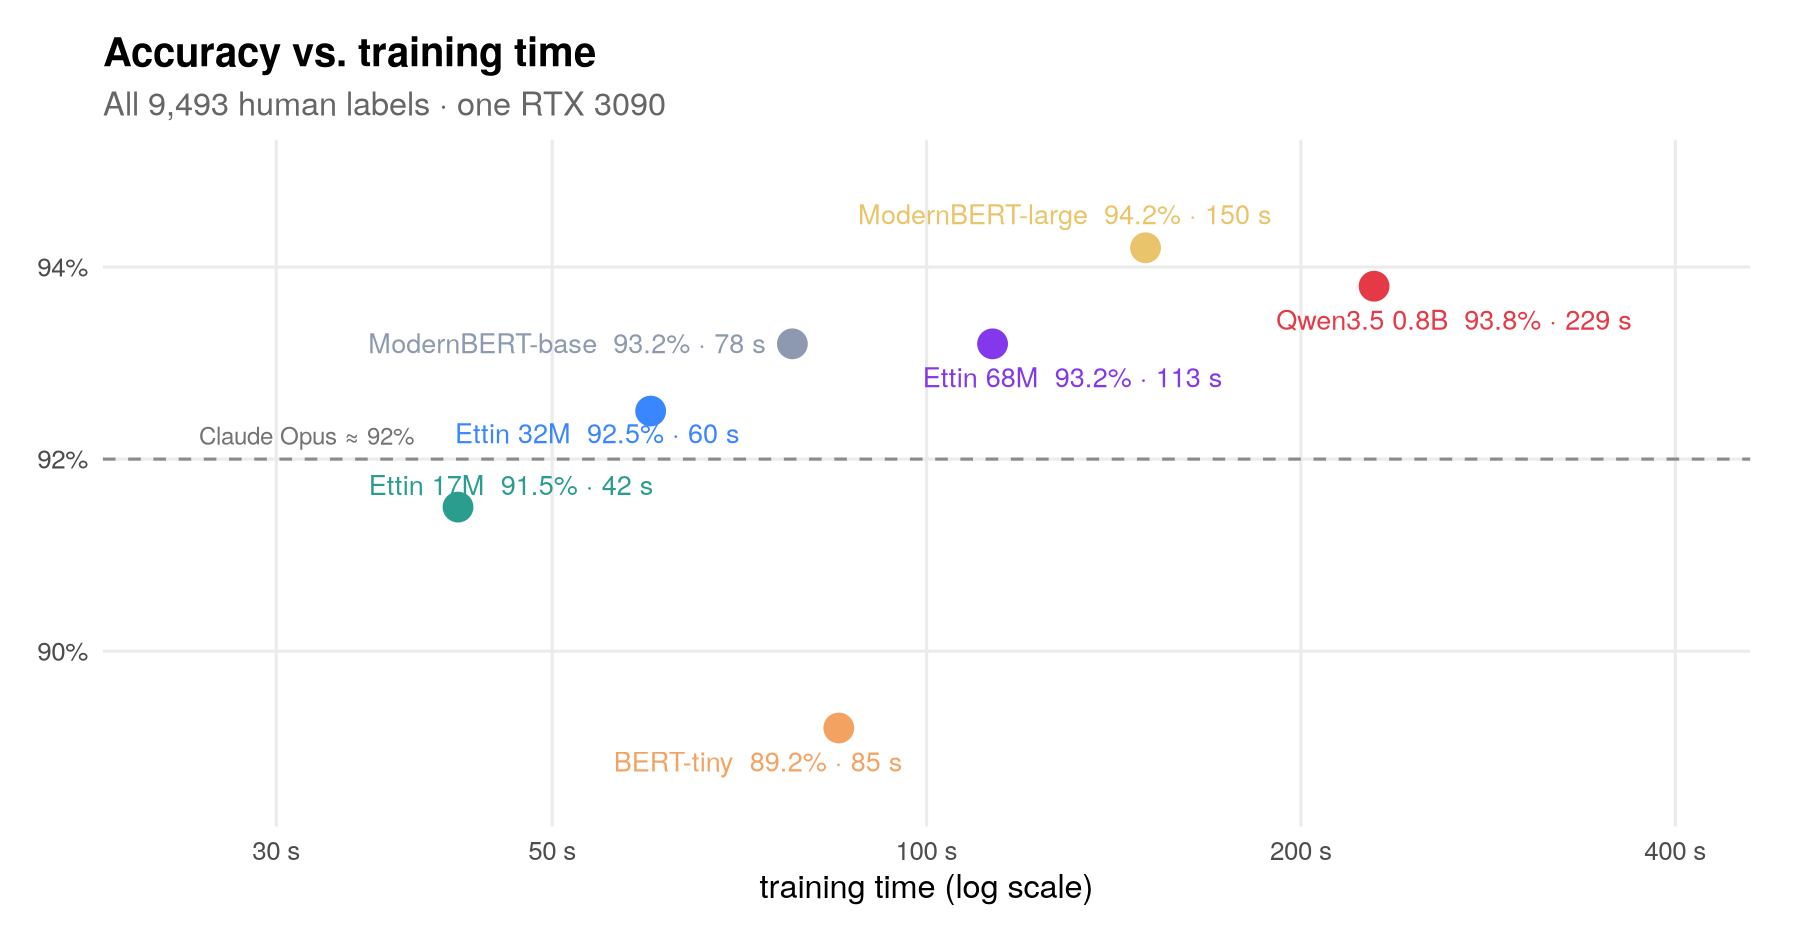
저장소의 Banking77 실험에서 Ettin-17M은 91.5%의 정확도를 달성했으며, Claude Opus의 정확도는 92%였습니다. 학습에는 게이밍 GPU 한 대에서 42초가 걸렸고, 추론에는 메시지당 약 5밀리초가 걸렸습니다. 학습은 노트북 CPU에서도 약 11분, 휴대폰 GPU에서도 약 21분 만에 완료되었습니다.
Banking77의 정확도와 학습 시간 비교.
주요 기능
- 소형 로컬 모델: Ettin-17M은 1,700만 개의 파라미터를 가지며 각 범주에 대해 하나의 점수를 생성합니다.
- 사람 또는 교사 레이블: 검증된 레이블로 학습하거나 Kimi K3에 레이블이 없는 메시지의 레이블 지정을 요청할 수 있습니다.
- GPU 및 CPU 학습: 학습 스크립트는 두 환경을 모두 지원합니다.
- 표준 모델 출력: 학습된 분류기는 Hugging Face
transformers파이프라인을 통해 불러올 수 있습니다. - 중단 후 재개 가능한 레이블 지정: 레이블 지정 스크립트는 재시도, 적응형 동시성, 느린 요청에 대한 헤징, 프로바이더별 예산을 지원합니다.
- 내장 평가: 학습 결과는 테스트 정확도를 보고하며, 교사 레이블 지정에서는 레이블이 지정된 테스트 세트에서 교사의 정확도를 측정할 수 있습니다.
- 비용 분석: 손익분기점 스크립트는 API를 통한 분류 비용을 지불하는 것보다 레이블 지정과 학습이 저렴해지는 시점을 추정합니다.
- 재사용 가능한 데이터 준비: 하나의 일관된 구조를 사용해 10개의 공개 분류 데이터 세트를 준비할 수 있습니다.
학습 레시피의 작동 방식
Ettin-17M은 Johns Hopkins에서 개발한 오픈 인코더이며 BERT 스타일 모델과 관련이 있습니다. 토큰 단위로 텍스트를 생성하는 생성 모델과 달리, 전체 입력을 읽고 사용 가능한 각 범주에 점수를 할당합니다.
이 저장소는 각 범주에 하나씩 출력을 추가하고 모든 모델 가중치를 파인튜닝합니다. 기본 레시피는 배치 크기 32, 학습률 1e-4의 AdamW, 가중치 감쇠 0.01, 5% 워밍업 후 코사인 감쇠, 1.0의 그래디언트 클리핑, 크로스 엔트로피 손실을 사용합니다.
약 9,500개의 메시지에 대해서는 6회 반복 학습합니다. 예제가 2,000개뿐인 경우에도 동일한 최적화 단계 수를 사용하며, 이는 약 28회 반복 학습에 해당합니다. README에서는 이러한 설정을 작업별로 따로 조정하지 않았다고 강조합니다.
설치 및 설정
1. uv 설치
스크립트는 uv를 사용해 필요한 환경을 만들고 첫 실행 시 의존성을 자동으로 설치합니다. 운영 체제에 맞는 안내에 따라 uv를 설치한 다음, 저장소의 루트 디렉터리에서 터미널을 엽니다.
2. 공개 데이터 세트 준비
준비 스크립트를 실행합니다.
uv run recipe/prepare.py이 스크립트는 Hugging Face Hub에서 Banking77, CLINC150, 영어 및 프랑스어 MASSIVE, TREC, AG News, SST-5, Financial PhraseBank, LEDGAR, 트윗 혐오 발언 데이터 세트를 다운로드합니다.
각 작업에 대해 스크립트는 data/tasks/ 아래에 디렉터리를 만듭니다. 작업 정의, 2,000개의 학습 메시지, 범주당 최대 150개의 예제가 포함된 더 큰 학습 분할, 테스트 세트를 생성합니다.
3. 레이블 지정 프로바이더 구성
교사 모델로 레이블을 생성하려면 하나 이상의 지원되는 프로바이더에 대한 API 키를 설정합니다.
export OPENROUTER_API_KEY=...이 레시피는 Fireworks, Together, DeepInfra, Parasail과 연결된 프로바이더 키도 인식합니다. 데이터를 전송하거나 생성된 답변을 학습에 사용하기 전에 해당 프로바이더의 최신 가격, 사용 정책, 모델 약관을 확인하세요.
기본 튜토리얼: AG News 분류기 학습
1단계: Kimi K3로 레이블 생성
데이터 세트를 준비한 후 AG News 학습 메시지 2,000개에 레이블을 지정합니다.
uv run recipe/label.py data/tasks/agnews보고된 실행에서는 Kimi K3가 약 20초 만에 2,000개의 예제에 레이블을 지정했으며 비용은 약 $1였습니다. 실제 시간과 비용은 프로바이더에 따라 달라질 수 있습니다. 이 스크립트는 중단 후 재개할 수 있으므로, 중단된 레이블 지정 작업을 처음부터 다시 시작할 필요가 없습니다.
2단계: 교사 레이블로 Ettin-17M 파인튜닝
생성된 레이블 파일을 학습 스크립트에 전달하고 출력 디렉터리를 지정합니다.
uv run recipe/train.py data/tasks/agnews --labels labels/agnews-train.jsonl --save models/agnews이 스크립트는 분류기를 파인튜닝하고 테스트 세트에서 평가하며, 테스트 정확도를 출력하고, Hugging Face와 호환되는 모델을 models/agnews 아래에 저장합니다.
3단계: 사람 레이블 기준선 학습
교사 레이블 인자 없이 동일한 학습 스크립트를 실행해 데이터 세트의 원래 사람 레이블로 학습합니다.
uv run recipe/train.py data/tasks/agnews이 비교를 통해 지식 증류 과정에서 성능이 얼마나 손실되었는지 확인할 수 있습니다. 저장소의 튜토리얼 실행에서는 사람 레이블이 89.2%의 정확도를, Kimi K3 레이블이 85.1%를, Qwen3.8-27B 레이블이 81.8%를 기록했습니다.
4단계: 새 텍스트 분류
Hugging Face 파이프라인을 사용해 저장한 모델을 불러옵니다.
from transformers import pipeline

classify = pipeline(
    "text-classification",
    model="models/agnews",
    device="cpu"
)

result = classify(
    "NASA's new telescope finds water vapour on a distant planet"
)
print(result)
결과는 예측된 레이블과 해당 점수가 담긴 목록입니다. 이 예시에서 예상되는 범주는 Sci/Tech입니다. 보고된 AG News 모델은 CPU에서 메시지 하나를 약 6밀리초 만에 처리했습니다.
자체 데이터로 Tiny Classifier 사용하기
1. 작업 디렉터리 만들기
data/tasks/agnews/와 동일한 구조로 폴더를 만듭니다. 각 사용자 지정 작업에는 task.json, train.jsonl, test.jsonl 파일이 필요합니다.
2. 범주 정의하기
task.json 파일에는 이름, 하나의 지시문 문장, 전체 레이블 목록이 포함되어야 합니다.
{"name":"support-routing","instruction":"Assign each support message to the correct team.","labels":["billing","technical","account"]}서로 구별되고 의미가 분명한 레이블 이름을 사용합니다. 지시문에는 모델 또는 교사가 내려야 할 분류 결정을 명확히 설명해야 합니다.
3. 학습 및 테스트 레코드 추가하기
한 줄에 하나의 JSON 객체를 저장합니다. 레이블이 지정된 레코드의 구조는 다음과 같습니다.
{"id":"msg-001","text":"I was charged twice for my subscription.","label":"billing"}교사 모델이 학습 데이터에 레이블을 지정하는 경우 train.jsonl의 레코드에서 label 필드를 생략할 수 있습니다.
{"id":"msg-002","text":"The application closes whenever I upload a file."}교사와 학생의 정확도를 모두 측정할 수 있도록 테스트 레코드에는 검증된 레이블이 있어야 합니다. 이 프로젝트는 모델을 프로덕션에서 신뢰하기 전에 수백 개의 테스트 메시지를 직접 확인할 것을 권장합니다.
4. 레이블 지정, 학습 및 평가
표준 명령어에서 디렉터리를 지정합니다.
uv run recipe/label.py data/tasks/support-routing
uv run recipe/train.py data/tasks/support-routing \
  --labels labels/support-routing-train.jsonl \
--save models/support-routing--labels를 생략하면 사람이 지정한 레이블로 직접 학습할 수도 있습니다. Ettin-17M 대신 다른 인코더를 사용하려면 학습 스크립트의 --model 옵션으로 모델을 전달합니다.
파인튜닝의 비용 대비 효과 측정하기
작업을 준비한 후 손익분기점 분석을 실행합니다.
uv run recipe/breakeven.py이 스크립트는 비용과 시간을 모두 고려해 레이블 지정 및 학습에 드는 초기 비용을 회수하려면 몇 개의 메시지를 분류해야 하는지 추정합니다. Jev 제로샷 분류 API와 비교했을 때, 이 저장소가 확인한 손익분기점은 작업에 따라 약 50,000~500,000개 메시지였습니다.
사용량이 적거나 불확실하다면 API가 더 간단한 선택일 수 있습니다. 작업이 안정적이고 평가 데이터가 있으며 분류량이 많을 때 파인튜닝의 매력이 커집니다.
고급 팁
레이블 품질을 우선하기
실험 결과 모델 크기보다 레이블이 더 중요한 것으로 나타났습니다. 레이블이 지정된 예시를 추가할수록 학습 곡선은 계속 개선되었습니다. 교사가 학습시킨 학생 모델은 일반적으로 교사보다 정확도가 몇 퍼센트 포인트 낮았지만, 사람이 지정한 레이블을 사용하면 그 한계를 넘어설 수 있었습니다.
모호한 범주를 검토하고, 체계적인 레이블 오류를 수정하며, 아키텍처를 변경하거나 많은 하이퍼파라미터를 조정하기 전에 대표성 있는 예시를 추가하세요.
교사를 별도로 평가하기
작업 수행 능력이 낮은 교사를 학생이 안정적으로 보완할 수는 없습니다. 10개 작업의 결과에 따르면 교사 자체가 약한 작업에서는 교사가 지정한 레이블로 학습한 모델의 성능도 하락했습니다. 사람이 확인한 테스트 세트를 유지하고, 훨씬 더 큰 컬렉션에 레이블을 지정하는 비용을 지불하기 전에 교사의 정확도를 측정하세요.
실험 변동성 고려하기
README에는 무작위 시드로 인한 약 ±0.5퍼센트 포인트의 변동과 테스트 세트 크기로 인한 ±1.5~2포인트의 변동이 보고되어 있습니다. 공개된 표에는 세 번의 실행 결과 평균이 사용되었습니다. 작은 정확도 차이가 배포 결정에 영향을 미칠 때는 반복 실행과 충분히 큰 테스트 세트를 사용하세요.
라이선스 및 제공업체 약관 준수하기
교사 모델의 라이선스와 제공업체 약관이 허용하는 경우에만 생성된 답변으로 학습하세요. 이 저장소는 Kimi K3를 사용했지만, 일부 모델과 API는 출력을 다른 모델 학습에 사용하는 것을 금지합니다. 공개 데이터 세트에도 고유한 라이선스가 있으므로, 이 저장소는 이를 재배포하지 않고 다운로드합니다.
대체 하드웨어 살펴보기
기본 학습 스크립트는 CPU 및 GPU 실행을 지원합니다. 또한 이 저장소에는 WebGPU와 jax-js를 사용해 Chrome에서 학습하는 별도의 휴대전화 구현도 포함되어 있습니다. 휴대전화 워크플로는 전용 구현으로 취급하고 프로젝트의 phone/ 디렉터리에 있는 지침을 따르세요.
문서화된 NixOS 문제 우회하기
/sbin/ldconfig를 찾을 수 없어 NixOS에서 학습이 실패하면, 학습을 실행하기 전에 CUDA 라이브러리 경로를 설정합니다.
export TRITON_LIBCUDA_PATH=/run/opengl-driver/lib결론
tiny-classifiers는 레이블이 지정된 텍스트를 빠른 로컬 분류기로 변환하는 간결한 워크플로를 제공합니다. 작업을 준비하고, 사람 또는 교사 레이블을 확보하고, Ettin-17M을 파인튜닝하고, 검증된 예시로 평가한 다음, 로컬 추론이 경제성 측면에서 API보다 나은지 추정합니다.
가장 중요한 교훈은 신뢰할 수 있는 레이블과 평가 데이터에 투자하는 것입니다. 이를 확보하면 1,700만 개 파라미터의 인코더로도 높은 분류 정확도, 밀리초 수준의 추론 속도, 예측 가능한 로컬 운영 비용을 얻을 수 있으며, 모든 메시지마다 대규모 모델을 호출할 필요가 없습니다.