

순환 루프 트랜스포머란 무엇인가?
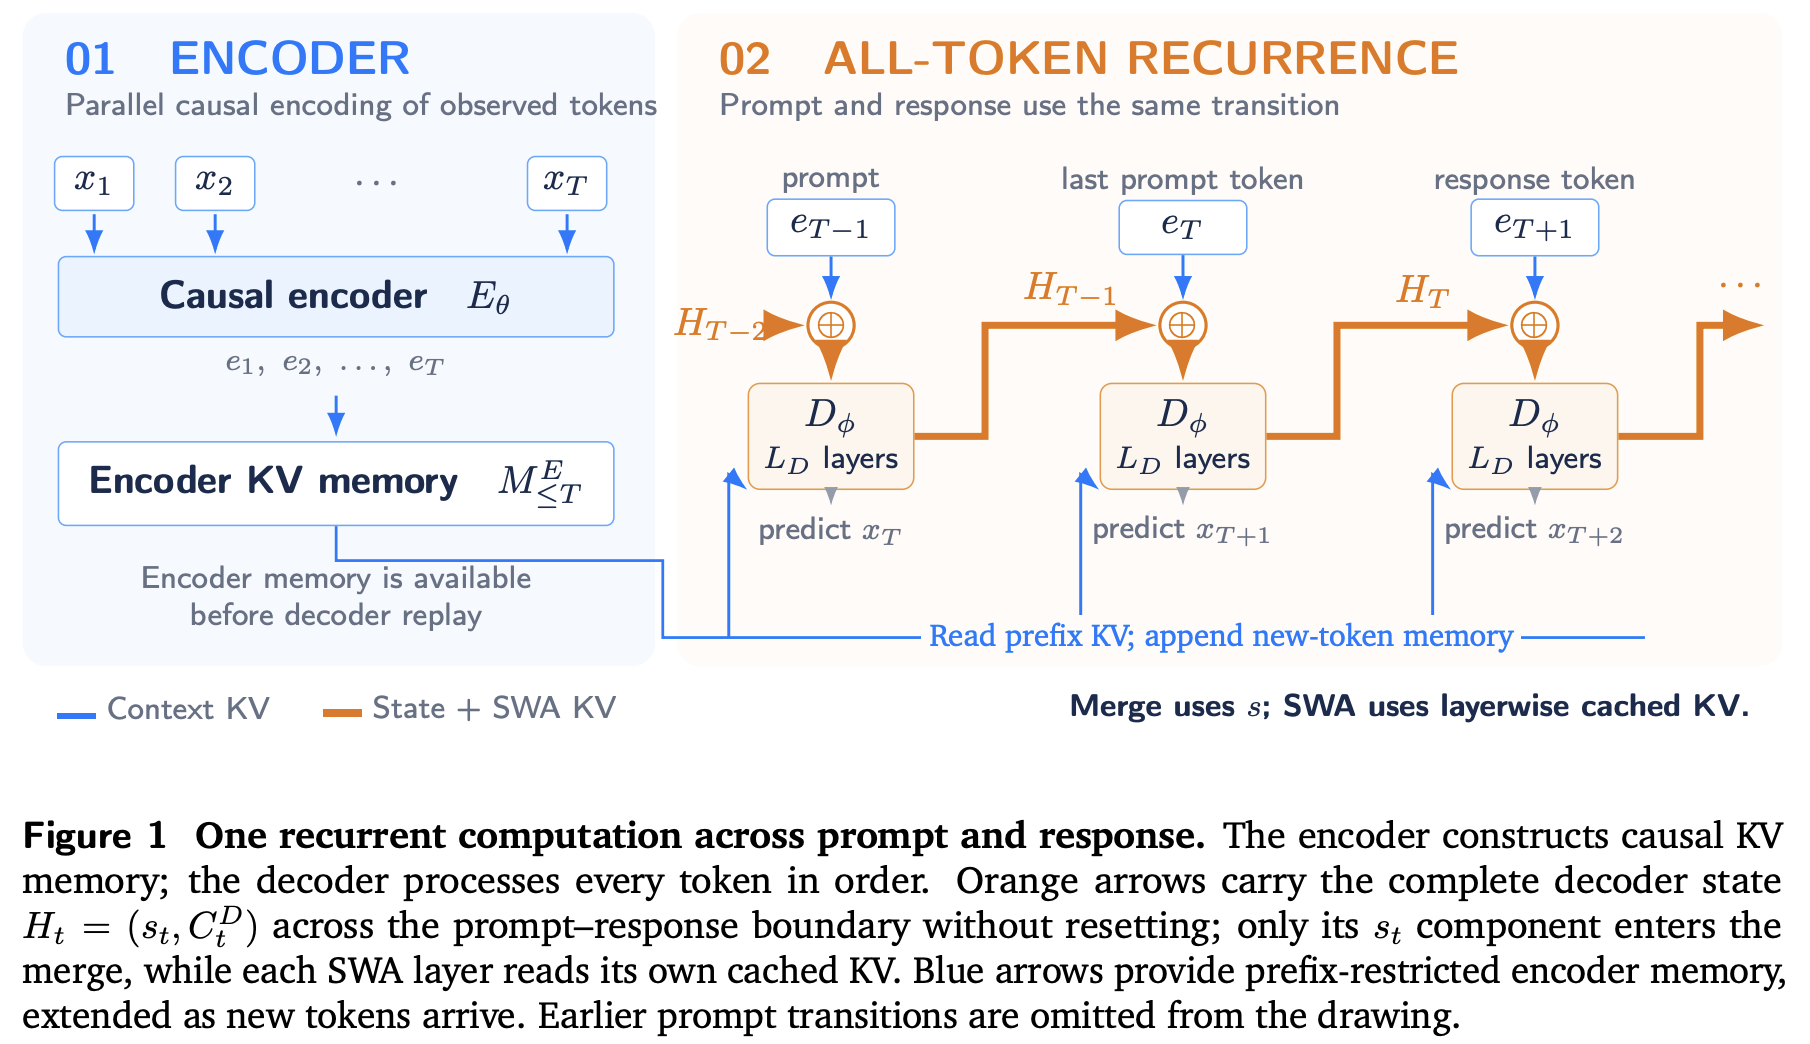
순환 루프 트랜스포머(Recurrent Looped Transformer, RLT)는 시퀀스의 모든 토큰에 걸쳐 잠재 계산을 전달하도록 설계된 연구 아키텍처입니다. 인과적 인코더는 전역 키-값 메모리를 구성하고, 순환 디코더는 이 메모리를 슬라이딩 윈도우 어텐션 및 이전 최종 은닉 상태의 피드백과 결합합니다.
이를 통해 확장 가능한 시간적 계산 경로가 만들어집니다. 디코더에 L_D개의 레이어가 있는 경우, t개의 토큰을 처리하면 토큰마다 고정된 수의 블록만 실행하더라도 tL_D개의 디코더 블록을 통과하는 순환 경로가 생성됩니다.
이 프로젝트에서 “무한 시간 깊이”란 시퀀스 길이에 따라 계산 경로가 늘어날 수 있다는 의미입니다. 단일 토큰 안에서 모델이 무한한 계산을 수행한다는 뜻은 아닙니다.
핵심 설계 원칙
1. 시간에 걸친 잠재 추론
한 토큰의 최종 디코더 출력은 다음 토큰의 입력이 됩니다. 따라서 모델은 프롬프트와 생성된 응답 전체에 걸쳐 잠재 상태를 전달할 수 있으며, 프롬프트와 응답의 경계를 초기화 지점으로 처리하지 않습니다.
2. 모델 및 하드웨어 공동 설계
제안된 설계는 다음과 같은 여러 최적화 기회를 제공합니다.
- 이미 알려진 토큰에 대한 병렬 인과적 인코더 계산
- 독립적인 시퀀스 간 배치 처리
- 인코더에서 파생된 메모리 재사용
- 순환 디코더 실행 주변의 활성값 체크포인팅
이는 설계 기회이자 연구 목표입니다. 이 보고서는 대규모 하드웨어 속도 향상을 측정했다고 주장하지 않습니다.
3. 학습과 강화 학습을 위한 의미 공유
사전 학습, 지도 미세 조정, 샘플링, 현재 정책 강화 학습 리플레이는 모두 동일한 완전 상태 전이를 사용합니다. 이 상태에는 프롬프트 순환뿐 아니라 디코더의 슬라이딩 윈도우 키-값 캐시도 포함됩니다.
아키텍처 작동 방식
토큰 x_t에 대해 인과적 인코더는 표현 e_t와 인코더에서 파생된 전역 메모리 M_≤t를 생성합니다. 디코더 상태에는 순환 출력과 레이어별 슬라이딩 윈도우 어텐션 캐시가 모두 포함됩니다.
H_t = (s_t, C_t^D)
H_0 = (s_*, empty)
상태 전이는 다음과 같습니다.
(s_t, C_t^D) = D_phi(
  Merge(e_t, s_(t-1)),
  M_≤t,
  C_(t-1)^D,
  t
)
다음 토큰의 분포는 최종 순환 출력으로 계산됩니다.
p(x_(t+1) | x_(1:t)) = softmax(W_o RMSNorm_o(s_t))세 가지 형태의 컨텍스트
- 전역 인코더 컨텍스트: 디코더의 교차 어텐션은 현재 위치를 통해서만 인코더 메모리를 읽으므로 인과적 동작이 유지됩니다.
- 로컬 디코더 메모리: 슬라이딩 윈도우 어텐션은 최근 디코더 키-값 항목과 현재 토큰의 항목을 읽습니다. 크기가
W인 윈도우에는 현재 토큰이 포함되므로 다음 업데이트에 사용할 수 있는 과거 항목은 최대W - 1개입니다. - 시간적 피드백: 이전 최종 디코더 출력은 현재 인코더 표현과 병합됩니다.
시퀀스가 프롬프트에서 응답으로 넘어가도 순환 출력이나 디코더 캐시는 초기화되지 않습니다.
구체적인 모델 구성
이 보고서는 인코더 레이어 48개와 디코더 레이어 48개로 구성된 설정을 설명합니다. 호환되는 어텐션 및 피드포워드 가중치는 단계 간에 공유됩니다. 디코더 블록은 인코더 메모리에 대한 교차 어텐션도 수행하므로 레이어 수가 같다고 해서 부동소수점 연산 횟수까지 같다는 의미는 아닙니다.
설치 및 저장소 설정
README는 문서화된 소프트웨어 패키지가 아니라 아키텍처 보고서를 제시합니다. 의존성 요구 사항, 설치 명령, 공개 학습 스크립트 또는 실행 가능한 API는 제공하지 않습니다. 그래도 저장소를 복제하여 논문과 지원 자료를 읽을 수 있습니다.
git clone https://github.com/yifanzhang-pro/recurrent-looped-tranformer.git
cd recurrent-looped-tranformer
먼저 포함된 Recurrent_Looped_Transformer.pdf를 확인하세요. 프로젝트 웹사이트를 방문하고 프리필-디코드 커널 불일치 관련 문서를 검토할 수도 있습니다.
README에는 실행 가능한 구현이 문서화되어 있지 않으므로 저장소 설명만으로 패키지 설치 지침이나 바로 실행할 수 있는 모델 코드가 있다고 추론해서는 안 됩니다.
기본 사용법: RLT 실행 모델 따르기
이 보고서를 적용하는 가장 유용한 방법은 구현 청사진으로 활용하는 것입니다. 다음 개념적 의사 코드는 하나의 상태 전이를 요약한 것이며, 저장소에서 제공하는 API가 아닙니다.
state = (initial_recurrent_state, empty_decoder_cache)

for each token x_t:
    e_t = causal_encoder_representation(x_t)
    memory = encoder_memory_through_position(t)

    merged = Merge(e_t, state.recurrent_output)
    state = recurrent_decoder(
        merged,
        memory,
        state.decoder_cache,
        position=t
    )

    next_token_distribution = output_head(state.recurrent_output)
프롬프트 프리필
- 알려진 프롬프트 토큰 전체에 대해 인과적 인코더를 배치로 실행합니다.
- 모든 프롬프트 토큰을 디코더로 순환 처리합니다.
- 이 순환 과정에서 디코더 슬라이딩 윈도우 키-값 캐시를 구성합니다.
- 생성을 위해 최종 순환 출력과 캐시를 유지합니다.
프롬프트 프리필 단계에서 인코더만 실행하면 보고서에 설명된 완전한 RLT 상태를 재현할 수 없습니다.
자기회귀 생성
- 이전 상태를 사용해 다음 토큰의 분포를 계산합니다.
- 해당 분포에서 토큰을 샘플링합니다.
- 샘플링된 토큰을 점진적으로 인코딩합니다.
- 순환 디코더를 통해 해당 토큰을 정확히 한 번 처리합니다.
- 순환 출력과 슬라이딩 윈도우 캐시를 모두 업데이트합니다.
이 순서를 따르면 생성된 토큰을 두 번 처리하는 일을 방지하고, 학습 중 사용된 것과 동일한 상태 전이 의미를 보존할 수 있습니다.
사전 학습 및 지도 미세 조정
사전 학습 중에는 인코더가 인과적으로 실행되고 순환 디코더는 시간에 따른 완전한 역전파를 사용합니다. 유효한 모든 다음 토큰 타깃에 대해 지도 신호가 제공됩니다.
지도 미세 조정 중에는 모든 컨텍스트 토큰을 사용해 상태를 업데이트하지만, 손실은 어시스턴트 타깃에만 적용됩니다. 프롬프트 토큰에 지도 신호가 제공되지 않더라도 프롬프트는 순환 상태 구성에 계속 참여합니다.
현재 정책 강화 학습 리플레이
현재 정책 리플레이는 현재 모델 가중치에 따라 전체 시퀀스 이력을 재구성해야 합니다. 여기에는 순환 출력, 인코더 메모리, 모든 디코더 슬라이딩 윈도우 캐시가 포함됩니다.
- 현재 파라미터를 사용해 인코더 표현과 메모리를 재구성합니다.
- 이전의 모든 토큰을 재생해 순환 상태와 디코더 캐시를 재구성합니다.
- 행동 토큰을 처리하기 전에 해당 행동의 확률을 평가합니다.
- 행동을 한 번 처리해 다음 상태로 진행합니다.
파라미터에 의존하는 캐시는 가중치 업데이트 후 오래된 상태가 되므로 정확한 리플레이를 위해서는 이를 다시 구성해야 합니다. 완전한 그래디언트는 순환 출력, 디코더 키-값 항목, 인코더 메모리를 모두 통과합니다. 이 구성 요소 중 하나라도 분리하면 그래디언트 근사가 됩니다.
행동 로그 확률은 샘플링에 실제로 사용된 분포에 대응해야 합니다. 또한 정확한 중요도 샘플링을 위해서는 지지집합 커버리지가 필요합니다. 실행 의미를 공유하면 구조적인 프롬프트 경계 불일치를 줄일 수 있지만, 커널 간 수치적 동등성이나 편향 없는 오프폴리시 목적 함수를 보장하지는 않습니다.
예비 합성 결과
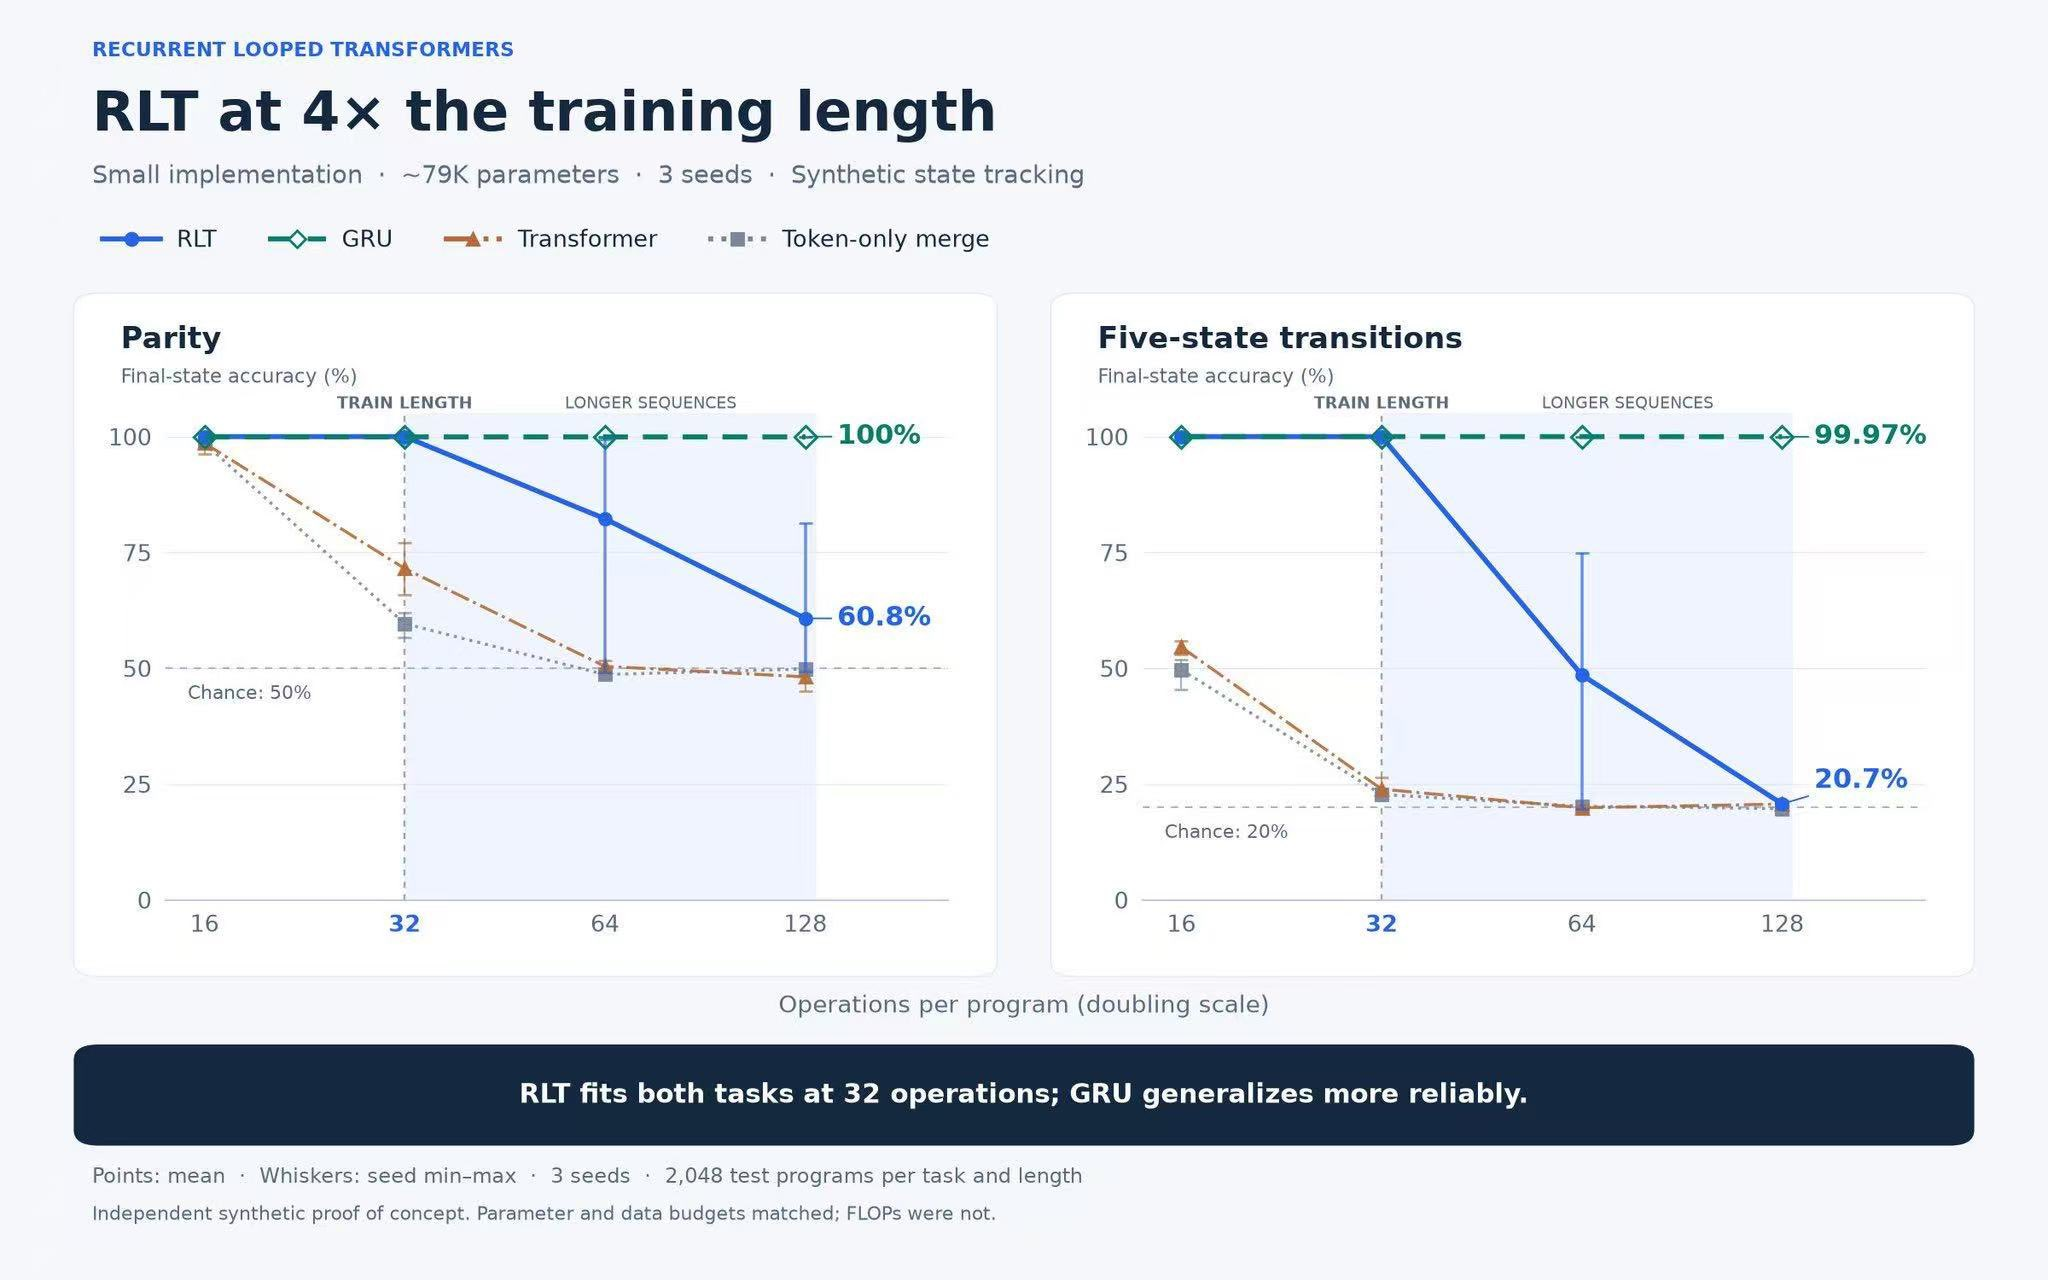
README에는 약 79,000개의 파라미터와 세 개의 무작위 시드를 사용하는 소규모 구현으로 수행한 독립적인 개념 증명 상태 추적 실험이 보고되어 있습니다. 모델은 32개 연산으로 구성된 시퀀스에서 학습되었고 최대 128개 연산까지 평가되었으며, 각 작업과 길이마다 2,048개의 테스트 프로그램이 사용되었습니다.
패리티 작업
- 32개 연산에서 RLT는 최종 상태 정확도 약 100%에 도달했습니다.
- 64개 연산에서는 약 82%에 도달했습니다.
- 128개 연산에서는 60.8%를 기록했습니다.
- 패리티의 무작위 기준 정확도는 50%입니다.
5상태 전이 작업
- 32개 연산에서 RLT는 최종 상태 정확도 약 100%에 도달했습니다.
- 64개 연산에서는 약 49%에 도달했습니다.
- 128개 연산에서는 20.7%를 기록했습니다.
- 이 작업의 무작위 기준 정확도는 20%입니다.
결과에 따르면 RLT는 학습 길이에서 두 작업을 모두 학습했지만, 더 긴 시퀀스에서는 정확도가 하락했습니다. 근사값으로 표시된 수치는 원본 그림에서 읽은 값이며, 128개 연산에서의 RLT 수치는 숫자로 표시되어 있었습니다.
파라미터와 데이터 예산은 일치했지만 부동소수점 연산 예산은 일치하지 않았습니다. 이러한 실험은 대규모 추론 성능 향상, 하드웨어 가속 또는 강화 학습 확장성을 입증하는 것이 아니라 합성 환경에서의 시연입니다.
고급 구현 팁
- 전체 상태를 분할할 수 없는 단위로 취급하세요:
s_t와C_t^D를 모두 보존하세요. 순환 벡터만 복원해서는 문서에 설명된 전이를 재현할 수 없습니다. - 응답 경계에서 상태를 초기화하지 마세요: 프롬프트의 순환 상태와 디코더 캐시는 응답 생성으로 직접 이어져야 합니다.
- 윈도우를 정확히 정의하세요: 크기가
W인 슬라이딩 윈도우에는 현재 토큰이 포함되므로 다음 업데이트에 사용할 수 있는 과거 항목은W - 1개뿐입니다. - 업데이트 후 캐시를 다시 구성하세요: 현재 정책 리플레이에는 이전 정책에서 캐시된 값이 아니라 현재 가중치로 생성된 캐시가 필요합니다.
- 샘플링 순서와 리플레이 순서를 일치시키세요: 이전 상태에서 생성된 행동을 평가한 다음 한 번 처리하세요.
- 정확한 그래디언트와 근사를 구분하세요: 순환 상태, 디코더 캐시 또는 인코더 메모리를 분리하면 그래디언트 경로가 변경됩니다.
- 계산량을 별도로 측정하세요: 특히 디코더 레이어가 인코더 메모리와의 교차 어텐션을 추가하므로, 동일한 파라미터 또는 데이터 예산이 동일한 FLOPs를 의미하지는 않습니다.
- 수치 동작을 검증하세요: 상위 수준의 실행 의미를 공유한다고 해서 프리필 커널과 디코드 커널 간 차이가 자동으로 사라지는 것은 아닙니다.
결론
Recurrent Looped Transformer는 전역 인과 인코더 메모리, 로컬 디코더 슬라이딩 윈도우 어텐션, 토큰 간 순환 피드백을 결합합니다. 핵심 구현 원칙은 일관성입니다. 사전 학습, 미세 조정, 생성, 현재 정책 리플레이 전반에서 모든 프롬프트 및 응답 토큰이 동일한 완전한 상태 전이에 참여해야 합니다.
예비 실험은 소규모 상태 추적 작업에서 유용한 길이 일반화 가능성을 시사하지만, 학습 길이를 넘어가면 성능은 여전히 하락합니다. 따라서 이 아키텍처는 검증된 대규모 추론 시스템이라기보다 연구 제안이자 개념 증명으로 보아야 합니다.