

대학원 입학 상담 에이전트 벤치마크의 역할
대학원 입학 상담 에이전트 벤치마크는 대학원 입학 상담을 위한 에이전트 구성을 평가합니다. 에이전트 구성은 실행 시스템과 언어 모델을 결합하며, 지원서 추천, 계획 수립, 의사 결정, 새로운 학생 정보가 제공되었을 때 조언을 업데이트하는 능력을 평가받습니다.
현재 벤치마크에는 중국어 작업 70개, 사례 23개, 답변 단계 83개가 포함되어 있습니다. 각 작업에는 평가 기준과 참조 프로그램이 있습니다. 공개 데이터 세트는 접근 승인 없이 이용할 수 있지만, 평가 대상 에이전트가 채점 자료에 접근할 수 없도록 해야 결과가 오염되지 않습니다.
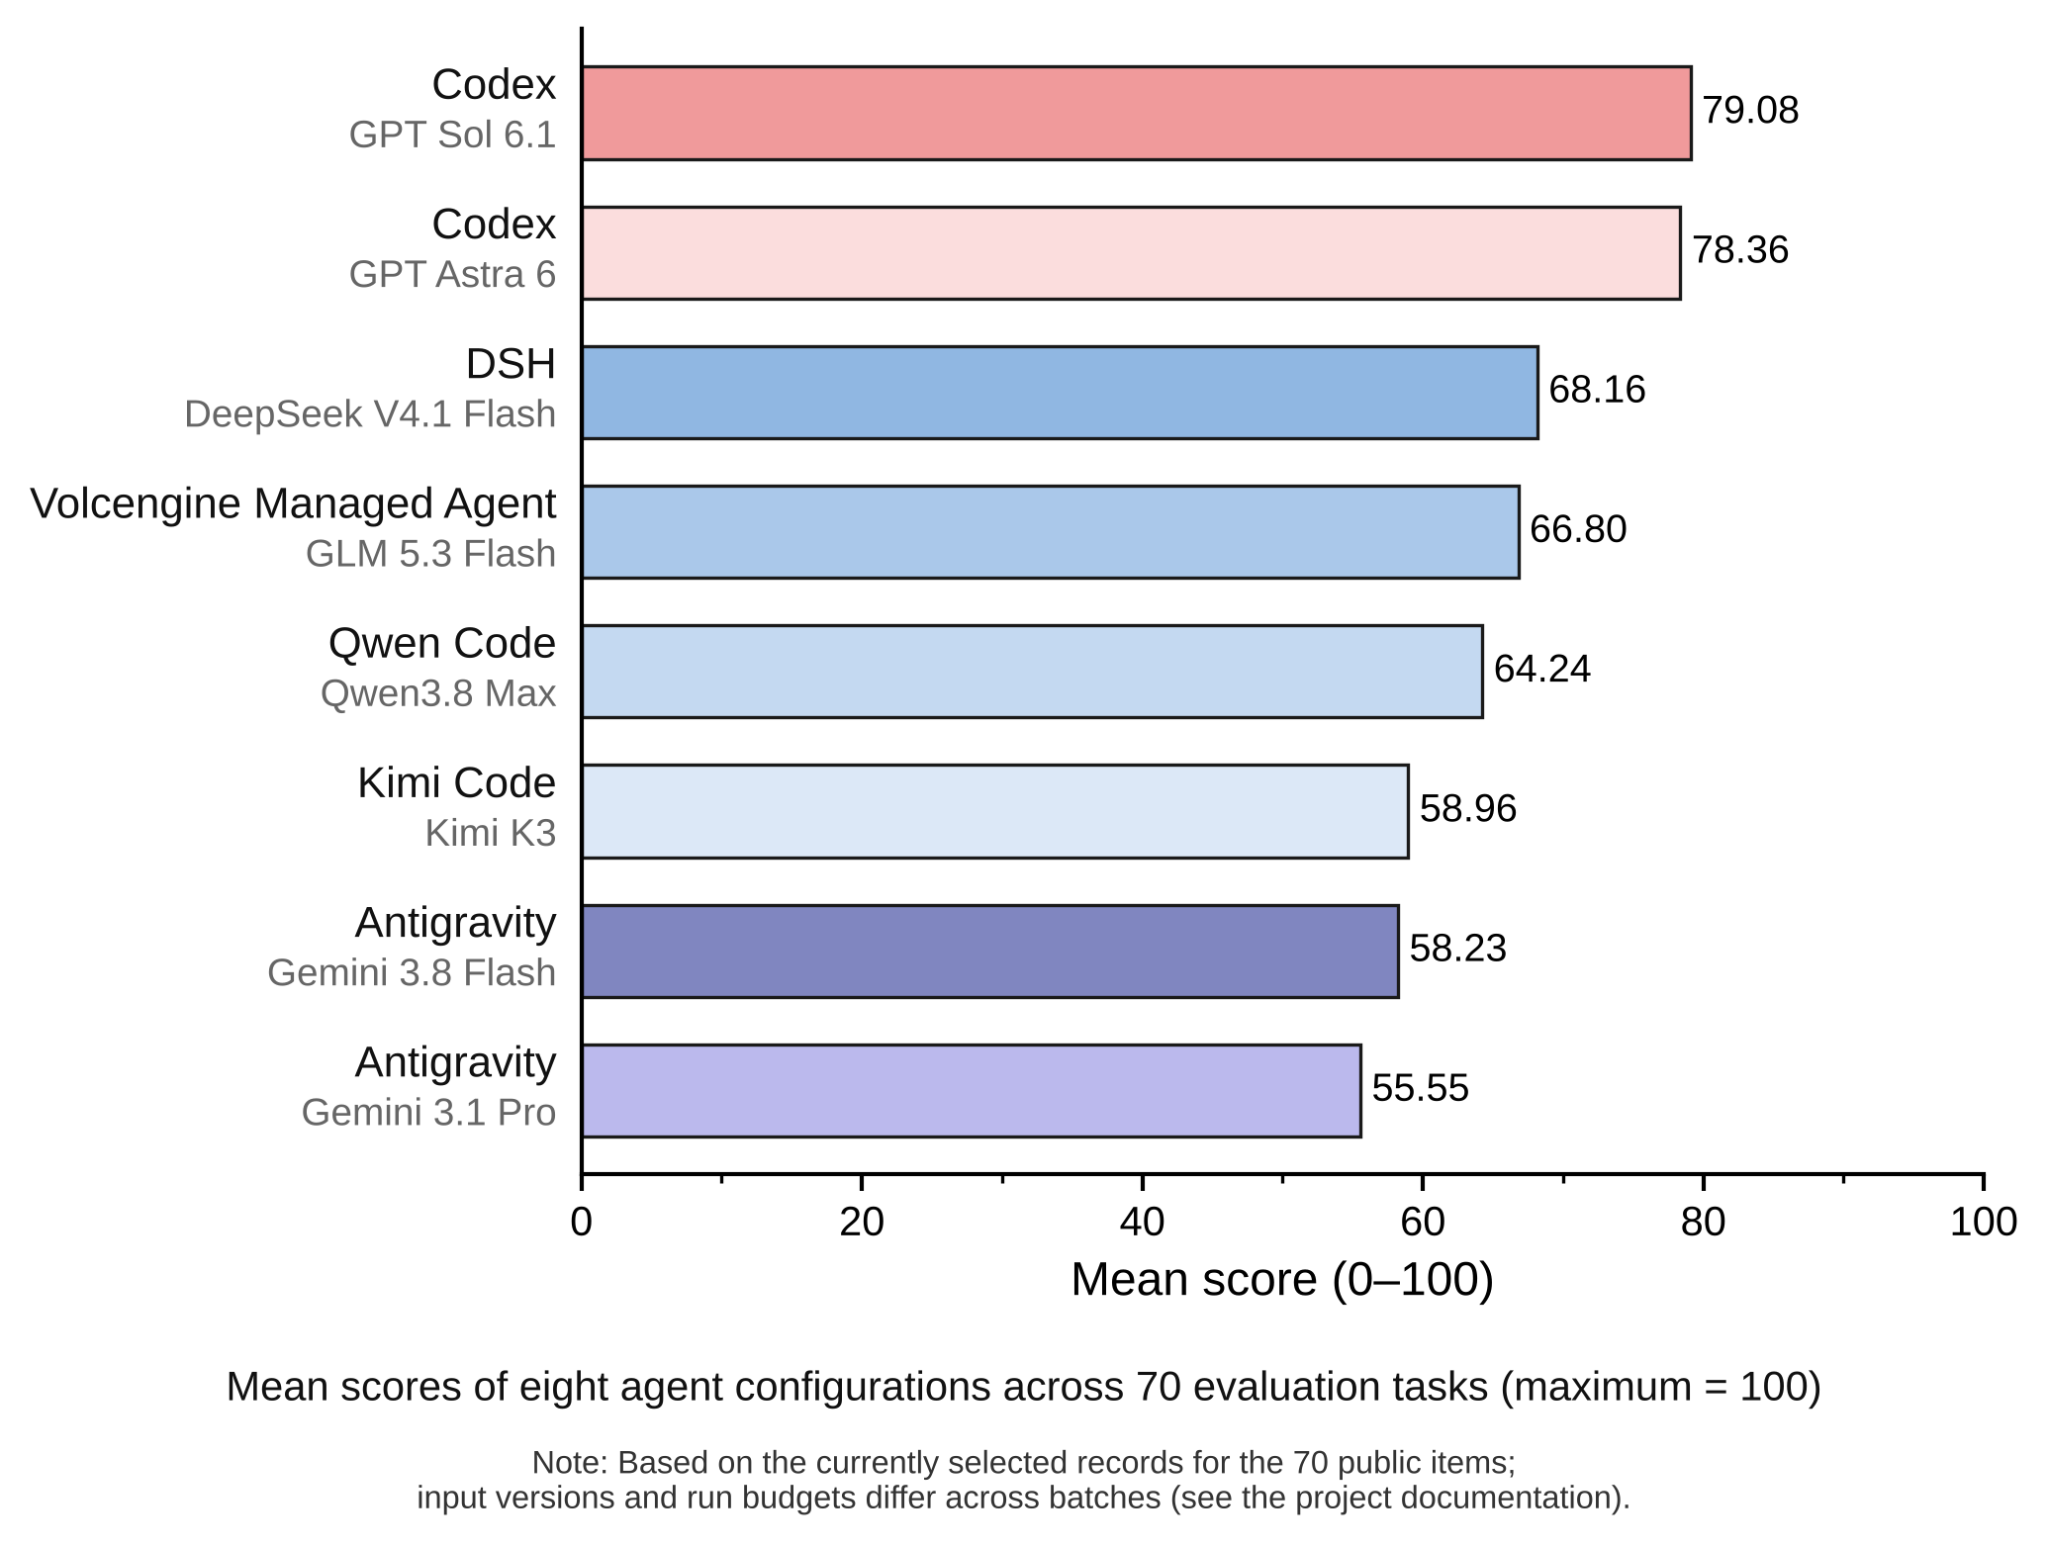
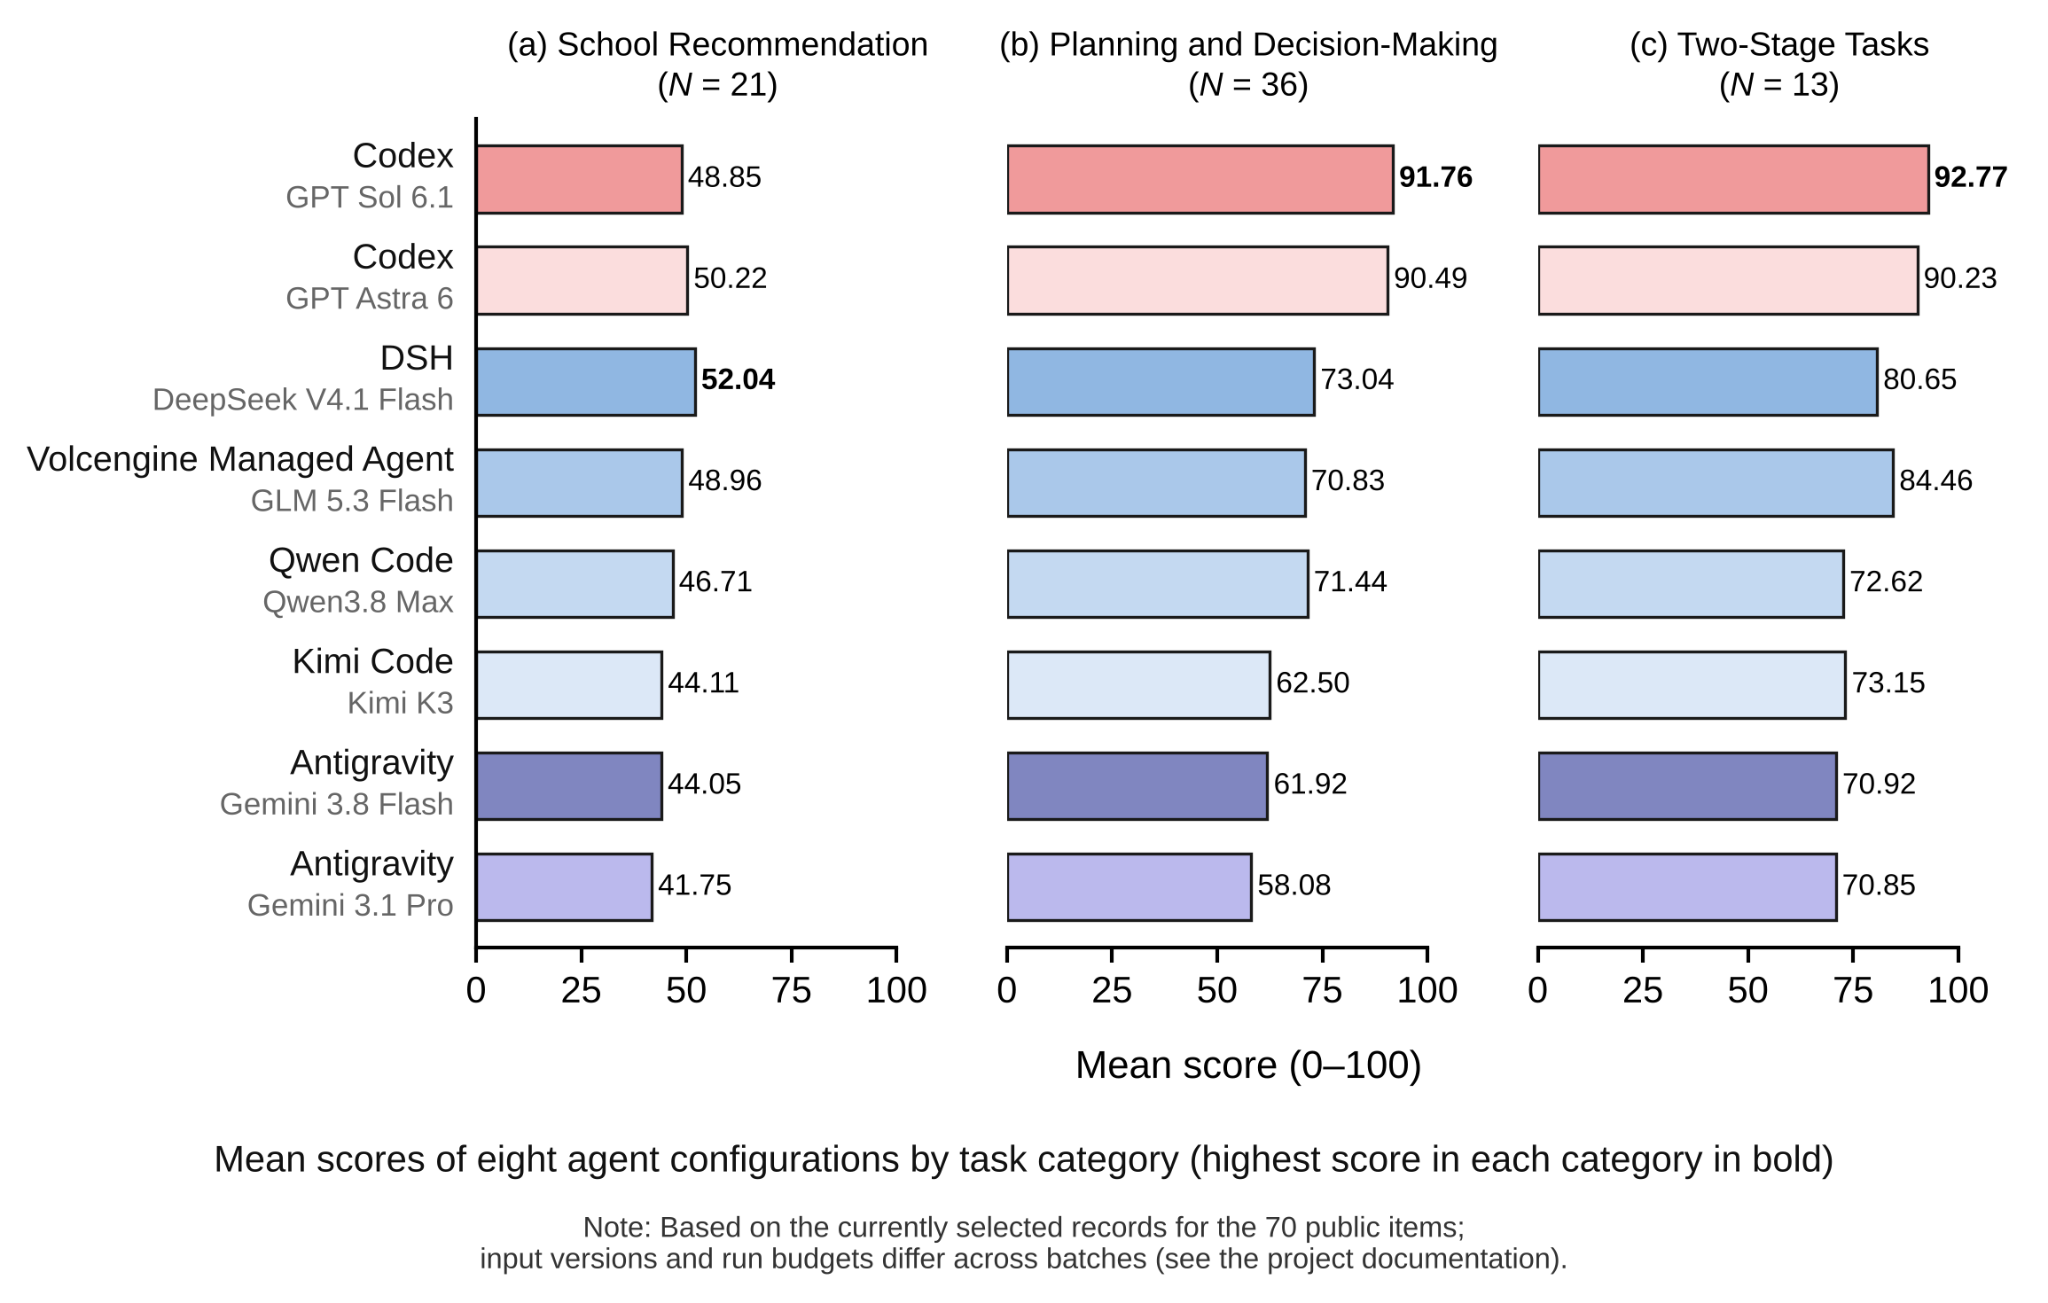
저장소에는 8개 구성에 대한 평가 기록도 공개되어 있습니다. 모든 구성은 현재 70개 작업을 완료했지만, 프로젝트에서는 실행마다 입력 버전과 예산이 달랐다고 설명합니다. 따라서 리더보드 결과를 완전히 동일한 조건의 실험 결과로 간주해서는 안 됩니다.
평가 구조 이해하기
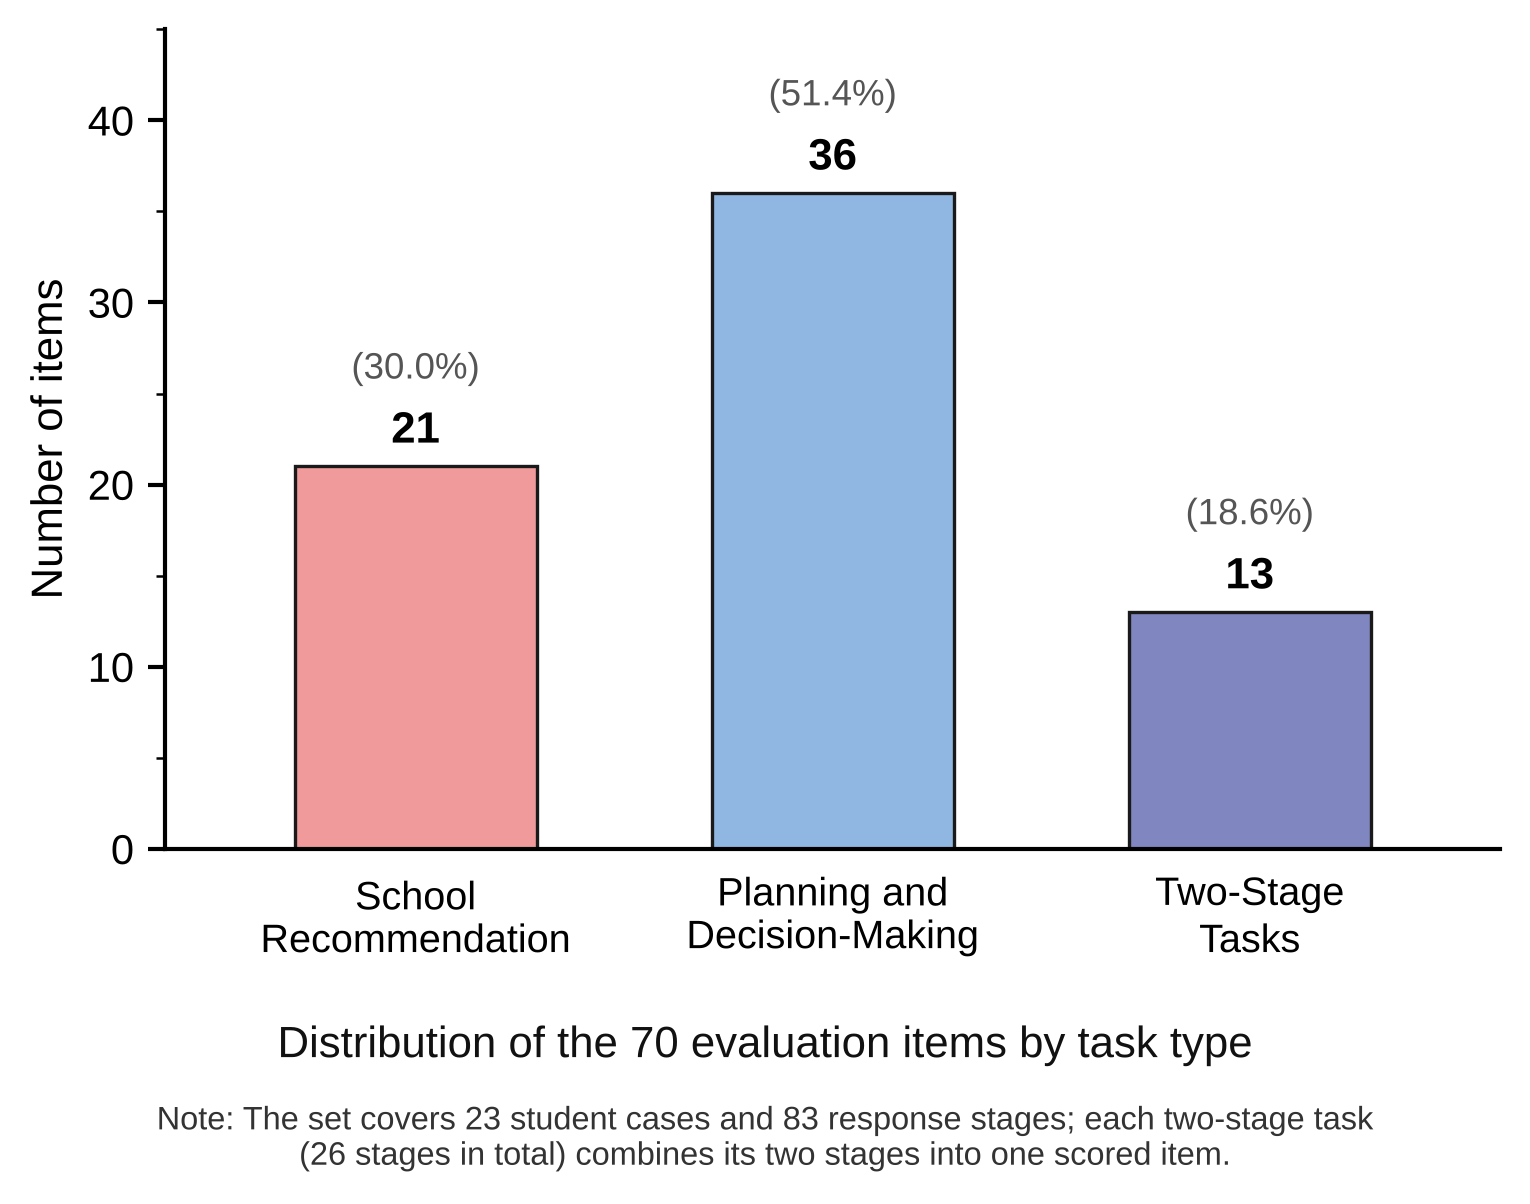
작업 모음은 세 가지 범주로 나뉩니다.
- 추천 작업 21개: 추천 프로그램이 학생의 배경과 제약 조건에 얼마나 잘 부합하는지 평가합니다.
- 계획 및 의사 결정 작업 36개: 준비 계획, 위험 평가, 실행 가능한 조언을 평가합니다.
- 2단계 작업 13개: 같은 세션에서 새로운 정보를 제공하고 에이전트가 이전 조언을 수정하는지 확인합니다.
각 작업의 배점은 100점입니다. 추천 작업은 참조 프로그램 일치도에 70점, 추천 품질에 30점을 배정합니다. 별도의 검토자가 전체 답변을 채점하며, 평가 기준은 답변 과정에서 에이전트에 공개되지 않습니다.
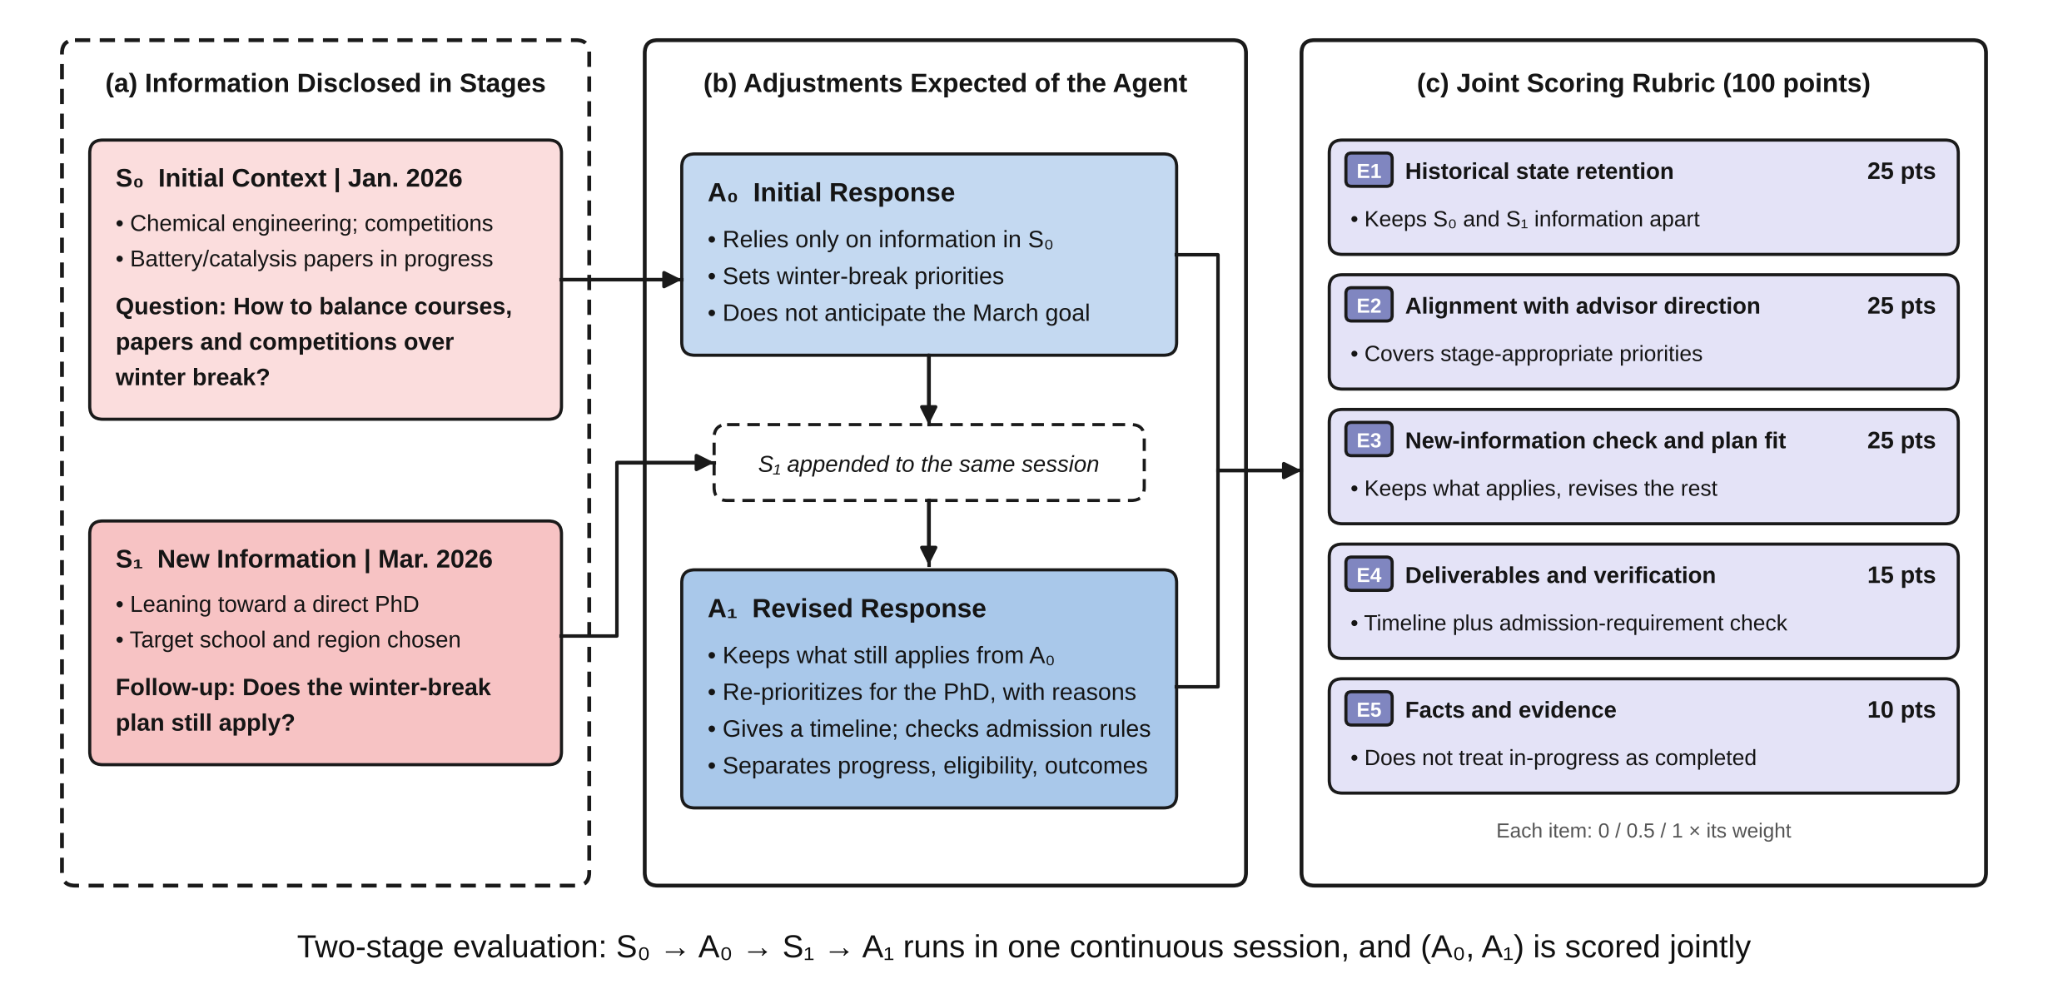
2단계 작업은 S₀이라고 하는 초기 맥락으로 시작한 다음, S₁이라고 하는 업데이트된 정보를 제공합니다. 에이전트는 한 세션에서 초기 답변 A₀와 수정 답변 A₁을 작성합니다. 두 답변은 함께 채점됩니다. 공개된 O03-04 예시는 학생이 1월부터 3월 사이에 진로를 직접 박사 과정 지원으로 전환하는 시나리오를 보여 줍니다.
환경 준비하기
저장소 루트에서 명령을 실행합니다. 자동화된 네이티브 실행에는 macOS Seatbelt와 Python 3.10 이상이 필요합니다. Kimi 구독 구성에는 Python 3.11 이상이 필요합니다.
이 프레임워크는 Python 표준 라이브러리만 사용하므로 저장소에 pip install 단계가 필요하지 않습니다. 단, 실행하려는 구성의 공식 클라이언트를 설치하고 구독 로그인 또는 API 키를 준비해야 합니다.
사용 가능한 클라이언트로는 Codex, Claude Code, Antigravity, DeepSeek Harness, Qwen Code, Kimi Code가 있습니다. 인증 방식은 클라이언트마다 다릅니다. 일부 구성은 구독 또는 OAuth를 사용하며, DeepSeek와 Qwen은 프로젝트 문서에 설명된 API 기반 인증을 사용합니다.
에이전트 구성 선택하기
에이전트 ID는 저장소의 현재 레지스트리인 config/agents-cli.example.json에서 가져옵니다. 이 ID는 벤치마크 구성 식별자이며 직접적인 모델 인자가 아닙니다.
gpt-6-astra는 GPT Astra 6을 사용하는 Codex용입니다.gpt-6-1-sol은 GPT Sol 6.1을 사용하는 Codex용입니다.claude-opus-5-5는 Claude Opus를 사용하는 Claude Code용입니다.claude-sonnet-5-5는 Claude Sonnet을 사용하는 Claude Code용입니다.antigravity-gemini-3-8-flash-high는 Gemini Flash를 사용하는 Antigravity용입니다.deepseek-v4-1-flash는 DeepSeek Flash를 사용하는 DeepSeek Harness용입니다.qwen3-8-max-0902는 Qwen Max를 사용하는 Qwen Code용입니다.kimi-k3는 Kimi K3를 사용하는 Kimi Code용입니다.
빠른 시작 워크플로 실행하기
벤치마크는 모든 구성에 동일한 워크플로를 사용합니다. 먼저 에이전트 ID를 AGENT 셸 변수에 할당합니다.
AGENT=gpt-6-1-sol다음으로 로컬 구성을 저장합니다.
python3 -m benchmark setup --agent "$AGENT"
선택한 클라이언트와 인증이 준비되었는지 확인합니다.
python3 -m benchmark cli-check --agent "$AGENT"확인 결과가 ready_for_trial이면 현재 작업 선택 항목을 사용해 배치를 실행합니다.
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT"
기본적으로 배치 실행은 모델을 호출하지 않고 70개 작업과 83개 단계를 미리 확인합니다. 계정 사용량을 차감할 준비가 되면 --execute를 추가합니다.
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT" \
--executecli-check가 성공한 후 먼저 시험 작업 하나를 실행하세요. 이를 통해 전체 배치를 시작하기 전에 클라이언트, 인증 방식, 샌드박스, 출력 위치가 정상적으로 작동하는지 확인할 수 있습니다.
여러 구성 실행하기
각 클라이언트를 개별적으로 구성하고 확인한 다음, 배치 명령에 여러 --agent 옵션을 전달하세요. 서로 다른 구성의 결과가 서로 덮어쓰이지 않도록 새 출력 디렉터리를 사용하세요.
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent gpt-6-1-sol \
  --agent claude-opus-5-5 \
  --out "./runs/comparison" \
  --execute
각 구성의 인증 모드가 레지스트리에 등록된 클라이언트와 일치하도록 유지하세요. 구독 기반 구성은 지원되는 구독 로그인을 사용해야 하며, API 구성은 필요한 API 자격 증명을 사용해야 합니다.
작업 및 결과 확인
작업 인덱스는 config/selections/current.json에서 확인할 수 있습니다. 질문, 평가 기준, 점수 정의는 질문 및 점수 산정, 데이터 형식 가이드, 점수 산정 규칙을 참조하세요.
공개된 결과는 여러 형식으로 제공됩니다:
- 집계 결과를 제공하는 점수 요약.
- 작업별 상세 기록을 제공하는 작업별 결과.
- 공개 답변 텍스트와 평가 정보를 제공하는 구성별 답변 및 점수.
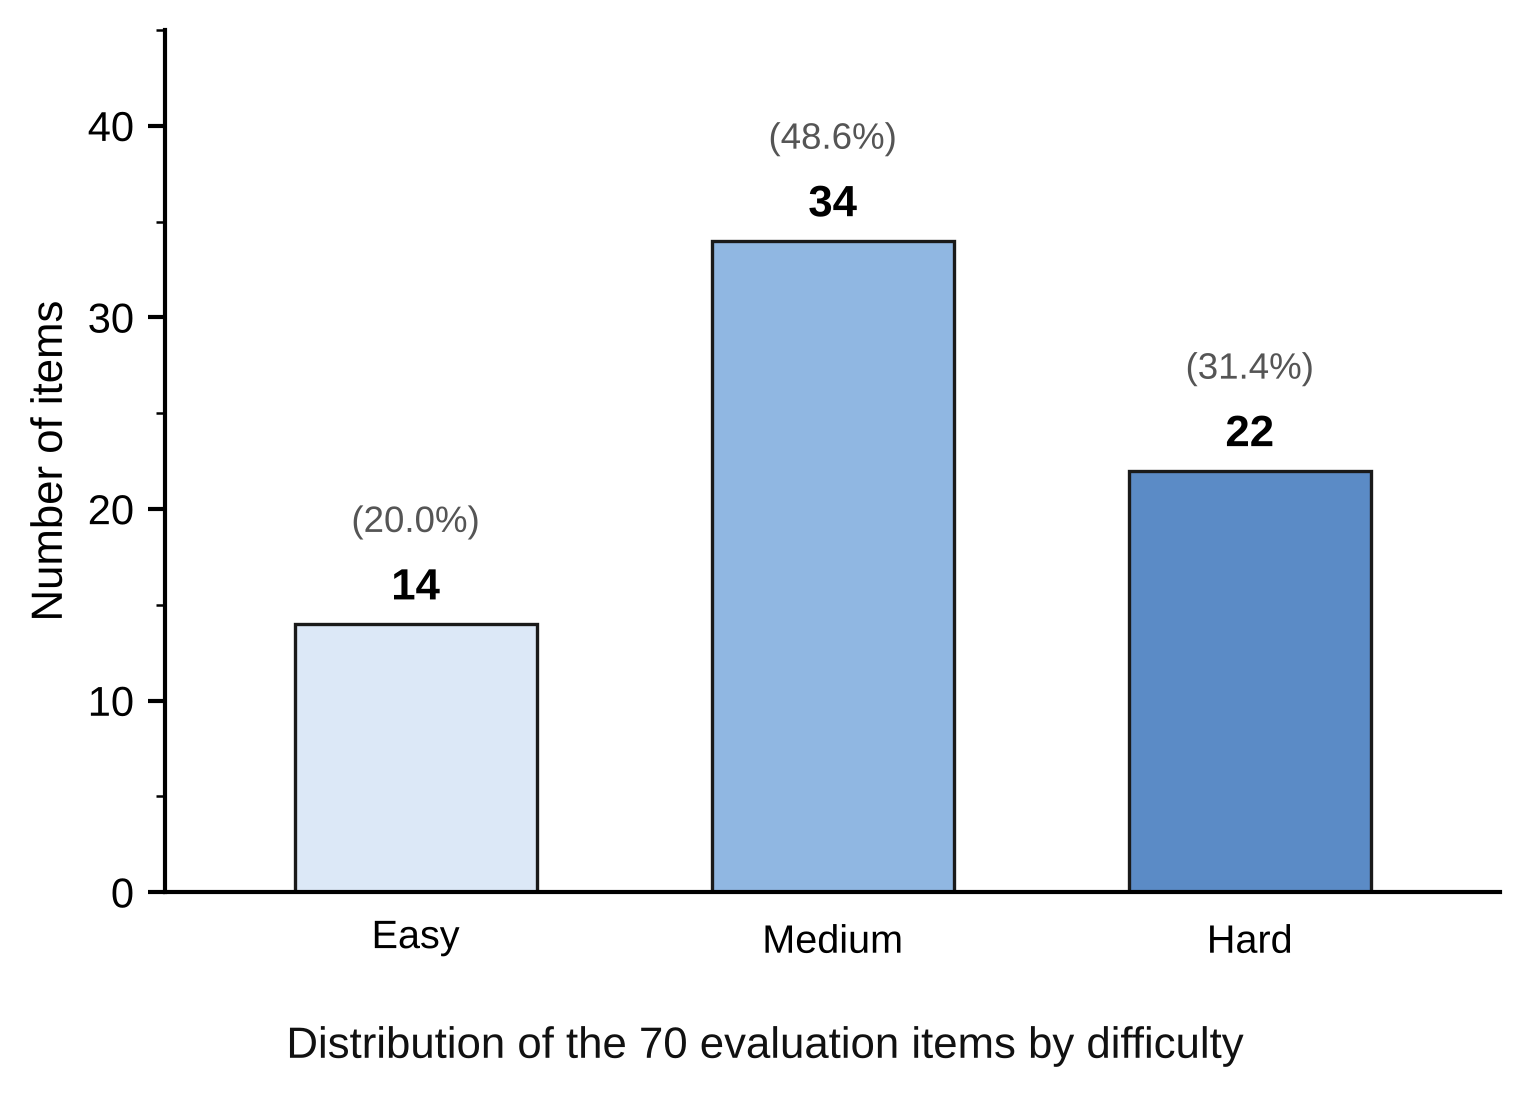
공개 리더보드는 평가된 8개 구성의 평균 점수와 완료율을 보고합니다. 또한 저장소에는 현재 작업의 난이도 레이블이 기록되어 있습니다: 쉬움 14개, 보통 34개, 어려움 22개입니다. 이러한 레이블은 교사 보정을 통해 담당자가 확인한 것이며, 독립적인 이중 검토 결과로 제시되는 것은 아닙니다.
점수 산정 및 검토 팁
점수 산정에는 내보낸 자료를 검토하기 위해 별도의 Codex 구독 세션이 사용될 수 있습니다. 선택적 API 평가는 추가 구성이 필요합니다. 평가 대상 에이전트에 루브릭이나 참조 프로그램이 노출되면 비교 결과가 무효화될 수 있으므로, 답변 과정과 점수 산정 자료를 분리하세요.
자체 실행 결과를 비교할 때는 에이전트 ID, 클라이언트 버전, 입력 버전, 실행 예산, 출력 디렉터리 및 관련 콘텐츠 해시를 기록하세요. 프로젝트에서는 공개 리더보드 실행 결과가 모두 동일한 실행 조건을 공유하지 않는다고 경고하므로, 방법론 및 실행 기록과 함께 결과를 비교하세요.
재현 가능한 실험을 위해 고정된 입력, 제출물, 점수 확인을 다루는 재현 가이드를 따르세요. 방법론 문서는 평가 설정과 제한 사항을 설명하며, 네이티브 CLI 가이드는 설치, 인증 및 여러 단계에 관한 자세한 정보를 제공합니다.
결론
Graduate Admissions Agent Benchmark는 입학 에이전트가 정확한 추천, 유용한 계획 조언, 학생 상황 변화에 대한 적절한 업데이트를 제공하는지 체계적으로 테스트할 수 있는 방법을 제공합니다. 지원되는 클라이언트를 설정하고, 레지스트리에서 에이전트 ID를 선택한 뒤, cli-check로 확인하고, 배치를 미리 본 다음 시험 실행 또는 전체 평가를 수행하세요. 점수를 책임 있게 해석하고 비교 결과를 재현하려면 공개된 작업 정의, 결과 및 방법론 문서를 사용하세요.