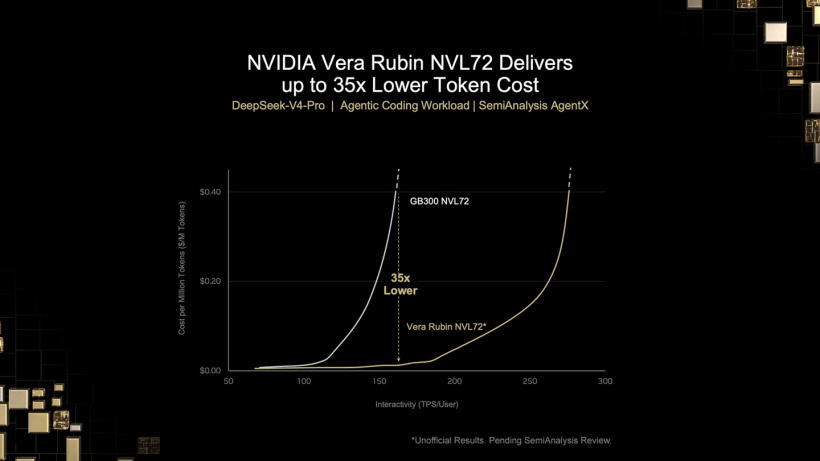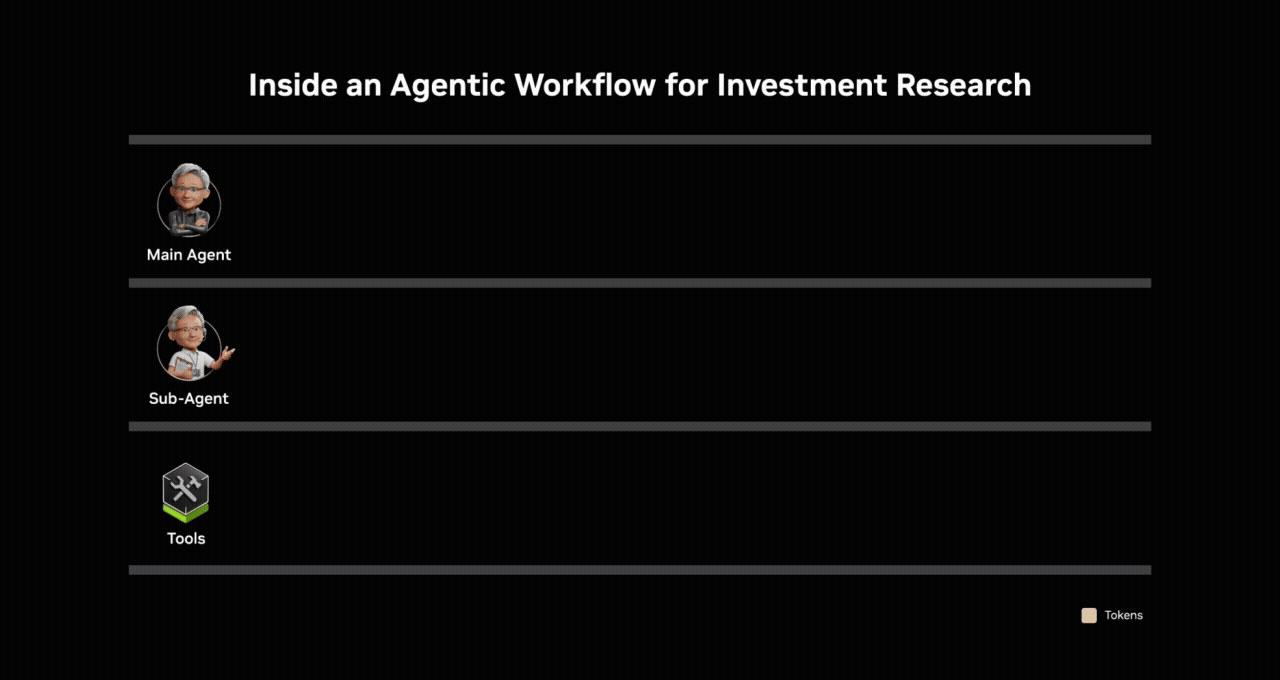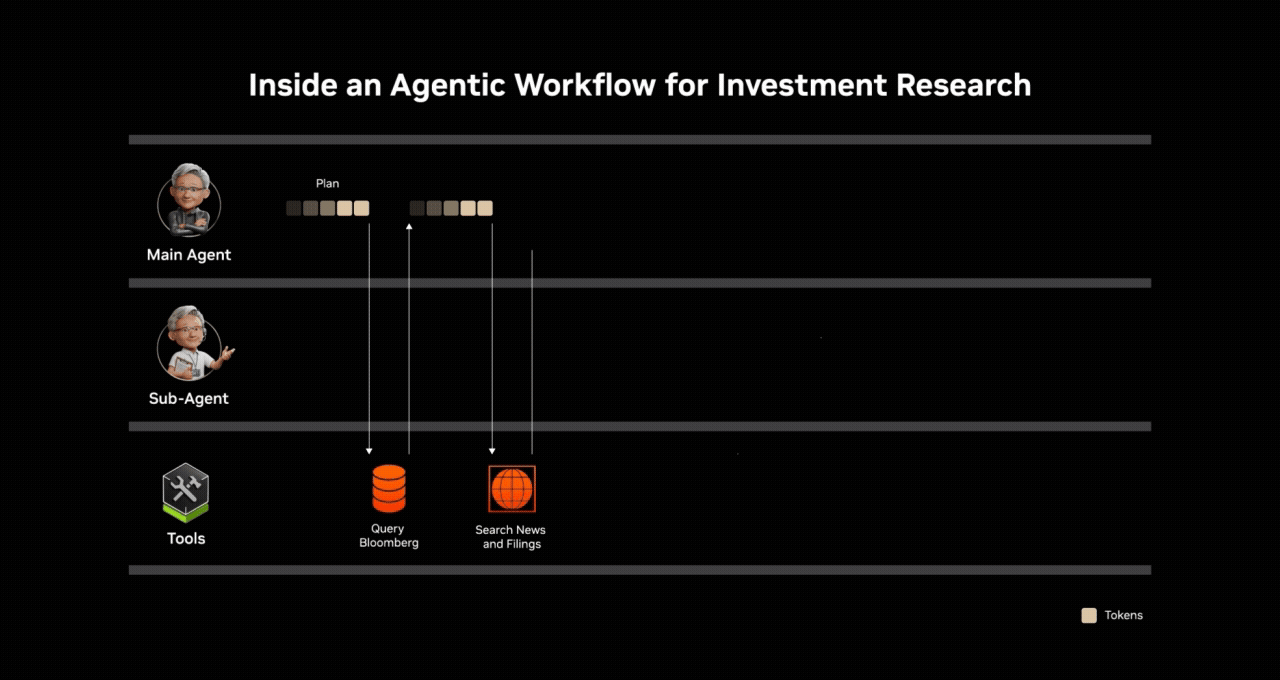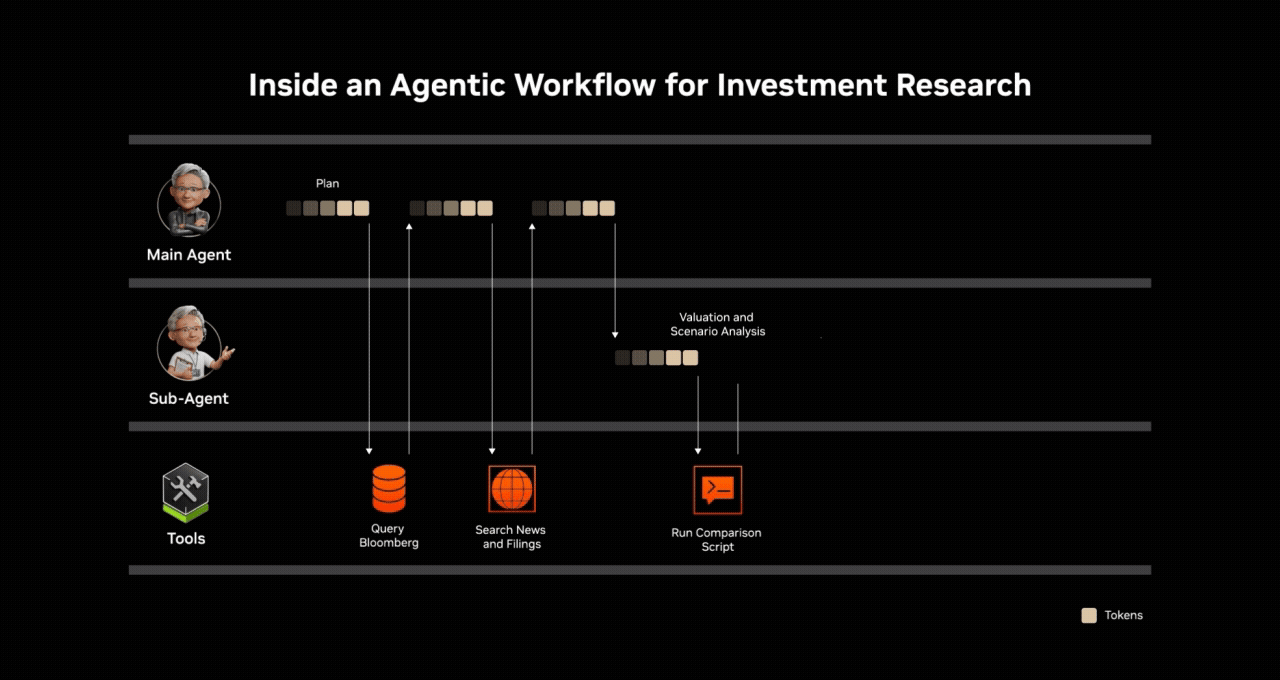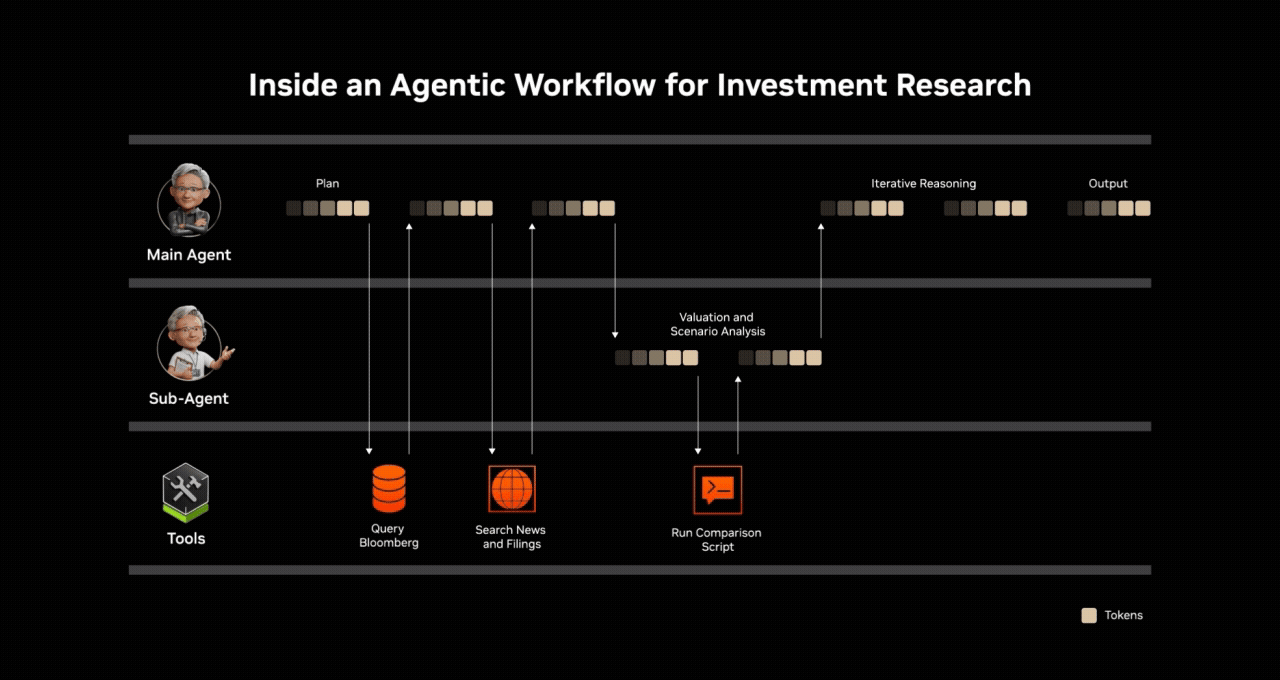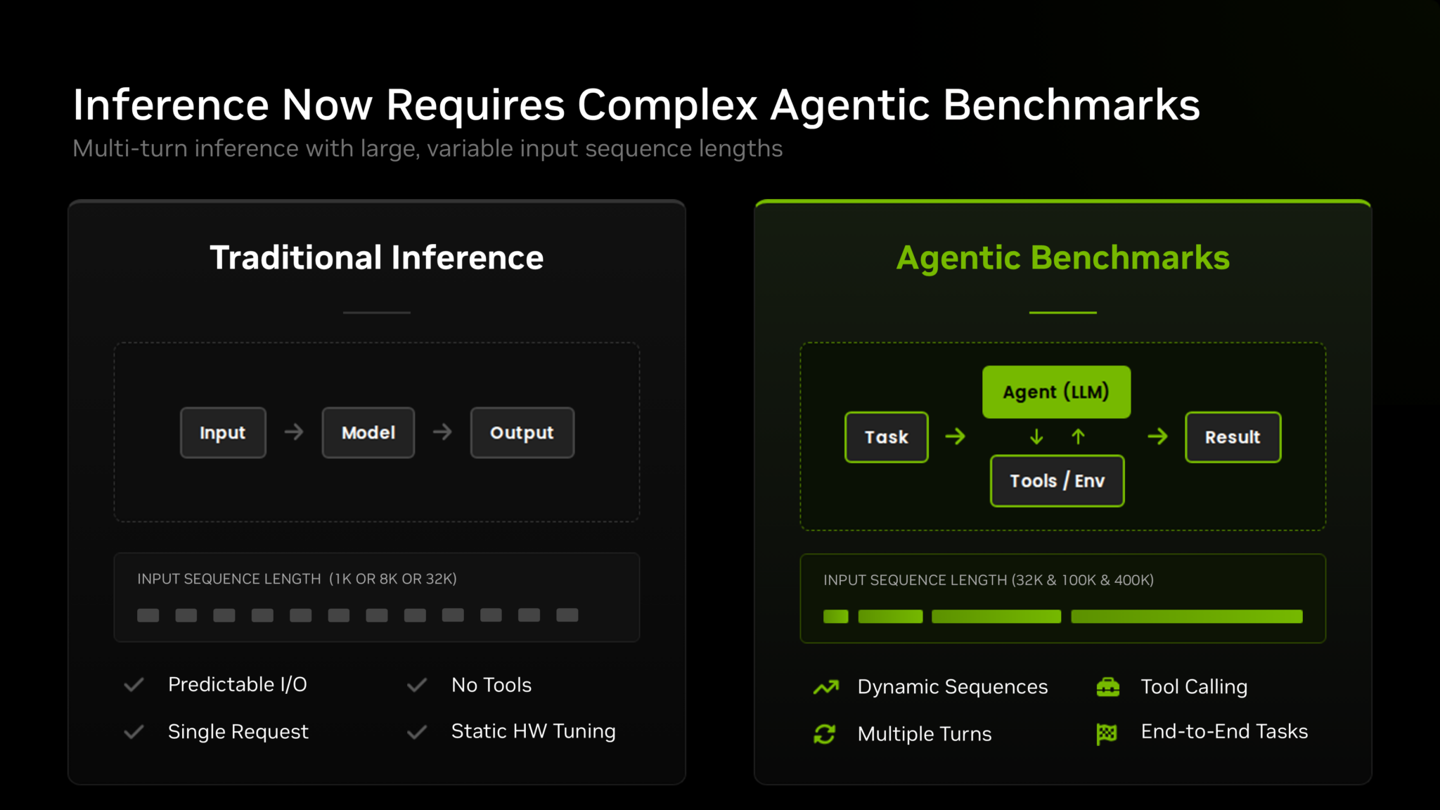
NVIDIA ilitumia jana workload ya SemiAnalysis AgentX kufanya tathmini kwa modeli ya DeepSeek-v4-PRO 1.6T, na kuonyesha kuwa throughput ya Vera Rubin kwa kila megawati ni mara 30 ya Blackwell.
Throughput kwa kila megawati (Tokens per Megawatt, kwa kifupi tokens / MW) ni kiashiria muhimu cha ufanisi wa nishati kinachopima idadi ya tokeni za AI ambazo kituo cha data cha AI kinaweza kuzalisha kwa kiwango maalum cha umeme.
IT之家 ilinukuu makala ikieleza kuwa SemiAnalysis AgentX hutathmini hasa workload za uelekezaji wa programu kwa mawakala kupitia vipimo 4:
Muingiliano uliosanifishwa wa mwisho hadi mwisho huhesabiwa kuanzia ombi linapowasilishwa hadi tokeni ya mwisho inapowasili, na huonyesha ufanisi wa matokeo unaoonekana kwa mtumiaji, ikijumuisha muda wa kusubiri tokeni ya kwanza;
Muingiliano wa kawaida huhesabu tu hatua ya uzalishaji kati ya tokeni ya kwanza na tokeni ya mwisho.
Kuchelewa kwa mwisho hadi mwisho hupima muda wote wa ombi moja kuanzia linapowasilishwa hadi tokeni ya mwisho ya matokeo inapowasili.
Kuchelewa kwa tokeni ya kwanza (TTFT) hupima muda kuanzia ombi linapowasilishwa hadi tokeni ya kwanza ya matokeo inapowasili.
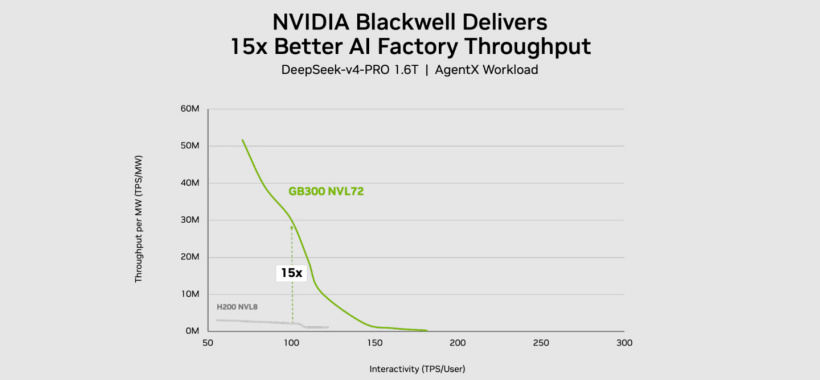
Kwenye workload ya DeepSeek-v4-PRO 1.6T, seva ya Grace Blackwell yenye GB300 NVL72 ilifikisha throughput kwa kila megawati mara 15 ya suluhisho la H200 NVL8 Hopper.
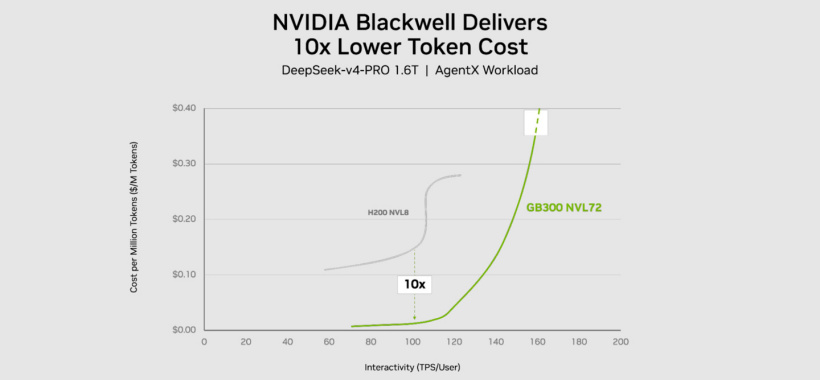
Gharama ya kila tokeni milioni kwenye Blackwell ni takriban sehemu ya 1/10 ya kizazi kilichopita. Waendeshaji wanaweza kusaidia mawakala wengi zaidi kwa bajeti ileile ya umeme na miundombinu, au kudumisha uwezo uleule wa mawakala kwa gharama ndogo za uendeshaji.
Vera Rubin inaendeleza faida hii zaidi. Kwenye modeli ya DeepSeek V4 Pro, throughput ya Vera Rubin NVL72 kwa kila megawati ni takriban mara 30 ya GB300 NVL72.
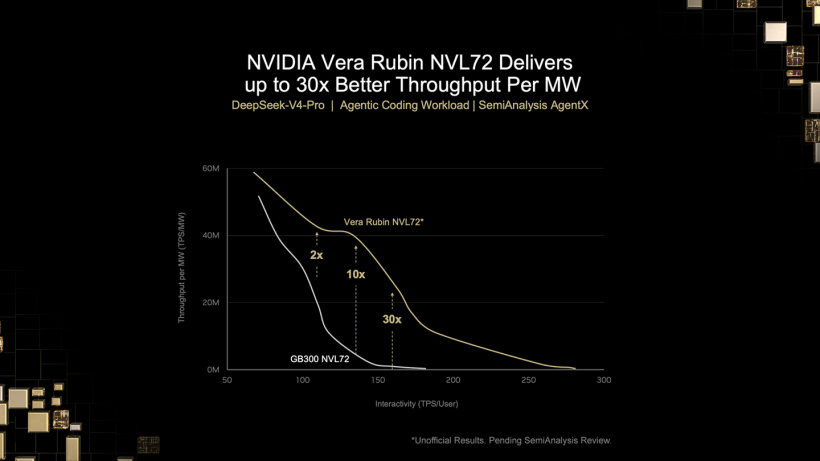
Gharama ya kila tokeni milioni kwenye Vera Rubin NVL72 ni sehemu ya 1/35 ya GB300 NVL72, hivyo inaweza kuendesha mawakala kwa uendelevu na kwa kiwango kikubwa, na kukidhi mahitaji ya wateja ya workloads mbalimbali.