

Google imetangaza leo kuzindua kipengele cha uelewa wa video unaoongozwa na wakala (agentic video understanding) katika miundo mipya ya Gemini 3.7 Flash, 3.6 Flash na 3.5 Flash-Lite. Kipengele hiki kipya kinaweza kuongeza usahihi wa uchanganuzi wa video, huku kikipunguza kwa kiasi kikubwa matumizi ya Token na gharama wakati wa kuchanganua video.
Kipengele hiki hutumia bei ya kawaida ya Token ya Gemini API na hakitozwi ada ya ziada ya kipengele.
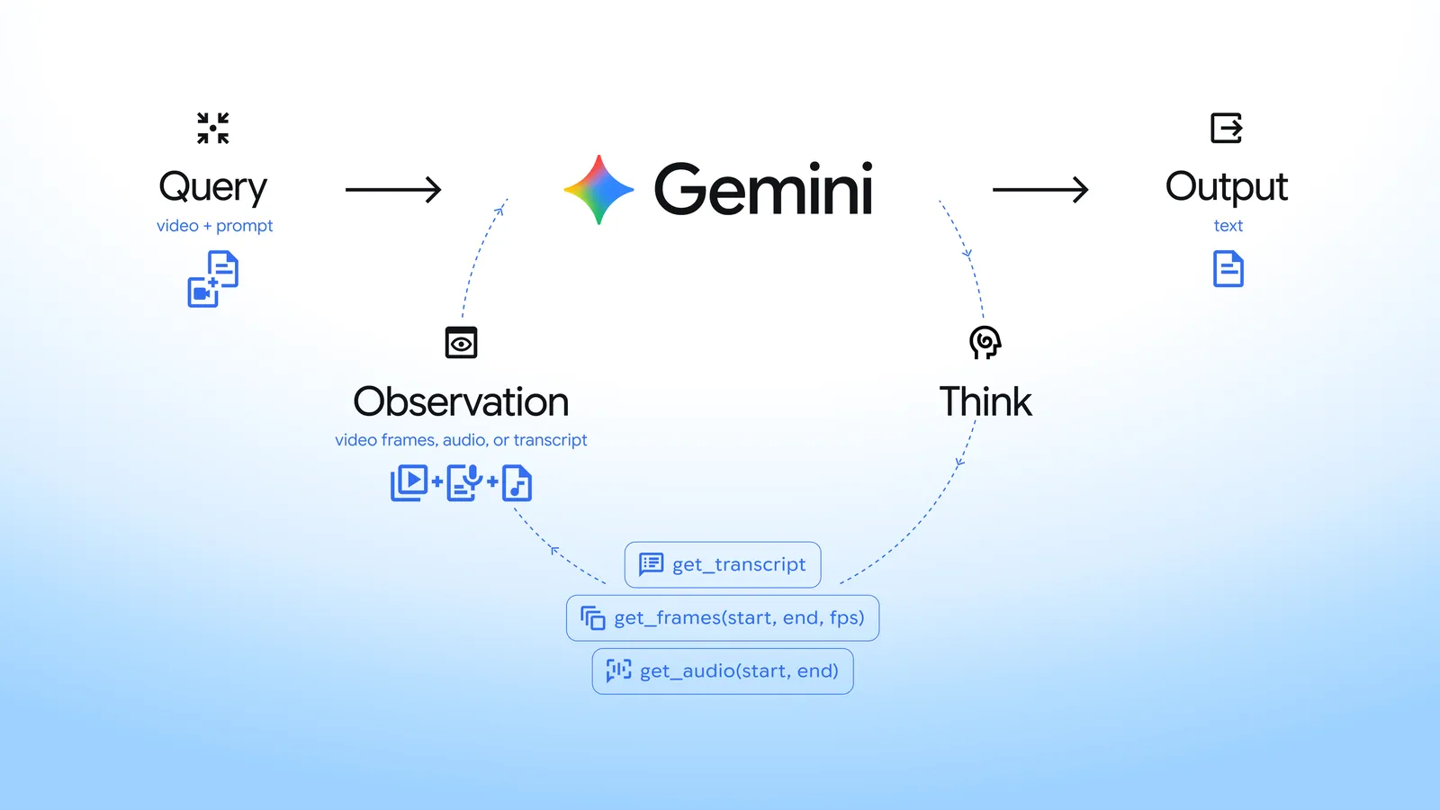
Tofauti na mbinu ya sasa ya “uchakataji tuli” ambapo modeli husoma video kwa kasi maalum ya fremu, kwa chaguo-msingi 1 FPS inayoweza kurekebishwa kupitia API, uelewa wa video unaoongozwa na wakala huunganisha uwezo wa msingi wa modeli wa kufanya hoja na zana asilia za video. Hivyo, inaweza kutafuta, kuchanganua na kukagua kwa nguvu sehemu lengwa za video katika fremu za picha, sauti na maandishi yaliyonakiliwa.
Katika majaribio sanifu ya utendaji wa uchanganuzi wa video, miundo ya Gemini yenye uelewa wa video unaoongozwa na wakala inaweza kupunguza gharama ya uchanganuzi kwa hadi 66%, kupunguza matumizi ya Token kwa hadi 88%, na kuongeza usahihi kwa hadi 7%. Ongezeko hili la ufanisi linaonekana zaidi katika video ndefu, kwa kuwa uchakataji tuli wa jadi huwalazimisha watengenezaji kuchagua kati ya gharama kubwa ya Token na kupoteza maelezo muhimu.
Google imesema kuwa Gemini 3.7 Flash ikiwa na uelewa wa video unaoongozwa na wakala hutoa ubora bora zaidi kwa ujumla, huku ikifikia uwiano bora kati ya ubora na ufanisi wa gharama, na kuwa kwenye mpaka wa Pareto wa usahihi na gharama katika kazi za uelewa wa video.
Tofauti na uchakataji tuli ambapo modeli husoma mkondo wa midia kwa kasi maalum ya fremu, uelewa wa video unaoongozwa na wakala huiwezesha Gemini kuamua kwa njia tendaji na yenye lengo ni maudhui gani ya kutazama, itazame kwa kasi gani, na itumie njia ipi ya kupata taarifa, iwe fremu, sauti au maandishi yaliyonakiliwa. Hivyo, hutoa tu sehemu na ishara zinazohitajika. Hapo awali, watengenezaji walilazimika kukamilisha shughuli hizi wenyewe, lakini kwa kutumia uelewa wa video unaoongozwa na wakala, Gemini inaweza kufanya hivyo kupitia mzunguko wa akili na kuita zana za ndani kupakia sehemu zinazohusiana za video, hivyo kupunguza kwa kiasi kikubwa kazi ya uundaji.
Kulingana na IT之家, kipengele hiki huwapa watengenezaji uwezo mwingi mpya wa kuchakata maudhui ya video ndefu.
Utafutaji wa matukio ya chini ya sekunde: Kubaini kwa usahihi mabadiliko ya muda mfupi na mipaka ya uhariri wa vipande vifupi ambayo ni rahisi kukosa katika 1 FPS, na kuwezesha uhariri wa video wa kiotomatiki kwa usahihi wa juu.
Utafutaji wa “sindano kwenye mrundikano wa nyasi” katika video ndefu: Kujibu maswali changamano katika video zenye urefu wa saa kadhaa bila kutumia mamilioni ya Token.
Ugunduzi wa hitilafu: Kuchukua sampuli upya ya madirisha ya muda yanayovutia kwa kasi ya juu zaidi ya fremu ili kukagua mwendo wa haraka na dosari ndogo za kuona.
Hesabu ya vitendo na vitu: Kufuatilia kwa usahihi vitendo vya kimwili vinavyojirudia na vitu tofauti kadiri muda unavyopita.
Kwa sasa, kipengele hiki kimezinduliwa katika Gemini API ya Google AI Studio na Gemini Enterprise Agent Platform, kikiwa na uwezo wa kupakia video na kuchanganua video za YouTube. Watengenezaji wanahitaji tu kuweka hali ya uchakataji kuwa “agentic” katika usanidi wa API ili kuwasha kipengele hiki.
Google pia inapanga kupeleka uwezo huu katika bidhaa zaidi zinazolenga watumiaji wa kawaida. Kipengele hiki kitasambazwa hivi karibuni kwa watumiaji wote wa miundo ya Flash na Flash-Lite katika programu ya Gemini; katika miezi michache ijayo, uelewa wa video unaoongozwa na wakala pia utawezesha kipengele cha “Ask YouTube” kwenye ukurasa wa kutazama video wa YouTube, kikitumia Gemini kutoa majibu yenye ubora wa juu zaidi yanayotegemea picha za video.