

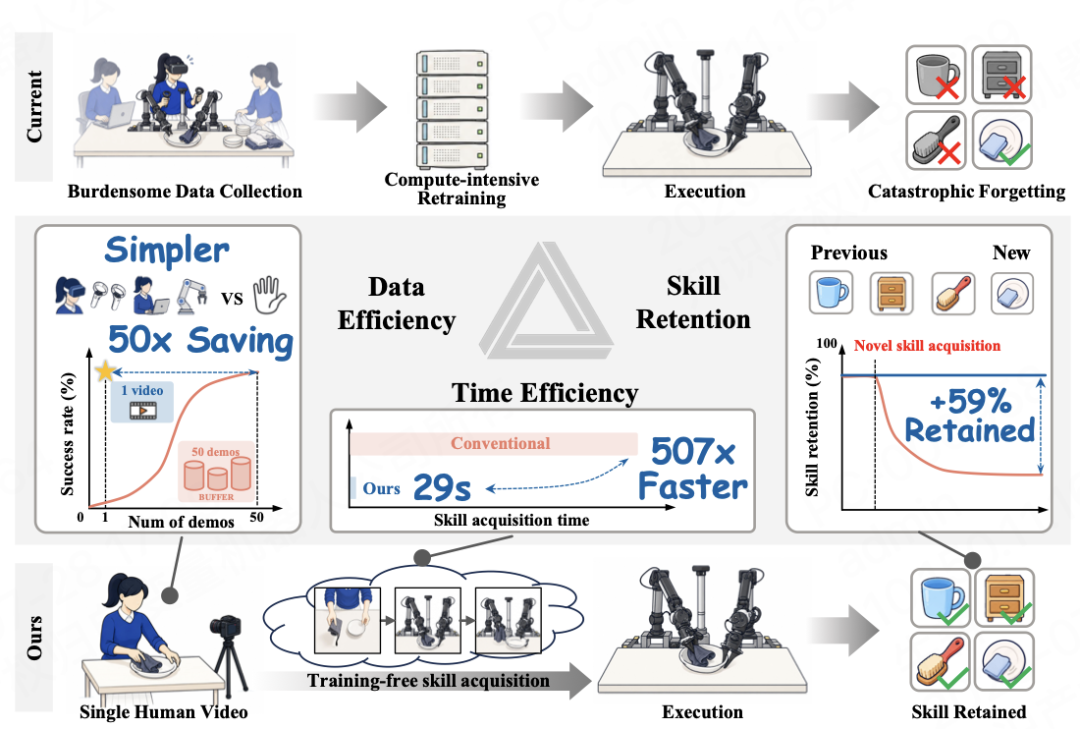
Roboti ya 自变量 leo imezindua na kuweka wazi mfumo wa HOST (Human-to-robot One-Shot Skill AcquisiTion, upataji wa ujuzi wa mara moja kutoka kwa binadamu kwenda kwa roboti), ikidai kuwa mfumo huo unaweza kuiwezesha roboti kujifunza ujuzi mpya kwa kutazama tu video ya binadamu yenye urefu wa makumi ya sekunde, huku ikihifadhi ujuzi ambao tayari imejifunza.
HOST inatumia mbinu ya kipekee: badala ya kutafsiri mienendo ya binadamu kuwa mienendo ya roboti na kujaribu kuiiga, huiwezesha roboti kwanza kuwazia matokeo baada ya kutekeleza kitendo, kisha kutenganisha vitendo vinavyohitajika kutokana na matokeo hayo. Matokeo ya mbinu hii mpya yanatia moyo: kiwango cha mafanikio cha roboti kujifunza ujuzi kutoka kwenye video ya binadamu ya sekunde 29 kinafikia 62%, kikizidi msingi wa zero-shot wa 45%. Ikilinganishwa na suluhisho la Pi-0.5 + fine-tuning, HOST hupunguza data inayohitajika mara 50 na kuongeza kasi ya kujifunza ujuzi mara 500.
Wazo la HOST linatokana na nadharia ya “kujifunza kwa kutazama” katika sayansi ya utambuzi: wanadamu wanapokabiliwa na kazi wasiyoijua, hawahitaji kujifunza kupitia mazoezi ya muda mrefu au kujaribu kila uwezekano. Badala yake, hutumia uwezo wa awali kuiga kiakili matokeo yanayotarajiwa ya kitendo, kisha kutekeleza kitendo kinachofaa. Wakiongozwa na wazo hili, watafiti wa 自变量 walibadilisha mpango wa kujifunza wa HOST kutoka “mzunguko wa fine-tuning wakati wa mafunzo” kuwa “upataji wa ujuzi wakati wa inference”, na hivyo kuiwezesha roboti kujifunza ujuzi mpya kwa kutazama binadamu akitekeleza kazi.
Tatizo la kwanza ambalo roboti inapaswa kutatua ni: inawezaje kuoanisha maendeleo ya utekelezaji wa kazi wake na maendeleo yanayoonekana kwenye video?
Kwa mfano, baada ya kufanya kazi kwa sekunde 10, mtu kwenye video huenda tayari amemaliza kukata chakula na kuanza kukipika, huku roboti ikiwa bado inakata chakula. Ikiwa uoanishaji utafanywa kwa kuzingatia muda pekee, roboti itapoteza mfuatano wa maendeleo ya kazi.
Kutatua hili, HOST hutumia “uoanishaji kulingana na maendeleo ya kazi”. HOST hubadilisha kila fremu ya video na kila hatua ya uendeshaji wa roboti kuwa vekta katika nafasi ileile ya vekta; kisha hutumia algoriti ya “dynamic time warping” ili kuoanisha kiotomatiki “fremu ya X ya video ya binadamu na hatua ya Y ya uendeshaji wa roboti”. Kwa njia hii, kila roboti inapofikia hatua fulani ya utekelezaji, huona daima fremu inayolingana na maendeleo ya kazi.
Kutokana na mbinu hii, HOST hupunguza kosa la muda katika kuoanisha maendeleo ya kazi kwa oda moja ya ukubwa, na hivyo kuwezesha ulandanishi sahihi kati ya utekelezaji wa roboti na onyesho la video.
Sehemu kuu ya HOST ni modeli ya sera ya kaskadi yenye uwezo wa kutabiri kwa kutumia kuona. Inatumia usanifu wa wataalamu wawili wa MoT, unaofanana na akili mbili zenye majukumu yaliyogawanywa wazi: “akili ya kuona” (mtaalamu wa video) hushughulikia picha za video, kubaini maendeleo ya kazi na kutabiri mandhari ya baadaye; “akili ya vitendo” (mtaalamu wa vitendo) hubadilisha mandhari iliyotabiriwa kuwa vitendo vinavyohitajika na kudhibiti utekelezaji.
Wakati wa kufundisha modeli, timu ya 自变量 iligawanya mchakato wa mafunzo katika hatua mbili: “mafunzo ya awali ndani ya mwili mmoja” na “mafunzo kwa video za binadamu na roboti”. Katika hatua ya mafunzo ya awali ndani ya mwili mmoja, roboti hujifunza kutoka kwenye video za roboti yenyewe ikitekeleza kazi, na kujifunza kutabiri hali baada ya kukamilisha kazi pamoja na kuzalisha vitendo vinavyolingana. Katika hatua ya mafunzo kwa video za binadamu na roboti, roboti huendelea kujifunza kutokana na video za maonyesho ya binadamu, kubadilisha mchakato wa binadamu kutekeleza kazi kuwa matokeo ya kazi kutoka kwa mtazamo wa roboti, kisha kukisia vitendo vinavyohitajika ili kukamilisha kazi kulingana na matokeo lengwa. Hivyo, ujuzi huhamishwa kutoka kwenye onyesho la binadamu kwenda kwa roboti.
Kwa sasa, karatasi ya utafiti na msimbo wa HOST zote zimewekwa wazi. Katika siku zijazo, roboti zinapofanya kazi za nyumbani huenda zikaondokana na mchakato wa kitaalamu wa kukusanya data na kufundisha, na kujifunza ujuzi mpya kupitia maonyesho ya moja kwa moja ya binadamu.
Marejeo
Ukurasa wa mradi
Kiungo cha karatasi
Kiungo cha Github
Kiungo cha Huggingface